Mô hình 24GB không đồng nghĩa máy tính 24GB: ngân sách bộ nhớ của Nemotron Bolt
Tìm hiểu 74B tham số tổng và 9B tham số hoạt động của Nemotron Bolt, trọng số 2-bit nguyên bản, cùng bộ nhớ dành cho ngữ cảnh, hình ảnh, mô hình dự thảo và môi trường chạy trong các cấu hình cục bộ.
Bạn có GPU với 24GB bộ nhớ. Một mô hình mới có chữ “24GB” trong tên. Chẳng phải hai con số đó đã đủ để quyết định mua hay sao?
Không, nếu xét toàn bộ khối lượng công việc AI cục bộ. Trong thông báo ngày 15 tháng 10, NVIDIA giới thiệu Nemotron 3.5 Bolt 74B-A9B 24GB là mô hình ngôn ngữ-thị giác có thể triển khai cục bộ và sử dụng lượng tử hóa 2-bit nguyên bản. Tên gọi mô tả mục tiêu tối ưu hóa, chứ không hứa rằng mọi độ dài ngữ cảnh, yêu cầu hình ảnh và cấu hình tác tử đều vừa với card đồ họa 24GB. Thông báo của NVIDIA, ngày 15 tháng 10 năm 2026.
Câu hỏi hữu ích là còn lại những gì sau khi mô hình được tải. Hướng dẫn này phân biệt tham số được lưu với phép tính đang hoạt động, giải thích các thành phần khác dùng bộ nhớ và hướng dẫn thiết lập chỉ truy cập loopback dựa trên công thức thực tế trong thẻ mô hình. Hãy bắt đầu từ khối lượng công việc cần làm, rồi quyết định máy có thể duy trì nó hay không.
Ảnh đầu bài: phần giải thích biên tập nguyên bản về ngân sách cho toàn bộ khối lượng công việc, không phải ảnh chụp màn hình chính thức hay phép đo phân bổ bộ nhớ. Kích thước các thành phần không được biểu diễn.
Số tham số hoạt động nhỏ hơn không biến đây thành bản tải 9B
Bolt có tổng cộng 74 tỷ tham số và khoảng 9 tỷ tham số hoạt động trên mỗi token. Bộ định tuyến mixture-of-experts chọn một phần mạng đã lưu. Đây là hậu duệ được nén từ Super VL 120B-A12B, không phải mô hình dense 9B. Tổng quan nghiên cứu Bolt của NVIDIA, ngày 15 tháng 10 năm 2026.
Hãy ghi nhớ điểm khác biệt này: tham số hoạt động giúp giải thích lượng công việc tính toán cho một token; tổng tham số giúp giải thích phần cần được lưu trữ. Không con số nào tự nó quyết định tốc độ ứng dụng. Vị trí lưu trữ, băng thông bộ nhớ, kernel, độ dài đầu vào và ứng dụng bao quanh đều ảnh hưởng đến kết quả.
Tác tử rà soát mã vẫn cần truy cập những chuyên gia không được chọn cho token ngay trước đó. Chuyển dữ liệu giữa ổ lưu trữ, bộ nhớ hệ thống và bộ nhớ GPU không tương đương với việc có sẵn mọi thứ trên bộ tăng tốc. Vì vậy, số tham số hoạt động nhỏ hơn không cho phép tính yêu cầu phần cứng như thể các tham số còn lại chưa từng tồn tại.
Tên các mô hình trong họ này cũng cần được so sánh chính xác:
| Mô hình | Tên gọi đề cập đến điều gì | Trạng thái ngày 16 tháng 10 |
|---|---|---|
| Nemotron 3.5 Super VL | Mô hình 120B riêng biệt | Đã phát hành |
| Nemotron 3.5 Bolt 74B-A9B 24GB | Tùy chọn mô hình cục bộ nén được bàn trong bài này | Đã phát hành |
| Nemotron 3.5 Bolt E4B 4GB | Sản phẩm edge/hội thoại nhỏ hơn, riêng biệt | Được thông báo sẽ ra mắt ngày 23 tháng 10 |
Trạng thái phát hành lấy từ thông báo ngày 15 tháng 10. Ở thời điểm bài viết, E4B là sản phẩm sẽ có trong tương lai, không phải lựa chọn thay thế hiện có được các lệnh này minh họa. Kết quả triển khai doanh nghiệp của Super VL cũng không nên được hiểu là kết quả của Bolt trên máy tính để bàn.
Trọng số 2-bit nguyên bản giải quyết một phần ngân sách
“2-bit nguyên bản” có ý nghĩa vì nén mạnh là một phần trong quá trình phát triển mô hình, chứ không đơn thuần là người dùng chọn bản xuất nhỏ hơn sau này. NVIDIA dùng chưng cất có nhận biết lượng tử hóa để phục hồi năng lực sau khi giảm độ chính xác. Trọng số chuyên gia dùng IQ2_XXS ở mức 2.0625 bit mỗi phần tử, trong khi các thành phần khác giữ những định dạng khác nhau. Mạng có độ chính xác hỗn hợp, không phải mọi thứ đều đồng nhất ở mức hai bit. Giải thích về nén và lượng tử hóa của NVIDIA, ngày 15 tháng 10 năm 2026.
Một phép tính minh họa cố ý phi thực tế: 74 tỷ giá trị, mỗi giá trị lưu đúng hai bit, sẽ chiếm 18.5 tỷ byte. Đây chỉ là ví dụ, không phải kích thước tệp hay yêu cầu khởi chạy của Bolt: phép tính bỏ qua hỗn hợp độ chính xác thực tế, siêu dữ liệu và trạng thái thực thi. Nhân số tham số nổi bật với độ sâu bit nổi bật không thể thay thế việc kiểm tra một checkpoint cụ thể.
GGUF trả lời một câu hỏi khác. Đây là định dạng tệp mô hình mà hệ sinh thái llama.cpp sử dụng, chứa tensor và thông tin liên quan. Nó không phải lời hứa nén thứ hai chồng lên “2-bit”; tải GGUF cũng không tự chứng minh rằng môi trường chạy cụ thể hiểu được mô hình. Tài liệu công cụ GGUF của llama.cpp, truy cập ngày 16 tháng 10 năm 2026.
Ước tính phân rã bộ nhớ của chính NVIDIA làm rõ sự khác biệt: Bảng 2 liệt kê 22.01GB cho trọng số, tổng cộng 23.83GB không tính phần thị giác, và thêm 1.68GB cho vision encoder cùng projector. Đây là ước tính của nhà cung cấp cho cấu hình trong báo cáo, không phải số đo bộ nhớ của bài viết này. Báo cáo cũng mô tả mục tiêu thiết kế dưới 24GB ở batch size một và ngữ cảnh 128K. Báo cáo kỹ thuật Bolt, Bảng 2 và Mục 2.3, liên kết ngày 15 tháng 10 năm 2026.
Điều cần rút ra không phải là tên gọi kia thực chất chỉ nói về trọng số. Mà là mục tiêu triển khai dựa trên các giả định. Thay đổi giả định thì yêu cầu bộ nhớ cũng thay đổi.
Dự trù toàn bộ tập làm việc, không chỉ trọng số
Hãy hình dung triển khai như một chi phí ngữ cảnh cộng thêm trên mô hình được lưu: công việc bạn yêu cầu hệ thống ghi nhớ và xử lý cũng cần chỗ. Khi lập kế hoạch, hãy tách trọng số, trạng thái chuỗi, xử lý hình ảnh, giải mã suy đoán và vùng làm việc của môi trường chạy. Chừa thêm dung lượng cho máy tính để bàn và các ứng dụng bạn thực sự định để mở.
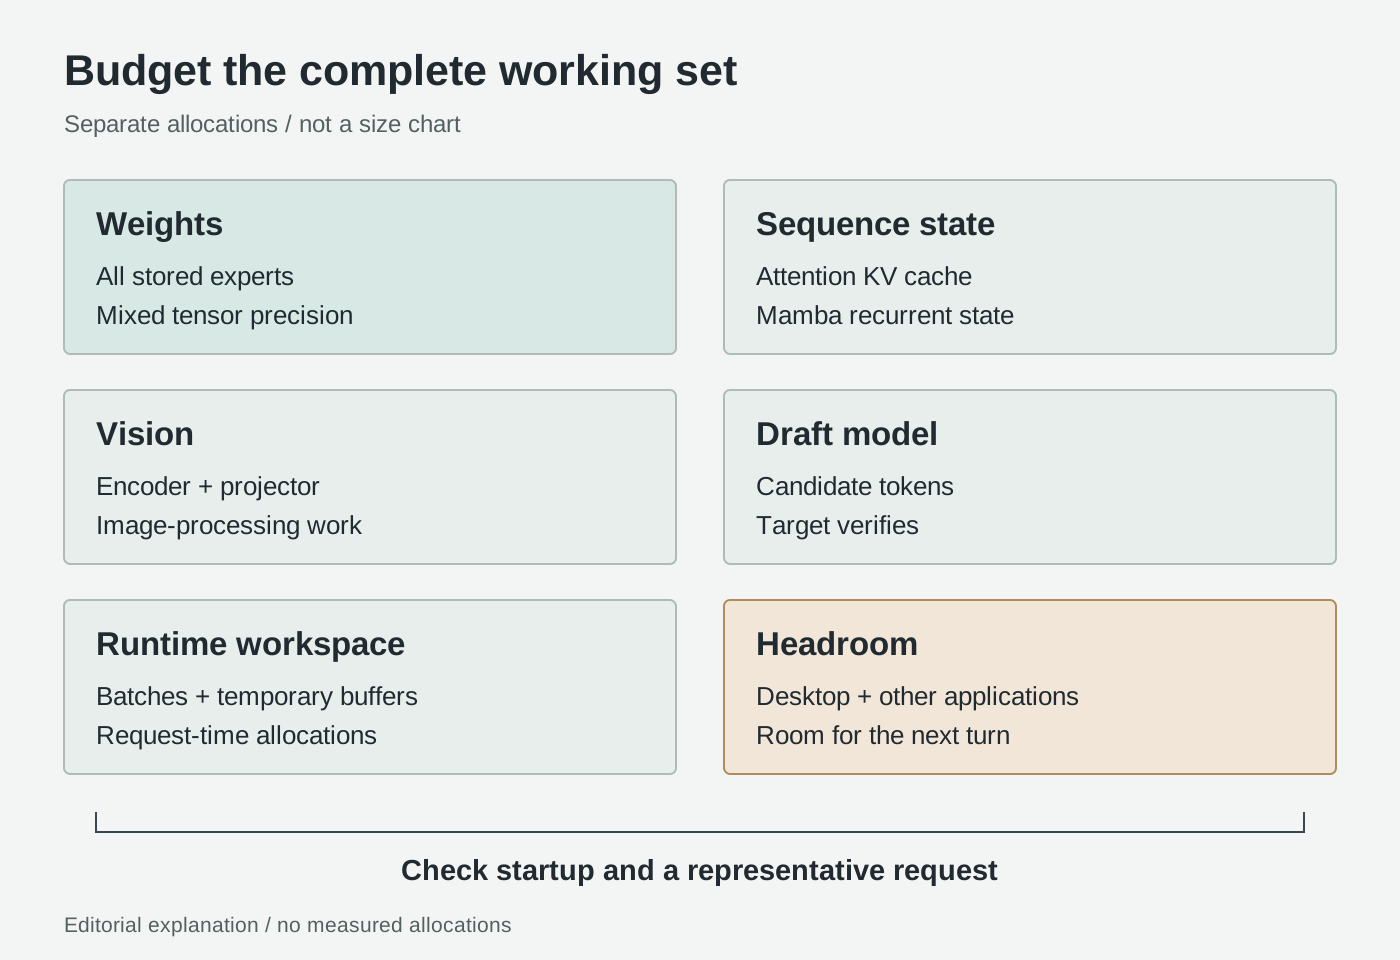
Phần giải thích biên tập nguyên bản, không biểu thị tỷ lệ đo được. Cơ chế: tài liệu bộ nhớ đệm của Hugging Face, hướng dẫn đa phương thức của llama.cpp và báo cáo Bolt của NVIDIA, truy cập ngày 16 tháng 10 năm 2026.
Trạng thái chuỗi không phải một bản sao khác của trọng số. Mô hình attention tự hồi quy lưu đệm các khóa và giá trị từ token trước để tái sử dụng khi tạo nội dung. Chuỗi được giữ lại càng dài thì càng cần nhiều bộ nhớ đệm attention; chi tiết phụ thuộc kiến trúc và cách biểu diễn bộ đệm. Hugging Face, “Cách hoạt động của bộ nhớ đệm”, truy cập ngày 16 tháng 10 năm 2026.
Bolt là mô hình lai có các lớp Mamba và attention, vì vậy ước tính bộ đệm chung cho mô hình toàn Transformer không thể tính đầy đủ cho nó. Trạng thái hồi quy và bộ đệm attention là các phần cấp phát riêng; hãy kiểm tra những gì môi trường chạy thực sự tạo ra. Khác biệt kiến trúc được ghi trong Bảng 1 của báo cáo Bolt, truy cập ngày 16 tháng 10 năm 2026.
Với một tác tử, ngữ cảnh được giữ lại không chỉ là câu hỏi bạn nhập. Chỉ thị hệ thống, lược đồ công cụ, lịch sử hội thoại, đoạn văn được truy xuất và phản hồi từ công cụ đều tranh chỗ với phần trả lời. Bản ghi chứa nhiều danh sách kho mã lặp lại có thể làm cạn ngân sách hữu ích mà không bổ sung bằng chứng giá trị. Giữ trạng thái tác vụ ngắn gọn là quyết định về quy trình, không chỉ là cách ứng phó với phần cứng.
Thị giác tạo ra một đường xử lý riêng. llama.cpp ghép mô hình ngôn ngữ với tệp projector đa phương thức qua --mmproj; tài liệu cho biết thành phần này mặc định được chuyển tải sang GPU. Hướng dẫn đa phương thức của llama.cpp, truy cập ngày 16 tháng 10 năm 2026. Vì vậy, chỉ tải tệp mô hình ngôn ngữ không tương đương với cấu hình đầy đủ có khả năng xử lý hình ảnh.
Với tác vụ tài liệu, hãy phân biệt việc đọc văn bản đã trích xuất với việc diễn giải trang đã kết xuất. Một đoạn văn thuần túy không chứa mối liên hệ trực quan giữa tiêu đề cột và các ô dữ liệu. Ngược lại, gửi ảnh các trang mà bố cục không quan trọng sẽ làm tăng công việc mà chưa chắc cải thiện câu trả lời. Hãy chọn cách biểu diễn giữ được bằng chứng cần thiết cho câu hỏi.
Mô hình dự thảo suy đoán là một mô hình bổ sung. Bộ dự thảo LiLiCorr của Bolt đề xuất các token ứng viên để mô hình đích xác minh. Nó được thiết kế để tăng tốc giải mã, nhưng checkpoint bổ sung và trạng thái thực thi của nó vẫn cần bộ nhớ. Giải thích LiLiCorr của NVIDIA, ngày 15 tháng 10 năm 2026. Có bộ dự thảo không đảm bảo tác vụ của bạn sẽ hoàn thành nhanh hơn.
Vùng làm việc của môi trường chạy lại là phần riêng. Các batch xử lý prompt và bộ đệm tính toán tạm thời cần được tính cùng trạng thái lưu giữ lâu dài. Máy chủ cung cấp cả kích thước batch logic và kích thước microbatch vật lý; hai khái niệm này không thể đánh đồng với số hội thoại đồng thời. Tài liệu tham khảo tùy chọn máy chủ llama.cpp, truy cập ngày 16 tháng 10 năm 2026. Cấu hình khởi chạy thành công vẫn cần được thử với yêu cầu đại diện.
Bảng phần cứng chính thức hữu ích hơn hậu tố trong tên sản phẩm
Cấu hình NVIDIA đã công bố:
| Công thức | Phần cứng | Ngữ cảnh | Số chuỗi |
|---|---|---|---|
| 28GB | RTX Spark 64GB hoặc RTX rời 32GB+ | 65,536 | 1 |
| 32GB | RTX Spark 128GB hoặc RTX rời 48GB+ | 262,144 | 1 |
Nguồn: Hướng dẫn nhanh NVIDIA, truy cập ngày 16 tháng 10 năm 2026.
Các hàng này không bao gồm GPU rời 24GB và cũng không xác nhận hỗ trợ Mac. RAM máy chủ không phải VRAM rời bổ sung.
Quan điểm của chúng tôi: hãy chọn cấu hình có thể lặp lại, không phải ảnh chụp màn hình tải mô hình thành công. Nếu định mua máy vì mô hình này, hãy yêu cầu trình diễn với đầu vào bạn dự kiến dùng và các ứng dụng chạy nền thông thường. Điều này đặc biệt quan trọng với ảnh tài liệu và tác tử chạy lâu, vì yêu cầu đầu tiên có thể nhỏ hơn nhiều so với các yêu cầu về sau.
Chọn ngữ cảnh theo công việc, không theo mức tối đa
Hãy xem xét ba công việc khởi đầu mang tính minh họa, không phải thử nghiệm đã được báo cáo.
Một nhà phát triển yêu cầu giải thích bài kiểm thử bị lỗi, cung cấp thông báo lỗi, hàm liên quan và một phần phụ thuộc lân cận. Kết quả hữu ích là chẩn đoán gắn với các dòng cụ thể, tiếp theo là thay đổi được đề xuất. Trước khi đưa cả kho mã vào, hãy kiểm tra xem thông tin còn thiếu là một giao diện cụ thể hay một khung ngăn xếp khác. Cách này giúp câu hỏi dễ kiểm tra và dễ phát hiện giả định sai.
Một nhà nghiên cứu đối chiếu bảng nằm trên hai trang tài liệu. Phép thử ở đây là liệu mô hình có ghép đúng tiêu đề, đơn vị, chú thích và giá trị hay không. Hãy dùng ảnh trang gốc khi những quan hệ đó quan trọng, yêu cầu bằng chứng theo từng trang và đối chiếu một số ô với bản gốc. Bản tóm tắt trôi chảy nhưng tráo hai cột vẫn là kết quả thất bại, dù được trả về nhanh.
Một trợ lý cục bộ tìm trong thư mục được phê duyệt và chuẩn bị báo cáo nháp. Áp lực bộ nhớ có thể tăng do tài liệu truy xuất và phản hồi công cụ lặp đi lặp lại. Hãy giao việc chỉ đọc trước tiên, giới hạn phạm vi tìm kiếm và yêu cầu nêu tên tệp làm căn cứ cho từng kết luận. Đừng cấp quyền ghi hay shell chỉ để xem mô hình có lập được kế hoạch hữu ích hay không.
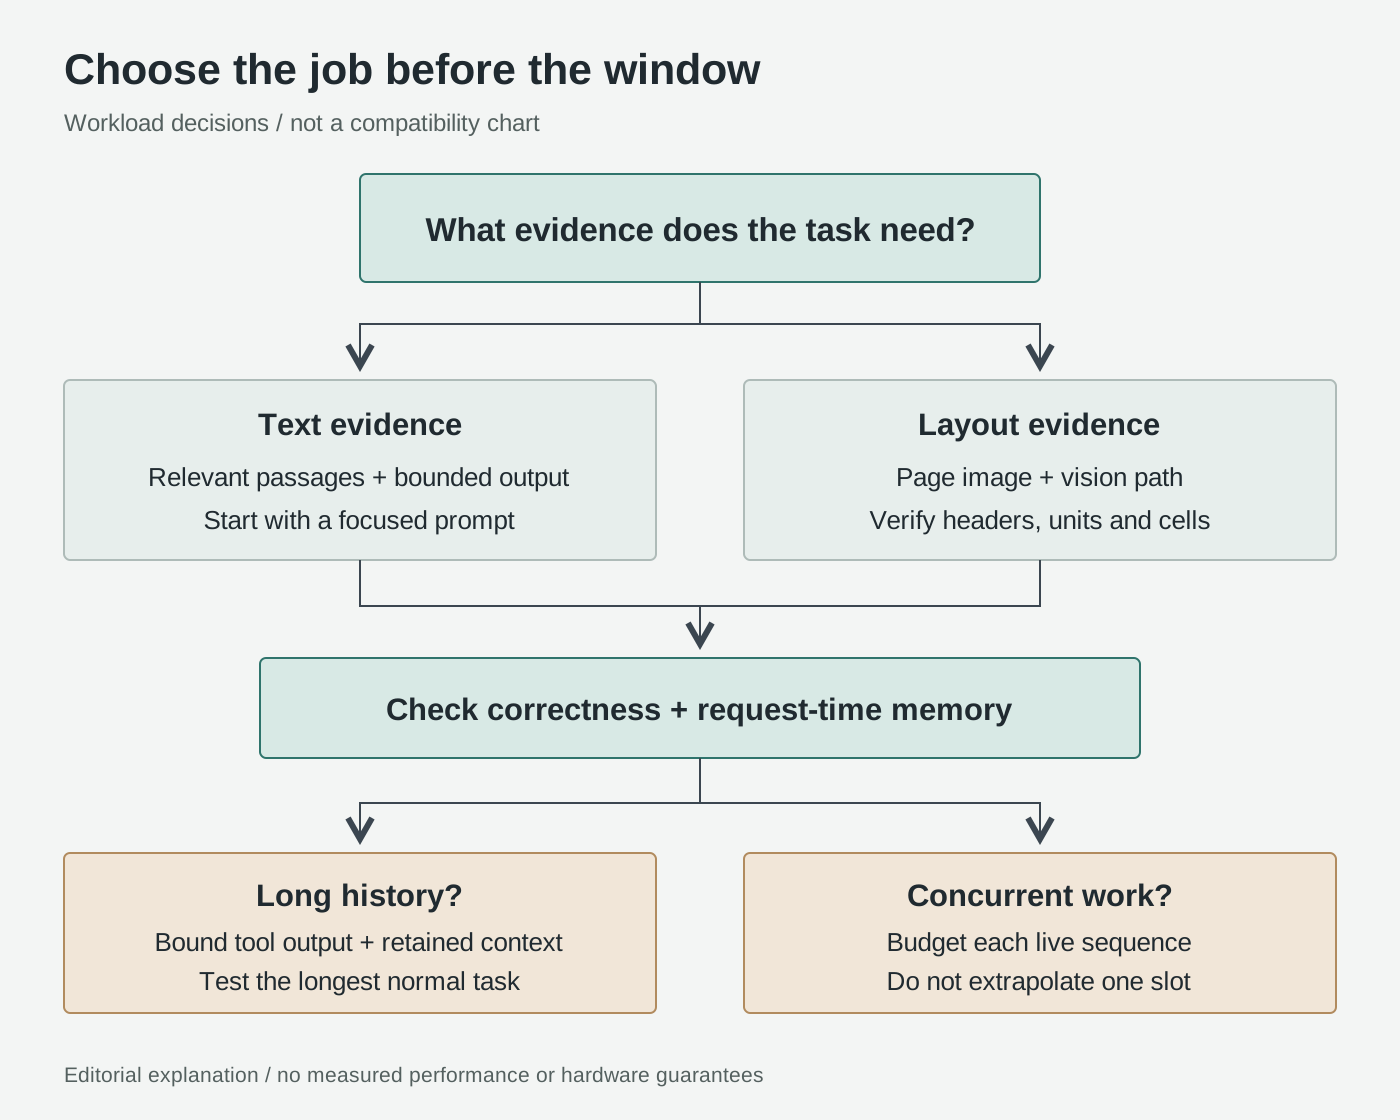
Phần giải thích biên tập nguyên bản về lựa chọn khối lượng công việc, không phải benchmark hay biểu đồ tương thích. Xem chiến lược bộ đệm của Hugging Face và cách xử lý đa phương thức của llama.cpp, truy cập ngày 16 tháng 10 năm 2026.
Bộ đệm lượng tử hóa có thể giảm dung lượng lưu so với bộ đệm độ chính xác cao hơn, còn chuyển tải bộ nhớ sẽ dời áp lực sang một tầng bộ nhớ khác và có thể đánh đổi thông lượng để lấy dung lượng. Đây là các đánh đổi chung, không phải bằng chứng rằng mọi chiến lược bộ đệm trong Transformers đều dùng được cho triển khai GGUF này. Chiến lược bộ đệm của Hugging Face, truy cập ngày 16 tháng 10 năm 2026.
Ưu tiên thực tế là mật độ bằng chứng: giữ lại tài liệu cần để trả lời, lưu bản gốc riêng và loại bỏ phần khung lặp lại. Cũng cần chừa chỗ cho câu trả lời. Cửa sổ cấu hình lớn hơn không khiến lịch sử không liên quan trở nên hữu ích.
Bắt đầu cục bộ, sau đó thử đúng khối lượng công việc bạn cần
Ví dụ Linux Bash sau đây hướng đến cấu hình GPU NVIDIA rời được hỗ trợ. Ví dụ giả định Git, Python, CMake, bộ công cụ C++, trình điều khiển NVIDIA tương thích và CUDA toolkit đã được cài đặt. Đây là quy trình để chạy trên máy của bạn, không phải báo cáo về một lần cài đặt đã hoàn tất.
- Build môi trường chạy cần thiết và kiểm tra tùy chọn. Dùng cách build từ mã nguồn, không dùng một dòng lệnh chung chép từ trang mô hình. Làm theo hướng dẫn build CUDA của llama.cpp, truy cập ngày 16 tháng 10 năm 2026. Ghi lại commit được báo cáo và phiên bản binary cùng cấu hình.
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git rev-parse HEAD
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON
cmake --build build --config Release -j
./build/bin/llama-server --version
./build/bin/llama-server --help
Kiểm tra phần trợ giúp có các tùy chọn draft-dflash, --spec-draft-model, --spec-draft-n-max, --cache-type-k, --cache-type-v, --flash-attn và --jinja hay không. Nhãn phiên bản gói phần mềm không tự chứng minh có hỗ trợ. Nếu binary từ chối các tùy chọn này, hãy xử lý sai khác trong bản build trước khi tải checkpoint lớn; đừng âm thầm thay công thức bằng các cờ giải mã suy đoán cũ. Tên tùy chọn được ghi trong tài liệu máy chủ hiện hành, truy cập ngày 16 tháng 10 năm 2026.
- Tải ba tệp trong Hướng dẫn nhanh của NVIDIA, truy cập ngày 16 tháng 10 năm 2026. Cú pháp tải xuống theo hướng dẫn CLI của Hugging Face, truy cập ngày 16 tháng 10 năm 2026. Trước tiên, hãy kiểm tra dung lượng ổ đĩa.
python3 -m venv .venv-hf
source .venv-hf/bin/activate
python -m pip install --upgrade huggingface_hub
MODEL_DIR="$PWD/models/nemotron-bolt"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --local-dir "$MODEL_DIR"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf \
  --local-dir "$MODEL_DIR"
MODEL="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
MMPROJ="$MODEL_DIR/mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
DRAFT="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf"
Trước khi dùng cấu hình này làm mốc so sánh, hãy ghi lại revision của kho mã và mã băm cục bộ của các tệp. Lần cập nhật tệp hay môi trường chạy về sau phải là thay đổi có chủ đích, không phải khác biệt khó giải thích giữa hai lần chạy.
- Dùng công thức 28GB của NVIDIA với ràng buộc loopback tường minh.
./build/bin/llama-server \
  --model "$MODEL" --mmproj "$MMPROJ" \
  --batch-size 2048 --ubatch-size 512 \
  --ctx-size 65536 --parallel 1 -ngl 999 \
  --spec-type draft-dflash --spec-draft-n-max 6 \
  --spec-draft-model "$DRAFT" --spec-draft-ngl 999 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja \
  --host 127.0.0.1 --port 8080
Nếu cần, hãy dùng cổng còn trống và sửa bước kiểm tra bên dưới cho khớp. Không tạo quy tắc chuyển tiếp trên router, tunnel công khai hay listener gắn với địa chỉ bên ngoài trong lần chạy đầu tiên. Loopback giới hạn phạm vi mạng; điều đó không làm các công cụ của tác tử được kết nối trở nên vô hại.
- Kiểm tra trạng thái sẵn sàng trước khi kết nối bất cứ thứ gì khác. Trong terminal khác, chạy:
curl --fail http://127.0.0.1:8080/health
Máy chủ mô tả riêng phản hồi đang tải và trạng thái sẵn sàng. Khi đã sẵn sàng, mở http://127.0.0.1:8080 cục bộ và thử một câu hỏi văn bản ngắn trước khi gửi yêu cầu hình ảnh. Tài liệu về kiểm tra sức khỏe máy chủ và giao diện web của llama.cpp, truy cập ngày 16 tháng 10 năm 2026. Hãy giữ các công cụ bên ngoài ở trạng thái ngắt kết nối cho đến khi phản hồi cơ bản hoạt động.
- Đo lường toàn bộ công việc trước khi mở rộng. Trên hệ thống GPU rời, hãy kiểm tra bộ nhớ trước khi khởi chạy và trong lúc xử lý prompt đại diện:
nvidia-smi --query-gpu=name,memory.total,memory.used,memory.free --format=csv
Đây là quan sát ở cấp thiết bị, không phải mức đỉnh đầy đủ của tiến trình hay phương pháp hạch toán bộ nhớ hợp nhất. NVIDIA ghi nhận việc báo cáo bộ nhớ phụ thuộc nền tảng trong tài liệu tham khảo NVIDIA System Management Interface, truy cập ngày 16 tháng 10 năm 2026. Đồng thời giữ lại nhật ký cấp phát của môi trường chạy và kiểm tra riêng bộ nhớ máy chủ.
Hãy so sánh một prompt ngắn, prompt thông thường dài nhất của bạn và ảnh tài liệu đại diện. Ghi lại độ chính xác, thời gian hoàn thành, quan sát bộ nhớ và mọi lỗi cấp phát. Lặp lại khi trình soạn thảo và trình duyệt thường dùng đang mở. Cấu hình chỉ chạy được sau khi đóng phần còn lại của môi trường làm việc chưa đáp ứng yêu cầu ban đầu.
Nếu thất bại, hãy thay đổi từng yếu tố một và đặt tên cho cấu hình mới. Giảm ngữ cảnh, kích thước microbatch hay lượng lịch sử công cụ trả lời những câu hỏi khác nhau; bỏ bộ dự thảo là một thử nghiệm khác, không phải công thức đã công bố. Hãy giữ lại lỗi và đầu vào gây ra lỗi để lần chạy ngắn thành công về sau không xóa mất khối lượng công việc vẫn chưa giải quyết.
Điểm mấu chốt: mua theo tập làm việc
Điểm hấp dẫn của Bolt là một mô hình lớn, chỉ kích hoạt thưa, được nén cho công việc cục bộ. Giá trị thực tế phụ thuộc vào những gì còn vừa bên cạnh nó: bằng chứng, đầu vào trực quan, trạng thái chuỗi và ứng dụng cần để hoàn thành tác vụ.
Câu hỏi nghiệm thu đúng không phải là “Mô hình 24GB đã tải chưa?” mà là “Chính chiếc máy này có thể hoàn thành khối lượng công việc thông thường của tôi, với câu trả lời đáng tin cậy và đủ chỗ cho lượt tiếp theo không?” Đó mới là ngân sách bộ nhớ đáng để mua.
Nguồn
Thông tin phát hành đề ngày 15 tháng 10 năm 2026; các thẻ mô hình được liên kết và tài liệu cập nhật được kiểm tra ngày 16 tháng 10 năm 2026. Quy trình là hướng dẫn được biên soạn lại, không phải kết quả thử nghiệm thực hành. Sơ đồ nguyên bản dùng để giải thích, không phải tài sản chính thức hay biểu đồ hiệu năng.
- Thông báo phát hành của NVIDIA về ba tên mô hình và thời điểm phát hành.
- Tổng quan nghiên cứu Bolt của NVIDIA và báo cáo kỹ thuật về nén, độ chính xác và phân rã bộ nhớ ước tính.
- Thẻ mô hình GGUF của NVIDIA về bảng phần cứng thực tế, tên tệp checkpoint và công thức khởi chạy.
- Tài liệu build llama.cpp, máy chủ, đa phương thức và công cụ GGUF về hoạt động của môi trường chạy.
- Giải thích bộ đệm của Hugging Face, chiến lược bộ đệm, hướng dẫn CLI và tài liệu NVIDIA SMI về các cơ chế và lệnh kiểm tra cụ thể.
Gợi ý tùy chọn từ Telli.sh: lưu nguồn tham khảo phía sau các quyết định
So sánh các tác tử sẽ dễ hơn khi nguồn ban đầu, ghi chú của bạn và kết quả thử nghiệm riêng được lưu cùng nhau. Tạo tài khoản Telli.sh để sắp xếp tài liệu thành nguồn tham khảo có thể quay lại khi sản phẩm thay đổi.