โมเดล 24GB ไม่ได้แปลว่าคอมพิวเตอร์ 24GB: งบหน่วยความจำของ Nemotron Bolt
ทำความเข้าใจพารามิเตอร์รวม 74B และที่ทำงาน 9B ของ Nemotron Bolt, weight native 2-bit และหน่วยความจำสำหรับบริบท ภาพ โมเดลร่าง และ runtime ที่สูตรใช้งานในเครื่องต้องใช้
คุณมี GPU หน่วยความจำ 24GB โมเดลใหม่มีคำว่า “24GB” อยู่ในชื่อ ตัวเลขสองอย่างนี้น่าจะเพียงพอให้ตัดสินใจซื้อได้แล้วใช่ไหม
ไม่ใช่สำหรับภาระงาน AI ในเครื่องแบบครบชุด ประกาศวันที่ 15 ตุลาคมของ NVIDIA เปิดตัว Nemotron 3.5 Bolt 74B-A9B 24GB ซึ่งเป็นโมเดล vision-language สำหรับติดตั้งใช้งานในเครื่องและใช้ quantization native 2-bit ชื่อรุ่นบอกเป้าหมายการปรับแต่ง ไม่ได้รับประกันว่าความยาวบริบท คำขอภาพ และการกำหนดค่า agent ทุกแบบจะพอดีกับการ์ดจอ 24GB ประกาศ NVIDIA, 15 ตุลาคม 2026
คำถามที่มีประโยชน์คือหลังโหลดโมเดลแล้วยังเหลืออะไรบ้าง คู่มือนี้แยกพารามิเตอร์ที่จัดเก็บออกจากการคำนวณที่ทำงาน อธิบายสิ่งอื่นที่ใช้หน่วยความจำ และพาเริ่มตั้งค่าแบบ loopback-only โดยอิงสูตรจริงจาก model card เริ่มจากภาระงานที่ต้องการ แล้วค่อยตัดสินใจว่าเครื่องรองรับได้อย่างต่อเนื่องหรือไม่
ภาพหลัก: คำอธิบายต้นฉบับเรื่องงบประมาณของทั้งภาระงาน ไม่ใช่ภาพหน้าจออย่างเป็นทางการหรือการจัดสรรที่วัดได้ ไม่ได้แสดงขนาดขององค์ประกอบแต่ละส่วน
จำนวนพารามิเตอร์ที่ทำงานน้อยกว่า ไม่ได้ทำให้ดาวน์โหลดรุ่น 9B
Bolt มีพารามิเตอร์รวม 74 พันล้าน และทำงานราว 9 พันล้านพารามิเตอร์ต่อ token ตัว router ของ mixture-of-experts เลือกใช้เครือข่ายที่จัดเก็บไว้เพียงบางส่วน นี่คือรุ่นต่อยอดแบบบีบอัดจาก Super VL 120B-A12B ไม่ใช่โมเดล dense ขนาด 9B ภาพรวมงานวิจัย Bolt ของ NVIDIA, 15 ตุลาคม 2026
ควรจำความแตกต่างนี้ไว้: พารามิเตอร์ที่ทำงานช่วยอธิบายปริมาณงานที่ทำกับ token หนึ่ง ส่วนพารามิเตอร์ทั้งหมดช่วยอธิบายสิ่งที่ต้องจัดเก็บ ไม่มีตัวเลขใดตัวเลขเดียวที่กำหนดความเร็วแอปพลิเคชัน การจัดวาง แบนด์วิดท์หน่วยความจำ kernel ความยาวอินพุต และแอปพลิเคชันรอบข้างล้วนมีผล
agent ที่ตรวจโค้ดยังต้องเข้าถึงผู้เชี่ยวชาญที่ไม่ได้ถูกเลือกใช้กับ token ก่อนหน้า การย้ายข้อมูลระหว่างพื้นที่เก็บ หน่วยความจำระบบ และหน่วยความจำ GPU ไม่เท่ากับการมีทุกอย่างพร้อมใช้บนตัวเร่ง การมีพารามิเตอร์ที่ทำงานน้อยกว่าจึงไม่ใช่ใบอนุญาตให้คำนวณความต้องการฮาร์ดแวร์ราวกับพารามิเตอร์ที่เหลือไม่มีอยู่
ชื่อในตระกูลนี้ควรเปรียบเทียบอย่างแม่นยำด้วย:
| โมเดล | ชื่อนี้หมายถึงอะไร | สถานะ ณ วันที่ 16 ตุลาคม |
|---|---|---|
| Nemotron 3.5 Super VL | โมเดล 120B แยกต่างหาก | เปิดตัวแล้ว |
| Nemotron 3.5 Bolt 74B-A9B 24GB | ตัวเลือกโมเดลในเครื่องแบบบีบอัดที่กล่าวถึงที่นี่ | เปิดตัวแล้ว |
| Nemotron 3.5 Bolt E4B 4GB | ผลิตภัณฑ์ edge/conversational ขนาดเล็กกว่าอีกตัว | ประกาศกำหนดเปิดตัว 23 ตุลาคม |
สถานะการเปิดตัวอ้างอิงจากประกาศวันที่ 15 ตุลาคม E4B ยังเป็นสิ่งที่จะเปิดให้ใช้ในอนาคต ณ วันที่ของบทความนี้ ไม่ใช่ตัวเลือกทดแทนที่ใช้ได้แล้วและสาธิตด้วยคำสั่งเหล่านี้ อย่าอ่านผลการติดตั้งระดับองค์กรของ Super VL ว่าเป็นผลการใช้งาน Bolt บนเดสก์ท็อปด้วย
weight native 2-bit แก้ปัญหาเพียงส่วนหนึ่งของงบประมาณ
คำว่า “native 2-bit” มีความหมายเพราะการบีบอัดแบบเข้มข้นเป็นส่วนหนึ่งของการพัฒนาโมเดล ไม่ใช่แค่ผู้ใช้เลือก export ที่เล็กลงภายหลัง NVIDIA ใช้ quantization-aware distillation เพื่อฟื้นความสามารถหลังลดความละเอียด weight ของ expert ใช้ IQ2_XXS ที่ 2.0625 bit ต่อองค์ประกอบ ขณะที่ส่วนอื่นคงรูปแบบที่ต่างกัน เครือข่ายนี้เป็น mixed precision ไม่ได้ใช้สอง bit เหมือนกันทั้งหมด คำอธิบายเรื่องการบีบอัดและ quantization ของ NVIDIA, 15 ตุลาคม 2026
ลองคำนวณเลขแบบง่ายที่ตั้งใจให้ไม่ตรงความจริง: ค่าจำนวน 74 พันล้านที่เก็บด้วยสอง bit พอดีจะใช้พื้นที่ 18.5 พันล้านไบต์ นี่เป็นเพียงภาพประกอบ ไม่ใช่ขนาดไฟล์หรือข้อกำหนดตอนเริ่มใช้งานของ Bolt เพราะไม่รวมการผสมความละเอียดจริง metadata และสถานะการทำงาน การนำจำนวนพารามิเตอร์พาดหัวคูณกับ bit depth พาดหัวใช้แทนการตรวจ checkpoint จริงไม่ได้
GGUF ตอบคำถามอีกข้อหนึ่ง เป็นรูปแบบไฟล์โมเดลที่ระบบนิเวศ llama.cpp ใช้ บรรจุ tensor และข้อมูลประกอบ ไม่ใช่คำรับรองการบีบอัดชั้นที่สองที่ซ้อนบน “2-bit” และการดาวน์โหลด GGUF ก็ไม่ได้ยืนยันว่า runtime ใด runtime หนึ่งจะเข้าใจโมเดลนี้ เอกสารเครื่องมือ GGUF ของ llama.cpp เข้าดูเมื่อ 16 ตุลาคม 2026
รายละเอียดหน่วยความจำโดยประมาณของ NVIDIA เองช่วยให้เห็นความแตกต่างชัดเจน: ตารางที่ 2 ระบุ 22.01GB สำหรับ weight รวม 23.83GB เมื่อไม่รวม vision และเพิ่มอีก 1.68GB สำหรับ vision encoder กับ projector ตัวเลขเหล่านี้เป็นประมาณการจากการกำหนดค่าในรายงานของผู้ผลิต ไม่ใช่ค่าหน่วยความจำที่บทความนี้วัดได้ รายงานเดียวกันอธิบายเป้าหมายการออกแบบให้ต่ำกว่า 24GB ที่ batch size หนึ่งและบริบท 128K รายงานเทคนิค Bolt ตาราง 2 และหัวข้อ 2.3 ลิงก์เมื่อ 15 ตุลาคม 2026
ข้อสรุปไม่ใช่ว่าชื่อทางการตลาดแอบหมายถึงขนาด weight อย่างเดียว แต่คือเป้าหมายการติดตั้งมีสมมติฐานอยู่ เปลี่ยนสมมติฐานเหล่านั้น ความต้องการหน่วยความจำก็เปลี่ยนตาม
วางงบสำหรับ working set ทั้งหมด ไม่ใช่เฉพาะ weight
ให้นึกถึงการติดตั้งใช้งานว่าเป็น ภาษีบริบท ที่เพิ่มจากโมเดลซึ่งจัดเก็บไว้ สิ่งที่คุณขอให้ระบบเก็บและประมวลผลต้องใช้พื้นที่ด้วย สำหรับวางแผน ให้แยก weight สถานะลำดับ Vision processing speculative decoding และพื้นที่ทำงานของ runtime เผื่อพื้นที่เพิ่มให้เดสก์ท็อปและแอปพลิเคชันที่ตั้งใจเปิดไว้ด้วย
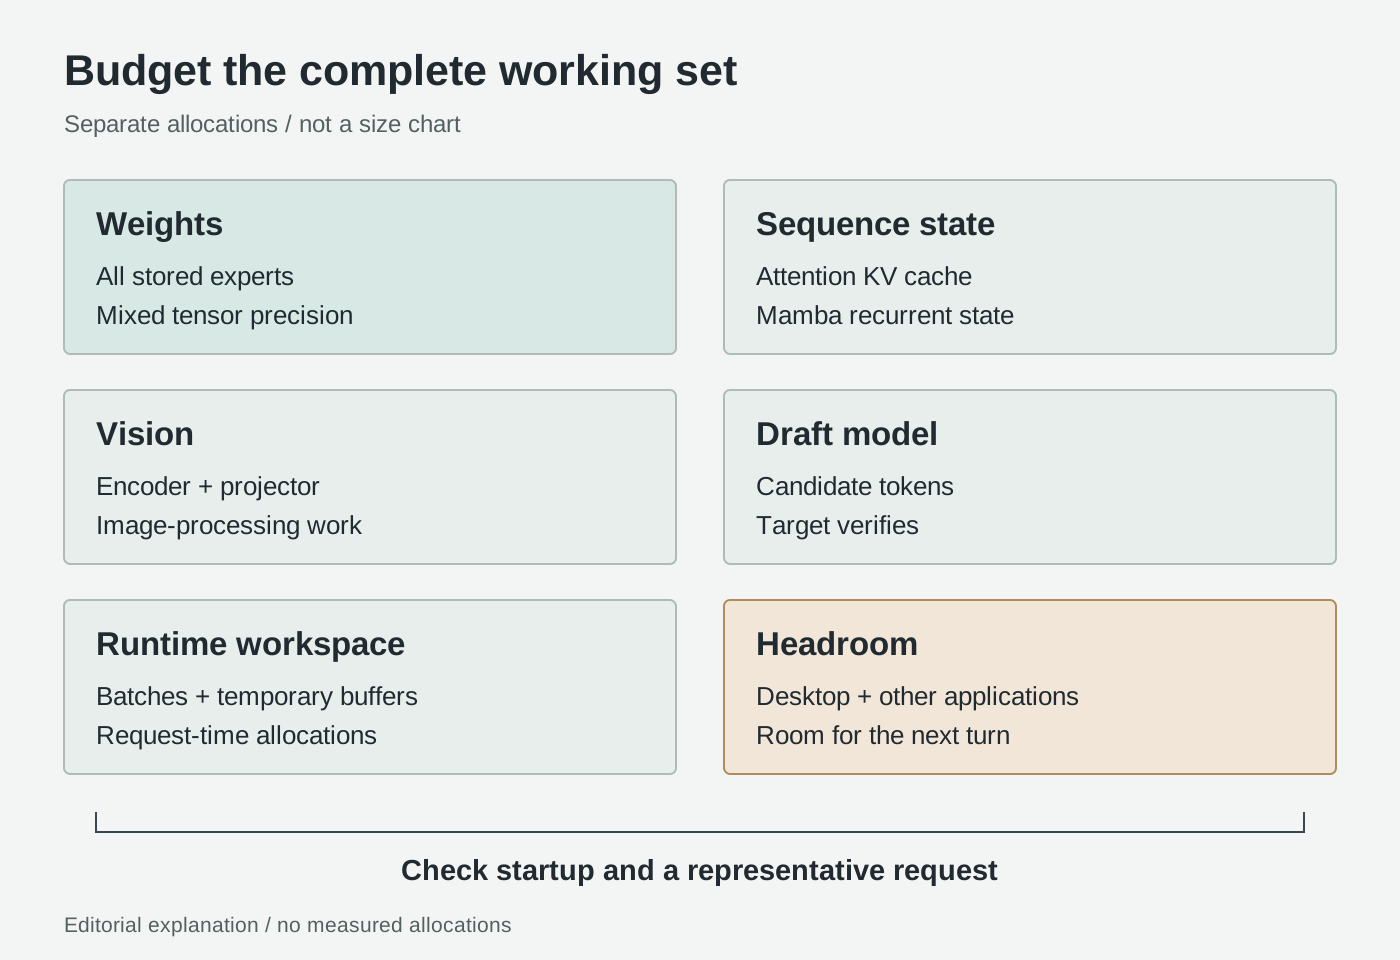
คำอธิบายต้นฉบับ ไม่ใช่สัดส่วนที่วัดได้ กลไกต่าง ๆ อ้างอิงจาก เอกสาร caching ของ Hugging Face, คู่มือ multimodal ของ llama.cpp และ รายงาน Bolt ของ NVIDIA เข้าดูเมื่อ 16 ตุลาคม 2026
สถานะลำดับไม่ใช่สำเนา weight อีกชุดหนึ่ง โมเดล attention แบบ autoregressive จะแคช key และ value จาก token ก่อนหน้าเพื่อใช้ซ้ำระหว่างการสร้าง ลำดับที่เก็บไว้นานขึ้นต้องใช้พื้นที่ attention cache มากขึ้น โดยรายละเอียดขึ้นอยู่กับสถาปัตยกรรมและการแทน cache Hugging Face, “การทำงานของ caching” เข้าดูเมื่อ 16 ตุลาคม 2026
Bolt เป็นโมเดลลูกผสมที่มีทั้งชั้น Mamba และ attention ดังนั้นค่าประมาณ cache ทั่วไปสำหรับ Transformer ทั้งหมดจึงคำนวณแทนโมเดลนี้ได้ไม่ครบ สถานะ recurrent กับ attention cache เป็นการจัดสรรคนละแบบ ให้ตรวจดูสิ่งที่ runtime สร้างขึ้นจริง ความแตกต่างด้านสถาปัตยกรรมระบุไว้ใน ตารางที่ 1 ของรายงาน Bolt เข้าดูเมื่อ 16 ตุลาคม 2026
สำหรับ agent บริบทที่เก็บไว้มีมากกว่าคำถามที่คุณพิมพ์ คำสั่งระบบ schema ของเครื่องมือ ประวัติการสนทนา ข้อความที่ดึงมา และคำตอบจากเครื่องมือล้วนใช้พื้นที่ร่วมกับคำตอบ รายการไฟล์ repository ที่ซ้ำ ๆ ในบทถอดความอาจกินงบที่มีประโยชน์โดยไม่ได้เพิ่มหลักฐานมีประโยชน์ การเก็บสถานะงานให้กระชับเป็นการตัดสินใจด้านเวิร์กโฟลว์ ไม่ใช่แค่ทางแก้เรื่องฮาร์ดแวร์
Vision เพิ่มเส้นทางประมวลผลแยกต่างหาก llama.cpp ใช้ไฟล์ multimodal projector คู่กับ language model ผ่าน --mmproj และเอกสารระบุว่าส่วนประกอบนี้จะ offload ไป GPU ตามค่าเริ่มต้น คู่มือ multimodal ของ llama.cpp เข้าดูเมื่อ 16 ตุลาคม 2026 ดังนั้นการโหลดเฉพาะไฟล์ language model จึงไม่ใช่การกำหนดค่าครบชุดสำหรับรองรับภาพ
สำหรับงานเอกสาร ให้แยกการอ่านข้อความที่ดึงออกมาแล้วกับการตีความหน้าที่เรนเดอร์ ข้อความย่อหน้าเปล่าไม่มีความสัมพันธ์เชิงภาพระหว่างหัวคอลัมน์กับเซลล์ ในทางกลับกัน การส่งภาพหน้าที่รูปแบบไม่สำคัญก็เพิ่มภาระโดยไม่จำเป็นต้องทำให้คำตอบดีขึ้น เลือกรูปแบบที่เก็บหลักฐานตามที่คำถามต้องใช้
โมเดลร่างแบบ speculative เป็นโมเดลเพิ่มอีกตัว ตัวร่าง LiLiCorr ของ Bolt เสนอ token ที่เป็นไปได้ให้โมเดลเป้าหมายตรวจสอบ ตั้งใจใช้เร่งการถอดรหัส แต่ checkpoint และสถานะการทำงานเพิ่มเติมก็ต้องใช้หน่วยความจำ คำอธิบาย LiLiCorr ของ NVIDIA, 15 ตุลาคม 2026 การมีตัวร่างไม่ได้รับประกันว่าจะทำงานของคุณเสร็จเร็วขึ้น
พื้นที่ทำงาน runtime เป็นอีกส่วนหนึ่ง batch สำหรับประมวลผล prompt และ buffer คำนวณชั่วคราวต้องอยู่ในงบควบคู่กับสถานะถาวร เซิร์ฟเวอร์แสดงทั้งขนาด batch เชิงตรรกะและขนาด microbatch เชิงกายภาพ ทั้งสองอย่างใช้แทนจำนวนบทสนทนาพร้อมกันไม่ได้ เอกสารตัวเลือกเซิร์ฟเวอร์ llama.cpp เข้าดูเมื่อ 16 ตุลาคม 2026 การกำหนดค่าที่เริ่มทำงานได้ยังต้องทดสอบกับคำขอตัวแทนด้วย
ตารางฮาร์ดแวร์อย่างเป็นทางการมีประโยชน์กว่าคำต่อท้ายชื่อผลิตภัณฑ์
การกำหนดค่าที่ NVIDIA เผยแพร่:
| สูตร | ฮาร์ดแวร์ | บริบท | ลำดับ |
|---|---|---|---|
| 28GB | RTX Spark 64GB หรือ RTX แยก 32GB+ | 65,536 | 1 |
| 32GB | RTX Spark 128GB หรือ RTX แยก 48GB+ | 262,144 | 1 |
ที่มา: Quick Start ของ NVIDIA เข้าดูเมื่อ 16 ตุลาคม 2026
แถวเหล่านี้ไม่ครอบคลุม GPU แยก 24GB และไม่ได้ยืนยันการรองรับ Mac หน่วยความจำ RAM ของโฮสต์ไม่ใช่ VRAM เพิ่มสำหรับการ์ดแยก
มุมมองของเรา: เลือกการกำหนดค่าที่ทำซ้ำได้ ไม่ใช่ภาพหน้าจอที่โหลดสำเร็จ หากการซื้อขึ้นอยู่กับโมเดลนี้ ให้ขอการสาธิตด้วยอินพุตที่ตั้งใจใช้และแอปพื้นหลังตามปกติ ภาระพิสูจน์ยิ่งสำคัญกับภาพเอกสารและ agent ที่ทำงานนาน เพราะคำขอแรกอาจเล็กกว่าคำขอในภายหลังมาก
เลือกบริบทตามงาน ไม่ใช่ตามค่าสูงสุด
ลองพิจารณางานเริ่มต้นสามแบบเพื่อประกอบตัวอย่าง ไม่ใช่ผลการทดลองที่รายงานไว้
นักพัฒนาขอคำอธิบายการทดสอบที่ล้มเหลว พร้อมส่งข้อผิดพลาด ฟังก์ชันที่เกี่ยวข้อง และ dependency ใกล้เคียงหนึ่งรายการ ผลลัพธ์ที่มีประโยชน์คือการวินิจฉัยที่อ้างอิงบรรทัดเฉพาะ ตามด้วยการเปลี่ยนแปลงที่เสนอ ก่อนเพิ่ม repository ทั้งชุด ให้ตรวจว่าข้อมูลที่ขาดคือ interface เฉพาะจุดหรือ stack frame อีกชั้น วิธีนี้ทำให้คำถามตรวจสอบได้และจับสมมติฐานผิดได้ง่ายขึ้น
นักวิจัยเปรียบเทียบตารางข้ามเอกสารสองหน้า ในกรณีนี้เกณฑ์คือโมเดลจับคู่หัวตาราง หน่วย เชิงอรรถ และค่าได้ถูกต้องหรือไม่ ใช้ภาพหน้าจริงเมื่อความสัมพันธ์เหล่านั้นสำคัญ ขอหลักฐานแยกตามหน้า และตรวจตัวอย่างเซลล์เทียบกับต้นฉบับ บทสรุปลื่นไหลแต่สลับสองคอลัมน์ถือว่าล้มเหลว แม้จะได้คำตอบเร็ว
ผู้ช่วยในเครื่องค้นหาโฟลเดอร์ที่ได้รับอนุญาตและเตรียมร่างรายงาน แรงกดดันต่อหน่วยความจำอาจเพิ่มจากเนื้อหาที่ดึงมาและคำตอบเครื่องมือที่ซ้ำกัน ให้เริ่มด้วยงานแบบอ่านอย่างเดียว จำกัดขอบเขตการค้นหา และกำหนดให้ระบุชื่อไฟล์ที่รองรับข้อสรุป อย่าให้สิทธิ์เขียนหรือ shell เพียงเพื่อดูว่าโมเดลวางแผนได้ดีหรือไม่
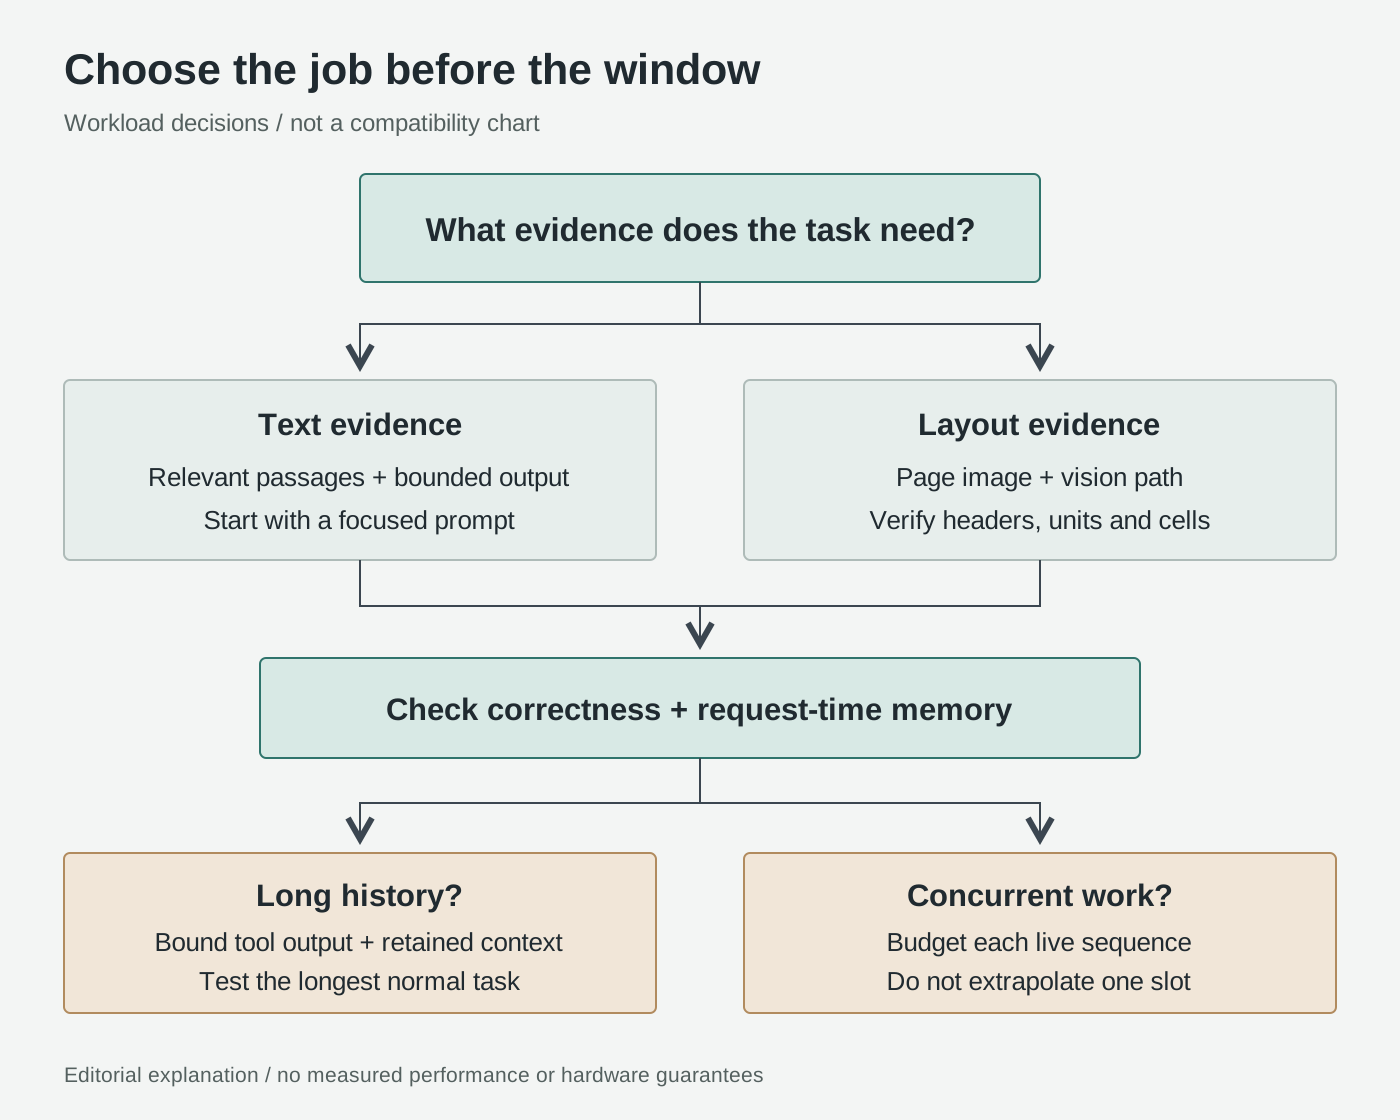
คำอธิบายต้นฉบับเรื่องการเลือกภาระงาน ไม่ใช่ benchmark หรือตารางความเข้ากันได้ ดู กลยุทธ์ cache ของ Hugging Face และ การจัดการ multimodal ของ llama.cpp เข้าดูเมื่อ 16 ตุลาคม 2026
cache แบบ quantized ลดพื้นที่จัดเก็บเมื่อเทียบกับ cache ความละเอียดสูงได้ ส่วนการ offload ย้ายแรงกดดันไปยังหน่วยความจำอีกระดับและอาจแลก throughput กับความจุได้ นี่เป็นการแลกเปลี่ยนทั่วไป ไม่ใช่หลักฐานว่ากลยุทธ์ cache ทุกแบบใน Transformers ใช้ได้กับการติดตั้ง GGUF นี้ กลยุทธ์ cache ของ Hugging Face เข้าดูเมื่อ 16 ตุลาคม 2026
สิ่งสำคัญในทางปฏิบัติคือความหนาแน่นของหลักฐาน: เก็บเนื้อหาที่จำเป็นต่อคำตอบ แยกต้นฉบับไว้ และตัดโครงสร้างประกอบที่ซ้ำออก เผื่อพื้นที่สำหรับคำตอบด้วย การกำหนดหน้าต่างขนาดใหญ่ขึ้นไม่ได้ทำให้ประวัติที่ไม่เกี่ยวข้องมีประโยชน์
เริ่มในเครื่อง แล้วทดสอบภาระงานที่ต้องใช้จริง
ตัวอย่าง Linux Bash ต่อไปนี้มุ่งสำหรับการกำหนดค่าการ์ด NVIDIA แยกที่รองรับ โดยสมมติว่าติดตั้ง Git, Python, CMake, toolchain C++, ไดรเวอร์ NVIDIA ที่เข้ากันได้ และ CUDA toolkit แล้ว นี่เป็นขั้นตอนให้รันบนเครื่องของคุณ ไม่ใช่รายงานการติดตั้งที่เสร็จเรียบร้อยแล้ว
- สร้าง runtime ที่เกี่ยวข้องและตรวจตัวเลือก ใช้เส้นทาง build จากซอร์ส ไม่ใช่ one-liner ทั่วไปจากหน้าโมเดล ทำตามคู่มือ build CUDA ของ llama.cpp เข้าดูเมื่อ 16 ตุลาคม 2026 เก็บ commit และเวอร์ชัน binary ที่รายงานไว้คู่กับการกำหนดค่าของคุณ
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git rev-parse HEAD
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON
cmake --build build --config Release -j
./build/bin/llama-server --version
./build/bin/llama-server --help
ตรวจว่า help มี draft-dflash, --spec-draft-model, --spec-draft-n-max, --cache-type-k, --cache-type-v, --flash-attn และ --jinja ป้ายเวอร์ชันแพ็กเกจเพียงอย่างเดียวไม่ได้ยืนยันว่ารองรับ หาก binary ปฏิเสธตัวเลือก ให้แก้ความไม่ตรงกันของ build ก่อนดาวน์โหลด checkpoint ขนาดใหญ่ อย่าเปลี่ยนสูตรอย่างเงียบ ๆ ไปใช้ flag speculative-decoding รุ่นเก่า ชื่อตัวเลือกมีในเอกสารอ้างอิงเซิร์ฟเวอร์ปัจจุบัน เข้าดูเมื่อ 16 ตุลาคม 2026
- ดาวน์โหลดไฟล์สามรายการใน Quick Start ของ NVIDIA เข้าดูเมื่อ 16 ตุลาคม 2026 รูปแบบคำสั่งดาวน์โหลดอ้างอิงจากคู่มือ CLI ของ Hugging Face เข้าดูเมื่อ 16 ตุลาคม 2026 ตรวจพื้นที่ดิสก์ก่อน
python3 -m venv .venv-hf
source .venv-hf/bin/activate
python -m pip install --upgrade huggingface_hub
MODEL_DIR="$PWD/models/nemotron-bolt"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --local-dir "$MODEL_DIR"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf \
  --local-dir "$MODEL_DIR"
MODEL="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
MMPROJ="$MODEL_DIR/mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
DRAFT="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf"
บันทึก revision ของ repository และ hash ไฟล์ในเครื่องก่อนใช้การตั้งค่านี้เป็นค่าฐานสำหรับเปรียบเทียบ การอัปเดตไฟล์หรือ runtime ภายหลังควรเป็นการเปลี่ยนแปลงโดยตั้งใจ ไม่ใช่ความแตกต่างระหว่างการรันสองครั้งที่อธิบายไม่ได้
- ใช้สูตร 28GB ของ NVIDIA พร้อมกำหนด loopback อย่างชัดเจน
./build/bin/llama-server \
  --model "$MODEL" --mmproj "$MMPROJ" \
  --batch-size 2048 --ubatch-size 512 \
  --ctx-size 65536 --parallel 1 -ngl 999 \
  --spec-type draft-dflash --spec-draft-n-max 6 \
  --spec-draft-model "$DRAFT" --spec-draft-ngl 999 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja \
  --host 127.0.0.1 --port 8080
หากพอร์ตไม่ว่างให้ใช้พอร์ตอื่น และปรับการตรวจด้านล่างให้ตรงกัน อย่าสร้างกฎส่งต่อเราเตอร์ tunnel สาธารณะ หรือ listener ที่ bind ออกภายนอกสำหรับการรันครั้งแรกนี้ การจำกัดด้วย loopback จำกัดการเข้าถึงเครือข่าย แต่ไม่ได้ทำให้เครื่องมือของ agent ที่เชื่อมต่ออยู่ปลอดภัยโดยอัตโนมัติ
- ตรวจความพร้อมก่อนเชื่อมต่อสิ่งอื่น เปิด Terminal อีกหน้าต่างแล้วรัน:
curl --fail http://127.0.0.1:8080/health
เซิร์ฟเวอร์แยกสถานะกำลังโหลดออกจากพร้อมใช้งาน เมื่อพร้อมแล้วให้เปิด http://127.0.0.1:8080 ในเครื่องและลองถามข้อความสั้น ๆ ก่อนคำขอภาพ เอกสาร health และเว็บอินเทอร์เฟซของเซิร์ฟเวอร์ llama.cpp เข้าดูเมื่อ 16 ตุลาคม 2026 ยังคงไม่เชื่อมต่อเครื่องมือภายนอกจนกว่าคำตอบพื้นฐานจะทำงานได้
- วัดงานทั้งหมดก่อนขยายขอบเขต บนระบบ GPU แยก ให้ตรวจหน่วยความจำก่อนเริ่มและระหว่าง prompt ตัวแทน:
nvidia-smi --query-gpu=name,memory.total,memory.used,memory.free --format=csv
ข้อมูลเหล่านี้เป็นการสังเกตจากอุปกรณ์ ไม่ใช่ยอดสูงสุดของทั้ง process หรือวิธีคำนวณหน่วยความจำรวม NVIDIA อธิบายการรายงานหน่วยความจำที่ขึ้นกับแพลตฟอร์มไว้ในเอกสารอ้างอิง NVIDIA System Management Interface เข้าดูเมื่อ 16 ตุลาคม 2026 เก็บบันทึกการจัดสรรของ runtime ด้วย และตรวจหน่วยความจำโฮสต์แยกต่างหาก
เปรียบเทียบ prompt สั้น prompt ปกติที่ยาวที่สุด และภาพเอกสารตัวแทน บันทึกความถูกต้อง เวลาจนเสร็จ การสังเกตหน่วยความจำ และความล้มเหลวในการจัดสรร ทำซ้ำเมื่อเปิด editor และเบราว์เซอร์ตามปกติ การกำหนดค่าที่ทำงานได้เฉพาะเมื่อต้องปิดสภาพแวดล้อมทำงานส่วนที่เหลือยังไม่ผ่านข้อกำหนดเดิม
หากล้มเหลว ให้เปลี่ยนทีละปัจจัยและระบุการกำหนดค่าใหม่ การลดบริบท ขนาด microbatch หรือปริมาณประวัติเครื่องมือตอบคำถามคนละข้อ ส่วนการเอาตัวร่างออกเป็นการทดลองอีกแบบ ไม่ใช่สูตรที่เผยแพร่ เก็บความล้มเหลวและอินพุตที่กระตุ้นไว้ เพื่อไม่ให้ prompt สั้นที่สำเร็จในภายหลังลบปัญหาของภาระงานที่ยังแก้ไม่ตก
สรุป: เลือกซื้อโดยคำนึงถึง working set
จุดน่าสนใจของ Bolt คือโมเดลขนาดใหญ่ที่เปิดใช้งานแบบกระจายและบีบอัดเพื่อทำงานในเครื่อง คุณค่าในทางปฏิบัติขึ้นกับสิ่งที่เหลือพื้นที่อยู่ข้าง ๆ ทั้งหลักฐาน อินพุตภาพ สถานะลำดับ และแอปพลิเคชันที่จำเป็นต่อการทำงานให้เสร็จ
คำถามยอมรับที่ถูกต้องไม่ใช่ “โมเดล 24GB โหลดได้หรือยัง” แต่คือ “เครื่องนี้ทำภาระงานปกติของฉันได้จริง พร้อมคำตอบที่เชื่อถือได้และมีพื้นที่พอสำหรับรอบถัดไปหรือไม่” นั่นคืองบหน่วยความจำที่ควรใช้ตัดสินใจซื้อ
แหล่งข้อมูล
ข้อมูลเปิดตัวลงวันที่ 15 ตุลาคม 2026 ส่วน model card และเอกสารที่ปรับปรุงต่อเนื่องเข้าดูเมื่อ 16 ตุลาคม 2026 ขั้นตอนเป็นคำแนะนำที่ดัดแปลงมา ไม่ใช่ผลทดสอบภาคปฏิบัติ แผนภาพต้นฉบับเป็นภาพอธิบาย ไม่ใช่สินทรัพย์ทางการหรือกราฟประสิทธิภาพ
- ประกาศเปิดตัวของ NVIDIA สำหรับชื่อโมเดลทั้งสามและกำหนดการเปิดตัว
- ภาพรวมงานวิจัย Bolt ของ NVIDIA และ รายงานเทคนิค สำหรับการบีบอัด ความละเอียด และรายละเอียดหน่วยความจำโดยประมาณ
- model card GGUF ของ NVIDIA สำหรับตารางฮาร์ดแวร์จริง ชื่อไฟล์ checkpoint และสูตรเริ่มต้น
- เอกสาร build, server, multimodal และ เครื่องมือ GGUF ของ llama.cpp สำหรับพฤติกรรม runtime
- คำอธิบาย cache ของ Hugging Face, กลยุทธ์ cache, คู่มือ CLI และ เอกสาร NVIDIA SMI สำหรับกลไกเฉพาะและคำสั่งตรวจสอบ
คำแนะนำ Telli.sh (ไม่บังคับ): เก็บแหล่งข้อมูลไว้เบื้องหลังการตัดสินใจ
การเปรียบเทียบ agent ทำได้ง่ายขึ้นเมื่อเก็บต้นฉบับ บันทึกของคุณ และผลจากการทดลองของคุณเองไว้ด้วยกัน สร้างบัญชี Telli.sh เพื่อจัดระเบียบเนื้อหาเหล่านั้นเป็นข้อมูลอ้างอิงที่กลับมาดูได้เมื่อผลิตภัณฑ์เปลี่ยนแปลง