Model 24GB bukan komputer 24GB: bajet memori Nemotron Bolt
Fahami 74B parameter keseluruhan dan 9B parameter aktif Nemotron Bolt, pemberat natif 2-bit, serta memori konteks, penglihatan, model draf dan masa jalan yang diperlukan oleh resipi setempatnya.
Anda mempunyai GPU dengan memori 24GB. Model baharu pula mempunyai “24GB” dalam namanya. Tentunya dua angka itu sudah cukup untuk menentukan pembelian?
Bukan untuk beban kerja AI setempat yang lengkap. Pengumuman NVIDIA pada 15 Oktober memperkenalkan Nemotron 3.5 Bolt 74B-A9B 24GB sebagai model bahasa-penglihatan yang boleh digunakan secara setempat dengan kuantisasi natif 2-bit. Namanya menggambarkan sasaran pengoptimuman, bukannya janji bahawa setiap panjang konteks, permintaan imej dan konfigurasi ejen muat pada kad grafik 24GB. Pengumuman NVIDIA, 15 Oktober 2026.
Soalan yang berguna ialah apa lagi yang diperlukan selepas model dimuatkan. Panduan ini membezakan parameter yang disimpan daripada pengiraan aktif, menerangkan pengguna memori yang lain dan menunjukkan persediaan yang hanya mengikat kepada loopback berdasarkan resipi sebenar dalam kad model. Mulakan dengan beban kerja yang anda perlukan, kemudian tentukan sama ada mesin mampu menampungnya.
Hero: penerangan editorial asal tentang bajet seluruh beban kerja, bukannya tangkap layar rasmi atau peruntukan memori yang diukur. Saiz komponen tidak digambarkan.
Bilangan aktif yang lebih kecil tidak menjadikannya muat turun 9B
Bolt mempunyai 74 bilion parameter keseluruhan dan kira-kira 9 bilion parameter aktif bagi setiap token. Penghala campuran pakarnya memilih sebahagian daripada rangkaian yang disimpan. Model ini ialah keturunan Super VL 120B-A12B yang dimampatkan, bukannya model tumpat 9B. Gambaran penyelidikan NVIDIA tentang Bolt, 15 Oktober 2026.
Perbezaan yang perlu diingati ialah: parameter aktif membantu menjelaskan kerja yang dilakukan untuk sesuatu token; jumlah parameter membantu menjelaskan perkara yang mesti disimpan. Tiada satu pun angka itu sahaja yang menentukan kelajuan aplikasi. Peletakan data, lebar jalur memori, kernel, panjang input dan aplikasi di sekelilingnya semuanya mempengaruhi hasil.
Ejen yang menyemak kod masih memerlukan akses kepada pakar yang tidak dipilih untuk token sebelumnya. Memindahkan data antara storan, memori sistem dan memori GPU tidak sama dengan menyediakan semuanya pada pemecut. Oleh itu, bilangan parameter aktif yang lebih kecil bukan alasan untuk mengira keperluan perkakasan seolah-olah parameter selebihnya tidak wujud.
Nama keluarga model ini juga wajar dibandingkan dengan tepat:
| Model | Maksud nama itu | Status pada 16 Oktober |
|---|---|---|
| Nemotron 3.5 Super VL | Model 120B yang berasingan | Telah dikeluarkan |
| Nemotron 3.5 Bolt 74B-A9B 24GB | Pilihan model setempat termampat yang dibincangkan di sini | Telah dikeluarkan |
| Nemotron 3.5 Bolt E4B 4GB | Tawaran lebih kecil yang berasingan untuk peranti pinggir/perbualan | Diumumkan untuk 23 Oktober |
Status keluaran ini berdasarkan pengumuman 15 Oktober. Pada tarikh artikel ini, E4B belum tersedia dan bukan pengganti tersedia yang dibuktikan oleh arahan ini. Hasil penggunaan perusahaan Super VL juga tidak patut dianggap sebagai hasil Bolt pada komputer meja.
Pemberat natif 2-bit menyelesaikan satu bahagian bajet
Istilah “natif 2-bit” bermakna kerana pemampatan agresif sebahagian daripada pembangunan model ini, bukan sekadar pengguna memilih eksport yang lebih kecil selepas itu. NVIDIA menggunakan penyulingan peka kuantisasi untuk memulihkan keupayaan selepas ketepatan dikurangkan. Pemberat pakarnya menggunakan IQ2_XXS pada 2.0625 bit setiap elemen, sementara komponen lain mengekalkan format yang berbeza. Rangkaian ini menggunakan ketepatan bercampur, bukannya setiap bahagiannya seragam dua bit. Penerangan pemampatan dan kuantisasi NVIDIA, 15 Oktober 2026.
Sebagai semakan aritmetik yang sengaja tidak realistik, 74 bilion nilai yang disimpan tepat pada dua bit akan menggunakan 18.5 bilion bait. Itu sekadar ilustrasi, bukannya saiz fail Bolt atau keperluan pelancaran: pengiraan itu mengabaikan campuran ketepatan sebenar, metadata dan keadaan pelaksanaan. Mendarab bilangan parameter utama dengan kedalaman bit utama tidak boleh menggantikan pemeriksaan terhadap checkpoint tertentu.
GGUF menjawab soalan yang berbeza. Ia ialah format fail model yang digunakan dalam ekosistem llama.cpp untuk membawa tensor dan maklumat berkaitan. Format ini bukan janji pemampatan kedua yang ditambah di atas “2-bit”, dan memuat turun GGUF tidak dengan sendirinya membuktikan bahawa masa jalan tertentu memahami model itu. Dokumentasi alat GGUF llama.cpp, dicapai pada 16 Oktober 2026.
Pecahan memori anggaran NVIDIA sendiri menjadikan perbezaan ini nyata: Jadual 2 menyenaraikan 22.01GB untuk pemberat, jumlah 23.83GB tanpa penglihatan dan tambahan 1.68GB untuk pengekod serta projektor penglihatan. Ini anggaran vendor bagi konfigurasi dalam laporan tersebut, bukannya ukuran memori daripada artikel ini. Laporan yang sama menerangkan sasaran reka bentuk bawah 24GB pada saiz kelompok satu dan konteks 128K. Laporan teknikal Bolt, Jadual 2 dan Bahagian 2.3, dipautkan pada 15 Oktober 2026.
Kesimpulannya bukan bahawa penjenamaan itu sebenarnya cuma merujuk kepada pemberat. Maksudnya, sasaran penggunaan mempunyai andaian tersendiri. Ubah andaian itu dan keperluan memori turut berubah.
Bajetkan seluruh set kerja, bukan pemberat sahaja
Anggap penggunaan model sebagai cukai konteks di atas model yang disimpan: kerja yang anda minta sistem kekalkan dan proses juga memerlukan ruang. Untuk perancangan, asingkan pemberat, keadaan jujukan, pemprosesan penglihatan, penyahkodan spekulatif dan ruang kerja masa jalan. Sediakan ruang tambahan untuk komputer meja dan aplikasi yang memang mahu anda biarkan terbuka.
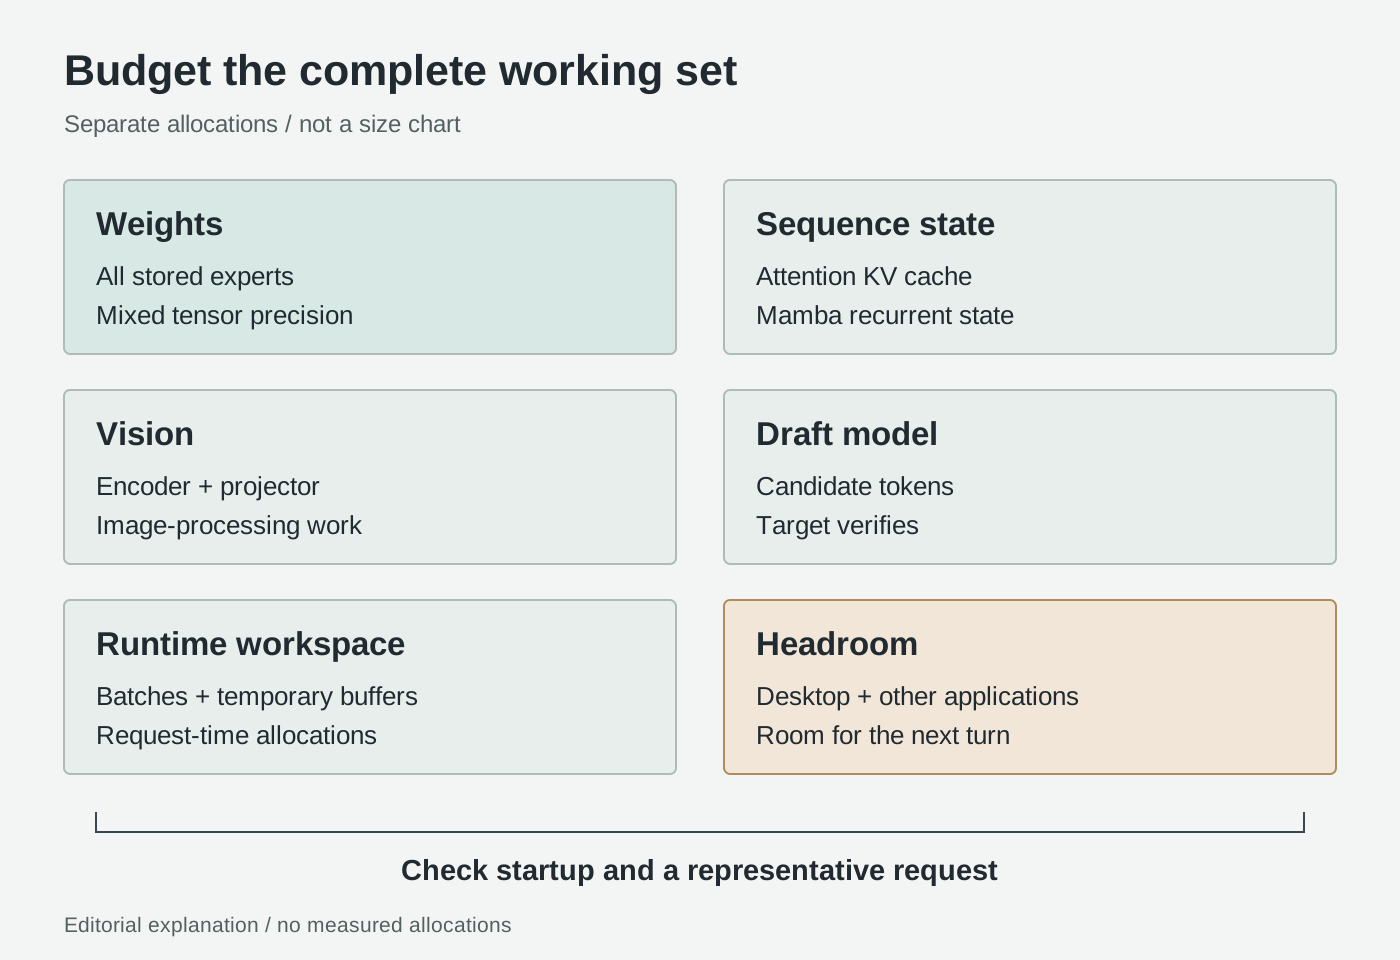
Penerangan editorial asal, bukan perkadaran yang diukur. Mekanisme: dokumentasi cache Hugging Face, panduan multimodal llama.cpp dan laporan NVIDIA Bolt, dicapai pada 16 Oktober 2026.
Keadaan jujukan bukan salinan pemberat yang satu lagi. Model perhatian autoregresif menyimpan kunci dan nilai daripada token terdahulu supaya boleh menggunakannya semula semasa penjanaan. Jujukan tersimpan yang lebih panjang memerlukan lebih banyak storan cache perhatian; butirannya bergantung pada seni bina dan perwakilan cache. Hugging Face, “Cara cache berfungsi,” dicapai pada 16 Oktober 2026.
Bolt ialah model hibrid dengan lapisan Mamba dan perhatian, jadi anggaran cache umum untuk model Transformer sepenuhnya bukan kalkulator lengkap untuknya. Keadaan berulang dan cache perhatian ialah peruntukan yang berbeza; periksa perkara yang benar-benar diwujudkan oleh masa jalan. Perbezaan seni bina itu didokumenkan dalam Jadual 1 laporan Bolt, dicapai pada 16 Oktober 2026.
Bagi ejen, konteks tersimpan merangkumi lebih daripada soalan yang anda taip. Arahan sistem, skema alat, sejarah perbualan, petikan yang diperoleh dan respons alat semuanya bersaing untuk ruang yang juga diperlukan jawapan. Transkrip yang mengandungi senarai repositori berulang boleh menghabiskan bajet berguna tanpa menambah bukti berguna. Mengekalkan keadaan tugas yang ringkas ialah keputusan aliran kerja, bukan sekadar helah mengatasi had perkakasan.
Penglihatan memperkenalkan laluan pemprosesan yang berasingan. llama.cpp memasangkan model bahasa dengan fail projektor multimodal melalui --mmproj; dokumentasinya menyatakan bahawa komponen ini dipunggah ke GPU secara lalai. Panduan multimodal llama.cpp, dicapai pada 16 Oktober 2026. Oleh itu, memuatkan fail model bahasa sahaja tidak sama dengan persediaan lengkap yang boleh mengendalikan imej.
Untuk tugas dokumen, bezakan pembacaan teks yang diekstrak daripada pentafsiran halaman yang dirender. Perenggan teks biasa tidak mengandungi hubungan visual antara tajuk lajur dengan selnya. Sebaliknya, menghantar imej halaman yang susun aturnya tidak penting menambah kerja tanpa semestinya memperbaik jawapan. Tentukan perwakilan yang mengekalkan bukti yang diperlukan untuk soalan anda.
Penggubal draf spekulatif ialah model tambahan. Penggubal LiLiCorr Bolt mencadangkan token calon untuk disahkan oleh model sasaran. Tujuannya ialah mempercepat penyahkodan, tetapi checkpoint tambahan dan keadaan pelaksanaannya tetap memerlukan memori. Penerangan LiLiCorr oleh NVIDIA, 15 Oktober 2026. Kehadiran penggubal draf tidak menjamin tugas anda akan selesai dengan lebih pantas.
Ruang kerja masa jalan juga berasingan. Kelompok pemprosesan prompt dan penimbal pengiraan sementara perlu dimasukkan dalam bajet bersama keadaan kekal. Pelayan mendedahkan saiz kelompok logik dan saiz kelompok mikro fizikal; kedua-duanya tidak boleh disamakan dengan bilangan perbualan serentak. Rujukan pilihan pelayan llama.cpp, dicapai pada 16 Oktober 2026. Konfigurasi yang berjaya bermula masih perlu diuji dengan permintaan yang mewakili penggunaan sebenar.
Jadual perkakasan rasmi lebih berguna daripada akhiran nama produk
Konfigurasi yang diterbitkan NVIDIA:
| Resipi | Perkakasan | Konteks | Jujukan |
|---|---|---|---|
| 28GB | RTX Spark 64GB atau RTX diskret 32GB+ | 65,536 | 1 |
| 32GB | RTX Spark 128GB atau RTX diskret 48GB+ | 262,144 | 1 |
Sumber: Panduan Mula Pantas NVIDIA, dicapai pada 16 Oktober 2026.
Baris ini tidak meliputi GPU diskret 24GB atau membuktikan sokongan Mac. RAM hos bukan VRAM diskret tambahan.
Pandangan kami: pilih konfigurasi yang boleh diulang, bukannya tangkap layar yang menunjukkan model berjaya dimuatkan. Jika pembelian bergantung pada model ini, minta demonstrasi dengan input yang anda mahu gunakan dan aplikasi latar yang biasa anda buka. Perkara ini amat penting untuk imej dokumen dan ejen yang berjalan lama, kerana permintaan pertama mungkin jauh lebih kecil berbanding permintaan kemudian.
Pilih konteks mengikut tugas, bukan nilai maksimum
Pertimbangkan tiga tugas permulaan yang bersifat ilustrasi, bukannya percubaan yang dilaporkan.
Seorang pembangun meminta penjelasan tentang ujian yang gagal, lalu memberikan ralat, fungsi berkaitan dan satu kebergantungan berdekatan. Hasil yang berguna ialah diagnosis yang terikat pada baris tertentu, diikuti perubahan yang dicadangkan. Sebelum menambah seluruh repositori, periksa sama ada maklumat yang hilang itu cuma antara muka tertentu atau bingkai tindanan yang lain. Dengan cara ini, soalan lebih mudah diperiksa dan andaian yang salah lebih mudah dikesan.
Seorang penyelidik membandingkan jadual merentasi dua halaman dokumen. Uji sama ada model memadankan tajuk, unit, nota kaki dan nilai dengan betul. Gunakan imej halaman sebenar apabila hubungan tersebut penting, minta bukti bagi setiap halaman dan semak sampel sel terhadap sumber asal. Ringkasan yang lancar tetapi menukar dua lajur tetap hasil yang gagal walaupun disiapkan dengan pantas.
Pembantu setempat mencari dalam folder yang diluluskan dan menyediakan draf laporan. Tekanan pada memori boleh meningkat apabila bahan yang diperoleh dan respons alat berulang kali ditambah. Berikan tugas baca sahaja terlebih dahulu, hadkan skop carian dan minta pembantu menamakan fail yang menyokong setiap kesimpulan. Jangan berikan kebenaran menulis atau shell semata-mata untuk melihat sama ada model boleh menghasilkan pelan yang berguna.
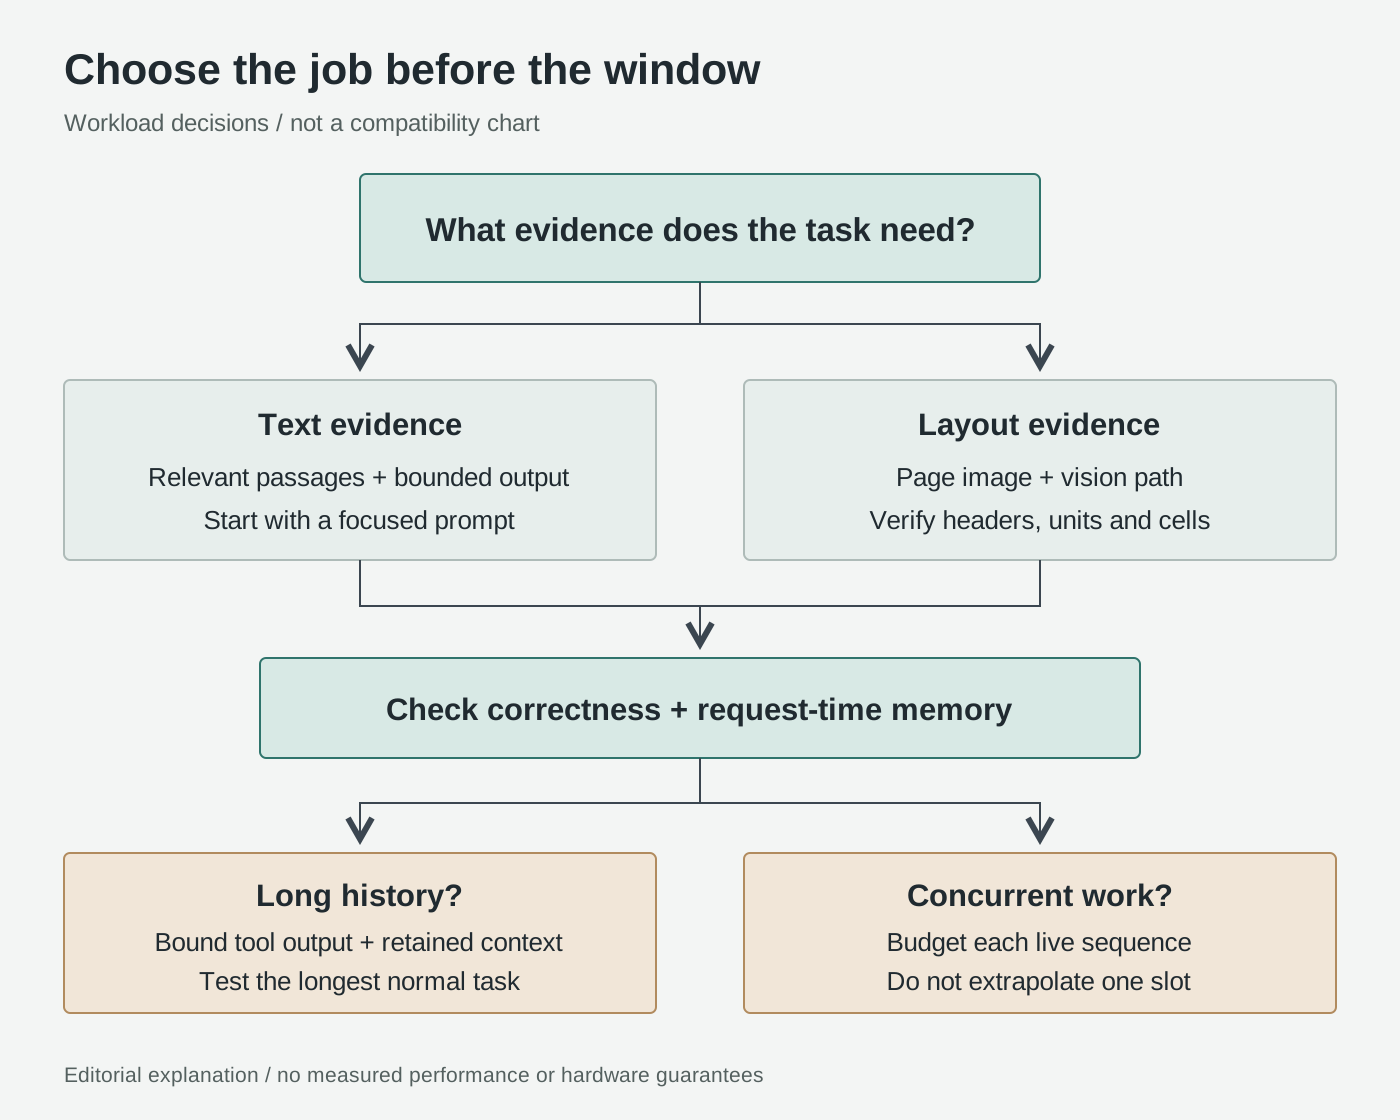
Penerangan editorial asal tentang pemilihan beban kerja, bukannya penanda aras atau carta keserasian. Lihat strategi cache Hugging Face dan pengendalian multimodal llama.cpp, dicapai pada 16 Oktober 2026.
Cache berkuantisasi boleh mengurangkan storan berbanding cache berketepatan lebih tinggi, manakala pemunggahan memindahkan tekanan kepada aras memori lain dan boleh menukar kadar pemprosesan demi kapasiti. Ini pertukaran umum, bukannya bukti bahawa setiap strategi cache dalam Transformers tersedia untuk penggunaan GGUF ini. Strategi cache Hugging Face, dicapai pada 16 Oktober 2026.
Keutamaan praktikal ialah kepadatan bukti: kekalkan bahan yang diperlukan untuk menjawab soalan, simpan sumber asal secara berasingan dan buang rangka kerja berulang. Sediakan ruang untuk jawapan juga. Tetingkap yang dikonfigurasi lebih besar tidak menjadikan sejarah yang tidak relevan berguna.
Mulakan secara setempat, kemudian uji beban kerja yang benar-benar anda perlukan
Contoh Linux Bash berikut menyasarkan konfigurasi GPU diskret NVIDIA yang disokong. Contoh ini mengandaikan Git, Python, CMake, rantaian alat C++, pemacu NVIDIA yang serasi dan toolkit CUDA sudah dipasang. Ini prosedur untuk dijalankan pada mesin anda, bukannya laporan pemasangan yang telah selesai.
- Bina masa jalan yang berkaitan dan periksa pilihannya. Gunakan laluan binaan daripada kod sumber, bukannya satu baris arahan umum daripada halaman model. Ikuti panduan binaan CUDA llama.cpp, dicapai pada 16 Oktober 2026. Simpan commit dan versi binari yang dilaporkan bersama konfigurasi anda.
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git rev-parse HEAD
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON
cmake --build build --config Release -j
./build/bin/llama-server --version
./build/bin/llama-server --help
Pastikan output bantuan merangkumi draft-dflash, --spec-draft-model, --spec-draft-n-max, --cache-type-k, --cache-type-v, --flash-attn dan --jinja. Label versi pakej sahaja tidak membuktikan sokongan. Jika binari anda menolak pilihan itu, selesaikan ketidakpadanan binaan sebelum memuat turun checkpoint besar; jangan diam-diam menggantikan resipi dengan bendera penyahkodan spekulatif lama. Nama pilihan itu didokumenkan dalam rujukan pelayan semasa, dicapai pada 16 Oktober 2026.
- Muat turun tiga fail dalam Panduan Mula Pantas NVIDIA, dicapai pada 16 Oktober 2026. Sintaks muat turun mengikut panduan CLI Hugging Face, dicapai pada 16 Oktober 2026. Periksa ruang cakera terlebih dahulu.
python3 -m venv .venv-hf
source .venv-hf/bin/activate
python -m pip install --upgrade huggingface_hub
MODEL_DIR="$PWD/models/nemotron-bolt"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --local-dir "$MODEL_DIR"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf \
  --local-dir "$MODEL_DIR"
MODEL="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
MMPROJ="$MODEL_DIR/mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
DRAFT="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf"
Catat revisi repositori dan hash fail setempat sebelum menggunakan persediaan ini sebagai garis dasar perbandingan. Kemas kini fail atau masa jalan kemudian hendaklah dibuat dengan sengaja, bukannya menjadi perbezaan yang tidak dapat dijelaskan antara dua pelaksanaan.
- Gunakan resipi 28GB NVIDIA dengan ikatan loopback yang dinyatakan secara jelas.
./build/bin/llama-server \
  --model "$MODEL" --mmproj "$MMPROJ" \
  --batch-size 2048 --ubatch-size 512 \
  --ctx-size 65536 --parallel 1 -ngl 999 \
  --spec-type draft-dflash --spec-draft-n-max 6 \
  --spec-draft-model "$DRAFT" --spec-draft-ngl 999 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja \
  --host 127.0.0.1 --port 8080
Gunakan port kosong jika perlu, kemudian sesuaikan pemeriksaan di bawah. Jangan buat peraturan pemajuan penghala, terowong awam atau pendengar yang terikat secara luaran untuk pelaksanaan pertama ini. Loopback mengehadkan jangkauan rangkaian; ia tidak menjadikan alat ejen yang disambungkan tidak berbahaya.
- Periksa kesediaan sebelum menyambungkan apa-apa yang lain. Dalam terminal lain, jalankan:
curl --fail http://127.0.0.1:8080/health
Pelayan mendokumenkan respons pemuatan secara berasingan daripada status sedia. Setelah sedia, buka http://127.0.0.1:8080 secara setempat dan cuba soalan teks ringkas sebelum permintaan imej. Dokumentasi kesihatan pelayan dan antara muka web llama.cpp, dicapai pada 16 Oktober 2026. Biarkan alat luaran terputus sehingga respons asas berfungsi.
- Ukur keseluruhan tugas sebelum mengembangkannya. Pada sistem GPU diskret, periksa memori sebelum pelancaran dan semasa prompt yang mewakili penggunaan sebenar:
nvidia-smi --query-gpu=name,memory.total,memory.used,memory.free --format=csv
Ini pemerhatian peranti, bukannya bacaan puncak lengkap bagi proses atau kaedah perakaunan memori bersatu. NVIDIA mendokumenkan pelaporan memori yang bergantung pada platform dalam rujukan NVIDIA System Management Interface, dicapai pada 16 Oktober 2026. Simpan juga log peruntukan masa jalan dan periksa memori hos secara berasingan.
Bandingkan prompt ringkas, prompt biasa anda yang paling panjang dan imej dokumen yang mewakili penggunaan sebenar. Catat ketepatan, masa sehingga selesai, pemerhatian memori dan sebarang kegagalan peruntukan. Ulangi ketika editor dan pelayar biasa anda terbuka. Persediaan yang hanya berfungsi selepas aplikasi lain ditutup belum memenuhi keperluan asal.
Jika gagal, ubah satu faktor pada satu masa dan namakan konfigurasi baharu itu. Mengurangkan konteks, saiz kelompok mikro atau jumlah sejarah alat menjawab soalan yang berbeza; membuang penggubal draf ialah percubaan lain, bukannya resipi yang diterbitkan. Kekalkan kegagalan dan input yang mencetuskannya supaya kejayaan prompt ringkas kemudian tidak memadamkan hakikat bahawa beban kerja itu masih belum diselesaikan.
Kesimpulannya: beli untuk keseluruhan set kerja
Proposisi menarik Bolt ialah model besar yang diaktifkan secara jarang dan dimampatkan untuk kerja setempat. Nilai praktikalnya bergantung pada perkara yang muat bersamanya: bukti, input visual, keadaan jujukan dan aplikasi yang diperlukan untuk menyiapkan tugas.
Soalan penerimaan yang tepat bukan “Adakah model 24GB berjaya dimuatkan?” tetapi “Bolehkah mesin khusus ini menyiapkan beban kerja biasa saya, dengan jawapan yang boleh diharap dan ruang yang cukup untuk giliran seterusnya?” Itulah bajet memori yang berbaloi untuk dibeli.
Sumber
Maklumat keluaran bertarikh 15 Oktober 2026; kad model yang dipautkan dan dokumentasi yang sentiasa dikemas kini disemak pada 16 Oktober 2026. Prosedur ini ialah arahan yang disesuaikan, bukannya hasil ujian langsung. Rajah asal ialah skema penerangan, bukan aset rasmi atau plot prestasi.
- Pengumuman keluaran NVIDIA untuk tiga nama model dan masa keluarannya.
- Gambaran penyelidikan NVIDIA Bolt dan laporan teknikal tentang pemampatan, ketepatan dan pecahan memori anggaran.
- Kad model GGUF NVIDIA untuk jadual perkakasan sebenar, nama fail checkpoint dan resipi pelancaran.
- Dokumentasi binaan llama.cpp, pelayan, multimodal dan alat GGUF tentang tingkah laku masa jalan.
- Penerangan cache Hugging Face, strategi cache, panduan CLI dan rujukan NVIDIA SMI tentang mekanisme dan arahan pemeriksaan khusus.
Syor pilihan Telli.sh: simpan sumber di sebalik keputusan anda
Membandingkan ejen lebih mudah apabila sumber asal, nota anda dan hasil percubaan sendiri kekal bersama. Cipta akaun Telli.sh untuk menyusun bahan itu sebagai rujukan yang boleh anda kunjungi semula apabila produk berubah.