Model 24GB bukan komputer 24GB: anggaran memori Nemotron Bolt
Pahami 74B parameter total dan 9B parameter aktif Nemotron Bolt, bobot native 2-bit, serta kebutuhan memori untuk konteks, visi, model draf, dan runtime pada konfigurasi lokalnya.
Anda memiliki GPU dengan memori 24GB. Model baru mencantumkan “24GB” di namanya. Apakah dua angka itu cukup untuk menentukan keputusan pembelian?
Tidak untuk seluruh beban kerja AI lokal. Pengumuman NVIDIA pada 15 Oktober memperkenalkan Nemotron 3.5 Bolt 74B-A9B 24GB sebagai model bahasa-visi yang dapat diterapkan secara lokal dengan kuantisasi native 2-bit. Namanya menggambarkan sasaran optimasi, bukan janji bahwa setiap panjang konteks, permintaan gambar, dan konfigurasi agen muat di kartu grafis 24GB. Pengumuman NVIDIA, 15 Oktober 2026.
Pertanyaan yang berguna adalah apa yang masih tersisa setelah model dimuat. Panduan ini memisahkan parameter yang disimpan dari komputasi aktif, menjelaskan pemakai memori lainnya, dan menguraikan konfigurasi yang hanya terikat ke loopback berdasarkan resep kartu model yang sebenarnya. Mulailah dari beban kerja yang Anda butuhkan, lalu tentukan apakah mesin mampu menjalankannya secara berkelanjutan.
Hero: penjelasan editorial orisinal tentang anggaran seluruh beban kerja, bukan tangkapan layar resmi atau alokasi terukur. Ukuran komponen tidak digambarkan.
Jumlah parameter aktif yang lebih kecil tidak menjadikannya unduhan 9B
Bolt memiliki total 74 miliar parameter dan sekitar 9 miliar parameter aktif per token. Router mixture-of-experts-nya memilih sebagian jaringan yang tersimpan. Model ini adalah turunan terkompresi dari Super VL 120B-A12B, bukan model padat 9B. Ikhtisar riset NVIDIA Bolt, 15 Oktober 2026.
Inilah perbedaan yang perlu diingat: parameter aktif membantu menjelaskan komputasi yang dilakukan untuk satu token; parameter total membantu menjelaskan apa yang perlu disimpan. Tak satu pun dari kedua angka itu sendirian menentukan kecepatan aplikasi. Penempatan, bandwidth memori, kernel, panjang masukan, dan aplikasi di sekitarnya semuanya memengaruhi hasil.
Agen yang meninjau kode tetap memerlukan akses ke pakar yang tidak dipilih untuk token sebelumnya. Memindahkan data antara penyimpanan, memori sistem, dan memori GPU tidak sama dengan menyediakan semuanya di akselerator. Karena itu, jumlah parameter aktif yang lebih kecil bukan izin untuk menghitung kebutuhan perangkat keras seolah-olah parameter lainnya tidak pernah ada.
Nama-nama dalam keluarga ini juga perlu dibandingkan secara tepat:
| Model | Acuan nama tersebut | Status pada 16 Oktober |
|---|---|---|
| Nemotron 3.5 Super VL | Model 120B yang terpisah | Dirilis |
| Nemotron 3.5 Bolt 74B-A9B 24GB | Opsi model lokal terkompresi yang dibahas di sini | Dirilis |
| Nemotron 3.5 Bolt E4B 4GB | Produk edge/percakapan terpisah yang lebih kecil | Diumumkan untuk 23 Oktober |
Status rilis tersebut berasal dari pengumuman 15 Oktober. Pada tanggal artikel ini, E4B belum tersedia dan belum ditunjukkan sebagai pengganti yang bisa digunakan melalui perintah-perintah ini. Hasil penerapan Super VL untuk perusahaan juga tidak boleh dianggap sebagai hasil Bolt di komputer desktop.
Bobot native 2-bit mengatasi satu bagian dari anggaran
Istilah “native 2-bit” bermakna karena kompresi agresif merupakan bagian dari pengembangan model ini, bukan sekadar pengguna memilih hasil ekspor yang lebih kecil belakangan. NVIDIA menggunakan distilasi sadar-kuantisasi untuk memulihkan kemampuan setelah presisi dikurangi. Bobot pakarnya menggunakan IQ2_XXS pada 2.0625 bit per elemen, sementara komponen lain mempertahankan format berbeda. Jaringan ini memakai presisi campuran, bukan dua bit secara seragam di semua bagian. Penjelasan kompresi dan kuantisasi NVIDIA, 15 Oktober 2026.
Sebagai pemeriksaan aritmetika yang sengaja tidak realistis, 74 miliar nilai yang masing-masing disimpan tepat pada dua bit akan menempati 18.5 miliar bita. Itu sekadar ilustrasi, bukan ukuran berkas Bolt atau kebutuhan peluncurannya: perhitungan itu mengabaikan campuran presisi sebenarnya, metadata, dan keadaan eksekusi. Mengalikan angka utama jumlah parameter dengan angka utama kedalaman bit tidak dapat menggantikan pemeriksaan checkpoint tertentu.
GGUF menjawab pertanyaan yang berbeda. Ini format berkas model yang digunakan dalam ekosistem llama.cpp, yang memuat tensor dan informasi terkait. GGUF bukan janji kompresi kedua yang ditambahkan di atas “2-bit”, dan mengunduh GGUF tidak dengan sendirinya membuktikan runtime tertentu memahami model tersebut. Dokumentasi perkakas GGUF llama.cpp, diakses 16 Oktober 2026.
Rincian perkiraan memori dari NVIDIA sendiri memperjelas perbedaan ini: Tabel 2 mencantumkan 22.01GB untuk bobot, total 23.83GB tanpa visi, dan tambahan 1.68GB untuk encoder serta proyektor visi. Ini perkiraan vendor untuk konfigurasi dalam laporan, bukan pengukuran memori dari artikel ini. Laporan yang sama menjelaskan sasaran desain di bawah 24GB pada ukuran batch satu dan konteks 128K. Laporan teknis Bolt, Tabel 2 dan Bagian 2.3, ditautkan 15 Oktober 2026.
Intinya bukan bahwa merek tersebut diam-diam merujuk hanya pada ukuran bobot. Intinya adalah sasaran penerapan memiliki asumsi. Ubah asumsinya, dan kebutuhan memori pun berubah.
Anggarkan seluruh working set, bukan hanya bobot
Bayangkan penerapan ini memiliki <strong>pajak konteks</strong> di atas model yang tersimpan: pekerjaan yang Anda minta agar dipertahankan dan diproses sistem juga membutuhkan ruang. Untuk perencanaan, pisahkan bobot, keadaan urutan, pemrosesan visi, dekode spekulatif, dan ruang kerja runtime. Sisakan ruang tambahan untuk desktop dan aplikasi yang memang ingin tetap terbuka.
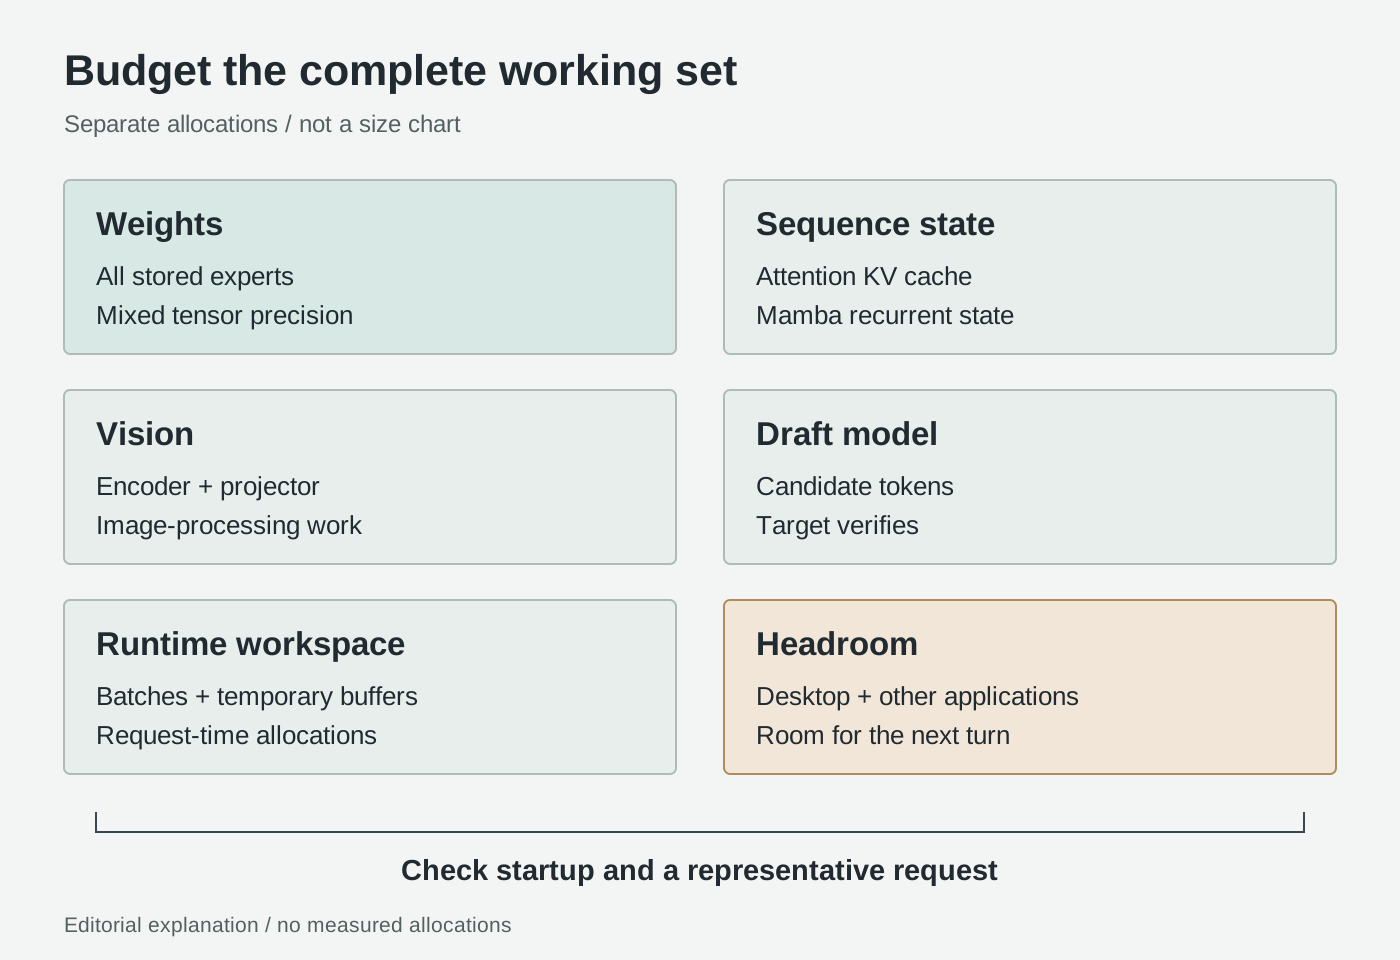
Penjelasan editorial orisinal, bukan proporsi terukur. Mekanisme: dokumentasi caching Hugging Face, panduan multimodal llama.cpp, dan laporan NVIDIA Bolt, diakses 16 Oktober 2026.
<strong>Keadaan urutan bukan salinan bobot lainnya.</strong> Model atensi autoregresif menyimpan cache key dan value dari token sebelumnya agar dapat menggunakannya kembali selama generasi. Urutan yang dipertahankan lebih panjang membutuhkan lebih banyak penyimpanan cache atensi; perinciannya bergantung pada arsitektur dan representasi cache. Hugging Face, “Cara kerja caching,” diakses 16 Oktober 2026.
Bolt merupakan model hibrida dengan lapisan Mamba dan atensi, jadi perkiraan cache generik untuk Transformer sepenuhnya bukan kalkulator lengkap untuknya. Keadaan rekuren dan cache atensi merupakan alokasi yang berbeda; periksa apa yang benar-benar dibuat runtime. Perbedaan arsitektur ini didokumentasikan di Tabel 1 laporan Bolt, diakses 16 Oktober 2026.
Bagi agen, konteks yang dipertahankan mencakup lebih dari pertanyaan yang Anda ketik. Instruksi sistem, skema alat, riwayat percakapan, bagian yang diambil, dan respons alat semuanya bersaing memperebutkan ruang yang diperlukan untuk jawaban. Transkrip yang berisi daftar repositori berulang dapat menghabiskan anggaran berguna tanpa menambah bukti yang bermanfaat. Menjaga status tugas tetap ringkas merupakan keputusan alur kerja, bukan sekadar siasat perangkat keras.
<strong>Visi menghadirkan jalur pemrosesan tersendiri.</strong> llama.cpp memasangkan model bahasa dengan berkas proyektor multimodal melalui --mmproj; dokumentasinya menyebut komponen ini secara bawaan dialihkan ke GPU. Panduan multimodal llama.cpp, diakses 16 Oktober 2026. Karena itu, memuat berkas model bahasa saja bukan konfigurasi lengkap yang mampu menangani gambar.
Untuk pekerjaan dokumen, bedakan membaca teks hasil ekstraksi dari menafsirkan halaman yang dirender. Paragraf teks biasa tidak memuat hubungan visual antara judul kolom dan sel-selnya. Sebaliknya, mengirim gambar halaman yang tata letaknya tidak penting menambah pekerjaan tanpa harus meningkatkan jawaban. Tentukan representasi mana yang mempertahankan bukti yang diperlukan untuk pertanyaan Anda.
<strong>Penyusun draf spekulatif adalah model tambahan.</strong> Penyusun draf LiLiCorr milik Bolt mengusulkan token kandidat untuk diverifikasi oleh model sasaran. Fungsinya dimaksudkan untuk mempercepat dekode, tetapi checkpoint tambahan beserta keadaan eksekusinya tetap membutuhkan memori. Penjelasan LiLiCorr dari NVIDIA, 15 Oktober 2026. Kehadiran penyusun draf bukan jaminan bahwa tugas Anda selesai lebih cepat.
<strong>Ruang kerja runtime merupakan kebutuhan terpisah.</strong> Batch pemrosesan prompt dan buffer komputasi sementara perlu masuk anggaran bersama keadaan persisten. Server menyediakan ukuran batch logis dan ukuran microbatch fisik; keduanya tidak dapat disamakan dengan jumlah percakapan serentak. Referensi opsi server llama.cpp, diakses 16 Oktober 2026. Konfigurasi yang berhasil dimulai tetap perlu diuji dengan permintaan yang representatif.
Tabel perangkat keras resmi lebih berguna daripada akhiran nama produk
Konfigurasi yang dipublikasikan NVIDIA:
| Resep | Perangkat keras | Konteks | Urutan |
|---|---|---|---|
| 28GB | RTX Spark 64GB atau RTX diskret 32GB+ | 65,536 | 1 |
| 32GB | RTX Spark 128GB atau RTX diskret 48GB+ | 262,144 | 1 |
Sumber: Panduan Mulai Cepat NVIDIA, diakses 16 Oktober 2026.
Baris-baris ini tidak mencakup GPU diskret 24GB dan tidak membuktikan dukungan Mac. RAM host bukan tambahan VRAM diskret.
Pendapat kami: pilih konfigurasi yang dapat diulang, bukan tangkapan layar yang sekadar menunjukkan model berhasil dimuat. Jika pembelian bergantung pada model ini, mintalah demonstrasi dengan masukan yang Anda rencanakan dan aplikasi latar yang biasanya terbuka. Hal ini sangat penting untuk gambar dokumen dan agen yang berjalan lama, karena permintaan pertama bisa jauh lebih kecil daripada permintaan berikutnya.
Pilih konteks berdasarkan pekerjaan, bukan batas maksimumnya
Pertimbangkan tiga pekerjaan awal yang bersifat ilustratif, bukan uji coba yang dilaporkan.
Seorang pengembang meminta penjelasan tentang pengujian yang gagal, dengan memberikan kesalahan, fungsi yang relevan, dan satu dependensi terdekat. Hasil yang berguna adalah diagnosis yang merujuk ke baris tertentu, diikuti usulan perubahan. Sebelum menambahkan seluruh repositori, periksa apakah informasi yang hilang hanyalah antarmuka tertentu atau frame stack lainnya. Ini membuat pertanyaan mudah diperiksa dan memudahkan pendeteksian asumsi yang keliru.
Seorang peneliti membandingkan tabel di dua halaman dokumen. Di sini, pengujiannya adalah apakah model mengaitkan judul, satuan, catatan kaki, dan nilai secara tepat. Gunakan gambar halaman yang sebenarnya jika hubungan itu penting, minta bukti untuk tiap halaman, lalu cocokkan sampel sel dengan dokumen asli. Ringkasan lancar yang menukar dua kolom tetap merupakan hasil gagal, meski selesai dengan cepat.
Asisten lokal menelusuri folder yang disetujui dan menyiapkan draf laporan. Tekanan memorinya dapat meningkat karena materi yang diambil dan respons alat yang berulang. Berikan tugas pertama yang hanya boleh membaca, batasi penelusuran, dan minta asisten menyebutkan berkas yang mendukung setiap kesimpulan. Jangan berikan izin menulis atau shell sekadar untuk melihat apakah model bisa menyusun rencana yang berguna.
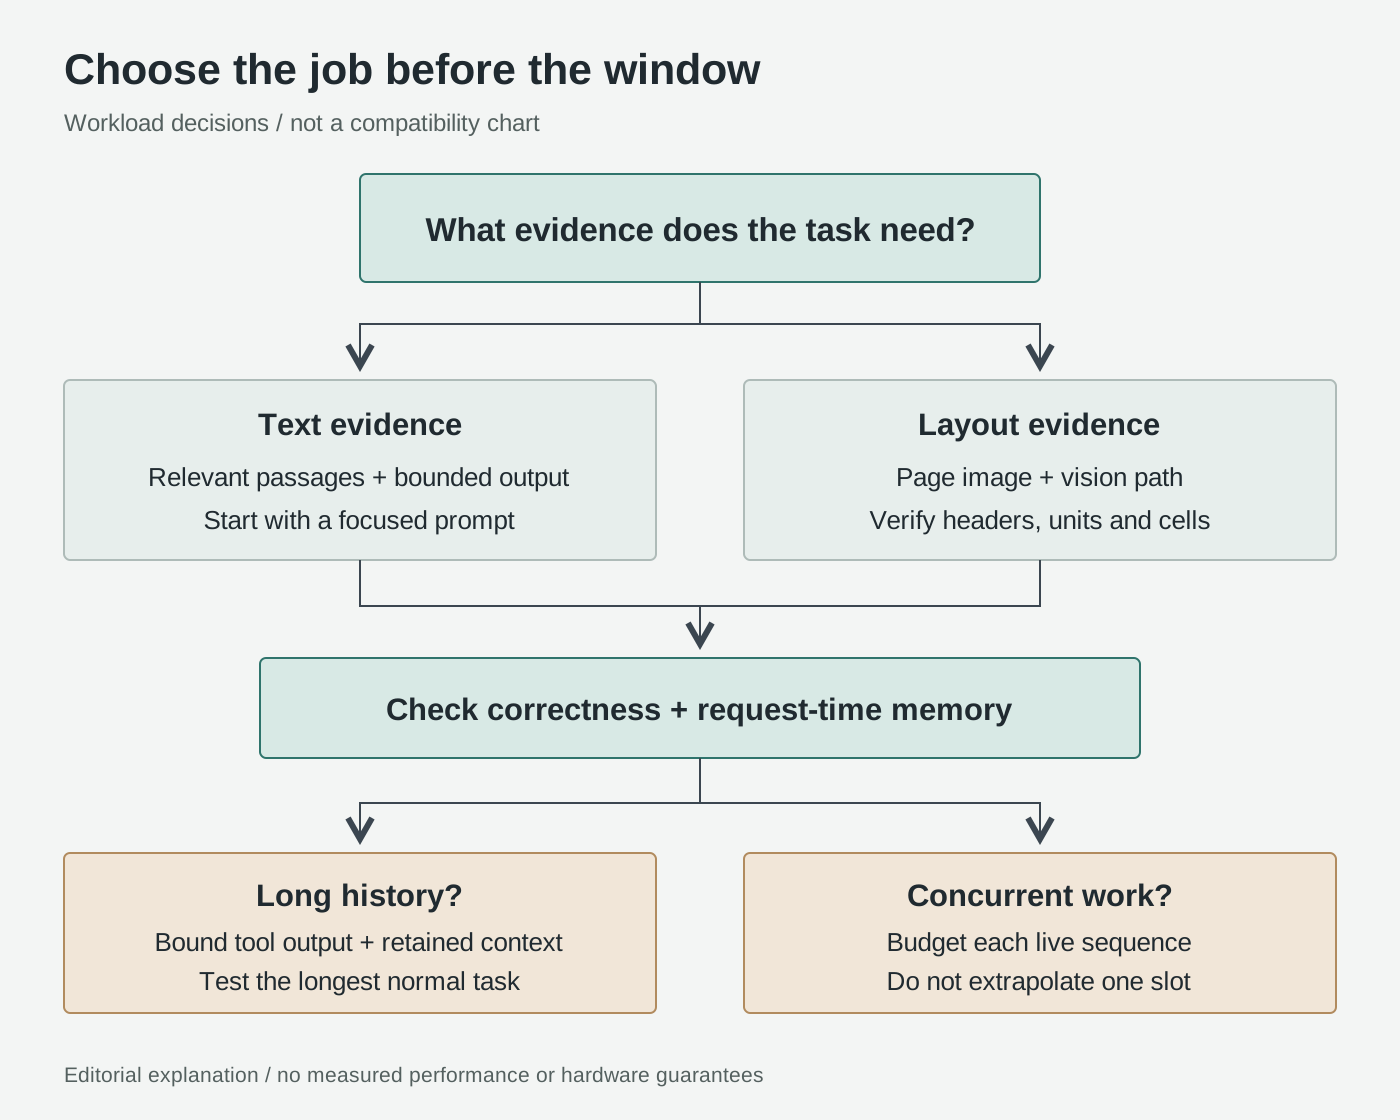
Penjelasan editorial orisinal tentang pemilihan beban kerja, bukan benchmark atau bagan kompatibilitas. Lihat strategi cache Hugging Face dan penanganan multimodal llama.cpp, diakses 16 Oktober 2026.
Cache terkuantisasi dapat mengurangi penyimpanan dibanding cache berpresisi lebih tinggi, sedangkan offloading memindahkan tekanan ke tingkat memori lain dan dapat menukar throughput dengan kapasitas. Ini kompromi umum, bukan bukti bahwa setiap strategi cache di Transformers tersedia untuk penerapan GGUF ini. Strategi cache Hugging Face, diakses 16 Oktober 2026.
Prioritas praktisnya adalah kepadatan bukti: pertahankan materi yang dibutuhkan untuk menjawab pertanyaan, simpan dokumen asli secara terpisah, dan buang kerangka berulang. Sisakan ruang untuk jawaban juga. Jendela yang dikonfigurasi lebih besar tidak membuat riwayat yang tak relevan menjadi berguna.
Mulai secara lokal, lalu uji beban kerja yang benar-benar Anda perlukan
Contoh Linux Bash berikut ditujukan untuk konfigurasi GPU NVIDIA diskret yang didukung. Contoh ini mengasumsikan Git, Python, CMake, toolchain C++, driver NVIDIA yang kompatibel, dan CUDA toolkit sudah terpasang. Ini prosedur untuk dijalankan di mesin Anda, bukan laporan pemasangan yang telah dilakukan.
- Bangun runtime yang sesuai dan periksa opsinya. Gunakan jalur build dari sumber, bukan satu baris perintah umum dari halaman model. Ikuti panduan build CUDA llama.cpp, diakses 16 Oktober 2026. Simpan commit dan versi biner yang dilaporkan bersama konfigurasi Anda.
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git rev-parse HEAD
cmake -B build -DGGML_CUDA=ON -DGGML_NATIVE=ON
cmake --build build --config Release -j
./build/bin/llama-server --version
./build/bin/llama-server --help
Pastikan bantuan menyertakan draft-dflash, --spec-draft-model, --spec-draft-n-max, --cache-type-k, --cache-type-v, --flash-attn, dan --jinja. Label versi paket saja tidak membuktikan dukungan. Jika biner menolak opsi-opsi itu, atasi ketidakcocokan build sebelum mengunduh checkpoint besar; jangan diam-diam mengganti resep dengan flag dekode spekulatif lama. Nama opsinya didokumentasikan dalam referensi server terkini, diakses 16 Oktober 2026.
- Unduh tiga berkas dalam Panduan Mulai Cepat NVIDIA, diakses 16 Oktober 2026. Sintaks unduhan mengikuti panduan CLI Hugging Face, diakses 16 Oktober 2026. Periksa ruang disk terlebih dahulu.
python3 -m venv .venv-hf
source .venv-hf/bin/activate
python -m pip install --upgrade huggingface_hub
MODEL_DIR="$PWD/models/nemotron-bolt"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --local-dir "$MODEL_DIR"
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf \
  --local-dir "$MODEL_DIR"
MODEL="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
MMPROJ="$MODEL_DIR/mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf"
DRAFT="$MODEL_DIR/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-LiLiCorr.gguf"
Catat revisi repositori dan hash berkas lokal sebelum menggunakan konfigurasi ini sebagai baseline perbandingan. Pemutakhiran berkas atau runtime berikutnya harus menjadi perubahan yang disengaja, bukan perbedaan tak jelas antara dua proses.
- Gunakan resep 28GB NVIDIA dengan pengikatan loopback eksplisit.
./build/bin/llama-server \
  --model "$MODEL" --mmproj "$MMPROJ" \
  --batch-size 2048 --ubatch-size 512 \
  --ctx-size 65536 --parallel 1 -ngl 999 \
  --spec-type draft-dflash --spec-draft-n-max 6 \
  --spec-draft-model "$DRAFT" --spec-draft-ngl 999 \
  --cache-type-k q8_0 --cache-type-v q8_0 \
  --temp 1.0 --top-p 0.95 --flash-attn on --jinja \
  --host 127.0.0.1 --port 8080
Gunakan porta kosong jika perlu, lalu sesuaikan pemeriksaan di bawah. Jangan membuat aturan penerusan router, tunnel publik, atau listener yang terikat secara eksternal untuk proses pertama ini. Loopback membatasi jangkauan jaringan; tetapi tidak menjadikan alat milik agen yang terhubung aman.
- Periksa kesiapan sebelum menghubungkan hal lain. Di terminal lain, jalankan:
curl --fail http://127.0.0.1:8080/health
Server mendokumentasikan respons pemuatan secara terpisah dari status siap. Setelah siap, buka http://127.0.0.1:8080 secara lokal dan coba pertanyaan teks singkat sebelum permintaan gambar. Dokumentasi kesehatan server dan antarmuka web llama.cpp, diakses 16 Oktober 2026. Biarkan alat eksternal tetap terputus sampai respons dasar berfungsi.
- Ukur seluruh pekerjaan sebelum memperluasnya. Di sistem dengan GPU diskret, periksa memori sebelum peluncuran dan selama prompt representatif:
nvidia-smi --query-gpu=name,memory.total,memory.used,memory.free --format=csv
Ini adalah pengamatan perangkat, bukan puncak proses secara menyeluruh atau metode penghitungan memori terpadu. NVIDIA mendokumentasikan pelaporan memori yang bergantung pada platform dalam referensi NVIDIA System Management Interface, diakses 16 Oktober 2026. Simpan juga log alokasi runtime dan periksa memori host secara terpisah.
Bandingkan prompt singkat, prompt normal terpanjang Anda, dan gambar dokumen yang representatif. Catat ketepatan, waktu hingga selesai, pengamatan memori, dan kegagalan alokasi. Ulangi dengan editor dan browser yang biasa Anda gunakan tetap terbuka. Konfigurasi yang hanya berfungsi setelah menutup seluruh lingkungan kerja Anda belum memenuhi persyaratan awal.
Jika gagal, ubah satu faktor pada satu waktu dan sebutkan konfigurasi yang baru. Mengurangi konteks, ukuran microbatch, atau volume riwayat alat menjawab pertanyaan yang berbeda; menghapus penyusun draf merupakan eksperimen lain, bukan resep yang dipublikasikan. Simpan kegagalan dan masukan yang memicunya agar keberhasilan prompt singkat berikutnya tidak menghapus masalah beban kerja yang belum terselesaikan.
Intinya: beli kapasitas untuk working set
Hal menarik dari Bolt adalah model besar dengan aktivasi jarang yang dikompresi untuk pekerjaan lokal. Nilai praktisnya bergantung pada apa yang muat bersamanya: bukti, masukan visual, keadaan urutan, dan aplikasi yang diperlukan untuk menyelesaikan tugas Anda.
Pertanyaan penerimaan yang tepat bukan “Apakah model 24GB berhasil dimuat?” melainkan “Bisakah mesin ini menyelesaikan beban kerja normal saya dengan jawaban andal dan ruang yang cukup untuk giliran berikutnya?” Itulah anggaran memori yang layak dibeli.
Sumber
Informasi rilis bertanggal 15 Oktober 2026; kartu model tertaut dan dokumentasi yang terus diperbarui diperiksa pada 16 Oktober 2026. Prosedur ini merupakan instruksi adaptasi, bukan hasil pengujian langsung. Diagram orisinal adalah skema penjelas, bukan aset resmi atau grafik performa.
- Pengumuman rilis NVIDIA untuk tiga nama model dan waktu rilis.
- Ikhtisar riset NVIDIA Bolt dan laporan teknis untuk kompresi, presisi, dan rincian perkiraan memori.
- Kartu model GGUF NVIDIA untuk tabel perangkat keras sebenarnya, nama berkas checkpoint, dan resep peluncuran.
- Dokumentasi build llama.cpp, server, multimodal, dan perkakas GGUF untuk perilaku runtime.
- Penjelasan cache Hugging Face, strategi cache, panduan CLI, dan referensi NVIDIA SMI untuk mekanisme khusus dan perintah pemeriksaan.
Rekomendasi Telli.sh opsional: simpan sumber di balik keputusan Anda
Membandingkan agen lebih mudah ketika sumber asli, catatan Anda, dan hasil uji coba sendiri tersimpan bersama. Buat akun Telli.sh untuk menata materi itu menjadi referensi yang dapat Anda kunjungi kembali seiring perubahan produk.