816B บนโต๊ะ Mac: Muse Spark Open ทำอะไรได้จริงบ้าง
โมเดลแบบเปิดน้ำหนักของ Meta มาถึง Mac ที่มีหน่วยความจำสูง เปรียบเทียบการสาธิตด้วย Mac Studio สองเครื่องกับ checkpoint แบบ quantized ที่เล็กกว่า ดูเดโมจริง และเลือกการตั้งค่าเริ่มต้นที่เหมาะสม
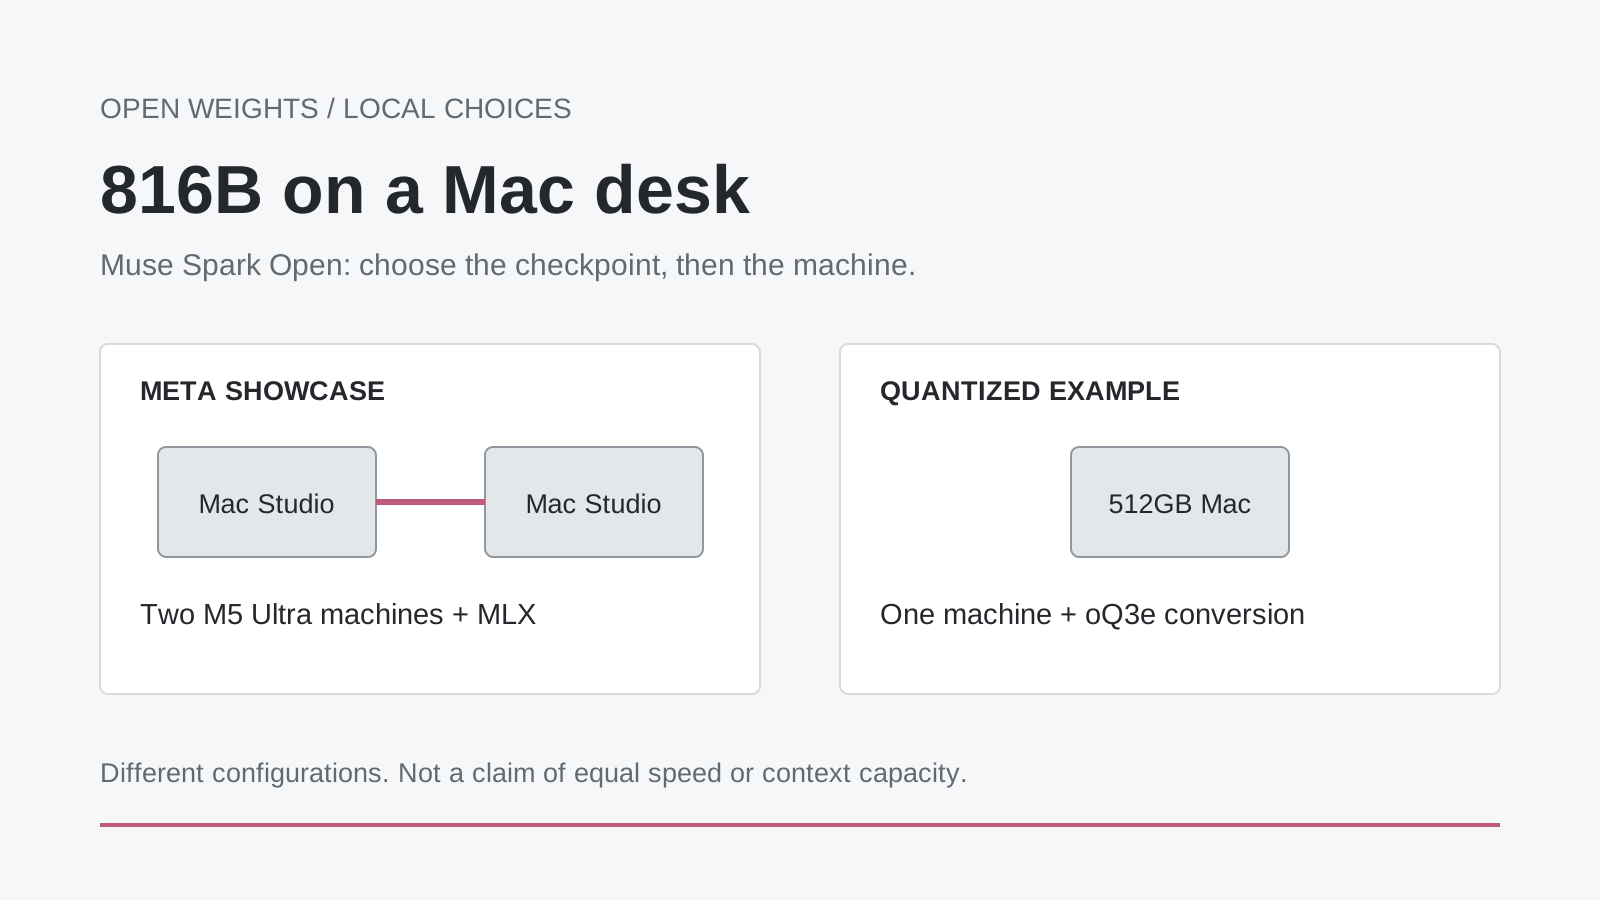
ภาพประกอบอธิบายต้นฉบับ การสาธิตด้วยเครื่องสองเครื่องและตัวอย่าง quantized บนเครื่องเดียวใช้การกำหนดค่าคนละแบบ จึงไม่ใช่ผลด้านประสิทธิภาพที่นำมาเทียบแทนกันได้
โมเดลขนาด 816 พันล้านพารามิเตอร์ที่ทำงานบนโต๊ะฟังดูขัดแย้งกัน แต่โต๊ะในประกาศวันที่ 15 ตุลาคมของ Meta มี Mac Studio สองเครื่อง แต่ละเครื่องมีหน่วยความจำขนาดใหญ่มาก นี่ต่างจากการนำโมเดลเดียวกันมาใช้กับแล็ปท็อปที่คุณมีอยู่แล้ว
พัฒนาการที่น่าสนใจกว่านั้นอยู่ถัดจากพาดหัว Muse Spark Open เปิดให้นักพัฒนาเข้าถึงน้ำหนักของโมเดล และเครื่องมือรอบข้างก็มีหลายวิธีให้ใช้งาน Meta แสดงการกำหนดค่าแบบสองเครื่อง ส่วน Hugging Face อธิบายเวอร์ชันที่ quantize มากขึ้นซึ่งทำงานบน Mac 512GB เครื่องเดียว AI ในเครื่องกำลังเปลี่ยนจากคำถามว่าในทางทฤษฎีดาวน์โหลดโมเดลได้หรือไม่ ไปเป็นการเลือกรูปแบบและขอบเขตการทำงานให้เหมาะสม
คู่มือนี้อธิบายว่าโมเดลทำอะไรได้บ้าง เหตุใดตัวเลขหน่วยความจำจึงต่างกัน เดโมที่เผยแพร่ไว้รายการใดควรดู และจะเริ่มต้นอย่างมีประโยชน์โดยไม่เผลอดาวน์โหลดไฟล์ขนาดหลายร้อยกิกะไบต์ได้อย่างไร เป้าหมายไม่ใช่เปลี่ยนผู้อ่านทุกคนให้เป็นผู้ซื้อเวิร์กสเตชัน แต่ช่วยให้เลือกระหว่างเครื่องในเครื่อง โมเดลขนาดเล็ก และบริการที่โฮสต์ไว้ได้ชัดเจนขึ้น
จุดเปลี่ยนคือการเข้าถึงโมเดล ไม่ใช่การอัปเกรดแล็ปท็อปได้ทุกเครื่อง
Meta เปิดตัว Muse Spark Open เมื่อวันที่ 15 ตุลาคม 2026 โดยระบุว่าเป็นโมเดล mixture-of-experts ขนาด 816B พารามิเตอร์ มีพารามิเตอร์ที่ทำงานต่อ token ราว 42B และหน้าต่างบริบทสูงสุดหนึ่งล้าน token รุ่นนี้มุ่งรองรับงานเขียนโค้ดและงานใช้เครื่องมือที่ยาวนาน สามารถนำ weight ไปใช้งานผ่าน inference engine ได้หลายแบบ ไม่ได้บังคับให้ใช้แอปแชตเพียงตัวเดียว
สิ่งนี้เปลี่ยนว่าใครเป็นผู้ตัดสินใจเรื่องการติดตั้งใช้งาน นักพัฒนาสามารถเลือก checkpoint เรียกใช้ serving stack ที่เหมาะสม เชื่อมต่อเครื่องมือ และกำหนดได้ว่าแอปพลิเคชันจะส่งข้อมูลไปที่ใด ตัวเลือกเหล่านี้สำคัญเมื่อโครงการต้องการเวอร์ชันโมเดลที่ทำซ้ำได้หรือการจัดการข้อมูลแบบเฉพาะ แต่ก็มาพร้อมความรับผิดชอบที่ปกติบริการแชตแบบจัดการให้ซ่อนเอาไว้ ทั้งพื้นที่จัดเก็บ การอัปเกรด ความเข้ากันได้ การติดตาม และการกู้คืน
มุมมองของเราคือ นี่เป็นการเพิ่มทางเลือกครั้งสำคัญ ไม่ใช่การทำให้โครงสร้างพื้นฐานหายไป การเป็นเจ้าของ weight คล้ายกับการเป็นเจ้าของเครื่องยนต์ คุณมีอิสระสร้างยานพาหนะแบบอื่น แต่ไม่ได้แถมเบรก อู่ซ่อม หรือถนนมาด้วย คำถามที่มีประโยชน์คือมีส่วนไหนของยานพาหนะนี้ที่คุณต้องการดูแลเองจริง ๆ
สำหรับโปรเจ็กต์งานอดิเรก การดูแลส่วนเหล่านั้นอาจเป็นเป้าหมายเสียเอง สำหรับธุรกิจขนาดเล็กที่ต้องการคำตอบก่อนเริ่มประชุม อาจกลายเป็นสิ่งรบกวนที่ไม่จำเป็น ทั้งสองแบบเป็นการตอบสนองต่อการเปิดตัวเดียวกันอย่างสมเหตุสมผล โมเดลแบบเปิดน้ำหนักทำให้มีทางเลือก แต่ไม่ได้ตัดสินแทนคุณ
พารามิเตอร์ที่ทำงาน 42B ไม่ได้ทำให้ดาวน์โหลด 816B ได้เล็กลง
โมเดล mixture-of-experts จะเลือกใช้ความจุของผู้เชี่ยวชาญเพียงบางส่วนสำหรับแต่ละ token จึงช่วยอธิบายได้ว่าทำไมจำนวนพารามิเตอร์ที่ทำงานจึงน้อยกว่าจำนวนทั้งหมดมาก แต่ไม่ได้หมายความว่าจะตัดผู้เชี่ยวชาญที่ไม่ได้ใช้ในขณะนั้นออกจากการติดตั้งโมเดลเต็มรูปแบบได้ token ถัดไปอาจต้องใช้เส้นทางอื่นในโมเดล
ควรแยกงบประมาณออกเป็นสามส่วน ส่วนแรกคือพื้นที่เก็บ checkpoint ส่วนที่สองคือหน่วยความจำทำงานสำหรับ weight และ runtime ส่วนที่สามคือสถานะเพิ่มเติมที่เพิ่มขึ้นตามภาระงาน เช่น attention cache และอินพุตหลายสื่อ การผ่านข้อกำหนดส่วนแรกไม่ได้ยืนยันว่าอีกสองส่วนจะพอดี
model card อย่างเป็นทางการ ระบุอินพุตข้อความ รูปภาพ วิดีโอ และเสียง พร้อมเอาต์พุตข้อความ อีกทั้งยังระบุรูปแบบ checkpoint และข้อกำหนดหน่วยความจำขนาดใหญ่ นี่คือข้อกำหนดของตระกูลโมเดลเต็ม ไม่ใช่คำรับรองว่า checkpoint ที่แปลงแล้วทุกแบบจะมี encoder ครบทุกชนิดหรือรองรับบริบทสูงสุดบนทุกเครื่อง
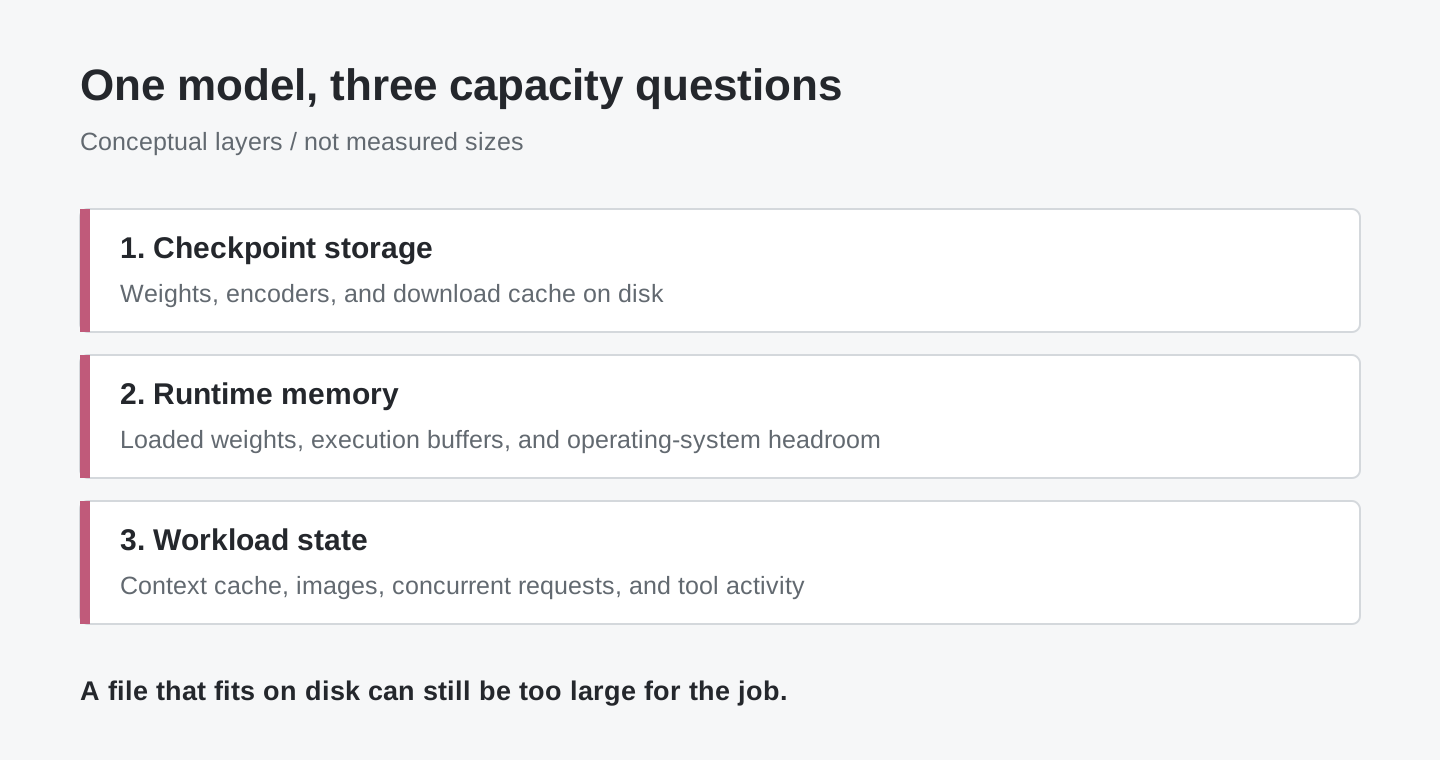
แผนภาพแนวคิดต้นฉบับ แถบต่าง ๆ แสดงประเภทการใช้หน่วยความจำ ไม่ใช่สัดส่วนที่วัดได้ ขนาด checkpoint เพียงอย่างเดียวไม่ใช่การประเมินความจุของทั้งเครื่อง
ความแตกต่างนี้สำคัญเป็นพิเศษกับวิดีโอ คำถามสั้น ๆ เกี่ยวกับรูปภาพกับการวิเคราะห์เฟรมจำนวนมากเป็นเวลานานไม่ใช่คำขอแบบเดียวกัน เพียงเพราะใช้โมเดลที่เข้าใจภาพได้ การทดลองแรกที่เหมาะสมควรใช้อินพุตขนาดเล็ก จำกัดคำตอบ และสร้างค่าฐานที่ใช้งานได้ ก่อนเพิ่มคลังข้อมูลขนาดใหญ่หรือวงรอบ agent ที่ยาวขึ้น
Mac Studio สองเครื่องกับ Mac 512GB หนึ่งเครื่องเล่าเรื่องคนละแบบ
การสาธิตของ Meta ใช้ Mac Studio M5 Ultra สองเครื่องและ MLX ประกาศระบุหน่วยความจำรวมสูงสุด 512GB ต่อเครื่อง และรายงานเวิร์กโฟลว์ในเครื่องที่เกี่ยวข้องกับการแก้ไขแอป iOS Ice Cubes และการตัดต่อใน DaVinci Resolve นี่คือเดโมของ Meta ไม่ใช่ผลวัดจากโต๊ะของเรา ดูการกำหนดค่าและตัวอย่างในโพสต์เปิดตัวของ Meta
บทความเปิดตัวของ Hugging Face ใช้อีกแนวทางหนึ่ง โดยอธิบายการทดสอบ checkpoint แบบ quantized oQ3e บน M3 Ultra ที่มีหน่วยความจำ 512GB สำหรับ prompt 1,024 token และ token ที่สร้าง 128 token ผู้เขียนรายงานความเร็วราว 225 token ต่อวินาทีระหว่าง prefill และ 21 ระหว่างการสร้าง ตัวเลขเหล่านี้เป็นของการทดสอบสั้น ๆ และ checkpoint นั้น ไม่ใช่ของ Mac ทุกเครื่องหรือการสาธิตแบบสองเครื่อง อ่านส่วน MLX ในบทความวิศวกรรม
การ์ด checkpoint oQ3e ช่วยแก้ความเข้าใจเรื่องหน่วยได้อย่างชัดเจน: พื้นที่เก็บ tensor อยู่ที่ประมาณ 344.152 GiB หรือ 369.531 GB การ์ดระบุประมาณ 370GB ใน oMLX การเรียกตัวเลขนี้เพียงว่า “โมเดล 344GB” ทำให้หน่วยฐานสองกับฐานสิบพร่าเลือน ทั้งที่หน่วยความจำส่วนที่เหลือมีความสำคัญมาก
| เส้นทางที่เผยแพร่ | แสดงให้เห็นอะไร | สิ่งที่ผู้อ่านไม่ควรอนุมาน |
|---|---|---|
| Mac Studio M5 Ultra สองเครื่องของ Meta | การติดตั้งใช้งานในเครื่องที่มีหน่วยความจำสูงและการสาธิต agent | การกำหนดค่า Muse ทุกแบบต้องใช้ Mac สองเครื่องพอดี |
| M3 Ultra 512GB กับ oQ3e ของ Hugging Face | ตัวอย่างเครื่องเดียวที่ quantize มากขึ้น | MacBook ทั่วไปมีหน่วยความจำเพียงพอ |
| inference แบบโฮสต์ | เข้าถึงได้โดยไม่ต้องดูแล checkpoint เต็มรูปแบบไว้ในเครื่อง | งานจะต้องอยู่บนคอมพิวเตอร์ของคุณเองเสมอ |
ยังมีข้อจำกัดที่สำคัญอีกข้อ การแปลง oQ3e มีทั้ง language model และ vision encoder แต่ ไม่มี audio encoder ดังนั้นเดโมเสียงและเบราว์เซอร์ที่ใช้โมเดลเต็มจึงไม่ได้ยืนยันว่าเวิร์กโฟลว์เสียงเดียวกันจะใช้ได้กับไฟล์ดาวน์โหลดรุ่นนี้ ชื่อโมเดลใช้แทนการอ่านการ์ดของรุ่นย่อยไม่ได้
การ์ด oQ4e ทำให้การแลกเปลี่ยนด้านความจุชัดเจนยิ่งขึ้น โดยระบุพื้นที่เก็บ tensor ราว 475.886GB และเตือนว่ามากเกินไปสำหรับการใช้งานอย่างน่าเชื่อถือบน Mac 512GB เครื่องเดียว จำนวน bit ที่มากขึ้นอาจรักษารูปแบบ weight อีกแบบไว้ แต่เหลือพื้นที่ให้ทำงานจริงน้อยลง การใช้หน่วยความจำจนเต็มไม่เท่ากับทำงานเสร็จ
ดูวงรอบการใช้เครื่องมือ ไม่ใช่แค่คำตอบสุดท้าย
กรณีใช้งานที่น่าสนใจอย่างหนึ่งคือผู้ช่วยเขียนโค้ดที่ตรวจดูผลงานของตัวเองได้ ตัวอย่าง งานสร้าง asset 3D ของ Hugging Face รวมโมเดล quantized, coding agent, Three.js, มุมมองเบราว์เซอร์ที่เรนเดอร์แล้ว และการป้อนผลภาพกลับเข้าไป จุดสำคัญคือวงรอบนี้: สร้างชิ้นงาน ตรวจดู หาข้อบกพร่อง แล้วแก้ไข
ลองนึกภาพการใช้รูปแบบนี้ทำต้นแบบเครื่องมือปรับแต่งผลิตภัณฑ์ คุณอยากให้ agent สังเกตเห็นตัวควบคุมที่ถูกบังหรือวัตถุที่อยู่นอกกรอบกล้อง ไม่ใช่แค่สร้างโค้ดที่ถูกไวยากรณ์ นี่เป็นการประยุกต์รูปแบบดังกล่าวเพื่ออธิบาย ไม่ใช่การอ้างว่าเดโมมีเครื่องมือปรับแต่งที่พร้อมใช้งานจริงให้แล้ว เกณฑ์การยอมรับยังเป็นของโครงการเอง: ตัวควบคุมที่ถูกต้อง ขนาดที่เหมาะสม และพฤติกรรมบนหน้าจอขนาดเล็ก
ตัวอย่างที่สองคือเดโม “Call your Browser” ซึ่งลิงก์จากบทความ Hugging Face เดโมนี้รวมอินพุตเสียงกับการโต้ตอบผ่านเบราว์เซอร์ด้วยภาพเพื่อค้นหาผลิตภัณฑ์ตามคำบรรยาย เดโมที่โฮสต์อยู่ในบทความวิศวกรรม แสดงการโต้ตอบ โดยไม่ได้บอกว่าการติดตั้ง weight เพียงอย่างเดียวจะสร้าง browser agent ได้ ลิงก์ Space อาจต้องได้รับสิทธิ์เข้าถึง อย่าคิดว่าลิงก์หน้าเปิดตัวรับรองว่าจะใช้บริการสาธารณะได้ ก่อนลองเวอร์ชันที่โฮสต์ไว้ ให้ตรวจการตั้งค่าและการจัดการข้อมูล แล้วใช้ตัวอย่างที่ไม่มีข้อมูลอ่อนไหว
กรณีที่สามคือผู้ช่วยตรวจทานเอกสารและภาพหน้าจอของคุณเอง ตัวอย่างเช่น ขอให้เปรียบเทียบข้อกำหนดที่เขียนไว้กับภาพหน้าจออินเทอร์เฟซแล้วแจกแจงจุดที่ไม่ตรงกัน งานนี้ได้ประโยชน์จากความเข้าใจภาพโดยไม่ต้องให้ระบบเปลี่ยนไฟล์ ส่งข้อความ หรือซื้ออะไรทันที เริ่มจากงานที่มนุษย์ตรวจทั้งอินพุตและคำตอบที่เสนอได้
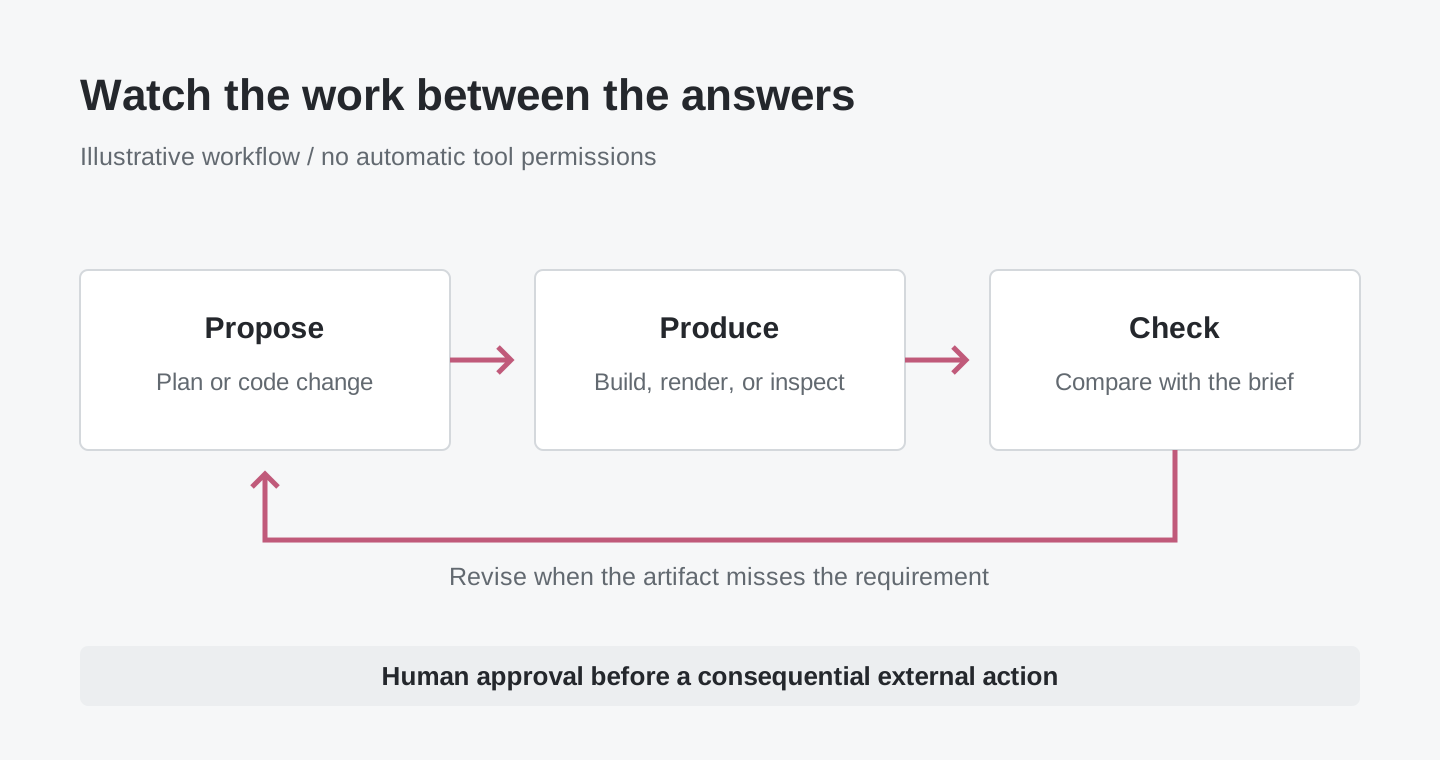
ภาพประกอบเวิร์กโฟลว์ต้นฉบับ กรอบ agent และเครื่องมือเป็นผู้จัดเตรียมวงรอบการลงมือทำ การดาวน์โหลด weight ไม่ได้ให้สิทธิ์เข้าถึงเบราว์เซอร์หรือระบบไฟล์โดยตัวมันเอง
สำหรับทั้งสามรูปแบบ ให้มองหาหลักฐานระหว่างทาง งานโค้ดคอมไพล์หรือไม่ หน้าเว็บที่เรนเดอร์ตรงตามข้อกำหนดหรือไม่ การเลือกผลิตภัณฑ์ตรงตามเงื่อนไขหรือไม่ ย่อหน้าสุดท้ายที่เขียนสละสลวยทดแทนชิ้นงานที่งานนั้นตั้งใจจะสร้างไม่ได้
เริ่มบน Mac โดยไม่ถือว่า “ดาวน์โหลด” คือขั้นตอนแรก
ข้อผิดพลาดที่ง่ายที่สุดคือเลือกโมเดลที่ใหญ่ที่สุดก่อน แล้วค่อยพบข้อกำหนดด้านความจุระหว่างทาง ให้ทำกลับกัน ตัดสินใจเลือกงานเล็ก ๆ ระบุ checkpoint ที่รองรับ และตรวจเครื่องก่อนใช้พื้นที่หรือเวลา
- ตรวจหน่วยความจำและพื้นที่ว่างบน Mac ใน Terminal คำสั่งด้านล่างแสดงเวอร์ชัน macOS หน่วยความจำที่ติดตั้งเป็นไบต์ และพื้นที่ว่างใน volume ของโฮม คำสั่งเหล่านี้ไม่ติดตั้งซอฟต์แวร์หรือดาวน์โหลด weight
sw_vers -productVersion
sysctl -n hw.memsize
df -h "$HOME"
-
เลือกแอปพลิเคชันกับ checkpoint ที่รองรับไปด้วยกัน โปรเจ็กต์ oMLX มีแอป macOS และเอกสารการติดตั้ง ข้อกำหนดเบื้องต้นตามเอกสารรวมถึง Apple Silicon และ macOS 15 ขึ้นไป ณ เวลาที่เขียน รุ่นล่าสุดคือ v0.7.1rc1 ซึ่งเป็น release candidate แยกงานทดลองออกจากเวิร์กสเตชันที่คุณต้องพึ่งพาเพื่อส่งงานตามกำหนด
-
อ่านการ์ดของรุ่นที่แปลงมาโดยเฉพาะก่อนเลือกจากหน้าดาวน์โหลดโมเดล สำหรับตัวอย่างเครื่องเดียวข้างต้น identifier คือ
mlx-community/Muse-Spark-Open-816B-A42B-oQ3eเผื่อพื้นที่ให้ checkpoint แคชดาวน์โหลด runtime และงานที่ต้องการทำ Mac 256GB มีความจุต่ำกว่าข้อกำหนดที่เผยแพร่สำหรับรุ่นนี้ การลดคำตอบให้เหลือหนึ่งประโยคไม่ได้ลดข้อกำหนดพื้นที่เก็บ weight -
เริ่มจากงานสั้น ๆ ที่ทิ้งได้ ลองถามข้อความสั้น ๆ หรือใช้ภาพหน้าจอที่ไม่มีข้อมูลอ่อนไหวพร้อมขอคำตอบสั้น ๆ ยืนยันว่าโมเดลโหลดได้และผลลัพธ์มีประโยชน์ ก่อนเพิ่มบริบทหรือเครื่องมือ การโหลดสำเร็จยืนยันความเข้ากันได้ ไม่ใช่ความถูกต้องของข้อเท็จจริง
-
เพิ่มการลงมือทำหลังจากเวิร์กโฟลว์แบบอ่านอย่างเดียวทำงานได้ดีแล้ว ทำงานในสำเนาของโปรเจ็กต์ จำกัดไฟล์และเครื่องมือที่ agent เข้าถึงได้ และกำหนดให้ยืนยันก่อนดำเนินการภายนอก เก็บการเปลี่ยนแปลงให้ตรวจทานได้ อย่าปล่อยให้การทดลองครั้งแรกแก้สำเนางานเพียงชุดเดียวของคุณ
ควรใช้เส้นทางดาวน์โหลดและเลือกโมเดลที่แอปพลิเคชันรองรับ แทนการคัดลอกคำสั่งทั่วไปจากหน้าโมเดลอื่น MLX LM มีเส้นทาง command line ด้วย แต่การรองรับโมเดลและรุ่นแพ็กเกจอาจพัฒนาไม่พร้อมกัน pull request เพิ่มการรองรับ Muse เป็นข้อมูลอ้างอิงความเข้ากันได้ที่มีประโยชน์เมื่อเลือกรุ่น ไม่ใช่เหตุผลให้ติดตั้ง development branch แบบสุ่ม
คุณไม่จำเป็นต้องซื้อฮาร์ดแวร์เพื่อทำความเข้าใจว่าโมเดลมีประโยชน์หรือไม่ endpoint ที่โฮสต์ไว้ช่วยตอบได้ว่ารองรับงานตัวแทนของคุณหรือไม่ ก่อนพิจารณาติดตั้งในเครื่อง ควรตรวจราคา การจัดการข้อมูล และการควบคุมค่าใช้จ่ายของผู้ให้บริการก่อน เดโมสาธารณะเป็นเครื่องมือเรียนรู้ ไม่ใช่ backend สำหรับใช้งานจริงฟรี
วัดงานที่เสร็จแล้ว ไม่ใช่แค่ตัวนับ token
จำนวน token ต่อวินาทีช่วยอธิบายการกำหนดค่า inference แต่บอกไม่ได้ว่าผู้ช่วยช่วยประหยัดเวลาช่วงบ่ายหรือสร้างข้อผิดพลาดที่สังเกตยาก การเปลี่ยนแปลงที่ผิดแต่เร็วอาจมีต้นทุนมากกว่าการเปลี่ยนแปลงที่ถูกแต่ช้า โดยเฉพาะเมื่อ agent ที่ทำงานนานทำซ้ำสมมติฐานที่ผิดของตัวเอง
การเปรียบเทียบที่ใช้งานได้จริงควรใช้ชุดงานขนาดเล็กชุดเดียวกันกับการตั้งค่าที่เป็นตัวเลือก ใส่การแก้โค้ดที่มีการทดสอบเดิม ภาพหน้าจอที่มีปัญหาที่ทราบอยู่แล้ว และคำถามเกี่ยวกับเอกสารที่ตรวจสอบคำตอบกับข้อความต้นทางได้ คง prompt และเงื่อนไขการยอมรับให้เหมือนเดิม จากนั้นบันทึกความถูกต้อง เวลาจนได้ผลที่ตรวจแล้ว การแทรกแซงที่ต้องทำ และทรัพยากรสูงสุดหากเครื่องมือแสดงข้อมูลนั้น
แยก prefill กับ generation ว่าเป็นเวลารอคนละช่วง อินพุตยาวอาจทำให้คำตอบแรกช้า แม้ token หลังจากนั้นจะมาเร็ว agent อาจใช้เวลา compile ท่องเว็บ หรือรอเครื่องมืออื่นด้วย ให้นับเวลาส่วนนั้นเมื่อเทียบการกำหนดค่าในเครื่องกับบริการที่โฮสต์ไว้ เพราะเป็นส่วนหนึ่งของประสบการณ์ผู้ใช้ แม้จะอยู่นอกโมเดลก็ตาม
ทำการเปรียบเทียบซ้ำหลังอัปเดต checkpoint หรือ runtime ที่มีนัยสำคัญ ไม่จำเป็นต้องทำ benchmark ใหญ่โตเพื่อรู้ว่าการเปลี่ยนแปลงทำให้เวิร์กโฟลว์ปกติเสียไป งานตัวแทนไม่กี่งานที่ตรวจด้วยวิธีสม่ำเสมอมีประโยชน์กว่าภาพหน้าจอคำตอบที่น่าประทับใจเพียงครั้งเดียว
open weights ให้ทางเลือก แต่ไม่ได้รับประกันความเป็นส่วนตัวหรือสิทธิ์ใช้งานอย่างไม่จำกัด
โมเดลในเครื่องช่วยให้ inference อยู่บนเครื่องของคุณได้ แต่แอปพลิเคชันทั้งหมดอาจยังใช้การค้นเว็บ telemetry เครื่องมือภายนอก พื้นที่จัดเก็บระยะไกล หรือโมเดลสำรองที่โฮสต์ไว้ วาดเส้นทางข้อมูลของเวิร์กโฟลว์จริงก่อนเรียกมันว่าเป็นส่วนตัว การทดลองข้อความแบบออฟไลน์กับ agent ซื้อสินค้าผ่านเบราว์เซอร์มีขอบเขตต่างกัน แม้เริ่มจาก checkpoint เดียวกัน
Muse Model License ก็มีเงื่อนไข ต้องระบุที่มาและมี usage policy ประกอบ อีกทั้งยังมีข้อกำหนดแยกสำหรับธุรกิจ model-as-a-service บางประเภท นี่คือการเปิดตัวแบบ open-weight ที่มีเงื่อนไขเฉพาะ ไม่ใช่การรับรองแบบครอบคลุมว่าการใช้งานทุกรูปแบบไม่มีข้อจำกัด ตรวจใบอนุญาตฉบับปัจจุบันให้ตรงกับการเผยแพร่หรือบริการที่คุณตั้งใจทำ
สำหรับทีม ความเป็นเจ้าของควรมีคำตอบด้านการปฏิบัติงานควบคู่กับคำตอบทางกฎหมาย ใครอนุมัติโมเดลเวอร์ชันใหม่ ใครกู้คืนการกำหนดค่าก่อนหน้าได้ prompt และผลจากเครื่องมือไปอยู่ที่ใด ใครตรวจการเปลี่ยนแปลงก่อนส่งถึงลูกค้า คำถามเหล่านี้ไม่ได้คัดค้าน inference ในเครื่อง แต่เป็นสิ่งที่ทำให้มันกลายเป็นบริการที่เชื่อถือได้ แทนการสาธิตเพียงวันเดียว
สรุป: AI ในเครื่องกำลังกลายเป็นตัวเลือกด้านการกำหนดค่า
หมุดหมายสำคัญไม่ใช่คอมพิวเตอร์ทุกเครื่องจะรันโมเดลขนาดมหึมาได้ แต่เป็นการที่ผู้ใช้มองเห็นและเลือกการติดตั้งใช้งานได้มากขึ้น: weight แบบไหน การแปลงแบบใด เครื่องใด runtime ไหน และเครื่องมืออะไร
Muse Spark Open ทำให้ทางเลือกนั้นเป็นรูปธรรม Mac หน่วยความจำสูงสองเครื่องสาธิตเส้นทางหนึ่ง การแปลงรุ่นเล็กกว่าสาธิตอีกเส้นทางหนึ่ง ส่วน inference ที่โฮสต์ไว้ก็เป็นการแลกเปลี่ยนอีกแบบ เลือกการจัดวางที่เล็กที่สุดซึ่งทำงานที่คุณสนใจได้อย่างน่าเชื่อถือ คำถามถัดไปที่มีประโยชน์ไม่ใช่ “ทำให้โหลดได้ไหม” แต่คือ “เชื่อถือผลงานที่ได้กลับมาได้หรือไม่”
แหล่งข้อมูลและเดโม
- Meta: เปิดตัว Muse Spark Open, 15 ตุลาคม 2026
- model card และข้อกำหนด checkpoint ของ Meta
- Hugging Face: คู่มือ runtime เงื่อนไขการทดสอบ MLX และเดโม agent, 15 ตุลาคม 2026
- การแปลง oQ3e: หน่วยพื้นที่จัดเก็บ encoder ที่มี และการใช้งาน
- การแปลง oQ4e: พื้นที่จัดเก็บและคำเตือนการใช้เครื่องเดียว
- เอกสารติดตั้ง oMLX และ รุ่น v0.7.1rc1
- การรองรับ Muse ใน MLX LM
- Muse Model License
ตรวจข้อมูลผลิตภัณฑ์และความเข้ากันได้เมื่อวันที่ 16 ตุลาคม 2026 ตัวเลขประสิทธิภาพข้างต้นเป็นการวัดที่ผู้เผยแพร่รายงาน โดยระบุเงื่อนไขการทดสอบไว้
เก็บการตัดสินใจไว้ ไม่ใช่แค่ชื่อโมเดล
สำหรับผู้อ่านที่รวบรวมลิงก์แหล่งข้อมูล บันทึกการกำหนดค่า และการตัดสินใจจากการตรวจทาน Telli.sh เป็นพื้นที่ทำงานทางเลือกหนึ่ง สร้างบันทึกการค้นคว้า