816B di meja Mac: perkara yang benar-benar boleh dilakukan oleh Muse Spark Open
Model pemberat terbuka Meta kini boleh dijalankan pada Mac dengan memori besar. Bandingkan demonstrasi dua Mac Studio dengan checkpoint kuantisasi yang lebih kecil, tonton demo sebenar dan pilih persediaan awal yang munasabah.
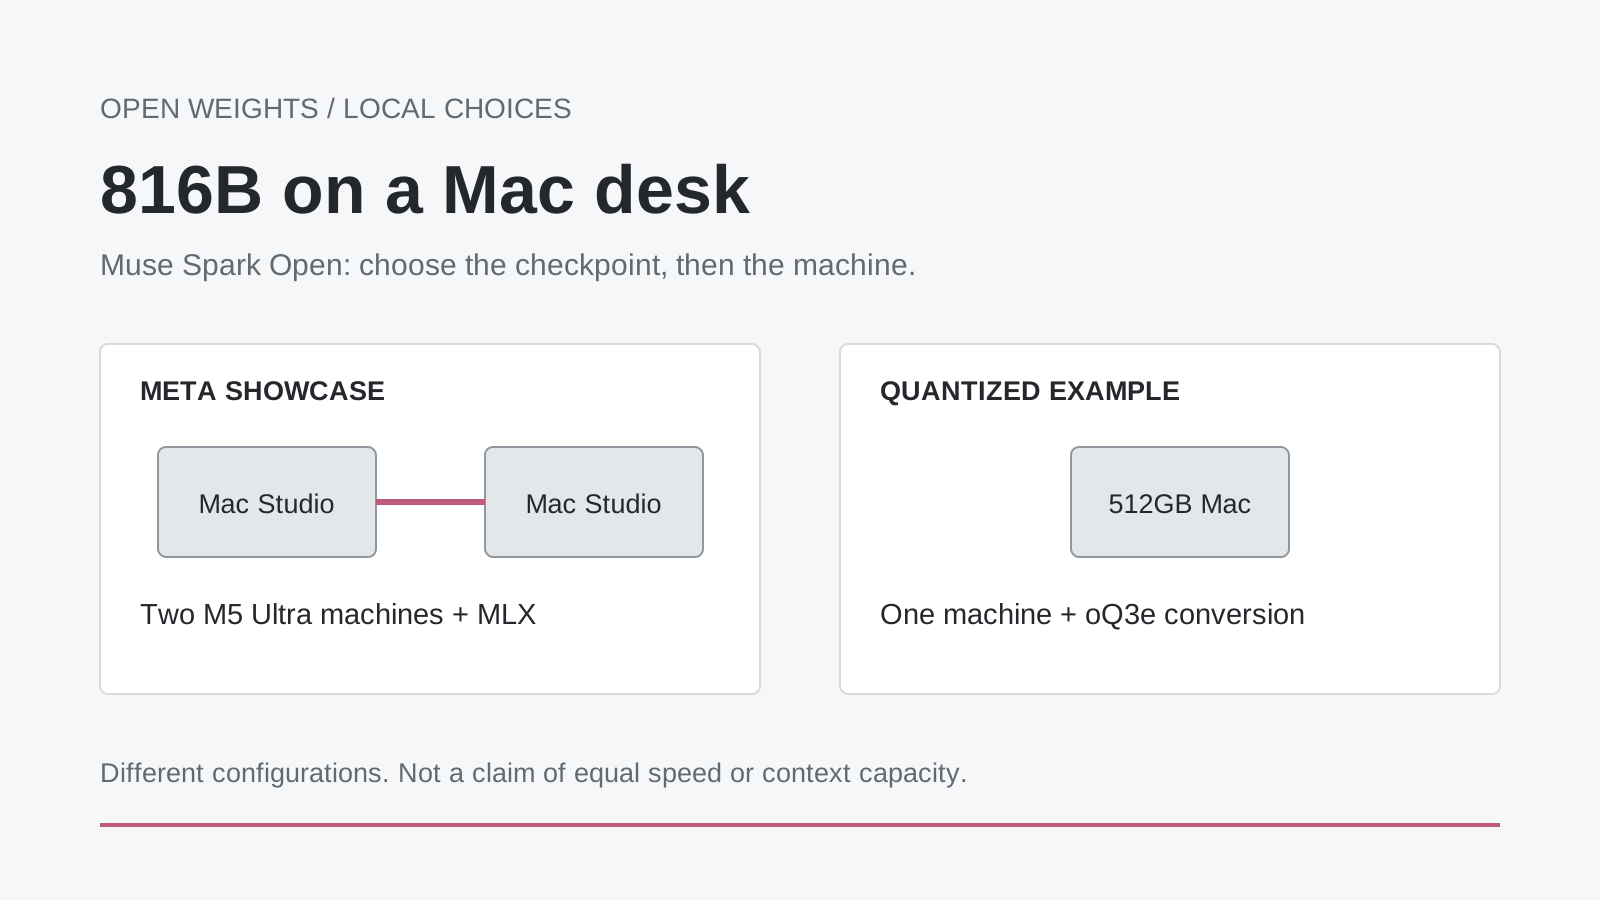
Ilustrasi penerangan asal. Demonstrasi dua mesin dan contoh satu mesin berkuantisasi menggunakan konfigurasi yang berbeza; kedua-duanya bukan hasil prestasi yang boleh dibandingkan secara terus.
Model dengan 816 bilion parameter yang berjalan di atas meja kedengaran seperti percanggahan. Namun, meja dalam pengumuman Meta pada 15 Oktober menempatkan dua Mac Studio, setiap satunya dengan kapasiti memori yang sangat besar. Itu jauh berbeza daripada menjalankan model yang sama pada komputer riba yang sudah anda miliki.
Perkembangan yang lebih menarik terletak sedikit di bawah tajuk utama itu. Muse Spark Open memberi pembangun akses kepada pemberat model, manakala alat di sekelilingnya menawarkan beberapa cara untuk menjalankannya. Meta menunjukkan konfigurasi dua mesin; Hugging Face turut menerangkan versi yang dikuantisasikan dengan lebih agresif pada sebuah Mac 512GB. AI setempat kini semakin kurang berkisar tentang sama ada model boleh dimuat turun secara teori, dan semakin berkisar tentang memilih perwakilan serta julat operasi yang sesuai.
Panduan ini menerangkan keupayaan model, sebab angka memori berbeza, demonstrasi terbitan yang berbaloi ditonton dan langkah pertama yang berguna tanpa tersilap memulakan muat turun beratus-ratus gigabait. Matlamatnya bukan menjadikan setiap pembaca pembeli stesen kerja. Sebaliknya, panduan ini membantu menjelaskan pilihan antara mesin setempat, model yang lebih kecil dan perkhidmatan hos.
Kejayaan utamanya ialah akses kepada model, bukannya naik taraf komputer riba untuk semua
Meta melancarkan Muse Spark Open pada 15 Oktober 2026, dan menerangkannya sebagai model campuran pakar dengan 816B parameter, kira-kira 42B parameter aktif bagi setiap token serta tetingkap konteks sehingga satu juta token. Keluaran ini menyasarkan kerja pengekodan dan penggunaan alat yang berpanjangan. Pemberatnya boleh digunakan melalui berbilang enjin inferens, bukannya terikat pada satu aplikasi sembang wajib.
Perubahan ini memperluas pihak yang boleh membuat keputusan tentang penggunaan model. Pembangun boleh memilih checkpoint, menjalankan susunan penyajian yang sesuai, menyepadukan alat dan menentukan ke mana aplikasi menghantar maklumat. Pilihan tersebut penting apabila projek memerlukan versi model yang boleh dihasilkan semula atau pengendalian data tertentu. Namun, ia juga membawa tanggungjawab yang biasanya tersembunyi di sebalik langganan sembang terurus: storan, naik taraf, keserasian, pemantauan dan pemulihan.
Pandangan kami: ini peluasan pilihan yang besar, bukannya hilangnya keperluan infrastruktur. Memiliki pemberat model ibarat memiliki enjin. Anda boleh membina kenderaan yang berbeza dengannya, tetapi brek, bengkel dan jalan raya tidak disertakan. Soalan yang berguna ialah bahagian mana dalam kenderaan itu yang benar-benar mahu anda selenggara.
Untuk projek hobi, kerja menyelenggaranya mungkin sebahagian daripada keseronokan. Bagi perniagaan kecil yang memerlukan jawapan sebelum mesyuarat bermula, kerja itu mungkin gangguan yang tidak perlu. Kedua-duanya ialah tindak balas yang munasabah terhadap keluaran yang sama. Model berpemberat terbuka memberi anda pilihan untuk membuat keputusan itu; ia tidak membuat keputusan bagi pihak anda.
42B parameter aktif tidak menjadikan 816B satu muat turun kecil
Model campuran pakar memilih hanya sebahagian daripada kapasiti pakarnya bagi setiap token. Hal ini membantu menjelaskan mengapa bilangan parameter aktif jauh lebih kecil daripada jumlah keseluruhan. Namun, itu tidak bermakna pakar yang tidak digunakan boleh begitu sahaja dibuang daripada penggunaan model penuh yang biasa: token seterusnya mungkin memerlukan laluan model yang lain.
Asingkan tiga bajet. Pertama, ruang storan untuk checkpoint. Kedua, memori kerja untuk pemberat dan masa jalan. Ketiga, keadaan tambahan yang bertambah mengikut beban kerja, termasuk cache perhatian dan input multimodal. Lulus ujian pertama tidak membuktikan bahawa dua yang lain juga muat.
Kad model rasmi menyenaraikan input teks, imej, video dan audio dengan output teks. Kad itu turut menyenaraikan format checkpoint yang berbeza serta keperluan memori yang besar. Semua itu ialah spesifikasi bagi keseluruhan keluarga model, bukannya janji bahawa setiap checkpoint yang ditukar format mengandungi setiap pengekod atau mencapai panjang konteks maksimum pada setiap mesin.
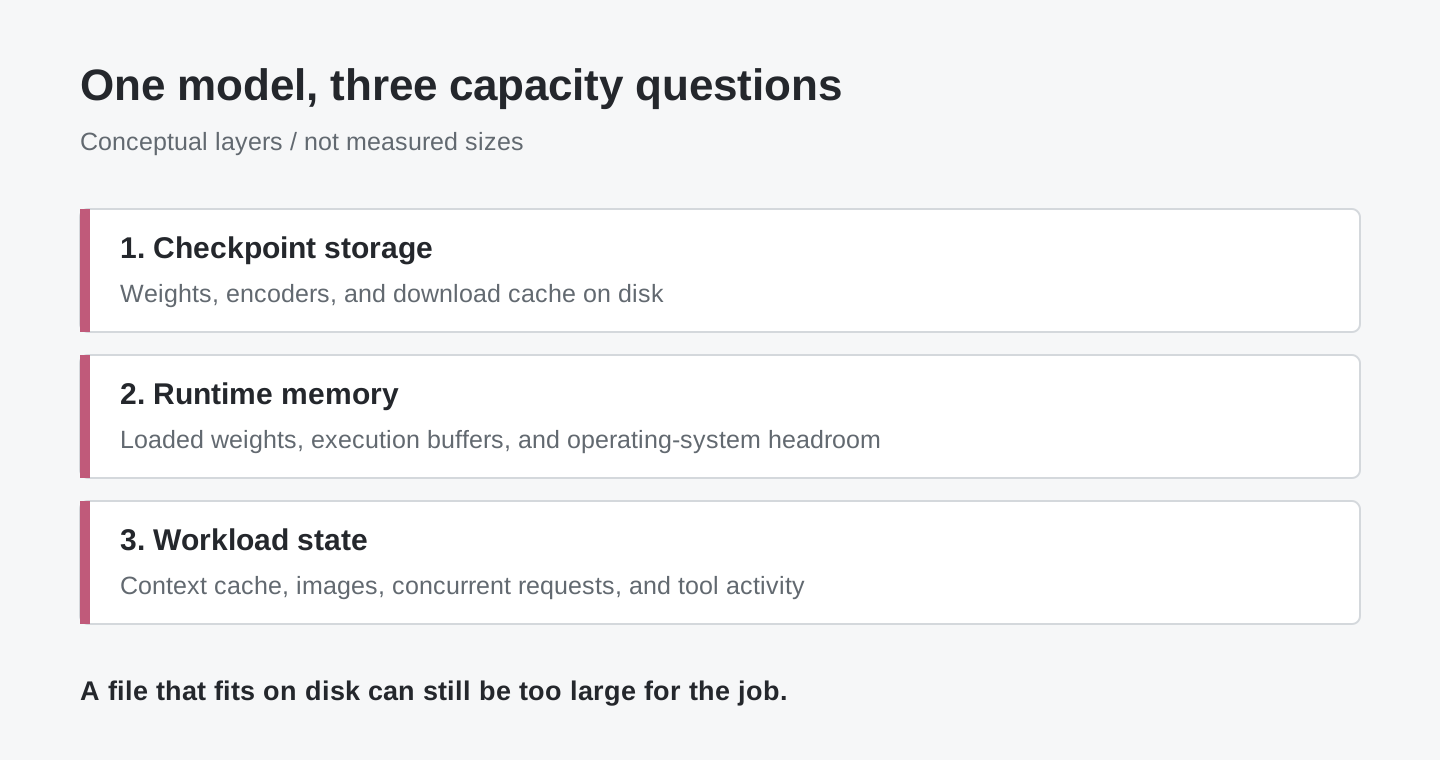
Rajah konsep asal. Jalur dalam rajah menunjukkan jenis penggunaan memori, bukan perkadaran yang diukur. Saiz checkpoint sahaja tidak cukup untuk menganggarkan kapasiti seluruh mesin.
Perbezaan ini amat penting untuk video. Soalan ringkas tentang imej dan analisis panjang yang melibatkan banyak bingkai bukan permintaan yang sama hanya kerana kedua-duanya menggunakan model berkeupayaan penglihatan. Eksperimen awal yang munasabah menggunakan input kecil, mengehadkan jawapan dan menetapkan garis dasar yang berfungsi sebelum menambah arkib lebih besar atau gelung ejen yang lebih panjang.
Dua Mac Studio dan sebuah Mac 512GB menunjukkan keadaan yang berbeza
Demonstrasi Meta menggunakan dua Mac Studio M5 Ultra dan MLX. Pengumumannya menyatakan sehingga 512GB memori bersatu bagi setiap mesin dan melaporkan aliran kerja setempat yang melibatkan perubahan pada aplikasi iOS Ice Cubes serta penyuntingan dalam DaVinci Resolve. Ini ialah demonstrasi Meta, bukannya ukuran daripada meja kerja kami sendiri. Lihat konfigurasi dan contoh dalam hantaran pelancaran Meta.
Artikel pelancaran Hugging Face memilih pendekatan yang berbeza. Artikel itu menerangkan ujian checkpoint berkuantisasi oQ3e pada M3 Ultra dengan memori 512GB. Bagi prompt 1,024 token dan 128 token yang dijana, penulis melaporkan kira-kira 225 token sesaat semasa prapengisian dan 21 semasa penjanaan. Angka ini khusus untuk ujian ringkas dan checkpoint tersebut, bukan untuk setiap Mac atau demonstrasi dua mesin. Baca bahagian MLX dalam artikel kejuruteraan itu.
Kad checkpoint oQ3e memberikan pembetulan unit yang berguna: storan tensornya kira-kira 344.152 GiB, atau 369.531 GB. Kad itu menyatakan kira-kira 370GB dalam oMLX. Menyebutnya sekadar “model 344GB” mengaburkan perbezaan unit binari dan perpuluhan, tepat pada bahagian yang baki memorinya penting.
| Laluan yang diterbitkan | Perkara yang ditunjukkan | Perkara yang tidak patut disimpulkan oleh pembaca |
|---|---|---|
| Dua Mac Studio M5 Ultra Meta | Penggunaan setempat bermemori besar dan demonstrasi ejen | Setiap konfigurasi Muse memerlukan tepat dua Mac |
| M3 Ultra 512GB Hugging Face dengan oQ3e | Contoh satu mesin yang dikuantisasikan dengan lebih agresif | MacBook biasa mempunyai memori yang mencukupi |
| Inferens hos | Akses tanpa perlu menyelenggara checkpoint penuh secara setempat | Kerja itu semestinya kekal pada komputer anda sendiri |
Terdapat satu lagi batas penting. Penukaran oQ3e merangkumi model bahasa dan pengekod penglihatan, tetapi tidak merangkumi pengekod audio. Oleh itu, demonstrasi suara dan pelayar yang menggunakan model penuh tidak membuktikan bahawa aliran kerja audio yang sama berfungsi dengan muat turun khusus ini. Nama model tidak menggantikan keperluan membaca kad bagi variannya.
Kad oQ4e menjelaskan lagi pertukaran kapasiti itu. Kad tersebut menyenaraikan kira-kira 475.886GB storan tensor dan memberi amaran bahawa saiz itu terlalu besar untuk penggunaan yang boleh diharap pada sebuah Mac 512GB. Lebih banyak bit boleh mengekalkan perwakilan pemberat yang berbeza, tetapi meninggalkan ruang yang lebih sedikit untuk kerja sebenar. Memenuhi memori tidak sama dengan menyiapkan kerja.
Perhatikan gelung alat, bukan jawapan akhir semata-mata
Satu kegunaan yang menarik ialah pembantu pengekodan yang boleh memeriksa rupa perubahan yang dibuatnya. Contoh aset 3D daripada Hugging Face menggabungkan model berkuantisasi, ejen pengekodan, Three.js, paparan pelayar yang dirender dan maklum balas visual. Bahagian yang menarik ialah gelungnya: hasilkan artifak, perhatikan hasilnya, cari kecacatan dan baikinya.
Bayangkan menggunakan corak itu untuk membina prototaip konfigurator produk. Anda mahu ejen mengesan kawalan yang terlindung atau objek di luar bingkai kamera, bukan sekadar menghasilkan kod yang sah dari segi sintaks. Ini contoh penerapan corak tersebut, bukannya dakwaan bahawa demo itu sudah menyediakan konfigurator yang sedia untuk pengeluaran. Projek itu tetap menentukan ujian penerimaan: kawalan yang betul, dimensi yang tepat dan tingkah laku yang sesuai pada skrin kecil.
Contoh kedua ialah demonstrasi “Call your Browser”, yang dipautkan daripada artikel Hugging Face. Demonstrasi itu menggabungkan input suara dengan interaksi visual dalam pelayar untuk mencari produk yang sepadan dengan penerangan. Demonstrasi yang dihoskan dalam sumber artikel kejuruteraan menunjukkan interaksi itu tanpa membayangkan bahawa pemasangan pemberat sahaja mewujudkan ejen pelayar. Space yang dipautkan mungkin memerlukan akses; jangan anggap pautan halaman pelancar menjamin perkhidmatan awam yang boleh digunakan. Sebelum mencuba versi hos, semak persediaan dan pengendalian datanya serta gunakan contoh yang tidak sensitif.
Contoh ketiga ialah pembantu semakan untuk dokumen dan tangkap layar anda sendiri. Contohnya, anda boleh memintanya membandingkan keperluan bertulis dengan imej antara muka dan menyenaraikan percanggahan. Tugas itu mendapat manfaat daripada pemahaman imej tanpa terus memberikan kebenaran kepada sistem untuk mengubah fail, menghantar mesej atau membeli sesuatu. Mulakan dengan tugas yang membolehkan manusia memeriksa input dan jawapan yang dicadangkan.
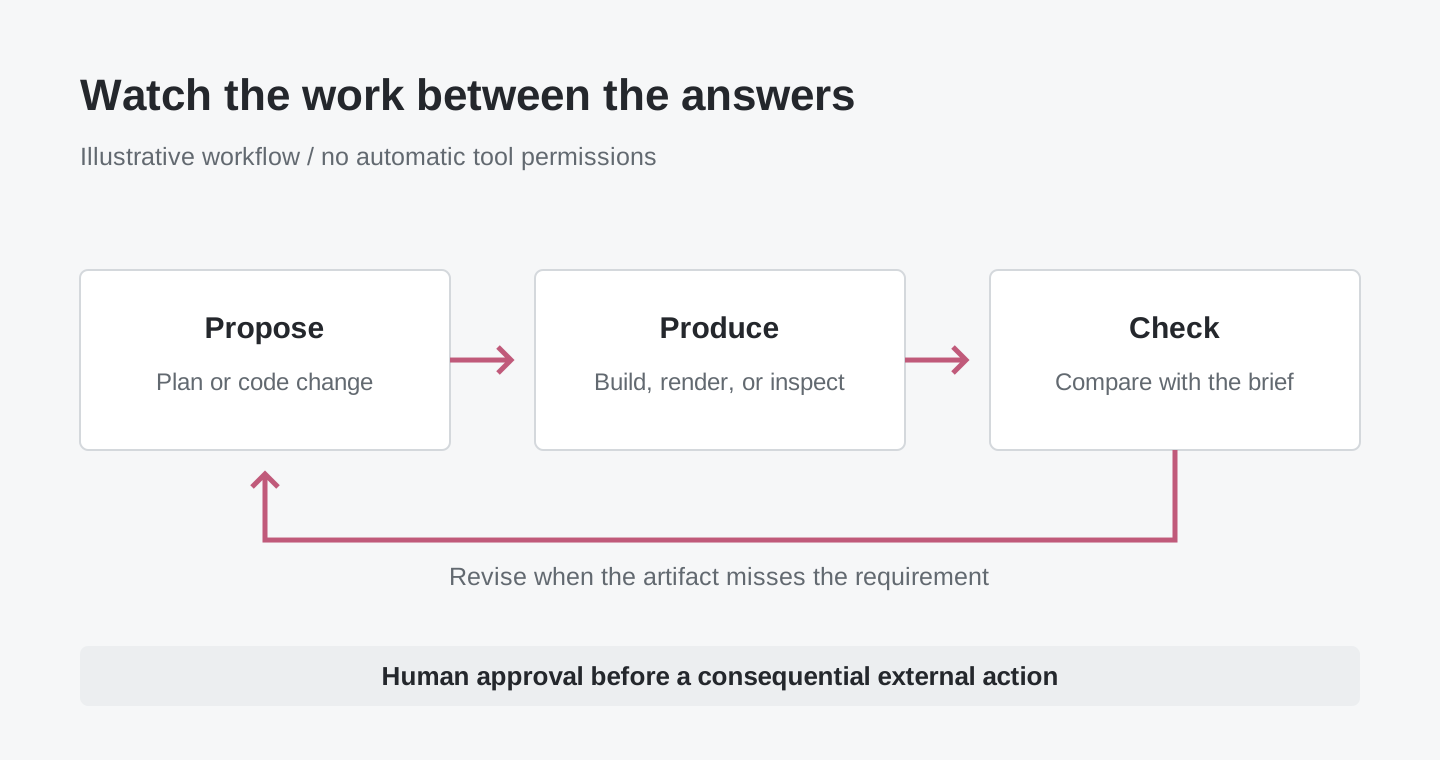
Ilustrasi aliran kerja asal. Rangka kerja ejen dan alatnya menyediakan gelung tindakan; memuat turun pemberat model tidak dengan sendirinya memberikan akses kepada pelayar atau sistem fail.
Bagi ketiga-tiga corak itu, cari bukti perantaraan. Adakah tugas kod berjaya dikompil? Adakah halaman yang dirender menepati keperluan? Adakah pilihan produk memenuhi kekangan yang dinyatakan? Perenggan akhir yang kemas tidak boleh menggantikan artifak yang sepatutnya dihasilkan oleh tugas tersebut.
Mulakan pada Mac tanpa menjadikan “muat turun” langkah pertama
Kesilapan paling mudah ialah memilih model terbesar dahulu, kemudian menyedari keperluan kapasiti apabila sudah separuh jalan. Buat secara terbalik. Tentukan tugas kecil, kenal pasti checkpoint yang disokong dan periksa mesin sebelum meluangkan storan atau masa.
- Periksa memori Mac dan ruang storan yang kosong. Dalam Terminal, arahan di bawah memaparkan versi macOS, memori terpasang dalam bait dan ruang kosong pada volum utama anda. Arahan ini tidak memasang perisian atau memuat turun pemberat.
sw_vers -productVersion
sysctl -n hw.memsize
df -h "$HOME"
-
Pilih aplikasi dan checkpoint yang disokong secara serentak. Projek oMLX menyediakan aplikasi macOS serta dokumentasi pemasangan. Prasyarat yang didokumenkan termasuk Apple Silicon dan macOS 15 atau lebih baharu. Pada masa penulisan, keluaran terkini ialah v0.7.1rc1, iaitu calon keluaran: asingkan kerja percubaan daripada stesen kerja yang anda perlukan untuk menepati tarikh akhir.
-
Baca kad penukaran yang tepat sebelum memilihnya dalam antara muka muat turun model. Bagi contoh satu mesin di atas, pengecamnya ialah
mlx-community/Muse-Spark-Open-816B-A42B-oQ3e. Peruntukkan ruang untuk checkpoint, cache muat turun, masa jalan dan kerja yang mahu anda lakukan. Mac 256GB berada di bawah keperluan terbitan bagi varian ini; memendekkan jawapan kepada satu ayat tidak menghapuskan keperluan ruang untuk menyimpan pemberat. -
Mulakan dengan tugas ringkas yang boleh dibuang. Cuba soalan teks kecil atau tangkap layar yang tidak sensitif dengan jawapan ringkas. Pastikan model berjaya dimuatkan dan hasilnya berguna sebelum menambah konteks atau alat. Model yang berjaya dimuatkan hanya membuktikan keserasian, bukan ketepatan fakta.
-
Tambah tindakan hanya selepas aliran kerja baca sahaja berfungsi dengan baik. Bekerja pada salinan projek. Hadkan fail dan alat yang boleh dicapai ejen, serta minta pengesahan sebelum sebarang tindakan luaran. Pastikan perubahan boleh disemak dan jangan biarkan percubaan pertama mengubah satu-satunya salinan kerja anda.
Utamakan laluan muat turun dan pemilihan model yang disokong oleh aplikasi berbanding arahan umum yang disalin daripada halaman model lain. MLX LM turut menawarkan laluan baris perintah, tetapi sokongan model dan keluaran berpakej boleh berkembang pada kadar yang berbeza. Permintaan tarik sokongan Muse berguna sebagai rujukan keserasian ketika memilih versi, bukannya alasan untuk memasang cabang pembangunan secara sembarangan.
Anda tidak perlu membeli perkakasan untuk memahami kegunaan model itu. Titik akhir hos boleh menjawab sama ada model mengendalikan tugas yang mewakili keperluan anda sebelum anda menyiasat penggunaan setempat. Semak harga, pengendalian data dan kawalan perbelanjaan penyedia terlebih dahulu. Demonstrasi awam ialah bahan pembelajaran, bukannya bahagian belakang pengeluaran percuma.
Ukur kerja yang selesai, bukan kaunter token semata-mata
Token sesaat membantu menerangkan konfigurasi inferens. Angka itu tidak memberitahu anda sama ada pembantu menjimatkan masa satu petang atau menghasilkan kesilapan halus. Perubahan salah yang lebih pantas boleh menelan kos lebih tinggi berbanding perubahan betul yang lebih perlahan, khususnya apabila ejen berpanjangan mengulangi andaian salahnya sendiri.
Perbandingan yang praktikal menggunakan koleksi kecil tugas yang sama merentas persediaan calon. Sertakan perubahan kod dengan ujian sedia ada, tangkap layar yang mempunyai isu diketahui dan soalan dokumen yang jawapannya boleh dijejak kepada satu petikan. Kekalkan prompt dan syarat penerimaan. Kemudian catat ketepatan, masa sehingga hasil disemak, tahap campur tangan yang diperlukan dan penggunaan sumber puncak jika alat anda mendedahkannya.
Anggap prapengisian dan penjanaan sebagai bahagian masa menunggu yang berbeza. Input panjang boleh melambatkan respons pertama walaupun token seterusnya tiba dengan pantas. Ejen juga mungkin meluangkan masa untuk mengkompil, melayari web atau menunggu alat lain. Ambil kira masa itu apabila membandingkan konfigurasi setempat dengan perkhidmatan hos; masa itu sebahagian daripada pengalaman pengguna walaupun berlaku di luar model.
Ulangi perbandingan selepas kemas kini checkpoint atau masa jalan yang bermakna. Anda tidak memerlukan penanda aras besar untuk mengesan perubahan yang merosakkan aliran kerja biasa. Beberapa tugas yang mewakili keperluan dan disemak secara konsisten lebih berguna daripada tangkap layar satu jawapan yang mengagumkan.
Pemberat terbuka memberi pilihan, bukan privasi automatik atau hak tanpa batas
Model setempat boleh memastikan inferens kekal pada mesin anda. Namun, aplikasi lengkap mungkin masih menggunakan carian web, telemetri, alat luaran, storan jauh atau model sandaran yang dihoskan. Lakarkan laluan data bagi aliran kerja sebenar sebelum menyifatkannya sebagai peribadi. Eksperimen teks luar talian dan ejen pelayar untuk membeli-belah mempunyai sempadan yang berbeza walaupun kedua-duanya bermula dengan checkpoint yang sama.
Lesen Model Muse juga mempunyai syarat. Lesen itu mewajibkan atribusi dan dasar penggunaan yang disertakan, serta mengandungi terma berasingan bagi perniagaan model-sebagai-perkhidmatan tertentu. Ini keluaran pemberat terbuka dengan lesen tersuai, bukannya dakwaan menyeluruh bahawa setiap penggunaan tidak terbatas. Semak lesen semasa bagi pengedaran atau perkhidmatan yang anda rancang.
Bagi sesebuah pasukan, tanggungjawab harus merangkumi jawapan operasi dan juga jawapan undang-undang. Siapa meluluskan versi model baharu? Siapa boleh memulihkan konfigurasi terdahulu? Ke manakah prompt dan hasil alat dihantar? Siapa menyemak perubahan sebelum sampai kepada pelanggan? Soalan-soalan itu bukan hujah menentang inferens setempat. Itulah perkara yang menjadikan inferens setempat perkhidmatan yang boleh diharap, bukannya demonstrasi sehari.
Kesimpulannya: AI setempat semakin menjadi pilihan konfigurasi
Pencapaian sebenar bukanlah setiap komputer kini boleh menjalankan model yang sangat besar. Sebaliknya, semakin banyak keputusan penggunaan model kini kelihatan dan boleh dibuat oleh pengguna: pemberat yang mana, penukaran yang mana, mesin yang mana, masa jalan yang mana dan alat yang mana.
Muse Spark Open menjadikan pilihan itu nyata. Dua Mac bermemori besar menunjukkan satu laluan; penukaran yang lebih kecil menunjukkan laluan lain; inferens hos pula menawarkan pertukaran yang berbeza. Pilih susunan paling kecil yang dapat menyiapkan kerja penting anda dengan boleh diharap. Soalan berguna yang seterusnya bukan “Bolehkah saya memuatkannya?” tetapi “Bolehkah saya mempercayai hasil kerja yang saya terima?”
Sumber dan demonstrasi
- Meta: pelancaran Muse Spark Open, 15 Oktober 2026.
- Kad model Meta dan spesifikasi checkpoint.
- Hugging Face: panduan masa jalan, keadaan ujian MLX dan demonstrasi ejen, 15 Oktober 2026.
- Penukaran oQ3e: unit storan, pengekod yang disertakan dan penggunaan.
- Penukaran oQ4e: storan dan amaran penggunaan satu mesin.
- Dokumentasi pemasangan oMLX dan keluaran v0.7.1rc1.
- Sokongan Muse dalam MLX LM.
- Lesen Model Muse.
Maklumat produk dan keserasian disemak pada 16 Oktober 2026. Angka prestasi di atas ialah ukuran penerbit yang dinyatakan dengan keadaan ujian masing-masing.
Kekalkan keputusan, bukan nama model sahaja
Bagi pembaca yang mengumpulkan pautan sumber, nota konfigurasi dan keputusan semakan, Telli.sh ialah satu ruang kerja pilihan. Cipta nota penyelidikan.