816B di meja Mac: apa yang benar-benar dimungkinkan Muse Spark Open
Model open-weight Meta kini dapat dijalankan di Mac berkapasitas memori besar. Bandingkan demonstrasi dua Mac Studio dengan checkpoint terkuantisasi yang lebih kecil, lihat demo nyata, dan pilih konfigurasi awal yang masuk akal.
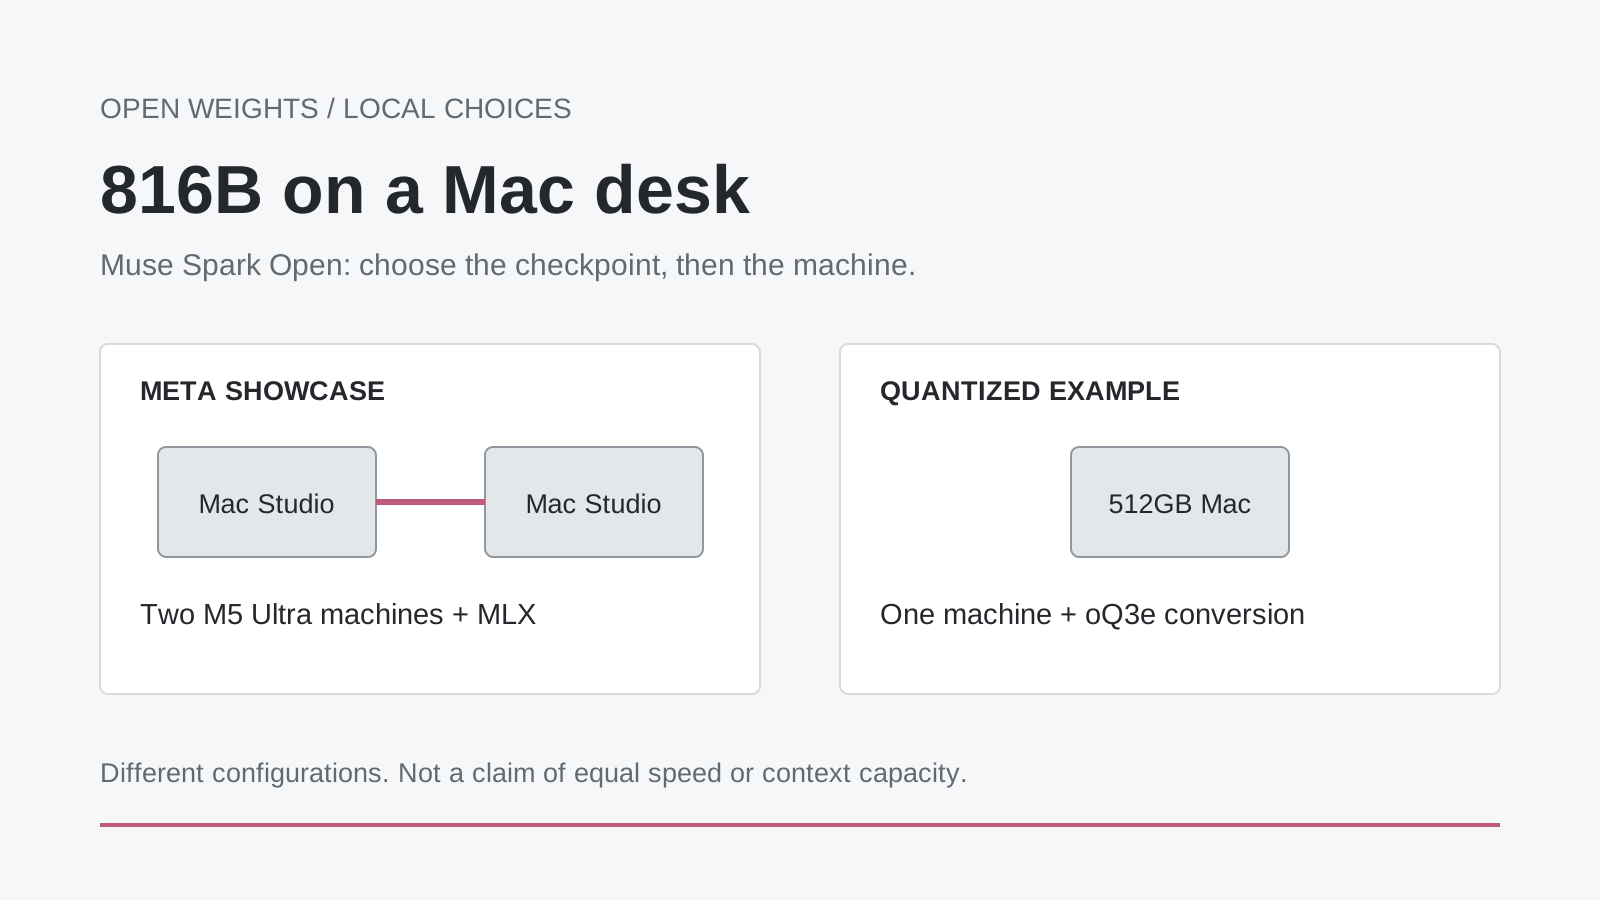
Ilustrasi penjelas orisinal. Demonstrasi dua mesin dan contoh terkuantisasi pada satu mesin menggunakan konfigurasi berbeda; keduanya bukan hasil performa yang dapat dipertukarkan.
Model dengan 816 miliar parameter yang berjalan di meja kerja terdengar seperti kontradiksi. Namun, meja dalam pengumuman Meta pada 15 Oktober itu menampung dua Mac Studio, masing-masing dengan kapasitas memori yang sangat besar. Ini berbeda dari menjalankan model yang sama di laptop yang sudah Anda miliki.
Perkembangan yang lebih menarik ada tepat di balik tajuk tersebut. Muse Spark Open memberi pengembang akses ke bobot model, dan perangkat di sekitarnya menawarkan beberapa cara untuk menjalankannya. Meta menunjukkan konfigurasi dua mesin; Hugging Face juga menjelaskan versi dengan kuantisasi lebih agresif pada satu Mac 512GB. AI lokal kini bukan lagi sekadar soal apakah model secara teoretis bisa diunduh, melainkan memilih representasi dan batas operasi yang tepat.
Panduan ini menjelaskan kemampuan model, alasan angka memorinya berbeda, demonstrasi terpublikasi mana yang layak ditonton, dan cara mengambil langkah awal yang berguna tanpa tanpa sengaja memulai unduhan berukuran ratusan gigabita. Tujuannya bukan mengubah setiap pembaca menjadi pembeli workstation. Tujuannya memperjelas pilihan antara mesin lokal, model yang lebih kecil, dan layanan ter-host.
Terobosan utamanya adalah akses ke model, bukan peningkatan universal untuk laptop
Meta merilis Muse Spark Open pada 15 Oktober 2026, dan menyebutnya sebagai model mixture-of-experts berparameter 816B dengan sekitar 42B parameter aktif per token serta jendela konteks hingga satu juta token. Rilis ini ditujukan untuk pemrograman dan pekerjaan panjang yang menggunakan alat. Bobotnya dapat diterapkan melalui beberapa mesin inferensi, bukan hanya satu aplikasi obrolan wajib.
Hal itu mengubah siapa yang dapat mengambil keputusan penerapan. Pengembang bisa memilih checkpoint, menjalankan tumpukan penyajian yang sesuai, mengintegrasikan alat, dan memutuskan ke mana aplikasi mengirim informasi. Pilihan tersebut penting ketika proyek memerlukan versi model yang dapat direproduksi atau pengaturan penanganan data tertentu. Pilihan itu juga menghadirkan tanggung jawab yang biasanya tersembunyi di balik langganan obrolan terkelola: penyimpanan, pemutakhiran, kompatibilitas, pemantauan, dan pemulihan.
Menurut kami, ini perluasan pilihan yang signifikan, bukan hilangnya kebutuhan infrastruktur. Memiliki bobot model mirip dengan memiliki mesin. Anda mendapat keleluasaan untuk merakit kendaraan berbeda, tetapi rem, bengkel, dan jalannya tidak ikut tersedia. Pertanyaan yang berguna adalah bagian mana dari kendaraan itu yang benar-benar ingin Anda rawat.
Untuk proyek hobi, merawat semua itu bisa menjadi tujuan tersendiri. Bagi usaha kecil yang membutuhkan jawaban sebelum rapat dimulai, hal itu mungkin hanya menjadi pengalih perhatian. Keduanya merupakan respons yang wajar terhadap rilis yang sama. Model open-weight membuat pilihan itu tersedia; model tersebut tidak menentukan jawabannya bagi Anda.
42B parameter aktif tidak membuat 816B menjadi unduhan kecil
Model mixture-of-experts hanya memilih sebagian kapasitas pakarnya untuk setiap token. Ini membantu menjelaskan mengapa jumlah parameter aktif jauh lebih kecil daripada jumlah totalnya. Namun, bukan berarti pakar yang tidak aktif bisa begitu saja dibuang dari penerapan model penuh yang normal: token berikutnya dapat membutuhkan jalur model yang berbeda.
Pisahkan tiga jenis kapasitas. Pertama, penyimpanan untuk checkpoint. Kedua, memori kerja untuk bobot dan runtime. Ketiga, keadaan tambahan yang bertambah mengikuti beban kerja, termasuk cache atensi dan masukan multimodal. Lolos dari pengujian pertama tidak membuktikan bahwa dua lainnya muat.
Kartu model resmi mencantumkan masukan teks, gambar, video, dan audio dengan keluaran teks. Kartu itu juga mencantumkan format checkpoint berbeda serta kebutuhan memori yang besar. Spesifikasi tersebut berlaku untuk keluarga model penuh, bukan jaminan bahwa setiap checkpoint hasil konversi menyertakan setiap encoder atau mencapai konteks maksimum di setiap mesin.
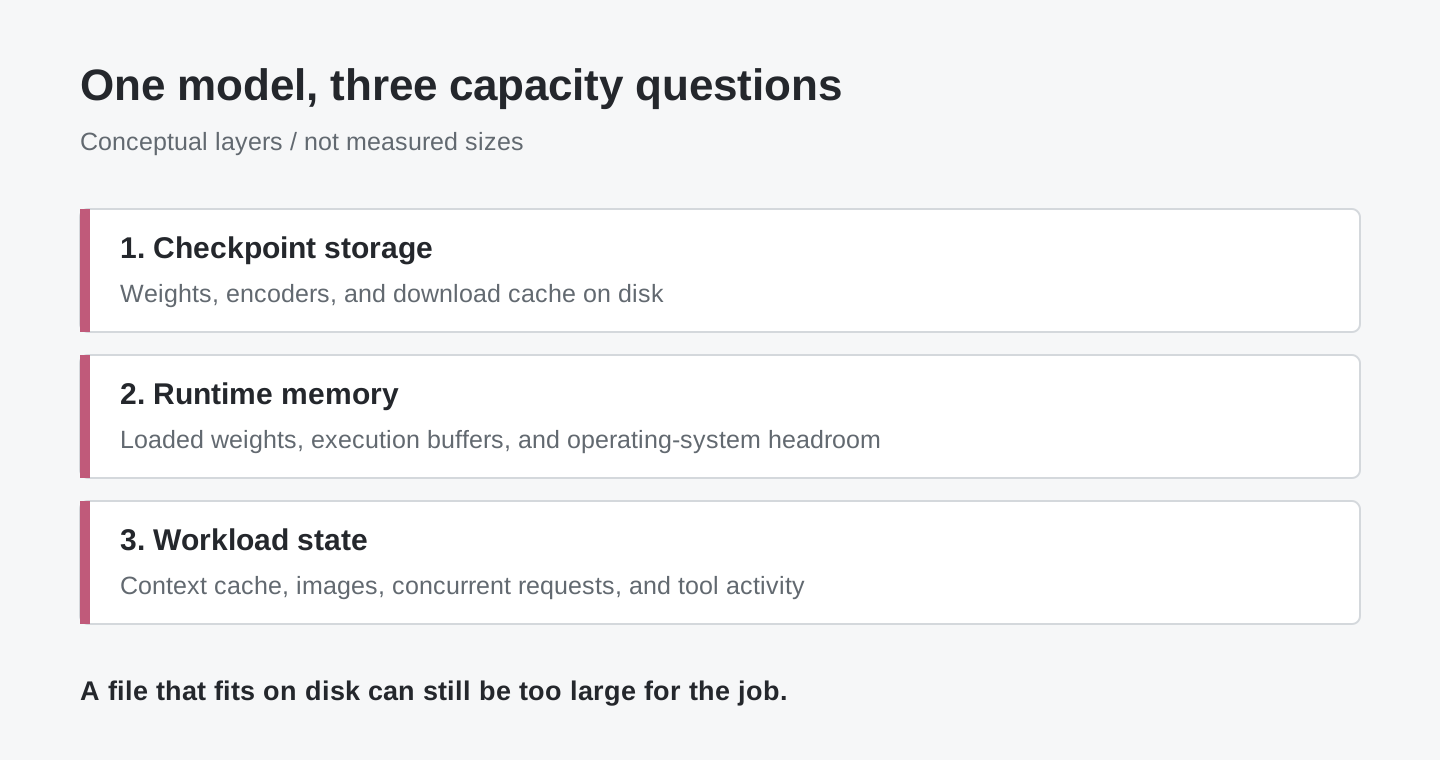
Diagram konseptual orisinal. Pita-pita menunjukkan jenis penggunaan memori, bukan proporsi terukur. Ukuran checkpoint saja tidak memperkirakan kapasitas seluruh mesin.
Perbedaan ini sangat penting untuk video. Pertanyaan singkat tentang sebuah gambar dan analisis panjang atas banyak bingkai bukanlah permintaan yang sama hanya karena keduanya menggunakan model berkemampuan visi. Eksperimen awal yang masuk akal membatasi masukan, membatasi panjang jawaban, dan menetapkan kondisi dasar yang berfungsi sebelum menambahkan arsip lebih besar atau rangkaian agen yang lebih panjang.
Dua Mac Studio dan satu Mac 512GB menceritakan hal berbeda
Demonstrasi Meta menggunakan dua Mac Studio M5 Ultra dan MLX. Pengumumannya menyebut hingga 512GB memori terpadu per mesin serta melaporkan alur kerja lokal yang mencakup perubahan pada aplikasi iOS Ice Cubes dan penyuntingan di DaVinci Resolve. Ini demonstrasi Meta, bukan pengukuran dari meja kerja kami sendiri. Lihat konfigurasi dan contoh di tulisan peluncuran Meta.
Artikel peluncuran Hugging Face menempuh jalur berbeda. Artikel itu menjelaskan pengujian checkpoint terkuantisasi oQ3e pada M3 Ultra dengan memori 512GB. Untuk prompt 1.024 token dan 128 token yang dihasilkan, penulis melaporkan sekitar 225 token per detik saat prefill dan 21 saat generasi. Angka-angka ini berlaku untuk pengujian singkat dan checkpoint tersebut, bukan setiap Mac atau demonstrasi dua mesin. Baca bagian MLX di artikel teknisnya.
Kartu checkpoint oQ3e memberi koreksi satuan yang berguna: penyimpanan tensornya sekitar 344.152 GiB, atau 369.531 GB. Kartu itu menyebut sekitar 370GB di oMLX. Menyebutnya sekadar “model 344GB” mengaburkan perbedaan satuan biner dan desimal, tepat ketika sisa kapasitas memori sangat berarti.
| Jalur yang dipublikasikan | Hal yang ditunjukkan | Hal yang tidak boleh disimpulkan pembaca |
|---|---|---|
| Dua Mac Studio M5 Ultra milik Meta | Penerapan lokal berkapasitas memori besar dan demonstrasi agen | Semua konfigurasi Muse memerlukan tepat dua Mac |
| M3 Ultra 512GB milik Hugging Face dengan oQ3e | Contoh satu mesin dengan kuantisasi lebih agresif | MacBook biasa memiliki memori yang cukup |
| Inferensi ter-host | Akses tanpa merawat checkpoint penuh secara lokal | Pekerjaan pasti berlangsung di komputer Anda sendiri |
Ada batas penting lainnya. Konversi oQ3e menyertakan model bahasa dan encoder visi, tetapi tidak menyertakan encoder audio. Karena itu, demonstrasi suara dan browser yang menggunakan model penuh tidak membuktikan bahwa alur audio yang sama berfungsi dengan unduhan khusus ini. Nama model tidak menggantikan pemeriksaan kartu variannya.
Kartu oQ4e membuat kompromi kapasitas ini makin jelas. Kartu tersebut mencantumkan penyimpanan tensor sekitar 475.886GB dan memperingatkan bahwa ukurannya terlalu besar untuk penggunaan andal pada satu Mac 512GB. Bit yang lebih banyak dapat mempertahankan representasi bobot yang berbeda, tetapi menyisakan lebih sedikit ruang untuk pekerjaan sebenarnya. Memenuhi memori bukan berarti pekerjaan selesai.
Amati rangkaian penggunaan alat, bukan hanya jawaban akhirnya
Salah satu penggunaan yang menarik adalah asisten pemrograman yang dapat memeriksa tampilan hasil perubahannya. Contoh aset 3D dari Hugging Face menggabungkan model terkuantisasi, agen pemrograman, Three.js, tampilan browser hasil render, dan umpan balik visual. Bagian yang menarik adalah siklusnya: membuat artefak, memeriksanya, menemukan cacat, lalu merevisinya.
Bayangkan memakai pola itu untuk membuat prototipe konfigurator produk. Anda ingin agen melihat kontrol yang tertutup atau objek yang berada di luar bingkai kamera, bukan hanya menghasilkan kode yang sintaksnya valid. Ini contoh penerapan pola tersebut, bukan klaim bahwa demo itu sudah menyediakan konfigurator siap produksi. Proyek tetap menentukan uji penerimaannya: kontrol yang tepat, dimensi yang tepat, dan perilaku yang tepat di layar kecil.
Contoh kedua adalah demonstrasi “Call your Browser”, yang ditautkan dari artikel Hugging Face. Demonstrasi ini menggabungkan masukan lisan dengan interaksi visual di browser untuk mencari produk berdasarkan deskripsi. Demonstrasi yang di-host bersama sumber dalam artikel teknis memperlihatkan interaksi tersebut tanpa menyiratkan bahwa memasang bobot saja otomatis menciptakan agen browser. Space tertaut itu mungkin memerlukan akses; jangan berasumsi tautan halaman peluncuran menjamin layanan publik yang bisa langsung dijalankan. Sebelum mencoba versi ter-host, tinjau konfigurasi dan penanganan datanya, lalu gunakan contoh yang tidak sensitif.
Contoh ketiga adalah asisten peninjau dokumen dan tangkapan layar Anda sendiri. Misalnya, Anda dapat memintanya membandingkan persyaratan tertulis dengan gambar antarmuka dan mencantumkan ketidaksesuaian. Tugas ini memanfaatkan pemahaman gambar tanpa langsung memberi sistem izin untuk mengubah berkas, mengirim pesan, atau membeli sesuatu. Mulailah dengan pekerjaan yang masukan dan usulan jawabannya dapat diperiksa manusia.
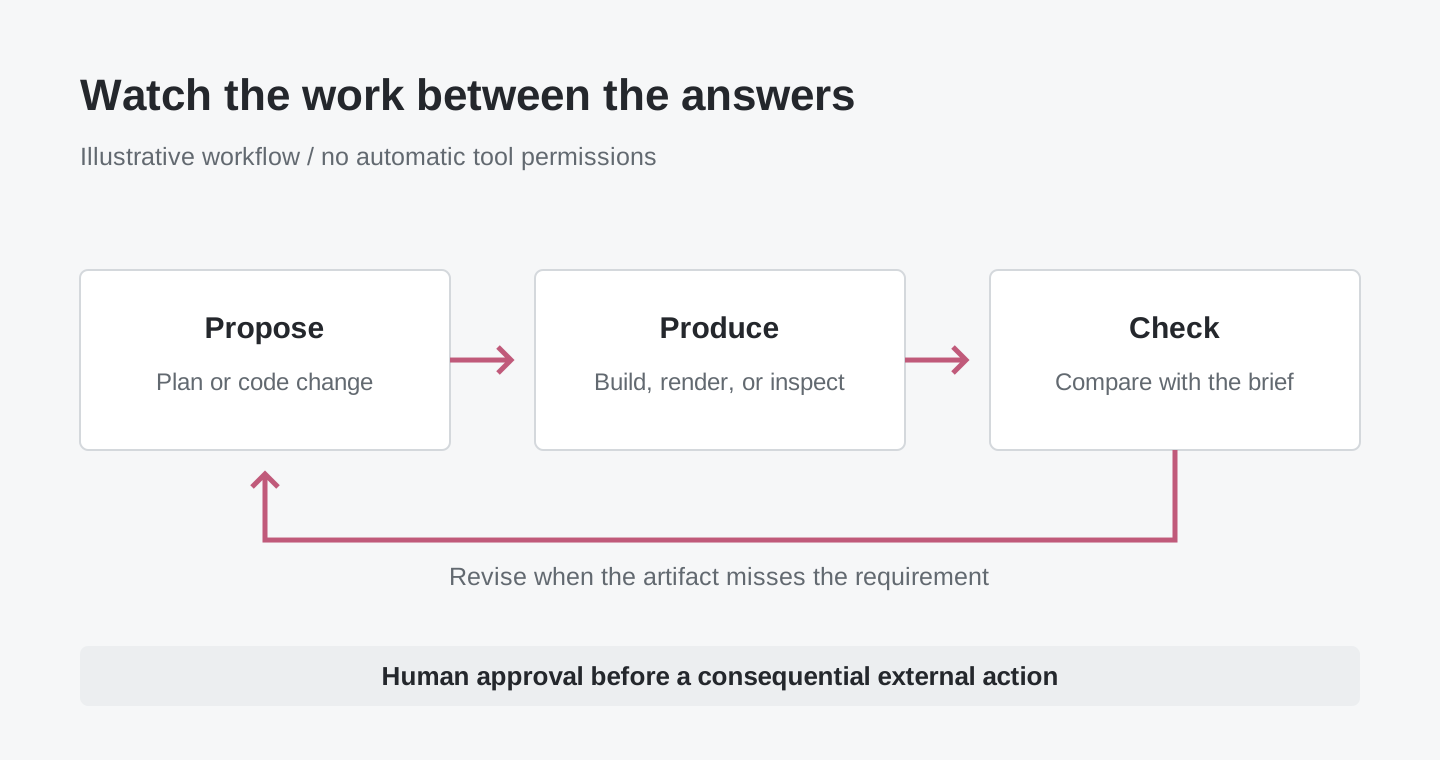
Ilustrasi alur kerja orisinal. Kerangka agen dan alatnya menyediakan rangkaian tindakan; mengunduh bobot model tidak otomatis memberinya akses ke browser atau sistem berkas.
Untuk ketiga pola tersebut, cari bukti antara. Apakah tugas pemrograman berhasil dikompilasi? Apakah halaman hasil render sesuai persyaratan? Apakah pilihan produk memenuhi batasan yang disebutkan? Paragraf akhir yang rapi bukan pengganti artefak yang seharusnya dihasilkan oleh tugas itu.
Mulai di Mac tanpa menjadikan “unduh” sebagai langkah pertama
Kesalahan termudah adalah memilih model terbesar lebih dulu, lalu baru menyadari kebutuhan kapasitas di tengah jalan. Balik urutannya. Tentukan pekerjaan kecil, kenali checkpoint yang didukung, lalu periksa mesin sebelum mengalokasikan penyimpanan atau waktu.
- Periksa memori dan ruang penyimpanan kosong Mac. Di Terminal, perintah di bawah menampilkan versi macOS, memori terpasang dalam bita, dan ruang kosong pada volume rumah Anda. Perintah tersebut tidak memasang perangkat lunak atau mengunduh bobot.
sw_vers -productVersion
sysctl -n hw.memsize
df -h "$HOME"
-
Pilih aplikasi dan checkpoint yang didukung secara bersamaan. Proyek oMLX menyediakan aplikasi macOS dan dokumentasi pemasangan. Prasyarat yang didokumentasikan mencakup Apple Silicon dan macOS 15 atau lebih baru. Saat artikel ini ditulis, rilis terbaru adalah v0.7.1rc1, sebuah kandidat rilis: pisahkan pekerjaan eksperimental dari workstation yang Anda andalkan untuk tenggat waktu.
-
Baca kartu konversi yang tepat sebelum memilihnya di antarmuka unduhan model. Untuk contoh satu mesin di atas, identifikatornya adalah
mlx-community/Muse-Spark-Open-816B-A42B-oQ3e. Siapkan kapasitas untuk checkpoint, cache unduhan, runtime, dan pekerjaan yang ingin Anda lakukan. Mac 256GB berada di bawah kebutuhan yang dipublikasikan untuk varian ini; meringkas balasan menjadi satu kalimat tidak menghilangkan kebutuhan penyimpanan bobot. -
Mulai dengan tugas singkat yang bisa dibuang. Coba pertanyaan teks sederhana atau tangkapan layar non-sensitif dengan jawaban singkat. Pastikan model berhasil dimuat dan hasilnya berguna sebelum menambah konteks atau alat. Berhasil dimuat membuktikan kompatibilitas, bukan akurasi faktual.
-
Tambahkan tindakan hanya setelah alur baca-saja berfungsi. Bekerjalah di salinan proyek. Batasi berkas dan alat yang dapat dijangkau agen, dan wajibkan konfirmasi sebelum tindakan eksternal. Pastikan perubahan dapat ditinjau, alih-alih membiarkan eksperimen pertama mengubah satu-satunya salinan kerja Anda.
Utamakan jalur unduhan dan pemilihan model yang didukung aplikasi dibanding perintah umum yang disalin dari halaman model lain. MLX LM juga menyediakan jalur baris perintah, tetapi dukungan model dan rilis paket bisa berkembang dengan kecepatan berbeda. Pull request dukungan Muse berguna sebagai referensi kompatibilitas saat memilih versi, bukan alasan untuk memasang cabang pengembangan sembarangan.
Anda tidak perlu membeli perangkat keras untuk memahami kegunaan model ini. Endpoint ter-host dapat menjawab apakah model menangani tugas representatif Anda sebelum Anda menyelidiki penerapan lokal. Tinjau harga, penanganan data, dan kontrol pengeluaran penyedia terlebih dahulu. Demonstrasi publik adalah sarana belajar, bukan backend produksi gratis.
Ukur pekerjaan yang selesai, bukan sekadar penghitung token
Token per detik membantu menjelaskan konfigurasi inferensi. Namun, angka itu tidak memberi tahu apakah asisten menghemat waktu sore Anda atau membuat kesalahan terselubung. Perubahan salah yang lebih cepat dapat menimbulkan biaya lebih besar daripada perubahan benar yang lebih lambat, terutama ketika agen jangka panjang mengulang asumsi kelirunya sendiri.
Perbandingan praktis menggunakan kumpulan kecil tugas yang sama di berbagai konfigurasi kandidat. Sertakan perubahan kode dengan pengujian yang sudah ada, tangkapan layar dengan masalah yang diketahui, dan pertanyaan dokumen yang jawabannya dapat ditelusuri ke suatu bagian. Pertahankan prompt dan kriteria penerimaan tetap sama. Kemudian catat ketepatan, waktu hingga hasil ditinjau, intervensi yang diperlukan, serta penggunaan sumber daya puncak jika alat Anda menampilkannya.
Perlakukan prefill dan generasi sebagai bagian waktu tunggu yang berbeda. Masukan panjang dapat membuat respons pertama lambat meski token berikutnya tiba dengan cepat. Agen juga bisa menghabiskan waktu untuk kompilasi, penjelajahan web, atau menunggu alat lain. Hitung waktu itu saat membandingkan konfigurasi lokal dengan layanan ter-host; waktu tersebut tetap menjadi bagian pengalaman pengguna meskipun terjadi di luar model.
Ulangi perbandingan setelah pemutakhiran checkpoint atau runtime yang berarti. Anda tidak memerlukan benchmark besar untuk mengetahui bahwa perubahan merusak alur kerja normal. Beberapa pekerjaan representatif yang diperiksa secara konsisten lebih berguna daripada tangkapan layar satu jawaban yang mengesankan.
Open-weight memberi pilihan, bukan privasi otomatis atau hak tanpa batas
Model lokal dapat menjalankan inferensi di mesin Anda. Namun, aplikasi lengkapnya masih dapat menggunakan pencarian web, telemetri, alat eksternal, penyimpanan jarak jauh, atau model cadangan ter-host. Petakan aliran data untuk alur kerja sebenarnya sebelum menyebutnya privat. Eksperimen teks luring dan agen belanja berbasis browser memiliki batas yang berbeda meski keduanya berawal dari checkpoint yang sama.
Lisensi Model Muse juga memiliki ketentuan. Lisensi itu mewajibkan atribusi dan kebijakan penggunaan yang menyertainya, serta mencakup ketentuan terpisah bagi bisnis tertentu yang menyediakan model sebagai layanan. Ini rilis open-weight dengan lisensi khusus, bukan pernyataan menyeluruh bahwa semua penggunaan bebas batasan. Periksa lisensi terkini untuk distribusi atau layanan yang Anda rencanakan.
Bagi tim, kepemilikan harus mencakup jawaban operasional selain jawaban hukum. Siapa yang menyetujui versi model baru? Siapa yang dapat memulihkan konfigurasi sebelumnya? Ke mana prompt dan hasil alat dikirim? Siapa yang meninjau perubahan sebelum sampai ke pelanggan? Pertanyaan-pertanyaan itu bukan argumen untuk menolak inferensi lokal. Justru itulah yang menjadikan inferensi lokal layanan andal, bukan demonstrasi sehari.
Intinya: AI lokal menjadi pilihan konfigurasi
Tonggak sebenarnya bukan semua komputer kini bisa menjalankan model raksasa. Yang terjadi adalah semakin banyak keputusan penerapan terlihat dan tersedia bagi pengguna: bobot mana, konversi mana, mesin mana, runtime mana, dan alat mana.
Muse Spark Open membuat pilihan itu konkret. Dua Mac berkapasitas memori besar menunjukkan satu jalur; konversi yang lebih kecil menunjukkan jalur lain; inferensi ter-host menawarkan kompromi yang berbeda lagi. Pilih konfigurasi terkecil yang secara andal menyelesaikan pekerjaan yang Anda pedulikan. Pertanyaan berguna berikutnya bukan “Bisakah saya membuatnya termuat?” melainkan “Bisakah saya memercayai hasil pekerjaan yang saya terima?”
Sumber dan demonstrasi
- Meta: peluncuran Muse Spark Open, 15 Oktober 2026.
- Kartu model dan spesifikasi checkpoint Meta.
- Hugging Face: panduan runtime, kondisi pengujian MLX, dan demonstrasi agen, 15 Oktober 2026.
- Konversi oQ3e: satuan penyimpanan, encoder yang disertakan, dan penggunaan.
- Konversi oQ4e: penyimpanan dan peringatan penggunaan satu mesin.
- Dokumentasi pemasangan oMLX dan rilis v0.7.1rc1.
- Dukungan Muse di MLX LM.
- Lisensi Model Muse.
Informasi produk dan kompatibilitas diperiksa pada 16 Oktober 2026. Angka performa di atas merupakan pengukuran penerbit yang diatribusikan beserta kondisi pengujiannya.
Pertahankan keputusan, bukan hanya nama model
Bagi pembaca yang mengumpulkan tautan sumber, catatan konfigurasi, dan keputusan peninjauan, Telli.sh adalah salah satu ruang kerja opsional. Buat catatan riset.