MiniCPM-OCR đọc cả thư mục bản quét trên máy. Trang nào vẫn cần người kiểm tra?
MiniCPM-OCR SDK 1.0.5 xử lý nhiều đầu vào trong một lượt. Giữ kết quả riêng từng tài liệu, kiểm tra trường quan trọng và chọn bản quét đưa vào kho tìm kiếm được.
Ba hóa đơn cũ đọc được bằng mắt nhưng khó tìm kiếm. Một tệp PDF đã được làm phẳng. Một tờ được chụp ảnh với góc gập. Tờ cuối là bản quét rõ nhưng bảng kéo dài qua hai trang. Công cụ OCR chạy cục bộ có thể chuyển ảnh thành chữ. Người duyệt kho lưu trữ vẫn cần biết mỗi kết quả thuộc tệp nào và các cột còn giữ đúng ý nghĩa không.
Ngày 9 tháng 11 năm 2026, OpenBMB phát hành MiniCPM-OCR SDK phiên bản 1.0.5. Bản cập nhật nhận nhiều đầu vào trong một lượt và trả kết quả riêng cho từng tệp. Một tùy chọn riêng có thể coi từng ảnh độc lập là một tài liệu. Mô hình MiniCPM-OCR 1.0 có 1,3 tỷ tham số, được thiết kế cho tài liệu và PDF tiếng Trung và tiếng Anh. OpenBMB đã phát hành mô hình và SDK trước đó, đồng thời công bố hướng dẫn chạy dịch vụ nhận dạng cục bộ. Bản phát hành trên PyPI · Dự án và lịch sử thay đổi của OpenBMB
Phép thử hữu ích bắt đầu bằng một lô nhỏ có thể kiểm tra kết quả. Gắn mã nhất quán cho từng đầu vào, giữ kết quả trích xuất cạnh tài liệu và kiểm tra các trường có thể gây hậu quả nếu sai. Đó là khác biệt giữa bản nháp tìm kiếm được và một hồ sơ có thể dùng để quyết định.
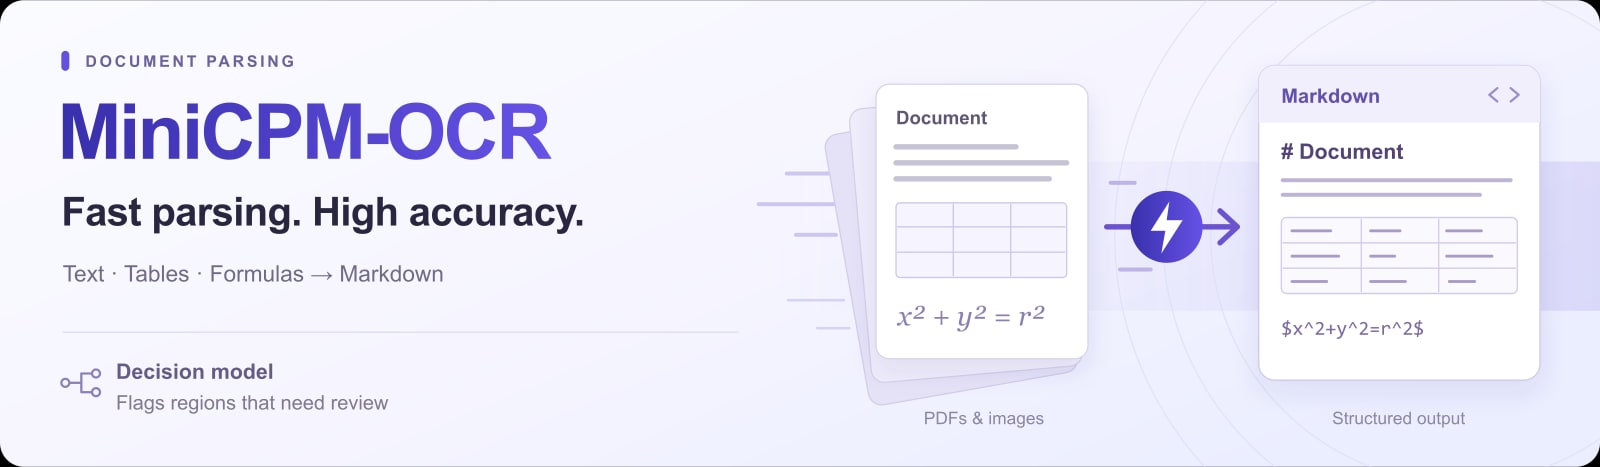
Minh họa phát hành chính thức của OpenBMB cho thấy tài liệu được chuyển thành văn bản có cấu trúc. Apache 2.0. Telli.sh đã chuyển thành ảnh raster và đổi kích thước. Hình gốc

Bản cập nhật giúp giữ ranh giới giữa các tài liệu
Ghi chú phát hành ngày 9 tháng 11 của OpenBMB cho biết phiên bản 1.0.5 trả một kết quả cho từng tệp khi nhận nhiều đầu vào. Tùy chọn --split-images coi các ảnh độc lập là những tài liệu riêng. Hai chi tiết đó quan trọng khi văn phòng có cả PDF nhiều trang lẫn ảnh chụp. Hóa đơn đã gộp thành một PDF thường nên giữ nguyên. Hai ảnh không liên quan nên là hai hồ sơ khác nhau. Gói MiniCPM-OCR 1.0.5 và ghi chú phát hành
Để đánh giá ở quy mô nhỏ, chuẩn bị một tài liệu mỗi loại. PDF rõ giúp xác định thứ tự đọc mong đợi. Ảnh một tờ giấy cho thấy nếp gập, góc xoay hoặc ánh chói có làm hỏng một vùng không. Bảng dày cho thấy điều gì xảy ra khi hai cột có số liệu tương tự. Nếu kho có ảnh chụp hai trang của cùng hồ sơ, quyết định cách nhóm trước khi đưa vào trình phân tích. Cách nhóm thuộc về tài liệu, còn lệnh xử lý nhận các tệp.
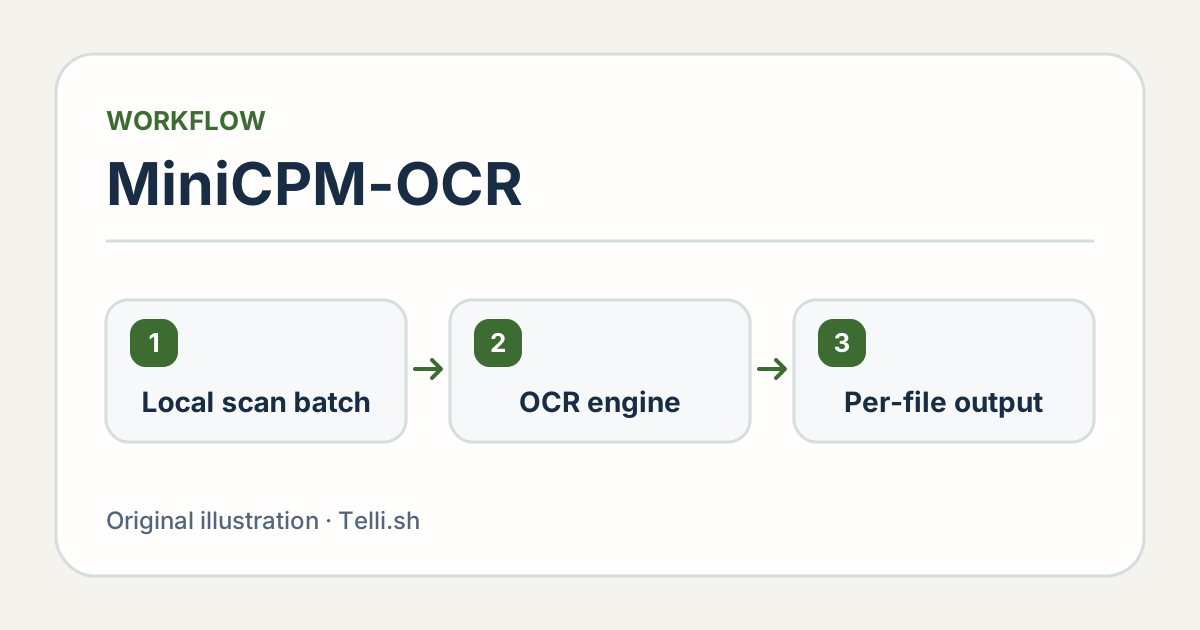
Lô ví dụ dùng một mã nhất quán cho mỗi tài liệu và giữ nguồn qua khâu duyệt. Minh họa do Telli.sh thực hiện.
Lập danh mục đầu vào ghi bản gốc, số trang và đầu ra dự kiến. Nếu dùng mã kiểm tra để phát hiện thay đổi ngoài ý muốn, hãy tính từ bản gốc trước khi chạy lô. Lưu kết quả trích xuất ở đích riêng để lần thử sau không ghi đè nguồn duy nhất. Nếu hai thư mục cùng có tệp invoice.pdf, mã nhất quán vẫn giúp ghép đúng cặp khi tên tệp trùng nhau.
Chọn định dạng quy trình tiếp theo đọc được. SDK của OpenBMB tổng hợp kết quả dưới dạng Markdown hoặc JSON tùy cấu hình. Markdown tiện cho người đọc bản nháp. Dữ liệu có cấu trúc có thể giúp bước sau xử lý các vùng mà trình phân tích trả về. Với cả hai, vẫn cần đối chiếu ảnh khi số liệu hoặc trường sẽ được dùng để quyết định. Quy trình phân tích OpenBMB
Chạy cục bộ vẫn có bước phân tích bố cục và bước nhận dạng
OpenBMB mô tả hai phần khi phân tích toàn trang trên máy tính. SDK chạy mô hình bố cục để xác định vị trí và thứ tự của văn bản, bảng, công thức và các vùng khác. SDK gửi các vùng đã cắt qua HTTP tới dịch vụ nhận dạng, rồi ghép phản hồi theo thứ tự đọc. Bạn có thể chạy cả hai phần trên phần cứng mình kiểm soát. Dịch vụ nhận dạng là môi trường riêng và SDK cũng có thể trỏ đến dịch vụ đặt ở nơi khác. Hướng dẫn phân tích toàn trang và triển khai cục bộ của OpenBMB
Ranh giới này quan trọng khi tài liệu có dữ liệu riêng tư. Hãy xác định bước bố cục gửi các vùng ảnh đi đâu. SDK chạy trên máy mà gọi dịch vụ lưu trú bên ngoài vẫn có thể gửi nội dung tài liệu qua mạng. Khi triển khai cục bộ, cấu hình đúng dịch vụ đích và áp dụng chính sách lưu trữ, ghi nhật ký đã được tổ chức duyệt. Bản trình diễn công khai dùng ví dụ giả lập có thể cho biết giao diện hoạt động thế nào mà không cần gửi tài liệu khách hàng thật.
Ngày 5 tháng 11, OpenBMB công bố ảnh Docker đóng gói SDK, vLLM và mô hình. Cấu hình được mô tả cần Linux x86-64, GPU NVIDIA, trình điều khiển tương thích CUDA 12.9 và Docker với NVIDIA Container Toolkit. OpenBMB cũng hướng dẫn các nền chạy dịch vụ nhận dạng như llama.cpp và Ollama. Kích thước mô hình chưa cho biết một máy có chạy tốt cả quy trình không. Kiểm tra phần bố cục, định dạng mô hình, bộ nhớ và thông lượng trên máy đích. Yêu cầu triển khai của OpenBMB
Tài liệu riêng lẻ còn có cách xử lý trên điện thoại. OpenBMB thông báo phân tích ngoại tuyến trên iOS ngày 2 tháng 11. Bản cập nhật dự án ngày 12 tháng 11 đưa bản trình diễn chạy trên thiết bị lên Android và HarmonyOS. Bản trình diễn di động và SDK xử lý lô trên máy tính là các cách dùng riêng. Chọn theo nơi lưu tệp và cách bạn định kiểm tra kết quả. Lịch sử phát hành di động của OpenBMB
Kiểm tra các trường có thể sai mà vẫn trông hợp lý
Giả sử hóa đơn có một dòng 10 đơn vị, đơn giá 38,50. Bảng trích xuất ghi 38,50 vào cột số lượng và 10 vào cột đơn giá. Bài kiểm tra chỉ tìm xem cả hai số có xuất hiện hay không có thể cho qua. Với người dùng kết quả, giá trị thuộc cột nào mới là thông tin quan trọng. Hãy so cả hàng, tiêu đề cột và tổng tiền cùng nhau.
Với kho phục vụ tìm kiếm, rủi ro khác đi. Lỗi đánh máy trong ghi chú mô tả có thể chấp nhận được nếu nhân viên tìm được bản gốc. Sai số đơn mua có thể dẫn họ đến nhầm tài liệu. Định nghĩa các trường phải khớp tuyệt đối và kiểm tra với bản gốc. Nếu trang có mã, giữ các số 0 ở đầu khi rà soát. Chế độ hiển thị số hoặc thao tác nhập bảng tính có thể bỏ mất chúng dù trình phân tích đọc đúng.
| Ví dụ tài liệu | Mục đối chiếu với bản gốc | Điều cần quyết định trước khi dùng tiếp |
|---|---|---|
| Hóa đơn | Mã nhà cung cấp, số hóa đơn, đơn vị tiền tệ, tổng và tiêu đề cột tương ứng | Trường nào phải khớp chính xác |
| Báo cáo nhiều cột | Tiêu đề, thứ tự cột và chú thích bên cạnh hình | Kết quả có đọc theo đúng thứ tự không |
| Biểu mẫu bị xoay hoặc chụp ảnh | Tên, ô đánh dấu, dấu đóng hoặc mục gần nếp gập | Trang nào cần kiểm tra tay hoặc quét lại |
| Bản quét nhiều ngôn ngữ | Mã định danh và văn bản trường trong mỗi ngôn ngữ | Ngôn ngữ nào đạt tiêu chí của kho |
OpenBMB mô tả MiniCPM-OCR 1.0 là mô hình hướng tới tiếng Trung và tiếng Anh. Nhóm xử lý tiếng Hàn hoặc trang trộn ngôn ngữ nên đo độ chính xác trên những trang đó. Phép thử thực tế có tài liệu dày, biểu mẫu rõ và ảnh chụp cho từng ngôn ngữ quan trọng. Ghi loại lỗi thay vì lấy trung bình từ một nhóm nhỏ tài liệu khác nhau. Mô tả mô hình của OpenBMB
Điểm từng vùng giúp quyết định người duyệt nên xem gì trước
OpenBMB còn công bố MiniCPM-OCR Jev, mô hình riêng để đánh giá văn bản, công thức và bảng đã trích xuất so với vùng ảnh. Dự án mô tả điểm số là cách tìm các vùng có thể cần duyệt. Khi xử lý lô, có thể dùng điểm để sắp thứ tự và vẫn đối chiếu trường có hậu quả lớn với bản gốc. Hãy đo mức độ nó xếp đúng những lỗi bạn quan tâm trước khi dùng điểm để định tuyến hàng đợi. OpenBMB giải thích MiniCPM-OCR Jev
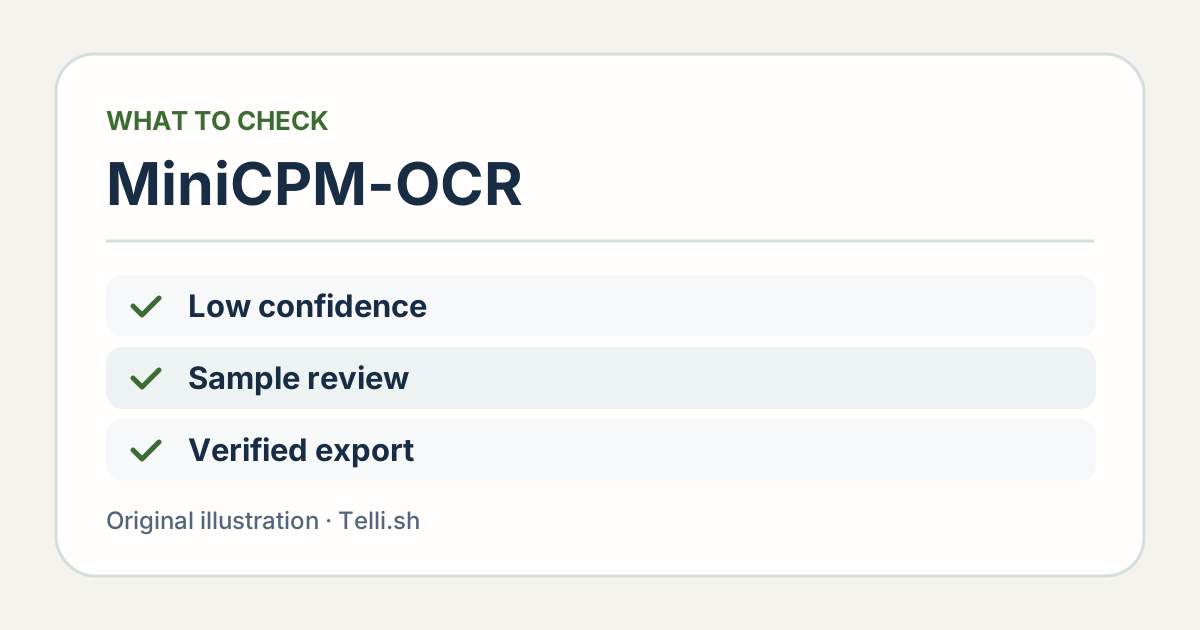
Chấm điểm vùng là bước tùy chọn để ưu tiên kiểm tra. Các trường chi phối thanh toán, mã định danh hoặc quyết định khác vẫn có thể cần đối chiếu trực tiếp. Minh họa do Telli.sh thực hiện.
Để xem điểm số giúp ở đâu, chuẩn bị bộ tham chiếu nhỏ với vài lỗi nhóm đã biết cách nhận diện. Thiếu một ký tự trong mã linh kiện, lệch hàng trong bảng và một câu trên trang rõ cho phép thử các kiểu lỗi khác nhau. Đưa thêm vài vùng đúng. Xem những ca mô hình cho điểm cao với lỗi hoặc điểm thấp với kết quả đúng. Đó là các ví dụ cần bàn trước khi đưa ngưỡng vào quy trình.
Giữ các chênh lệch hiển thị. Nếu người duyệt sửa tổng tiền, lưu kết quả OCR ban đầu và ghi thay đổi cùng tài liệu nguồn. Nhờ vậy nhóm biết lỗi có tập trung vào một loại tài liệu hoặc cách thu ảnh nào không. Người tiếp theo cũng phân biệt được phần sửa của con người với kết quả đầu của mô hình.
Thời gian rà soát có thể quyết định cách xử lý lô này có mở rộng được không. Ghi thời gian để xử lý một vấn đề và các kiểu trang cần xem lần hai. Công cụ cục bộ có thể tiết kiệm công trên tài liệu rõ nhưng kéo dài hàng đợi của bản quét kém. Nếu cùng một biểu mẫu giấy liên tục gặp lỗi, cải thiện cách quét có thể hiệu quả hơn thêm mô hình.
Dùng một lô nhỏ có thể gặp nhiều kiểu lỗi khác nhau
- Thu thập tài liệu mẫu đã được phép. Dùng một bản quét rõ, ảnh chụp bị xoay và bảng nhiều trang, có ngôn ngữ và bố cục đại diện. Giữ mỗi bản gốc theo một mã nhất quán.
- Chọn cách chạy cục bộ đã được duyệt. Với lô trên máy tính, theo hướng dẫn triển khai của OpenBMB và xác minh điểm cuối của dịch vụ nhận dạng. Kiểm tra yêu cầu phần cứng và môi trường trước khi tải tệp. Hướng dẫn triển khai cục bộ chính thức
- Chạy SDK và giữ kết quả riêng cho từng tệp. Ghi phiên bản SDK, mô hình hoặc mức lượng tử hóa, nền chạy và định dạng đầu ra. Chọn có chủ đích cách nhóm ảnh và giữ nguồn của mỗi kết quả. Hướng dẫn SDK 1.0.5
- Rà soát theo công việc kho sẽ phục vụ. Kiểm tra thứ tự đọc phục vụ tìm kiếm và các trường thiết yếu cho bước trích xuất tiếp theo. Ghi tài liệu nào được chấp nhận, sửa hoặc loại và vì sao.
- Lặp lại với một lô nhỏ mới. Áp dụng cùng tiêu chí. So sánh thời gian đến khi duyệt xong và khả năng truy về nguồn. Xử lý các loại tài liệu còn cần làm tay trước khi tăng số lượng.
Chọn phạm vi phù hợp. Trợ lý giúp tìm trong bản quét tài liệu họp không cần bảo đảm từng trường giống một công cụ điền biểu mẫu thanh toán hóa đơn. Nếu nhu cầu trước mắt là tìm kiếm hoặc quy trình khác có thể đảo ngược, hãy bắt đầu ở đó. Đợt thử có thể cho thấy kiểu trích xuất nào về sau cần kiểm tra chặt hơn.
Cho kho lưu trữ cách hiển thị nội dung đã lập chỉ mục. Nếu kết quả tìm kiếm chỉ hiện văn bản do máy trích xuất, người dùng có thể tin đoạn trông hợp lý là nguồn chính xác. Hiển thị tên tệp hoặc mã tài liệu cạnh kết quả và giúp mở trang tương ứng dễ dàng. Nếu có trạng thái duyệt, hãy hiển thị cùng kết quả. Người dùng sẽ biết khi nào cần đọc bản gốc.
Có một phép thử khôi phục cho lô tài liệu dùng chung thư mục đầu ra. Giả sử một tệp lỗi và bạn chỉ chạy lại tệp đó với cấu hình khác. Xác minh các kết quả khác còn nguyên và danh mục chỉ đúng đầu ra của lượt hai. Bài kiểm tra không cần tự động chạy lại. Nó cho biết có thể cải thiện một kết quả mà không mất hồ sơ của các tệp còn lại hay không.
Lô có giá trị khi mọi kết quả đều dẫn về trang nguồn
Bản cập nhật SDK MiniCPM-OCR giảm công gửi từng tệp riêng. Phần còn lại là quyết định của kho lưu trữ. Giữ ranh giới tài liệu, chọn nơi xử lý ảnh và để yêu cầu của quy trình tiếp theo quyết định mức kiểm tra từng trường. Khi tháng sau có người tìm thấy một con số, họ cần mở được trang gốc và thấy những gì trình phân tích đã nhận.
Nguồn
- MiniCPM-OCR SDK 1.0.5 trên PyPI ngày 9 tháng 11 năm 2026
- Kho mã MiniCPM-OCR của OpenBMB, thẻ mô hình, ngày phát hành và hướng dẫn triển khai
- Bản trình diễn công khai của OpenBMB
- Minh họa phát hành và giấy phép của OpenBMB
Để lưu và tìm lại các quyết định rà soát khi xây kho tài liệu, hãy tạo tài khoản Telli.sh.