MiniCPM-OCR อ่านไฟล์สแกนทั้งโฟลเดอร์ในเครื่องได้ หน้าไหนยังต้องให้คนตรวจ?
MiniCPM-OCR SDK 1.0.5 รับหลายไฟล์ต่อรอบ เก็บผลแยกตามเอกสาร ตรวจช่องสำคัญ แล้วเลือกไฟล์สแกนที่พร้อมเข้าคลังค้นหาได้
ใบแจ้งหนี้เก่าสามฉบับอ่านด้วยตาได้แต่ค้นหายาก ฉบับแรกเป็น PDF ที่รวมองค์ประกอบเป็นชั้นเดียว ฉบับที่สองเป็นรูปถ่ายกระดาษมุมงอ ฉบับสุดท้ายสแกนชัดแต่มีตารางต่อกันสองหน้า OCR ที่รันในเครื่องแปลงภาพเป็นข้อความได้ แต่คนอนุมัติคลังต้องรู้ว่าผลไหนมาจากไฟล์ไหน และคอลัมน์ยังสื่อความหมายเดิมหรือไม่
วันที่ 9 พฤศจิกายน 2026 OpenBMB ออก MiniCPM-OCR SDK เวอร์ชัน 1.0.5 รับหลายไฟล์ต่อรอบและให้ผลแยกแต่ละไฟล์ มีตัวเลือกให้ภาพเดี่ยวเป็นเอกสารแยกกัน โมเดล MiniCPM-OCR 1.0 ขนาด 1.3 พันล้านพารามิเตอร์ออกแบบมาสำหรับเอกสารและ PDF ภาษาจีนกับอังกฤษ OpenBMB เปิดตัวโมเดลและ SDK ก่อนหน้านี้แล้ว และเผยแพร่ขั้นตอนรันบริการรู้จำในเครื่อง รุ่นที่เผยแพร่บน PyPI · โครงการและประวัติการเปลี่ยนแปลง OpenBMB
เริ่มทดลองด้วยชุดเล็กที่ตรวจสอบย้อนหลังได้ กำหนดรหัสประจำไฟล์ เก็บผลการอ่านคู่กับต้นฉบับ และตรวจช่องที่ผิดแล้วมีผลต่อการใช้งาน วิธีนี้แยกร่างที่ค้นหาได้ออกจากบันทึกที่นำไปใช้ตัดสินใจได้
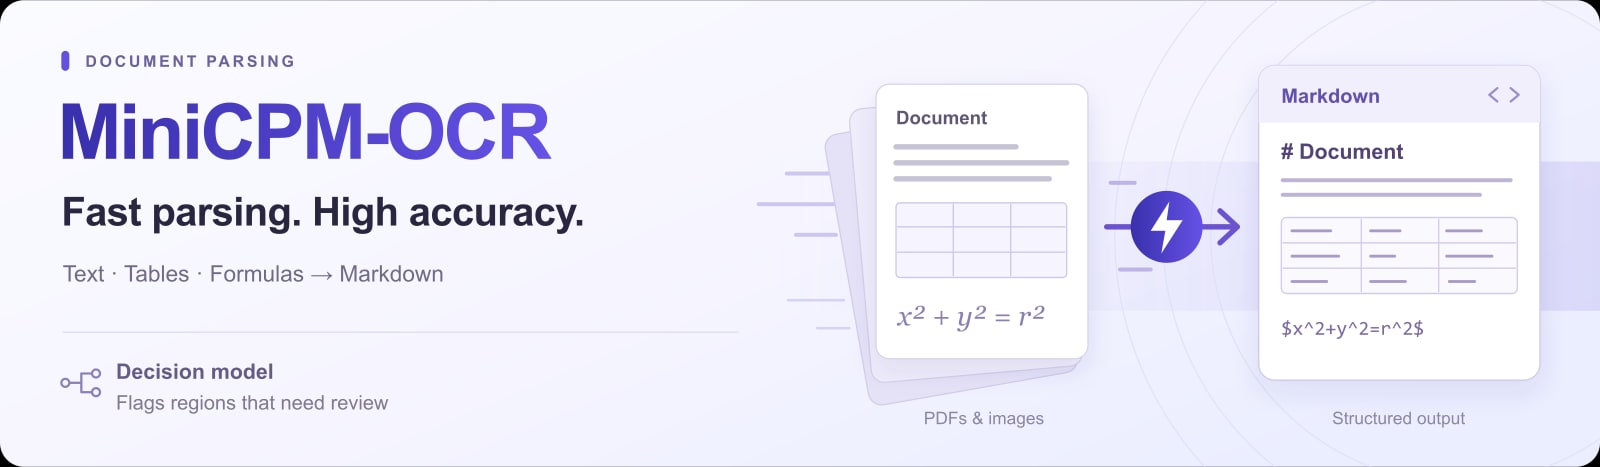
ภาพเปิดตัว MiniCPM-OCR ทางการของ OpenBMB แสดงเอกสารที่ถูกแปลงเป็นข้อความมีโครงสร้าง Apache 2.0 แปลงเป็นภาพราสเตอร์และปรับขนาดโดย Telli.sh ภาพต้นฉบับ

รุ่นนี้ช่วยรักษาขอบเขตของแต่ละเอกสาร
บันทึกรุ่น OpenBMB วันที่ 9 พฤศจิกายนระบุว่า 1.0.5 ให้ผลหนึ่งชุดต่อไฟล์เมื่อรับหลายไฟล์ ตัวเลือก --split-images ให้ภาพเดี่ยวเป็นคนละเอกสาร เรื่องนี้สำคัญกับสำนักงานที่มีทั้ง PDF หลายหน้าและรูปจากกล้อง ใบแจ้งหนี้ที่รวมอยู่ใน PDF เดียวควรอยู่ด้วยกัน ส่วนภาพที่ไม่เกี่ยวกันสองภาพควรเป็นสองรายการ แพ็กเกจ MiniCPM-OCR 1.0.5 และบันทึกรุ่น
สำหรับการประเมินเล็ก ๆ ให้เตรียมเอกสารอย่างละหนึ่งชนิด PDF ชัด ๆ ใช้กำหนดลำดับการอ่าน ภาพถ่ายช่วยดูว่ารอยพับ การหมุน หรือแสงสะท้อนทำให้ส่วนใดอ่านผิด ตารางแน่น ๆ แสดงผลเมื่อสองคอลัมน์มีค่าใกล้กัน หากคลังมีรูปสองหน้าจากเอกสารเดียว ให้กำหนดวิธีรวมก่อนส่งเข้าเครื่องมือ การจัดกลุ่มมาจากตัวเอกสาร ส่วนคำสั่งรับเป็นไฟล์
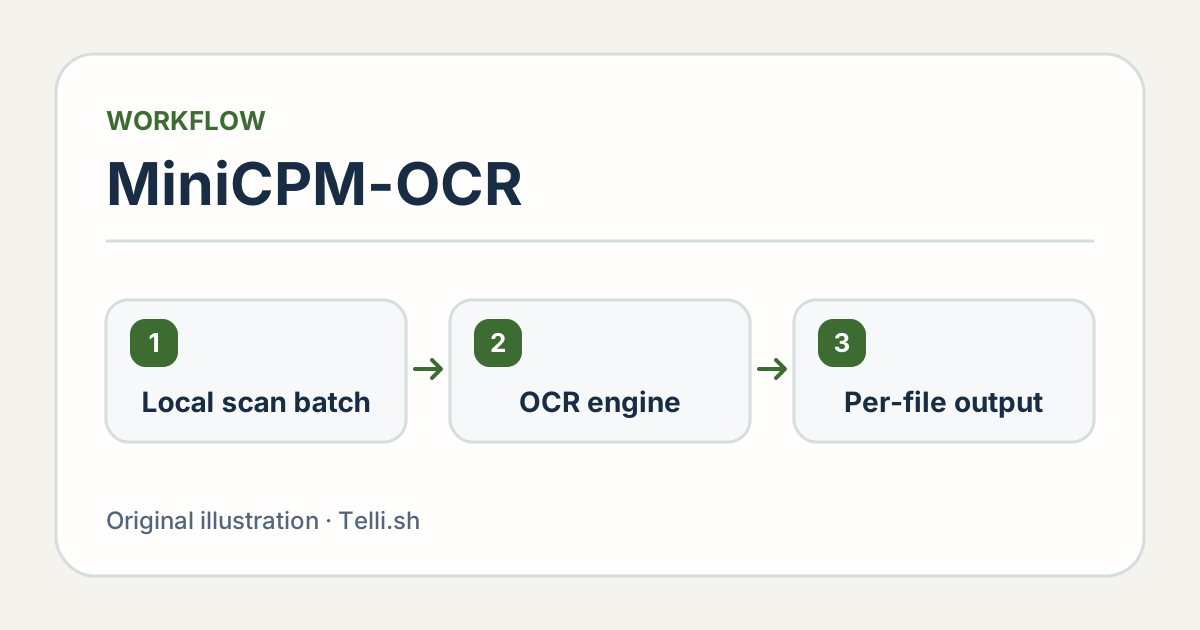
ตัวอย่างการประมวลผลใช้รหัสเอกสารคงที่สำหรับแต่ละไฟล์และเก็บต้นฉบับไว้ตลอดการตรวจ ภาพประกอบโดย Telli.sh
ทำรายการไฟล์นำเข้าที่ระบุต้นฉบับ จำนวนหน้า และผลที่คาด ถ้าใช้เช็กซัมตรวจการเปลี่ยนโดยไม่ตั้งใจ ให้สร้างจากต้นฉบับก่อนเริ่ม เก็บผลการอ่านแยกที่เพื่อไม่ให้รอบถัดไปเขียนทับต้นฉบับเพียงฉบับเดียว หากสองโฟลเดอร์มีไฟล์ชื่อ invoice.pdf เหมือนกัน รหัสที่คงที่จะช่วยจับคู่แม้ชื่อไฟล์กำกวม
เริ่มจากรูปแบบที่ขั้นถัดไปอ่านได้ SDK ของ OpenBMB รวมผลเป็น Markdown หรือ JSON ตามการตั้งค่า Markdown เหมาะให้คนอ่านร่าง ผลแบบมีโครงสร้างช่วยให้โปรแกรมปลายทางจัดการส่วนของหน้าที่เครื่องมือส่งกลับได้ ทั้งคู่ยังต้องเทียบกับภาพหากจะใช้ตัวเลขหรือช่องนั้นตัดสินใจ ขั้นตอนอ่านเอกสารของ OpenBMB
การรันในเครื่องมีขั้นจัดโครงหน้าและขั้นรู้จำ
OpenBMB อธิบายการอ่านเต็มหน้าบนเดสก์ท็อปเป็นสองส่วน SDK ใช้โมเดลโครงหน้าเพื่อหาและจัดลำดับข้อความ ตาราง สูตร และส่วนอื่น ๆ แล้วส่งภาพที่ตัดเป็นส่วนผ่าน HTTP ไปยังบริการรู้จำ ก่อนนำคำตอบมารวมตามลำดับอ่าน คุณรันทั้งสองส่วนบนฮาร์ดแวร์ที่ควบคุมได้ บริการรู้จำเป็นสภาพแวดล้อมแยก และ SDK ตั้งให้เรียกบริการที่อื่นได้เช่นกัน คู่มืออ่านเต็มหน้าและติดตั้งในเครื่องของ OpenBMB
ขอบเขตนี้สำคัญเมื่อเอกสารมีข้อมูลส่วนตัว ให้ตรวจว่าขั้นจัดโครงหน้าส่งส่วนภาพไปไหน SDK ที่รันในเครื่องแต่ตั้งให้เรียกบริการภายนอกยังส่งเนื้อหาผ่านเครือข่ายได้ การรันในเครื่องควรชี้ไปยังบริการที่ตั้งใจและใช้กติกาการจัดเก็บและบันทึกขององค์กร ลองเดโมสาธารณะด้วยตัวอย่างสังเคราะห์เพื่อดูหน้าจอโดยไม่ส่งเอกสารลูกค้าจริง
วันที่ 5 พฤศจิกายน OpenBMB เผยแพร่อิมเมจ Docker ที่รวม SDK, vLLM และโมเดล การตั้งค่าตามเอกสารต้องใช้ Linux x86-64, GPU NVIDIA, ไดรเวอร์ที่รองรับ CUDA 12.9 และ Docker พร้อม NVIDIA Container Toolkit คู่มือยังมีแบ็กเอนด์อย่าง llama.cpp และ Ollama สำหรับบริการรู้จำ ขนาดโมเดลอย่างเดียวบอกไม่ได้ว่าเครื่องหนึ่งจะรันทั้งกระบวนการได้คล่องหรือไม่ ให้ตรวจส่วนจัดโครงหน้า รูปแบบโมเดล หน่วยความจำ และอัตราประมวลผลบนเครื่องเป้าหมาย ข้อกำหนดการติดตั้งของ OpenBMB
มือถือเป็นอีกทางสำหรับเอกสารทีละฉบับ OpenBMB ประกาศการอ่านแบบออฟไลน์บน iOS วันที่ 2 พฤศจิกายน อัปเดตโครงการวันที่ 12 พฤศจิกายนขยายเดโมในเครื่องไปยัง Android และ HarmonyOS เดโมมือถือกับ SDK ประมวลผลหลายไฟล์บนเดสก์ท็อปเป็นคนละทางเลือก ให้เลือกตามที่อยู่ของไฟล์และวิธีตรวจผล ประวัติรุ่นมือถือของ OpenBMB
ตรวจช่องที่ผิดได้แม้ดูเหมือนถูก
สมมติว่าใบแจ้งหนี้มีสินค้า 10 หน่วย หน่วยละ 38.50 ตารางที่อ่านได้กลับวาง 38.50 ในช่องจำนวนและ 10 ในช่องราคาต่อหน่วย ระบบที่เช็กเพียงว่ามีตัวเลขทั้งสองอาจให้ผ่าน สำหรับคนใช้ข้อมูล สิ่งสำคัญคือค่าต้องจับคู่คอลัมน์ถูก เทียบทั้งแถว หัวคอลัมน์ และยอดรวมพร้อมกัน
ความเสี่ยงของคลังค้นหาต่างออกไป คำสะกดผิดในบันทึกบรรยายอาจยอมได้ถ้ายังหาต้นฉบับเจอ เลขใบสั่งซื้อผิดอาจพาไปผิดเอกสาร กำหนดว่าช่องใดต้องตรงทุกตัวและตรวจเทียบต้นฉบับ ถ้าหน้ามีรหัสให้คงเลขศูนย์ด้านหน้า การแสดงเป็นตัวเลขหรือนำเข้าในสเปรดชีตอาจตัดศูนย์แม้เครื่องมืออ่านถูก
| ตัวอย่างเอกสาร | สิ่งที่เทียบกับต้นฉบับ | สิ่งที่ตัดสินใจก่อนใช้ต่อ |
|---|---|---|
| ใบแจ้งหนี้ | รหัสผู้ขาย เลขใบแจ้งหนี้ สกุลเงิน ยอดรวม และหัวคอลัมน์ | ช่องใดต้องตรงทุกตัว |
| รายงานหลายคอลัมน์ | หัวข้อ ลำดับคอลัมน์ และคำอธิบายข้างรูป | ลำดับการอ่านถูกต้องหรือไม่ |
| แบบฟอร์มหมุนหรือถ่ายด้วยกล้อง | ชื่อ ช่องที่กา ตราประทับ หรือข้อมูลข้างรอยพับ | หน้าใดต้องตรวจด้วยคนหรือสแกนใหม่ |
| สแกนหลายภาษา | รหัสและข้อความของช่องในแต่ละภาษา | ภาษาใดผ่านเกณฑ์ของคลัง |
OpenBMB ระบุว่า MiniCPM-OCR 1.0 มุ่งที่ภาษาจีนและอังกฤษ ทีมที่ใช้ภาษาเกาหลีหรือหน้าที่มีหลายภาษาควรวัดความแม่นยำเอง ทดสอบด้วยเอกสารแน่น ๆ แบบฟอร์มชัด และรูปจากกล้องของแต่ละภาษาที่สำคัญ จดชนิดของข้อผิดพลาดแทนการเอาเอกสารต่างชนิดชุดเล็กมาคิดเป็นคะแนนเดียว คำอธิบายโมเดล OpenBMB
คะแนนรายส่วนช่วยจัดลำดับสิ่งที่ควรตรวจ
OpenBMB ยังเผยแพร่ MiniCPM-OCR Jev โมเดลแยกสำหรับเทียบข้อความ สูตร และตารางที่อ่านได้กับส่วนของภาพ โครงการอธิบายว่าคะแนนช่วยหาจุดที่ควรตรวจ สำหรับการประมวลผลเป็นชุด ใช้คะแนนช่วยเรียงลำดับได้และยังควรเทียบช่องที่มีผลมากกับต้นฉบับ ดูก่อนว่าคะแนนจัดข้อผิดพลาดที่สำคัญได้ดีเพียงใดแล้วจึงใช้กำหนดคิวตรวจ คำอธิบาย MiniCPM-OCR Jev จาก OpenBMB
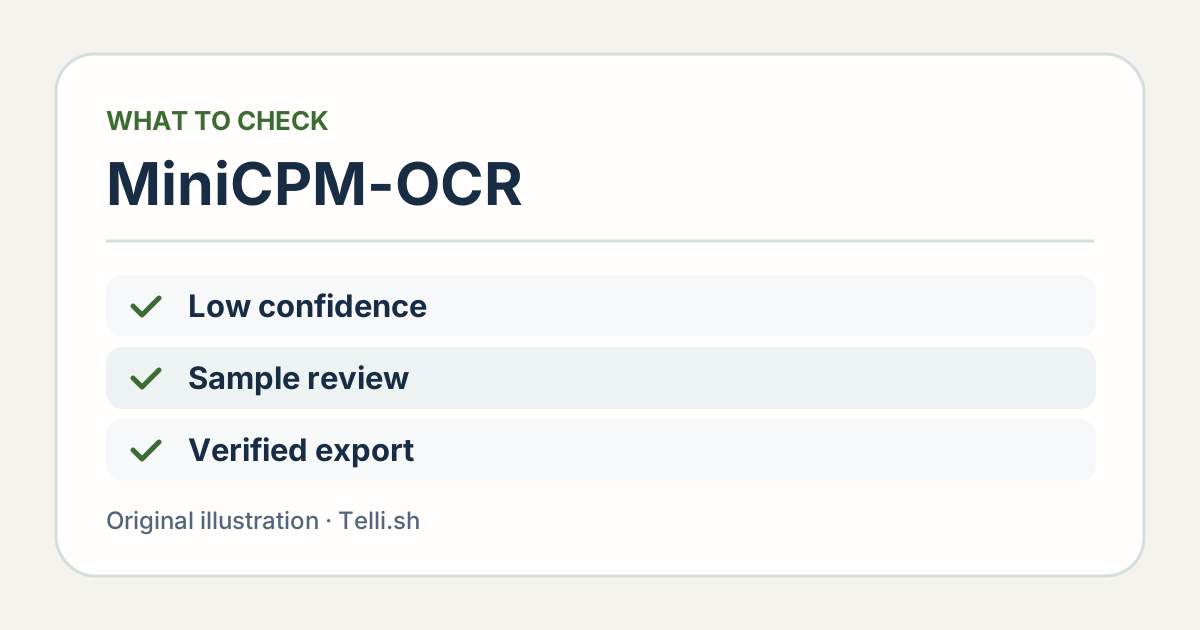
คะแนนรายส่วนเป็นตัวเลือกที่ช่วยจัดลำดับการตรวจ ช่องที่ใช้จ่ายเงิน ระบุตัวตน หรือประกอบการตัดสินใจอาจยังต้องดูโดยตรง ภาพประกอบโดย Telli.sh
ลองใช้ชุดอ้างอิงเล็ก ๆ ที่ทีมรู้ว่ามีข้อผิดพลาดตรงไหน ตัวอักษรหายจากเลขชิ้นส่วน แถวผิดแนว และประโยคบนหน้าที่ชัดทดสอบคนละรูปแบบ ใส่ส่วนที่อ่านถูกไว้ด้วย ดูกรณีที่โมเดลให้คะแนนสูงกับคำตอบผิดหรือคะแนนต่ำกับคำตอบถูก แล้วคุยถึงตัวอย่างเหล่านั้นก่อนกำหนดเกณฑ์คะแนนในงานจริง
เก็บความต่างให้มองเห็นได้ หากผู้ตรวจแก้ยอดรวม ให้รักษาผล OCR เดิมและบันทึกการแก้เทียบกับเอกสารต้นฉบับ ทีมจะดูได้ว่าข้อผิดพลาดกระจุกอยู่กับชนิดเอกสารหรือวิธีถ่ายแบบใด คนถัดไปยังแยกได้ว่าอะไรเป็นผลแรกของโมเดลและอะไรเป็นการแก้ของคน
เวลาที่คนใช้ตรวจมีผลว่าจะขยายวิธีนี้ได้ไหม จดเวลาที่ใช้แก้ปัญหาและชนิดหน้าที่ต้องดูซ้ำ เครื่องมือในเครื่องอาจช่วยประหยัดเวลาสำหรับเอกสารชัด แต่ทำให้ไฟล์สแกนคุณภาพต่ำเข้าคิวนานขึ้น หากแบบกระดาษเดิมล้มเหลวซ้ำ การปรับวิธีสแกนอาจดีกว่าการเพิ่มอีกโมเดล
ใช้ชุดเล็กที่เปิดโอกาสให้เห็นข้อผิดพลาดหลายแบบ
- รวบรวมเอกสารตัวอย่างที่ได้รับอนุญาต ใช้สแกนชัด รูปที่หมุน และตารางหลายหน้าให้เป็นตัวแทนของภาษาและรูปแบบ จัดเก็บต้นฉบับแต่ละฉบับด้วยรหัสคงที่
- เลือกการติดตั้งในเครื่องที่อนุมัติ ถ้ารันหลายไฟล์บนเดสก์ท็อป ให้ทำตามคู่มือ OpenBMB และยืนยันเอนด์พอยต์ที่บริการรู้จำใช้ ตรวจข้อกำหนดเครื่องและสภาพแวดล้อมก่อนโหลดไฟล์ คู่มือติดตั้งในเครื่องทางการ
- รัน SDK และเก็บผลตามไฟล์ จดรุ่น SDK โมเดลหรือการควอนไทซ์ แบ็กเอนด์ และรูปแบบผล เลือกวิธีจัดกลุ่มภาพโดยตั้งใจและเก็บต้นฉบับของทุกผล คำแนะนำ SDK 1.0.5
- ตรวจตามงานที่คลังจะทำ ดูลำดับอ่านสำหรับการค้นหา และช่องสำคัญสำหรับงานปลายทาง จดว่าเอกสารใดผ่าน ถูกแก้ หรือถูกปฏิเสธ พร้อมเหตุผล
- ทำซ้ำด้วยชุดใหม่ขนาดเล็ก ใช้เกณฑ์เดิม เทียบเวลาจนตรวจเสร็จและความสามารถในการตามรอย จัดการชนิดเอกสารที่ยังต้องทำมือก่อนเพิ่มปริมาณ
เลือกงานที่ทำได้ในขอบเขตตอนนี้ ผู้ช่วยค้นเอกสารประชุมที่สแกนไม่ต้องใช้การรับประกันช่องข้อมูลระดับเดียวกับเครื่องมือกรอกใบชำระเงิน เริ่มจากการค้นหาหรือขั้นตอนที่ย้อนกลับได้หากตอบโจทย์ทันที ผลทดลองจะชี้ว่าการอ่านแบบใดต้องเพิ่มการตรวจในภายหลัง
ทำให้คลังแสดงว่าเก็บดัชนีอะไร หากแสดงเฉพาะข้อความที่เครื่องสร้าง ผู้ใช้อาจเชื่อผลที่ดูน่าเชื่อถือทันที ให้แสดงชื่อไฟล์ต้นฉบับหรือรหัสเอกสารข้างผลและหาหน้าที่ตรงกันได้ง่าย หากมีสถานะการตรวจ ให้แสดงไปด้วยเพื่อให้คนรู้ว่าเมื่อไรต้องเปิดต้นฉบับ
ลองทดสอบการแก้เฉพาะไฟล์เมื่อชุดใช้โฟลเดอร์ผลร่วมกัน สมมติว่าไฟล์หนึ่งล้มเหลวและคุณรันเฉพาะไฟล์นั้นด้วยการตั้งค่าอื่น ตรวจว่าผลอื่นยังอยู่และรายการไฟล์ระบุได้ว่าผลไหนมาจากรอบที่สอง วิธีนี้ไม่ต้องมีระบบรันซ้ำอัตโนมัติ แต่ทดสอบว่าคนแก้ผลหนึ่งได้โดยไม่สูญบันทึกจากไฟล์อื่น
ชุดผลมีประโยชน์เมื่อย้อนกลับไปถึงหน้าได้ทุกผล
SDK MiniCPM-OCR รุ่นนี้ลดงานส่งไฟล์ทีละฉบับ ส่วนที่เหลือเป็นเรื่องการจัดการคลัง รักษาขอบเขตเอกสาร เลือกที่ประมวลผลภาพ และให้ความต้องการของงานปลายทางกำหนดว่าต้องตรวจแต่ละช่องมากแค่ไหน เมื่อเดือนหน้ามีคนพบตัวเลขหนึ่งในผล คนนั้นควรเปิดหน้าที่มาและดูสิ่งที่เครื่องมืออ่านได้
แหล่งข้อมูล
- MiniCPM-OCR SDK 1.0.5 บน PyPI วันที่ 9 พฤศจิกายน 2026
- โครงการ การ์ดโมเดล วันที่เปิดใช้ และคู่มือติดตั้ง MiniCPM-OCR ของ OpenBMB
- เดโมสาธารณะของ OpenBMB
- ภาพเปิดตัวและสัญญาอนุญาตของ OpenBMB
หากต้องการเก็บการตัดสินใจเรื่องการตรวจเอกสารไว้ในที่ค้นหาได้ สร้างบัญชี Telli.sh.