Mercury 3 สัญญาคำตอบเร็วขึ้น แล้วงาน AI ของคุณจะเสร็จเร็วขึ้นหรือไม่
โมเดลภาษาดิฟฟิวชันใหม่ของ Inception มุ่งงานโต้ตอบ มาดูว่าความเร็วช่วยตรงไหน เทียบงานครบอย่างไร และทำไมราคาเปิดตัวต้องมีคอลัมน์แยก
ลูกค้าถามว่าแก้คำสั่งซื้อก่อนส่งได้หรือไม่ ผู้ช่วยหาออเดอร์ อ่านนโยบาย ตรวจคลัง และเตรียมตอบ แต่ละขั้นดูเล็ก รวมกันแล้วการรอทำให้เรื่องง่ายรู้สึกเหมือนต่อสายช้าไปหาคนยุ่งมาก
Inception เปิด Mercury 3 วันที่ 19 ตุลาคม มุ่งโมเดลภาษาดิฟฟิวชันใหม่สู่งานที่ช่วงหยุดสะสม บริษัทระบุ 1,068 โทเคนผลลัพธ์ต่อวินาทีบน GPU NVIDIA กับ บริบท 1 ล้านโทเคน เป็นข้อมูลจำเพาะผู้ขาย ไม่รับรองการโต้ตอบลูกค้าทั้งหมด ประกาศ Inception
คำถามน่าสนใจคือโมเดลเร็วให้เปลี่ยนอะไร ติวเตอร์ใบ้ขณะผู้เรียนยังทำ ผู้ช่วยบริการตรวจข้อยกเว้นก่อนตอบ เอเจนต์เว็บทำขั้นมีประโยชน์เพิ่มในเวลารอเท่าเดิม บทความแนะนำโอกาส ต้นทุน และวิธีประเมินว่า Mercury 3 ปรับปรุงงานจริงหรือไม่
ฮาร์ดแวร์ NVIDIA H100 ประกอบบริบทอนุมาน GPU ภาพ 极客湾Geekerwan แหล่ง Wikimedia Commons CC BY 3.0 ปรับขนาดเป็น JPEG เก็บลายน้ำผู้สร้าง ไม่ใช่โครงสร้าง Inception หรือ benchmark ของเรา และไม่ระบุฮาร์ดแวร์ในผล Mercury 3 ที่รายงาน

ดิฟฟิวชันให้เส้นทางข้อความเร็วอีกแบบ
Inception เป็นบริษัทวิจัยและผลิตภัณฑ์ AI ขายโมเดลภาษาผ่านบริการ ตระกูล Mercury ใช้ดิฟฟิวชัน ปรับข้อความหลายตำแหน่งแทนพึ่งลำดับซ้ายไปขวาทั้งหมด บทความ Mercury ส่ง 17 มิถุนายน 2025 อธิบายวิธีและผลรุ่นก่อน ให้พื้นฐานแนวทาง ไม่ใช่ benchmark Mercury 3
ผลต่อผู้อ่านตรงไปตรงมา ลำดับคำนวณข้อความกระทบความเร็วได้คำตอบมีประโยชน์ แต่ไม่ทำทุกตอบทันทีหรือเรื่องยากไม่ต้องคิด เปลี่ยนเพียงส่วนหนึ่งของงาน แอปยังต้องหา ตัดสิน และแสดงสิ่งคนใช้ได้
มองความหน่วงเป็นงบรอ นักพัฒนาใช้กับอธิบายยาว ตรวจอีกแหล่ง หรือคืนสั้นเร็ว โมเดลเร็วเพิ่มที่ในงบ ที่นั้นช่วยผู้ใช้หรือไม่ขึ้นกับการใช้
สำคัญที่สุดเมื่อเรียกซ้ำ ผู้ช่วยตอบสั้นครั้งเดียวมีโอกาสคืนเวลาน้อย เอเจนต์สลับอ่าน เลือกทำ และดูผลจ่ายค่ารอหลายครั้ง ประหยัดขั้นซ้ำเปลี่ยนประสบการณ์แม้แต่ละคำตอบไม่หวือหวา
โทเคนต่อวินาทีวัดเพียงช่วงหนึ่ง
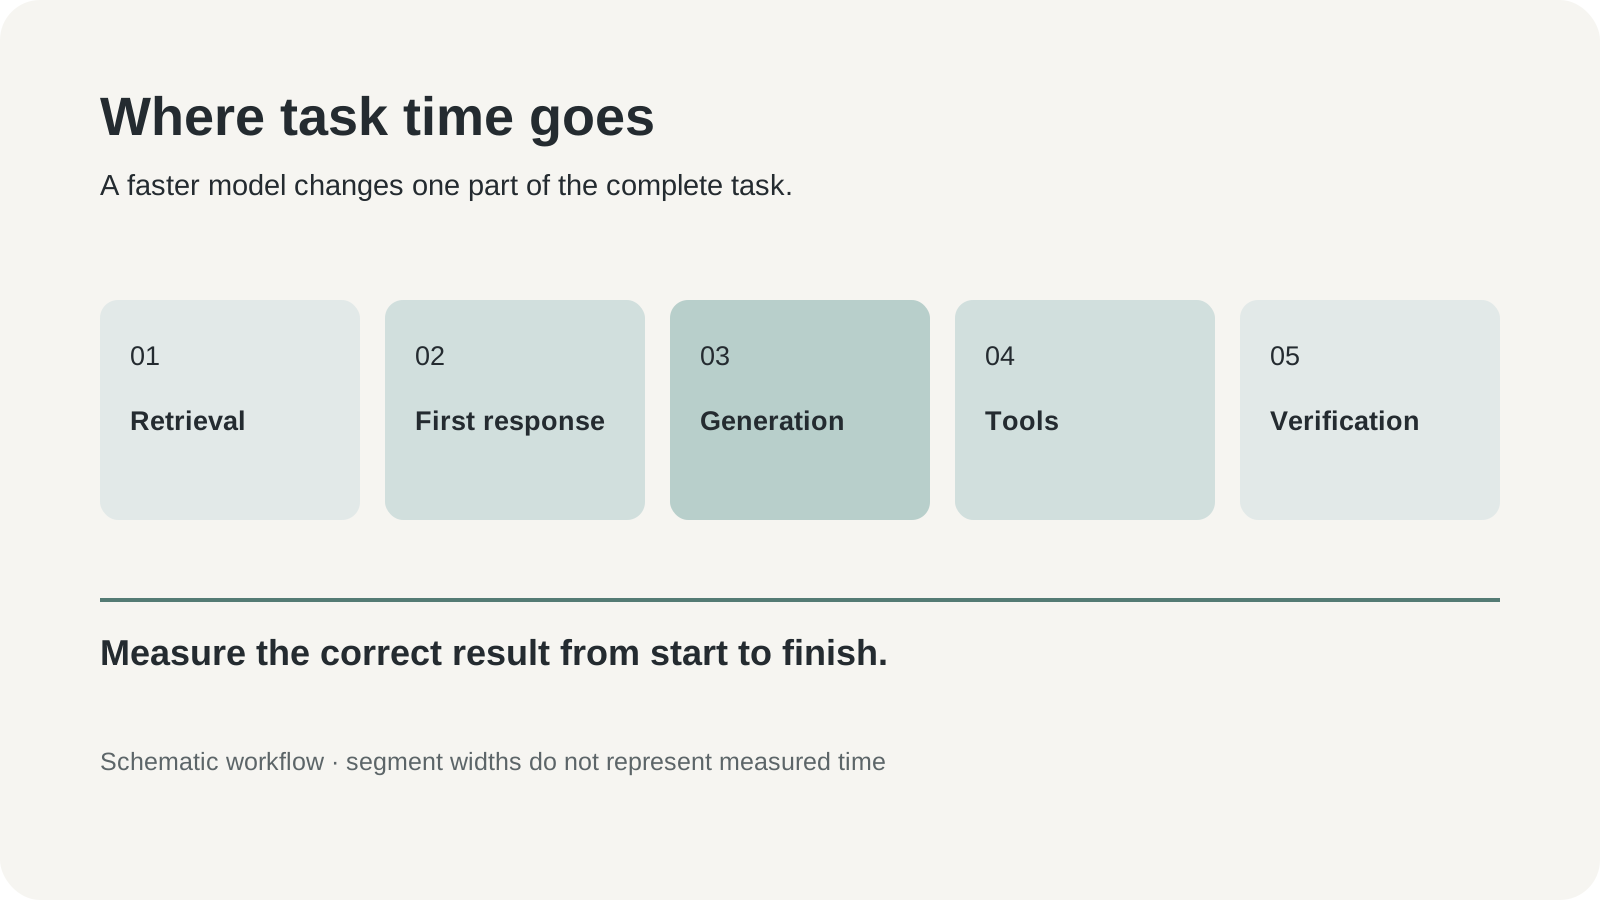
อินโฟกราฟิกบรรณาธิการที่จัดทำเอง แสดงขั้นที่มีส่วนต่อเวลาจบ ขนาดช่วงเป็นแผนผัง ไม่มีเวลาที่วัด
ฟีเจอร์ AI มีหลายเวลา เวลาถึงตอบแรกบอกว่ารอก่อนสิ่งมีประโยชน์นานเท่าไร อัตราผลลัพธ์บอกสร้างข้อความเร็วเท่าไร ความหน่วงเครื่องมือรวมค้น ฐานข้อมูล และบริการนอก เวลางานครบรวมขั้นได้ผลถูก ลองซ้ำและแก้
เวลาเหล่านี้ไปคนละทางได้ ระบบเริ่มสตรีมทันทีแต่จบงานยากช้า อีกระบบรอก่อนคืนสั้นไม่ต้องแก้ อีกตัวสร้างเร็วแต่รอออเดอร์เกือบทั้งเวลา ตัวเลขสำคัญขึ้นกับงาน
| การวัด | บอกผู้สร้างอะไร | ยังไม่ตอบอะไร |
|---|---|---|
| คำตอบมีประโยชน์แรก | รับรู้หรือเดินคำขอเร็วหรือไม่ | ผลสุดท้ายถูกหรือไม่ |
| โทเคนผลต่อวินาที | สร้างข้อความเร็วเท่าไร | เวลาค้น คิว และเครื่องมือ |
| เวลางานครบ | ผลถูกใช้เวลานานเท่าไร | ส่วนใดทำช้า |
| เวลารวมแก้ | ต้นทุนจริงถึงผลยอมรับ | งานอื่นจะคล้ายหรือไม่ |
มุมมองเราคือโมเดลเร็วคุ้มเมื่อเอาเวลาออกจากงานผู้ใช้ ขั้นสร้างสั้นมีค่าเมื่อจบเร็วหรือให้ตรวจจำเป็นได้ แต่มีค่าน้อยหากใช้เวลาที่ประหยัดสร้างข้อความเกินต้องการ
ถาม benchmark ให้ชัด งานเร็วขึ้นที่มาตรฐานเดิมหรือไม่ แล้วขั้นใดเปลี่ยน แยกการดีขึ้นของโมเดลจากพรอมป์ต์สั้น แคชอุ่น หรือบริการนอกเร็วได้
ผู้ช่วยบริการใช้เวลาที่ได้กับคำตอบดีกว่า
ลองงานร้านตัวอย่าง ลูกค้าอยากเปลี่ยนที่อยู่หลังสั่ง ผู้ช่วยต้องสถานะ นโยบาย และรายละเอียดแก้ ผลที่ดีคือขั้นถัดไปถูก เปลี่ยนที่อนุญาตผ่านเครื่องมือมีสิทธิ์ หรืออธิบายต้องให้คนช่วย
เร็วช่วยหลายจุด ถามชัดไวป้องกันทิ้งแชต อ่านนโยบายเร็วเหลือตรวจข้อยกเว้นออเดอร์กำลังแพ็ก ตอบท้ายสั้นยืนยันเปลี่ยนอะไรค้างอะไร ไม่ต้องเขียนยาวขึ้น
การประเมินควรรวมแรงเสียดทานจริง ลูกค้าแก้รหัสไปรษณีย์ ออเดอร์ส่งแล้ว นโยบายมีข้อยกเว้นแคบ วัดใช้ค่าปัจจุบันแทนค่าแรกหรือไม่ แยกสิทธิ์เปลี่ยนจากบรรยายการเปลี่ยน
หลีกเลี่ยงตอบเร็วมั่นใจแต่สร้างงาน หากลูกค้าติดต่อซ้ำแก้ ผลแรกมีประสิทธิภาพแค่ผิว บันทึกติดตามกับส่งต่อคนข้างความเร็ว นั่นเปลี่ยนตัวเลขน่าสนใจเป็นการตัดสินใช้งาน
ติวเตอร์ดีเมื่อฟีดแบ็กทันก่อนความสนใจย้าย
กรณีสองคือแอปเรียนตอบสั้น ผู้เรียนส่งประโยคภาษาใหม่หรือขั้นพีชคณิต แอปต้องหาความผิดและเสนอขั้นเหมาะ ตอบไวช่วยอยู่กับโจทย์เดิม
คำตอบไม่ต้องครบเสมอ ใบ้เล็กอาจดีกว่าเฉลย การประเมินแยกฟีดแบ็กถูกกับช่วยเกิน ระบุผิด รักษาโอกาสเรียน และใช้ภาษาตรงระดับหรือไม่ อธิบายเร็วผิดระดับยังขัดบทเรียน
สร้างตัวอย่างมีหลายคำตอบถูกและกำกวม ขอหนึ่งใบ้ก่อนเต็ม รวมผู้เรียนเปลี่ยนคำตอบ ตรวจตอบฉบับแก้หรือไม่ แสดงว่าตามการเรียนแทนสร้างเฉลยอย่างเดียว
ติวเตอร์เสียงมีโมเดลข้อความเป็นส่วนเดียว รู้จำเสียง จัดเทิร์น และสร้างเสียงมีเวลาและข้อผิดเอง ทดสอบบทพูดครบก่อนแปลงความเร็วข้อความเป็นคำกล่าวตอบสนอง เสียงยังอาจกำหนดความเป็นธรรมชาติแม้ข้อความสร้างที่ว่าง
เอเจนต์เว็บต้องมีนาฬิกากับกฎหยุด
กรณีสามคือเทียบเงื่อนไขผู้ขายจากเว็บ อ่าน เลือกลิงก์ ดึงเงื่อนไข ตรวจอีกแหล่ง เรียกเร็วลดรอซ้ำ และชวนให้ท่องต่อเพราะขั้นเพิ่มถูก
นิยามจบก่อนวัด เช่น มีราคาลงวัน ข้อจำกัด และแหล่งแต่ละราย หยุดเมื่อครบหรือรายงานขาดหลังค้นจำกัด คำขอเพิ่มมีประโยชน์เมื่อแก้ความไม่แน่ที่ระบุ
งานเว็บต้องขอบเขต อ่านสาธารณะต่างจากส่งฟอร์ม เปลี่ยนบัญชี ซื้อ เปลี่ยนโมเดลต้องรักษาสิทธิ์และจุดยืนยันเดิม เร็วทำผิดเร็ว ไม่ทำให้เหมาะขึ้น
เทียบสำเร็จและไม่สำเร็จแยก หากตัวหนึ่งหยุดเร็วอีกตัวสำรวจนาน เฉลี่ยเดียวซ่อนต่าง เก็บจำนวนขั้น เครื่องมือพลาด และหลักฐานขาดกับเวลา ผลควรอธิบายจบอย่างไรไม่ใช่รันนานเท่าไร
ตารางราคาต้องมีหลังโปรโมชัน
ตรวจ 23 ตุลาคม หน้าโมเดล ระบุ Mercury 3 0.20 ดอลลาร์ต่อล้านโทเคนเข้า และ 0.70 ดอลลาร์ต่อล้านออก โปรเปิดตัวลดเป็น 0.10 และ 0.35 ดอลลาร์ แคชเข้ามีราคาแยก หน้าไม่บอกจบโปร จึงควรเก็บกรณีราคาปกติในงบ
| โทเคน API ตรง | ราคาปกติต่อ 1 ล้าน | ราคาเปิดตัวต่อ 1 ล้าน |
|---|---|---|
| เข้า | 0.20 ดอลลาร์ | 0.10 ดอลลาร์ |
| เข้าแคช | 0.02 ดอลลาร์ | 0.01 ดอลลาร์ |
| ออก | 0.70 ดอลลาร์ | 0.35 ดอลลาร์ |
ตัวอย่างเข้าไม่แคช 100 ล้านกับออก 20 ล้าน ได้ 34 ดอลลาร์ราคาปกติ 17 ดอลลาร์เปิดตัว สมมติปริมาณตรงนี้และไม่รวมบริการอื่น เป็นวิธีเทียบสองราคา ไม่ใช่ประมาณงานสนับสนุนจริง
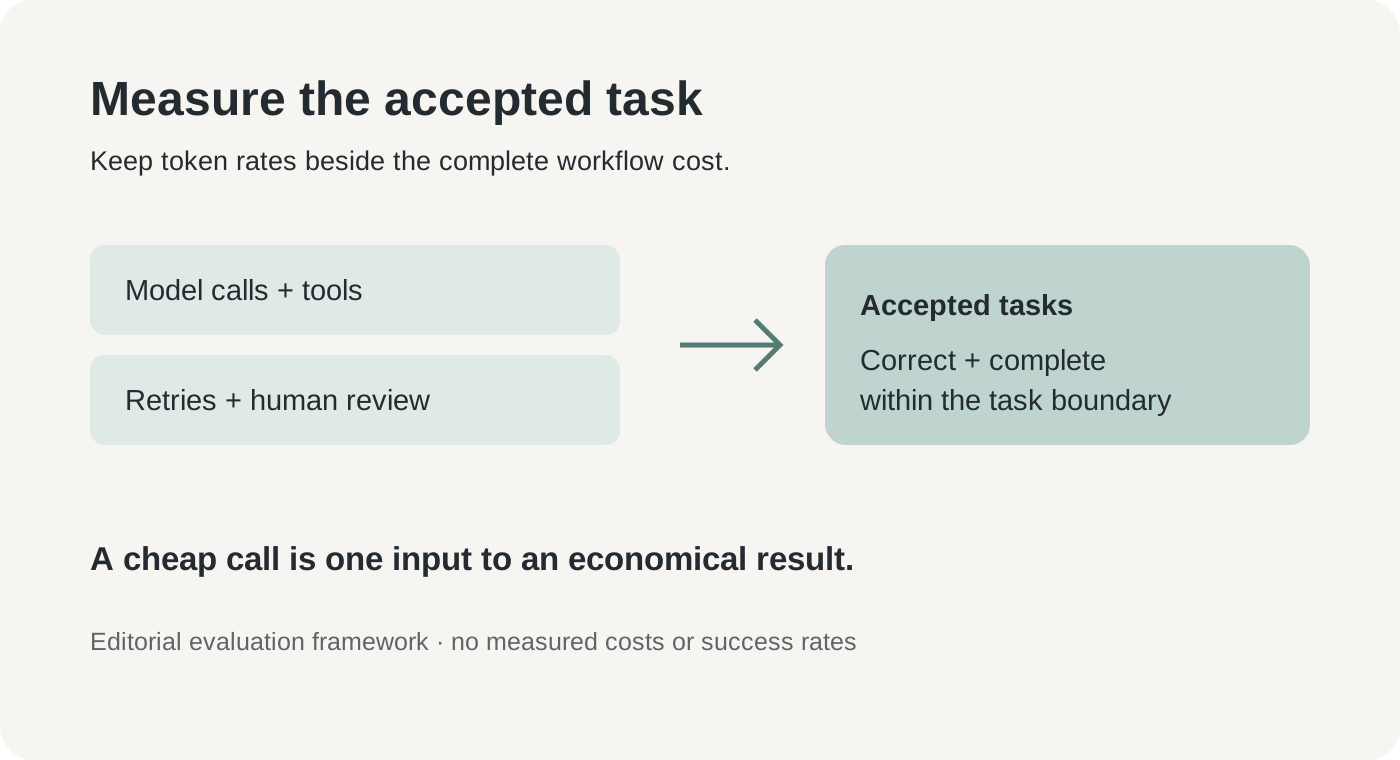
กรอบประเมินบรรณาธิการที่จัดทำเอง เทียบทรัพยากรรวมกับงานยอมรับ ไม่แสดงต้นทุนหรืออัตราสำเร็จที่วัดจริง
คำขอถูกยังอยู่ในขั้นตอนแพงได้ ค้นคืน เว็บ เสียง คนตรวจ และลองซ้ำเปลี่ยนรวม กลับกันคำขอแพงอาจคุ้มหากลดล้มเหลว ติดตามต้นทุนต่องานยอมรับควบคู่โทเคน
แคชต้องมีวินัย อย่าสมมติเอกสารซ้ำทุกอันได้ราคาแคช บันทึกผู้ให้บริการคิดจริงและเงื่อนไขเส้นทาง โมเดลหลายแพลตฟอร์มอาจต่างข้อปฏิบัติ ขีดจำกัด ราคา เก็บเส้นทางให้บริการในบันทึก
เริ่มเล่นซ้ำเล็ก แล้วเปลี่ยนหนึ่งส่วน
คู่มือเริ่มเร็ว ตรวจ 23 ตุลาคม ระบุ mercury-3 และ SDK กับ chat-completions ที่เข้ากัน ให้ทางผสานแอปเดิม ความเข้ากันช่วยคำขอแรก แต่พฤติกรรมพรอมป์ต์และความเชื่อถือยังต้องตรวจ
- เลือกงานย้อนคืนได้ เริ่มร่างตอบหรือฟีดแบ็กที่คนดูได้ เก็บตัวอย่างเล็กที่อนุญาตพร้อมกฎรับแต่ละกรณี
- บันทึกฐาน เก็บโมเดล พรอมป์ต์ ขนาดเข้า ขีดออก และผลเครื่องมือเดิม เก็บผลยอมรับกับเวลา
- สร้างบัญชีและคีย์ Inception เก็บในตัวแปรสภาพแวดล้อมหรือระบบความลับ ตรวจบิลและคุมใช้ก่อนรันชุด
- รันตามเอกสารด้วย
mercury-3คงงานและมาตรฐาน บันทึกการคิดและขีดผลเพื่อทำซ้ำ - ตรวจล้มเหลวก่อนเพิ่มทราฟฟิก ดูข้อมูลผิด เงื่อนไขขาด schema ผิด และเรียกเกิน ทำซ้ำกรณีตัวแทนดูความแปรปรวน
- ทดลองพร้อมย้อนกลับ เก็บผู้ให้บริการเดิม ตั้งเพดาน และดูเวลา/ต้นทุนงานยอมรับภายใต้ใช้ปกติ
จุดเริ่ม Python เล็กจาก SDK ทางการปรับกับโจทย์ไม่อ่อนไหวได้:
from inceptionai import Inception

client = Inception()  # reads INCEPTION_API_KEY
response = client.chat.completions.create(
    model="mercury-3",
    messages=[{"role": "user", "content": "Give one hint for solving 3x + 4 = 19."}],
    reasoning_effort="medium",
    temperature=0.75,
    max_completion_tokens=512,
)
print(response.choices[0].message.content)
ชิ้นงานต่อที่ดีคือตารางผลถูกและล้มเหลว คำขอตัวอย่างสำเร็จแสดงการเชื่อม ไม่แสดงว่าทุกค่า schema หรือพรอมป์ต์เดิมเหมือนกัน
คุณภาพและข้อมูลต้องอยู่ข้างความเร็ว
ผลเทียบเปิดตัวน่าสนับสนุนในหมวดเป้าหมาย แต่ความสามารถกว้างกับเหมาะงานต่างกัน หน้า Mercury 3 ของ Vals AI ตรวจ 23 ตุลาคม รายงานหลายงานด้วยค่าของตน อ่านภายใต้นิยาม benchmark แทนรวมกับความเร็วผู้ขายเป็นอันดับสากล
นิสัยดีกว่าคือตรวจความไม่สม่ำเสมอ โมเดลเก่งคำตอบโครงสร้างสั้นแต่อ่อนเฉพาะงานที่แอปเห็นว่าธรรมดาได้ ใส่กรณียากต้นการทดลอง ชุดเฉพาะสำเร็จบอกน้อยว่าคนต้องช่วยตรงไหน
ข้อมูลต่างตามบริการและสัญญา เงื่อนไข อธิบายเลือกไม่ร่วมฝึกในบัญชี ส่วนหน้าองค์กร มีปรับการเก็บและปรับใช้ ตรวจเส้นทางสัญญาก่อนส่งของลูกค้า ใช้ข้อมูลสังเคราะห์หรือได้รับอนุญาตในการเทียบแรก
ผู้ใช้เดิมมีวันที่ต้องจำ หน้าโมเดลบอกผู้ใช้ Mercury 2 หรือ 2.5 ก่อน 19 ตุลาคมยังเข้าถึงจน 15 พฤศจิกายน 2026 ส่วนองค์กรตามสัญญา การย้ายควรมีเล่นซ้ำตามกำหนดและแผนคืน พรอมป์ต์คุ้นไม่แทนตรวจรุ่นใหม่
สร้างเร็วควรซื้อขั้นถัดไปที่มีประโยชน์
Mercury 3 เสนอให้มองความเร็วอนุมานเป็นการออกแบบ โอกาสคือใช้เวลาคืนกับแก้ ตรวจแหล่ง หรือฟีดแบ็กทันช่วย ความกังวลคือเร็วก็สร้างงานไม่ตรวจมากขึ้น หลักฐานต่อที่มีความหมายคือความน่าเชื่อในงานครบที่คนขอ
ทดลองดีจบด้วยคำตอบเฉพาะ งานนี้เร็วขึ้นมาตรฐานเดิมหรือไม่ เป็นข้อกล่าวเล็กกว่าบอกเร็วที่สุดทุกสิ่ง แต่ทีมใช้ปล่อยประสบการณ์ดีขึ้นได้
แหล่งข้อมูล
- ประกาศ Mercury 3 ของ Inception วันที่ 19 ตุลาคม 2026 ความเร็วและบริบทเป็นสเปกผู้ขาย
- ข่าวเปิดตัวจากผู้ออก วันที่ 19 ตุลาคม 2026
- โมเดล ราคา และแจ้งย้าย Inception ตรวจ 23 ตุลาคม 2026
- เริ่มเร็ว API Inception ตรวจ 23 ตุลาคม 2026
- บทความวิจัย Mercury ส่ง 17 มิถุนายน 2025 พื้นฐานตระกูลก่อน
- benchmark Mercury 3 ของ Vals AI ตรวจ 23 ตุลาคม 2026
- เงื่อนไข Inception และการควบคุมองค์กร ตรวจ 23 ตุลาคม 2026
เก็บการเทียบไว้ตรวจภายหลัง
หากต้องการพื้นที่แยกสำหรับแหล่งที่อนุญาตและบันทึกเหตุเลือกโมเดล Telli.sh เป็นทางเลือกหนึ่ง เริ่มบันทึก