Mercury 3 menjanjikan jawaban lebih cepat. Akankah tugas AI Anda selesai lebih awal?
Model bahasa difusi baru Inception menyasar pekerjaan interaktif. Berikut bagian yang mendapat manfaat kecepatannya, cara membandingkan tugas lengkap, dan alasan harga peluncuran perlu kolom tersendiri.
Pelanggan bertanya apakah pesanannya bisa diubah sebelum dikirim. Asisten menemukan pesanan, membaca kebijakan, memeriksa status gudang, dan menyiapkan jawaban. Setiap langkah tampak kecil. Namun, waktu tunggu yang terkumpul dapat membuat percakapan sederhana terasa seperti koneksi lambat ke orang yang sangat sibuk.
Inception meluncurkan Mercury 3 pada 19 Oktober, mengarahkan model bahasa difusi terbarunya ke aplikasi tempat jeda tersebut menumpuk. Perusahaan melaporkan 1.068 token keluaran per detik pada GPU NVIDIA, bersama jendela konteks 1 juta token. Ini spesifikasi vendor, bukan jaminan bagi interaksi pelanggan lengkap. Pengumuman Inception.
Pertanyaan menariknya ialah perubahan yang dimungkinkan model lebih cepat. Tutor dapat memberi petunjuk saat pelajar masih mengerjakan soal. Agen dukungan dapat memeriksa pengecualian sebelum menjawab. Asisten browser dapat menyelesaikan langkah berguna tambahan dalam waktu tunggu sama. Panduan ini membahas kemungkinan tersebut, biaya di baliknya, serta cara praktis mengevaluasi apakah Mercury 3 memperbaiki tugas yang benar-benar Anda miliki.
Perangkat keras NVIDIA H100 sebagai konteks inferensi GPU. Foto: 极客湾Geekerwan, sumber Wikimedia Commons, CC BY 3.0; diubah ukurannya dan dikonversi ke JPEG, watermark pembuat dipertahankan. Ini bukan infrastruktur Inception atau tolok ukur kami, dan tidak mengidentifikasi perangkat untuk hasil Mercury 3 yang dilaporkan.

Difusi memberi Inception jalur berbeda menuju teks lebih cepat
Inception merupakan perusahaan riset dan produk AI yang menjual model bahasa melalui layanan hosted. Keluarga Mercury menggunakan difusi, pendekatan yang menyempurnakan teks pada beberapa posisi, bukan sepenuhnya bergantung pada urutan kiri ke kanan. Makalah Mercury, diajukan 17 Juni 2025, menjelaskan metode dan evaluasi keluarga terdahulu. Makalah itu memberi latar pendekatan, bukan laporan tolok ukur Mercury 3.
Dampaknya bagi pembaca sederhana: urutan komputasi teks dapat memengaruhi kecepatan aplikasi memperoleh jawaban berguna. Ini tidak membuat setiap respons instan atau menghilangkan kebutuhan penalaran untuk pertanyaan sulit. Yang berubah ialah satu bagian pekerjaan menghasilkan jawaban. Bagian aplikasi lain tetap harus memperoleh informasi, menentukan penggunaannya, dan menyajikan sesuatu yang dapat dipakai orang.
Bayangkan latensi sebagai anggaran menunggu. Pengembang dapat membelanjakannya untuk penjelasan lebih panjang, pemeriksaan satu sumber tambahan, atau pengembalian jawaban pendek lebih cepat. Model lebih cepat menciptakan ruang dalam anggaran itu. Manfaat ruang tersebut bagi pengguna bergantung pada cara aplikasi memakainya.
Ini paling penting ketika model dipanggil berulang. Asisten yang membutuhkan satu balasan pendek menawarkan sedikit kesempatan menghemat waktu. Agen yang bergantian membaca, memilih tindakan, dan memeriksa hasil dapat membayar jeda model berkali-kali. Menghemat waktu pada tahap berulang dapat mengubah pengalaman meskipun tidak ada satu respons yang terasa dramatis.
Token per detik hanya mengukur satu bagian perjalanan
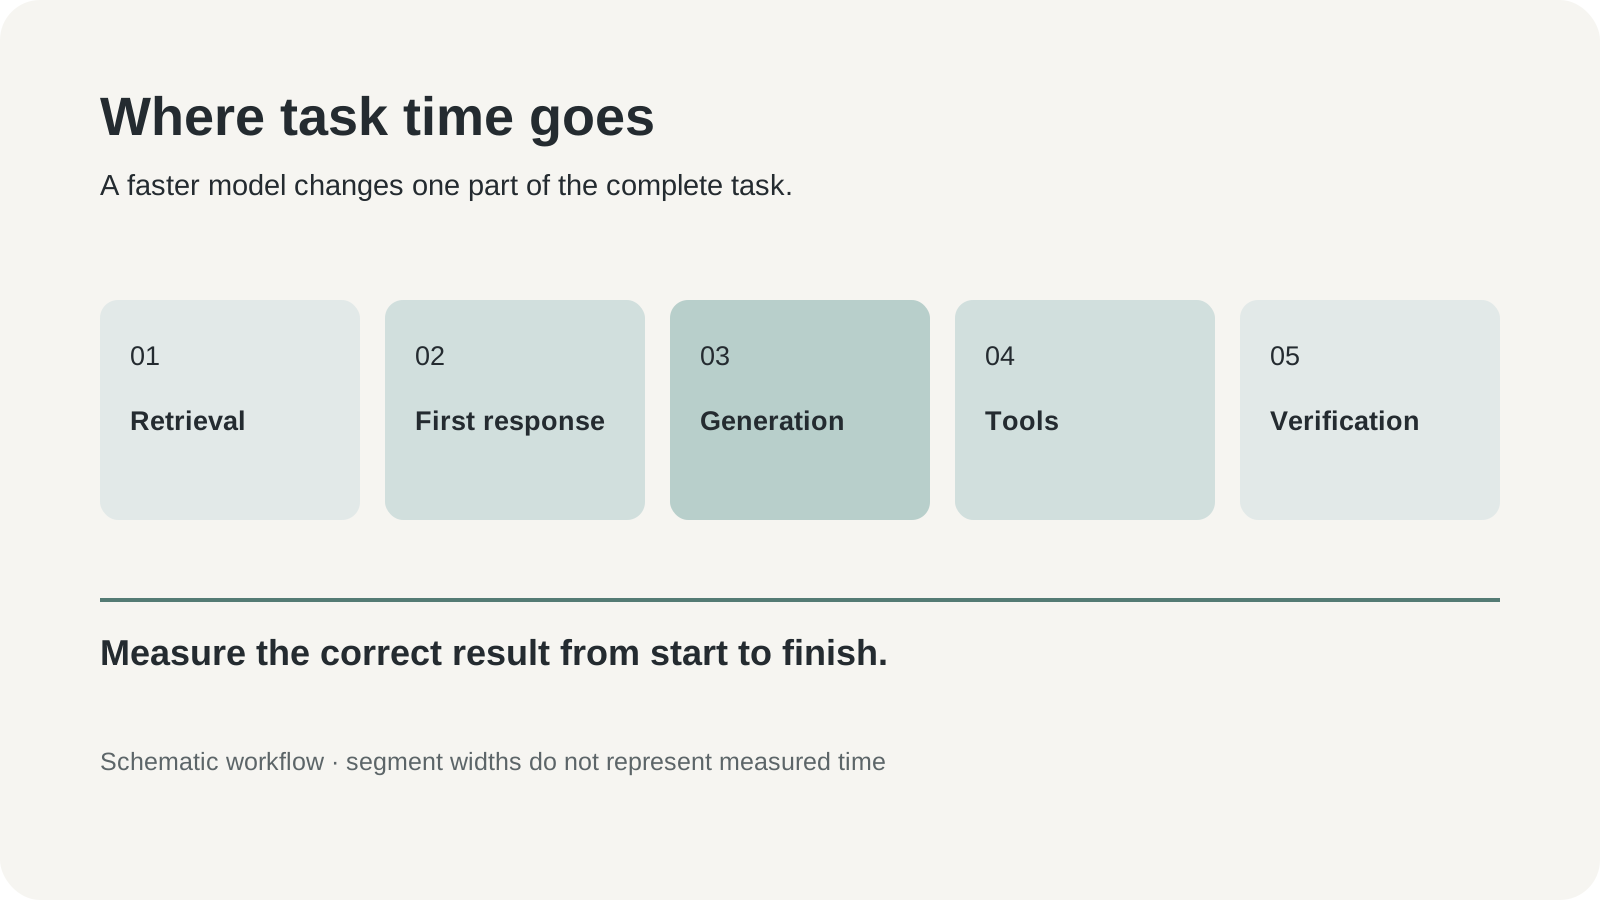
Infografik editorial orisinal: tahap yang dapat menyumbang waktu penyelesaian tugas. Ukuran segmen merupakan skema, tanpa durasi terukur.
Ada beberapa jam pengukur dalam fitur AI. Waktu menuju respons pertama menjelaskan lamanya antarmuka tampak menunggu sebelum sesuatu yang berguna terjadi. Throughput keluaran menjelaskan kecepatan teks yang dihasilkan tiba. Latensi alat mencakup pencarian, basis data, atau layanan eksternal yang dihubungi aplikasi. Waktu penyelesaian tugas mencakup langkah menuju hasil benar, termasuk percobaan ulang dan koreksi.
Jam-jam ini dapat menunjuk arah berbeda. Sistem bisa langsung mengalirkan kata pertama tetapi lama menyelesaikan permintaan rumit. Sistem lain dapat menunggu sebelum mengembalikan jawaban ringkas yang tidak perlu koreksi. Sistem ketiga dapat menghasilkan teks cepat tetapi menghabiskan sebagian besar interaksi menunggu sistem pesanan. Angka yang penting bagi pengguna bergantung pada pekerjaannya.
| Pengukuran | Informasi bagi pembuat | Hal yang belum dijawab |
|---|---|---|
| Respons berguna pertama | Apakah antarmuka segera mengakui atau memajukan permintaan | Apakah hasil akhir benar |
| Token keluaran per detik | Kecepatan produksi teks selama generasi | Waktu pencarian, antrean layanan, dan jeda alat |
| Waktu tugas lengkap | Lamanya mencapai hasil benar | Komponen penyebab perlambatan |
| Waktu termasuk koreksi | Biaya praktis mencapai hasil yang dapat diterima | Apakah tugas berbeda berperilaku serupa |
Menurut kami, model cepat layak digunakan jika mengurangi waktu pekerjaan pengguna. Fase generasi lebih pendek bernilai ketika mempersingkat pekerjaan atau memungkinkan pemeriksaan yang diperlukan. Nilainya lebih kecil ketika aplikasi menghabiskan penghematan untuk menghasilkan lebih banyak teks daripada yang dibutuhkan siapa pun.
Pertahankan pertanyaan tolok ukur yang konkret. Tanyakan apakah tugas lebih cepat pada standar penerimaan sama. Kemudian tanyakan tahap yang berubah. Ini mempermudah pembedaan peningkatan model dari prompt lebih pendek, cache siap pakai, atau layanan eksternal lebih cepat.
Asisten dukungan dapat memakai penghematan untuk jawaban lebih baik
Pertimbangkan alur dukungan ritel ilustratif. Pelanggan ingin mengubah alamat pengiriman setelah memesan. Asisten membutuhkan status pesanan, kebijakan perubahan alamat, dan detail pelanggan yang diperbarui. Keluaran bergunanya ialah langkah berikut yang akurat: melakukan perubahan yang diizinkan melalui alat berwenang, atau menjelaskan mengapa manusia perlu turun tangan.
Kecepatan membantu di beberapa titik. Klarifikasi cepat dapat mencegah pelanggan meninggalkan percakapan. Pembacaan kebijakan cepat dapat menyisakan waktu memeriksa pengecualian pesanan yang sudah dikemas. Jawaban akhir ringkas dapat mengonfirmasi perubahan dan hal yang masih menunggu. Tidak satu pun peningkatan itu membutuhkan pesan lebih panjang.
Evaluasi perlu menyertakan hambatan biasa. Berikan pelanggan yang mengoreksi kode pos, pesanan yang sudah dikirim, dan dokumen kebijakan dengan pengecualian sempit. Ukur penggunaan nilai terkini, bukan nilai pertama yang dilihat. Pisahkan izin melakukan perubahan dari kemampuan menjelaskannya.
Kegagalan yang perlu dihindari ialah jawaban cepat dan yakin yang menciptakan pekerjaan tambahan. Jika pelanggan harus menghubungi dukungan lagi untuk mengoreksi hasil, respons awal hanya tampak efisien. Catat tindak lanjut serta serah terima manusia bersama kecepatan awal. Begitulah statistik model menarik menjadi keputusan operasional berguna.
Tutor mendapat manfaat ketika umpan balik tiba sebelum perhatian berpindah
Kasus ilustratif kedua ialah aplikasi belajar yang menanggapi jawaban pendek. Pelajar mengirim kalimat dalam bahasa baru atau langkah antara pada latihan aljabar. Aplikasi harus mengenali kesalahan relevan dan menawarkan langkah berikut yang sesuai. Respons cepat dapat mempertahankan keterlibatan pelajar pada pertanyaan sama.
Jawaban tidak selalu harus lengkap. Petunjuk kecil mungkin lebih baik daripada penyelesaian terurai penuh. Evaluasi perlu membedakan umpan balik benar dari bantuan berlebihan: apakah aplikasi mengenali kesalahan, mempertahankan kesempatan belajar, dan memakai bahasa sesuai tingkat pelajar? Penjelasan cepat pada tingkat salah tetap mengganggu pelajaran.
Susun sampel dengan beberapa jawaban yang diterima dan jawaban yang sengaja ambigu. Minta satu petunjuk sebelum penjelasan penuh. Sertakan pelajar yang mengubah jawaban, lalu periksa apakah aplikasi menanggapi revisi itu. Kasus ini menunjukkan apakah model mengikuti interaksi pendidikan, bukan sekadar menghasilkan kunci jawaban.
Untuk tutor suara, model teks merupakan satu komponen. Pengenalan suara, pengelolaan giliran, dan generasi suara menambah waktu serta kesalahan sendiri. Uji interaksi suara lengkap sebelum menerjemahkan throughput teks menjadi klaim respons percakapan. Tahap teks cepat dapat memberi ruang berguna sementara tahap audio tetap menentukan keluwesan percakapan.
Agen browser membutuhkan jam pengukur dan aturan berhenti
Kasus ketiga ialah asisten yang membandingkan ketentuan pemasok terkini melalui halaman publik. Agen membaca halaman, menentukan tautan penting, mengekstrak syarat, dan memeriksa sumber lain. Panggilan model lebih cepat dapat mengurangi penantian berulang. Namun, agen juga bisa tergoda terus menjelajah karena langkah tambahan murah.
Definisikan selesai sebelum mengukur kecepatan. Misalnya, tugas berakhir saat asisten memiliki harga bertanggal, batasan layanan, serta tautan sumber untuk setiap kandidat. Agen perlu berhenti ketika persyaratan terpenuhi, atau melaporkan item hilang setelah pencarian terbatas. Kegunaan panggilan berikut bergantung pada penyelesaian ketidakpastian yang disebutkan.
Tugas browser juga membutuhkan batas tindakan. Membaca informasi publik berbeda dari mengirim formulir, mengubah akun, atau membeli produk. Pergantian model perlu mempertahankan izin dan titik konfirmasi aplikasi yang sudah ada. Eksekusi lebih cepat membuat tindakan keliru terjadi lebih awal; tidak membuat tindakan itu lebih tepat.
Bandingkan tugas berhasil dan gagal secara terpisah. Jika satu model berhenti lebih awal dan yang lain menjelajah lebih lama, satu rata-rata dapat menyembunyikan perbedaannya. Simpan jumlah langkah, kegagalan alat, serta bukti hilang di samping waktu penyelesaian. Hasil perlu menjelaskan bagaimana tugas berakhir, bukan hanya durasi prosesnya.
Tabel harga membutuhkan kolom setelah promosi
Saat diperiksa 23 Oktober, halaman model Inception mencantumkan Mercury 3 seharga US$0,20 per juta token masukan dan US$0,70 per juta token keluaran, dengan diskon peluncuran menjadi US$0,10 dan US$0,35. Masukan dalam cache memiliki tarif terpisah. Halaman itu tidak menyebut tanggal berakhirnya promosi, sehingga anggaran perlu mempertahankan skenario harga normal.
| Kategori token API langsung | Tarif normal per 1 juta token | Tarif peluncuran per 1 juta token |
|---|---|---|
| Masukan | US$0,20 | US$0,10 |
| Masukan dalam cache | US$0,02 | US$0,01 |
| Keluaran | US$0,70 | US$0,35 |
Untuk beban kerja ilustratif berupa 100 juta token masukan tanpa cache dan 20 juta token keluaran, perhitungannya US$34 dengan tarif normal dan US$17 dengan tarif peluncuran. Contoh mengasumsikan volume token tepat tersebut dan tidak mencakup layanan lain. Ini cara membandingkan kedua skema harga, bukan perkiraan belanja operasi dukungan nyata.
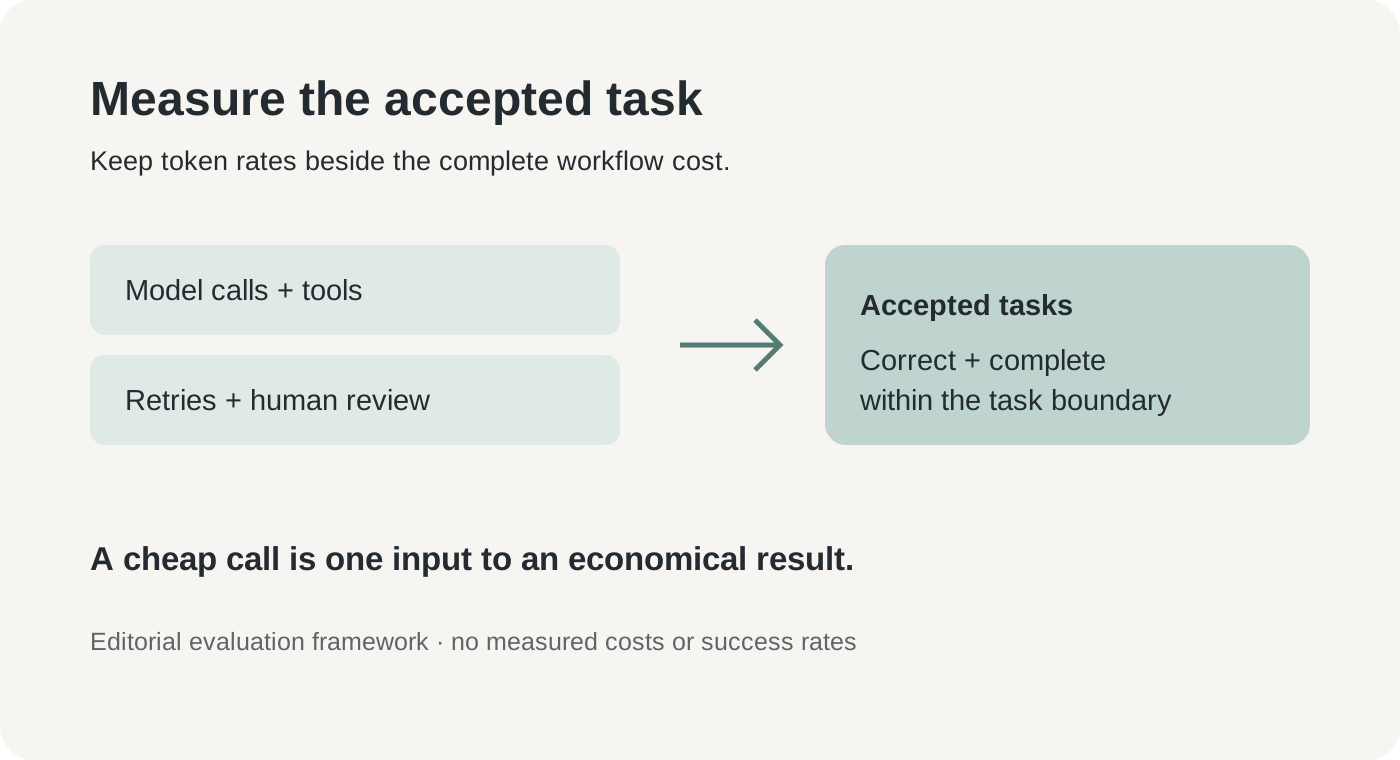
Kerangka evaluasi editorial orisinal. Bandingkan sumber daya total dengan jumlah tugas yang diterima; tidak menampilkan biaya produk atau tingkat keberhasilan terukur.
Panggilan murah tetap bisa menjadi bagian alur mahal. Retrieval, layanan browser, pemrosesan suara, peninjauan manusia, serta percobaan berulang dapat mengubah total. Sebaliknya, panggilan individual lebih mahal bisa ekonomis jika menghindari beberapa kegagalan. Lacak biaya per tugas yang diterima sekaligus harga token.
Caching membutuhkan disiplin sama. Jangan berasumsi setiap dokumen berulang memenuhi tarif cache. Catat tagihan aktual penyedia pilihan dan gunakan syarat terdokumentasi untuk jalur itu. Model yang ditawarkan melalui beberapa platform juga dapat memiliki ketentuan operasional, batas, atau harga berbeda. Pertahankan jalur serving dalam catatan perbandingan.
Mulai dari pemutaran ulang kecil, kemudian ubah satu komponen
Panduan cepat Inception, diperiksa 23 Oktober, mengidentifikasi model sebagai mercury-3 dan mendokumentasikan SDK serta endpoint chat-completions kompatibel. Ini memberikan jalur integrasi praktis bagi aplikasi yang sudah ada. Kompatibilitas mempermudah permintaan pertama; perilaku prompt serta keandalan alur tetap membutuhkan pemeriksaan sendiri.
- Pilih satu tugas yang dapat dibatalkan. Mulai dengan draf balasan atau saran umpan balik yang dapat diperiksa manusia. Kumpulkan sampel kecil yang diizinkan dengan aturan penerimaan eksplisit setiap kasus.
- Simpan pembanding awal. Catat model sekarang, prompt, ukuran masukan, batas keluaran, dan hasil alat. Pertahankan keluaran diterima serta durasi setiap kasus.
- Buat akun Inception dan kunci API. Simpan kunci dalam variabel lingkungan atau pengelola rahasia yang sudah ada. Periksa kontrol penagihan serta penggunaan saat ini sebelum menjalankan batch.
- Jalankan permintaan terdokumentasi dengan
mercury-3. Pertahankan tugas dan kriteria penerimaan. Catat pengaturan, termasuk tingkat penalaran serta batas keluaran, agar perbandingan bisa diulang. - Periksa kegagalan sebelum memperluas trafik. Periksa fakta salah, syarat hilang, kesalahan skema, dan panggilan tidak perlu. Ulangi kasus representatif untuk memahami variasi.
- Lakukan uji coba dengan jalur rollback. Pertahankan penyedia sebelumnya, tetapkan batas penggunaan, dan pantau waktu serta biaya tugas diterima pada trafik normal.
Sebagai titik awal Python minimal, contoh SDK resmi dapat disesuaikan untuk prompt pengujian tidak sensitif:
from inceptionai import Inception

client = Inception()  # reads INCEPTION_API_KEY
response = client.chat.completions.create(
    model="mercury-3",
    messages=[{"role": "user", "content": "Give one hint for solving 3x + 4 = 19."}],
    reasoning_effort="medium",
    temperature=0.75,
    max_completion_tokens=512,
)
print(response.choices[0].message.content)
Artefak berikut yang berguna ialah lembar perbandingan berisi hasil benar dan kasus gagal. Permintaan sampel berhasil membuktikan konektivitas. Itu tidak membuktikan setiap pengaturan, skema alat, atau prompt aplikasi lama berperilaku identik.
Kualitas dan kontrol data perlu berada di samping kecepatan
Perbandingan peluncuran Inception menjanjikan untuk kategori sasarannya, tetapi kemampuan model umum dan kecocokan beban kerja merupakan pertanyaan berbeda. Halaman Mercury 3 dari evaluator independen Vals AI, diperiksa 23 Oktober, melaporkan beberapa tugas dengan pengaturannya sendiri. Skor perlu ditafsirkan menurut definisi tolok ukur tersebut, bukan digabung dengan throughput vendor menjadi satu peringkat universal.
Kebiasaan lebih berguna ialah memeriksa ketidakmerataan kemampuan model. Model bisa sangat baik pada respons terstruktur pendek dan lebih lemah pada tugas khusus yang dianggap rutin oleh aplikasi. Masukkan kasus sulit aplikasi ke uji coba sejak awal. Kumpulan yang hanya berisi keberhasilan tidak banyak menjelaskan bagian yang akan membutuhkan bantuan manusia.
Penanganan data juga berbeda menurut layanan dan perjanjian. Ketentuan Inception menjelaskan pilihan keluar dari pelatihan model dalam pengaturan akun, sementara halaman enterprise menawarkan kontrol retensi serta penerapan yang dapat dikonfigurasi. Tinjau jalur dan kontrak yang berlaku sebelum mengirim materi pelanggan. Gunakan contoh sintetis atau yang diizinkan dengan benar untuk perbandingan pertama.
Bagi pengguna lama ada tanggal praktis: halaman model menyebut pelanggan dengan penggunaan Mercury 2 atau 2.5 sebelum 19 Oktober mempertahankan akses hingga 15 November 2026, dengan dukungan enterprise mengikuti perjanjian. Migrasi layak memiliki pemutaran ulang terjadwal dan rencana rollback. Familiaritas prompt lama bukan pengganti pemeriksaannya terhadap model baru.
Generasi lebih cepat perlu membeli langkah berikut yang lebih berguna
Mercury 3 mengajukan alasan memperlakukan kecepatan inferensi sebagai pilihan desain. Peluangnya ialah memakai waktu yang diperoleh untuk koreksi, pemeriksaan sumber, atau umpan balik yang masih tepat waktu. Kekhawatirannya ialah sistem lebih cepat juga dapat menghasilkan lebih banyak pekerjaan yang belum ditinjau. Bukti bermakna berikutnya ialah kinerja andal pada tugas lengkap yang diminta orang.
Uji coba yang baik berakhir dengan jawaban spesifik: alur ini menjadi lebih cepat pada standar sama, atau tidak. Klaim ini lebih kecil daripada menyatakan satu model tercepat dalam segala hal. Namun, inilah klaim yang dapat digunakan tim untuk merilis pengalaman lebih baik.
Sumber
- Pengumuman Mercury 3 Inception, 19 Oktober 2026; kecepatan dan konteks merupakan spesifikasi vendor.
- Rilis peluncuran penerbit, 19 Oktober 2026.
- Model, harga, dan pemberitahuan migrasi Inception, diperiksa 23 Oktober 2026.
- Panduan cepat API Inception, diperiksa 23 Oktober 2026.
- Makalah riset Mercury, diajukan 17 Juni 2025; latar keluarga model terdahulu.
- Halaman tolok ukur Mercury 3 Vals AI, diperiksa 23 Oktober 2026.
- Ketentuan Inception dan kontrol enterprise, diperiksa 23 Oktober 2026.
Pertahankan perbandingan agar dapat ditinjau
Jika Anda menginginkan tempat terpisah untuk materi sumber berizin dan catatan di balik keputusan model, Telli.sh merupakan salah satu pilihan. Mulai dengan catatan.