Anthropic mula menanda teks Claude dengan tera air — dan 1,922 kes mahkamah menunjukkan apa yang tidak dapat diperbaikinya
Penjelasan tentang cara tera air teks Claude mengenal pasti kemungkinan penglibatan model tanpa mengesahkan ketepatan fakta. Teliti batas pengesanan, tuduhan palsu serta perbezaan antara asal usul dan kebenaran melalui 1,922 kes halusinasi yang direkodkan.
Pada 14 Ogos 2026, Anthropic menerangkan cara tera air teks akan berfungsi dalam model Claude akan datang. FAQ-nya mengaitkan pelancaran ini dengan keperluan ketelusan Akta AI Kesatuan Eropah, yang mula terpakai pada 2 Ogos. Model yang dikeluarkan sebelum tarikh itu akan dikemas kini sepanjang tempoh peralihan; pengumuman ini tidak bermakna setiap respons Claude sudah mempunyai tera air.
Idea bergunanya ialah isyarat dalam pilihan perkataan model. Dalam keadaan yang sesuai, isyarat itu boleh membantu mengenal pasti penglibatan model tanpa mengubah rupa teks kepada pembaca.
Perbezaan ini penting apabila teks yang dijana mengandungi bukti rekaan. Petikan pangkalan data awam yang dibincangkan di bawah merekodkan 1,922 kes mahkamah yang melibatkan kandungan halusinasi AI. Kes-kes ini bukan ujian pengesanan tera air dan tidak membuktikan sama ada pengesan tertentu akan mengenal pasti teks berkenaan. Kes tersebut menunjukkan masalah yang berbeza: isyarat asal usul tidak dapat memastikan sama ada kes, kajian atau fakta yang dipetik benar-benar wujud. Memahami jurang itu menjadikan keputusan tera air lebih berguna dan lebih sukar disalahgunakan.
Ringkasnya:
- Tiada apa-apa ditambah kepada teks. Kunci rahsia mengubah kerawakan di sebalik pemilihan perkataan, bukan format yang kelihatan. Anthropic merancang pelancaran global, dengan model lama ditambah secara beransur-ansur.
- Keputusan positif ialah bukti lemah dan keputusan negatif hampir bukan bukti. Anthropic sendiri menyatakan tanda itu tidak dapat membezakan "Claude menulis ini" daripada "Claude menyunting ini dengan banyak", lemah pada teks pendek, kod dan perenggan fakta semata, serta terpadam oleh penulisan semula. Pada 2024 penyelidik menunjukkan bahawa kurang daripada 50 dolar sudah memadai untuk kedua-duanya: membuang tanda ini dan memalsukannya pada teks tulisan manusia.
- Asal usul bukan pengesahan. Keputusan pengesanan boleh menunjukkan kemungkinan penglibatan model, tetapi tidak mengesahkan kes, petikan atau buku yang disebut dalam teks.
Gambar: Jon Rawlinson, Wikimedia Commons, CC BY 2.0. Satu halaman penuh tanda ketulenan. Setiap satu membuktikan sempadan telah dilintasi. Tiada satu pun berkata apa-apa tentang sama ada pengembara itu bercakap benar.
Apa yang Anthropic benar-benar ubah, dan apa yang tidak
Mulakan dengan mekanismenya, kerana hampir semua salah faham selepas ini berpunca daripada tersilap di sini.
Apabila model bahasa menulis, ia menghasilkan satu perkataan pada satu masa, dan pada kebanyakan kedudukan tiada satu pilihan yang betul. "Mesyuarat itu produktif" dan "Mesyuarat itu berguna" kedua-duanya wajar. Model menyimpan senarai perkataan seterusnya yang boleh diterima lalu memilih satu melalui cabutan rawak. Itulah sebabnya arahan yang sama memberi anda dua jawapan yang sedikit berbeza.
Tera air teks menggantikan cabutan rawak itu dengan cabutan pseudo-rawak yang dipacu kunci rahsia. Model masih hanya memilih antara perkataan yang sudah dinilainya sama baik, jadi kualiti tidak tersentuh. Tetapi sepanjang beberapa ratus perkataan, corak tentang perkataan mana yang menang setiap kali berhenti kelihatan seperti kebetulan, dan sesiapa yang memegang kuncinya boleh mengukurnya.
Tiada aksara tersembunyi atau metadata teks yang boleh ditanggalkan. Isyaratnya datang daripada pilihan perkataan, dan Anthropic menyatakan ia tidak menambah token serta kesannya terhadap kelajuan boleh diabaikan. Dasar pelancarannya bersifat global, bukan mengikut wilayah, tetapi liputan model masih bergantung pada pelancaran berperingkat; dasar itu sahaja tidak membuktikan bahawa respons tertentu mempunyai tera air.
Tiada apa-apa yang baharu dari segi saintifik di sini. Scott Aaronson mencadangkan pendekatan ini pada 2022, Kirchenbauer dan rakan menerbitkan skema yang berfungsi di ICML pada 2023, dan Google DeepMind menerbitkan SynthID-Text dalam Nature pada Oktober 2024 — pelaksanaan Anthropic ialah satu versi daripadanya. Google menjalankannya dalam Gemini sejak 2024, melaporkan kira-kira 20 juta respons sebenar tanpa perbezaan kualiti yang dapat dikesan, dan sejak itu mendakwa lebih 10 bilion kandungan telah ditera.
Kemas kini, 12 Oktober 2026: FAQ Anthropic yang dikemas kini pada 1 September menerangkan API pengesanan dalam pratonton peribadi untuk organisasi yang layak, dengan akses lebih luas dirancang. Ini menggantikan status API "akan datang" dalam gambaran asal bulan Ogos. Tera air menganggarkan penglibatan Claude; ia tidak memeriksa sama ada teks itu benar.
Tanda itu bertahan disalin-tampal. Ia tidak bertahan ditulis semula.
Isyarat itu hidup dalam perkataan mana yang dipilih, jadi apa sahaja yang mengekalkan pilihan perkataan akan mengekalkan tandanya, dan apa sahaja yang menggantikannya akan memusnahkannya. Anthropic menyatakan hadnya secara terus terang: "penulisan semula sepenuhnya yang menggantikan setiap perkataan akan" membuangnya. Dua kes memecahkan corak itu dengan cara yang kerap mengejutkan orang.
Teks pendek dan teks fakta hampir tidak membawa apa-apa. Tera air memerlukan pilihan untuk disembunyikan. Satu atau dua ayat tidak memberi cukup keputusan untuk membentuk corak, dan kandungan yang sarat fakta mungkin langsung tidak menawarkan pilihan sebenar — contoh Anthropic sangat jelas: selepas "Principia karya Newton", perkataan seterusnya pastilah "Mathematica", dan tiada kunci pun mempunyai suara. Logik yang sama melemahkan kod, di mana sintaks menentukan kebanyakan token, dan kerja pembacaan pruf, di mana model mengubah terlalu sedikit perkataan untuk meninggalkan isyarat.
Terjemahan membawa tera air penuh. Yang ini bertentangan dengan gerak hati. Minta Claude menterjemah sesuatu dokumen ke bahasa Jepun, dan teks Jepun itu ialah sesuatu yang dijana baharu oleh Claude, perkataan demi perkataan, dengan kebebasan memilih seperti biasa — jadi ia keluar dengan tanda penuh, walaupun ideanya datang daripada naskhah manusia yang tidak bertanda. Ini bertentangan dengan apa yang digambarkan penyelidik DeepMind dalam Nature, iaitu menterjemah teks bertanda ke bahasa lain sangat mengurangkan keyakinan pengesanan. Kedua-duanya benar kerana ia senario berbeza: menterjemah teks bertanda di tempat lain akan melunturkan tandanya, manakala membiarkan model sendiri menterjemah akan mengecap tanda baharu.
| Apa yang anda lakukan pada teks | Adakah tanda itu bertahan? |
|---|---|
| Salin dan tampal ke mana-mana | Ya — tiada apa-apa terbenam yang boleh ditanggalkan oleh tampalan |
| Suntingan ringan: salah taip, tajuk, potongan | Ya — kebanyakan pilihan perkataan kekal utuh |
| Minta model menterjemahnya | Ya — terjemahan dijana baharu, jadi ia bertanda penuh |
| Parafrasa berat dengan perkataan anda sendiri | Tidak — anda menggantikan pilihan yang membawa isyarat itu |
| Penulisan semula sepenuhnya, setiap perkataan diganti | Tidak — Anthropic menyatakan ini membuangnya |
| Petikan pendek satu atau dua ayat | Lemah hingga tiada — terlalu sedikit pilihan untuk membentuk corak |
| Kod, atau perenggan fakta semata | Lemah — sintaks dan fakta tidak meninggalkan kebebasan kepada model |
| Membiarkan model membaca pruf draf anda | Lemah hingga tiada — terlalu sedikit perkataan berubah |
Tingkah laku seperti yang dinyatakan Anthropic dalam FAQ 14 Ogos 2026 (dikemas kini 1 September) dan oleh penulis SynthID-Text dalam Nature, Oktober 2024.
Keputusan positif ialah bukti lemah. Keputusan negatif hampir bukan bukti.
Jika pengesan memberikan keputusan, apakah kesimpulan munasabah yang boleh dibuat?
Jika positif: bahawa sebahagian teks ini pernah melalui model penyedia tersebut. Itu sahaja. Anthropic menyatakan dengan jelas bahawa tanda itu tidak dapat membezakan "Claude menulis ini" daripada "Claude menyunting ini dengan banyak", ia tidak berkata apa-apa tentang kebenaran mana-mana dakwaan di dalamnya, dan ia tidak mengecam teks daripada AI lain, kerana ia hanya mengenali kuncinya sendiri.
Jika negatif, dia hampir tidak mengetahui apa-apa. Keputusan bersih ialah tepat apa yang anda peroleh juga daripada parafrasa berat, petikan pendek, blok kod, model pesaing, atau model pemberat terbuka yang berjalan pada komputer riba seseorang tanpa sebarang penandaan.
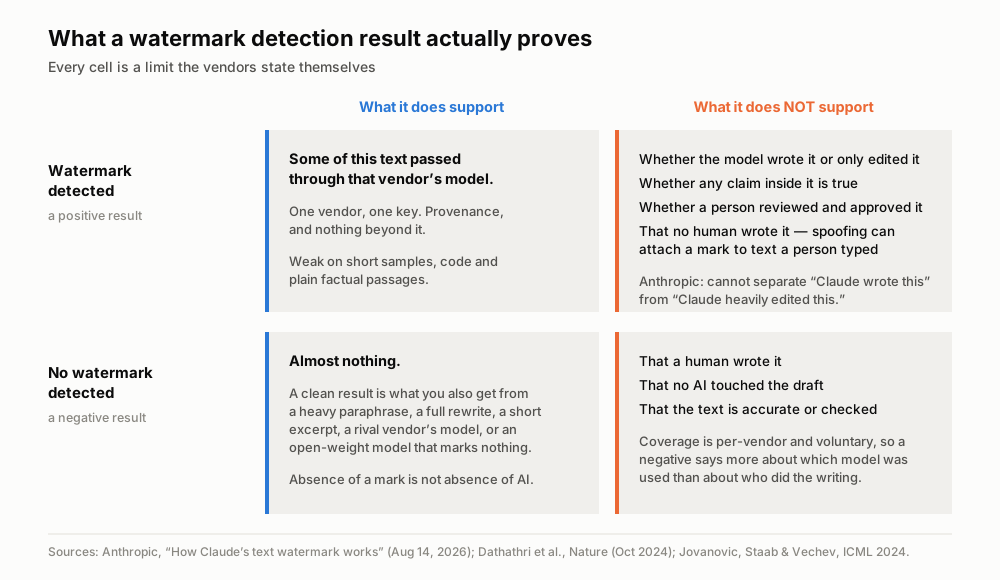
Setiap sel di sini ialah had yang diterbitkan sendiri oleh para penyedia. Sumber: FAQ tera air Anthropic (14 Ogos 2026, dikemas kini 1 September); Dathathri et al., Nature (Oktober 2024); Jovanović, Staab dan Vechev, ICML 2024.
Serangan yang tiada siapa peruntukkan belanjawan justeru berjalan songsang
Pembuangan tanda ialah risiko yang dibayangkan semua orang: seseorang mencuci teks AI untuk menyembunyikan asalnya. Baiklah. Tetapi ada serangan kedua dengan anak panah menunjuk ke arah bertentangan, dan itulah yang sepatutnya merisaukan anda.
Pemalsuan bermaksud membuat teks yang ditulis manusia membawa tera air milik orang lain. Tiada siapa menyembunyikan apa-apa; mereka sedang menanam sesuatu. Sasarannya ialah seseorang yang kemudiannya dituduh menggunakan AI, atau penyedia yang dipersalahkan atas keluaran yang tidak pernah dihasilkannya.
Di ICML 2024, Jovanović, Staab dan Vechev menunjukkan kedua-dua serangan terhadap skema tercanggih dengan kadar kejayaan melebihi 80% dan kos pengiraan kurang daripada 50 dolar. Penulis DeepMind mengakui perkara yang sama dalam kertas Nature mereka sendiri: tera air "tidak menawarkan penyelesaian yang lengkap", memerlukan kerjasama penyedia model sekadar untuk wujud, tidak boleh dikuatkuasakan pada model pemberat terbuka yang boleh dijalankan sesiapa sahaja seadanya, dan "terdedah kepada serangan kecurian, pemalsuan dan pembuangan". Klausa terakhir itulah keseluruhan hujahnya, ditulis oleh pasukan yang membina teknologi tersebut.
Pengesan AI awal menuduh pelajar yang salah
Alat pengesanan sudah lama wujud, dan ia teknologi berbeza dengan sejarah mudarat yang terdokumentasi. Tera air ditanam pada masa penjanaan oleh pemilik model, menggunakan kunci. Pengelas pula meneka selepas kejadian, daripada ciri teks itu sendiri: sejauh mana pilihan perkataannya boleh dijangka, sejauh mana kosa katanya pelbagai. Yang pertama tahu sesuatu. Yang kedua sekadar memadan corak gaya. Itulah beza antara mengukur dan memprofil.
OpenAI melancarkan AI Text Classifier pada 31 Januari 2023 dan mematikannya pada 20 Julai tahun yang sama "kerana kadar ketepatannya yang rendah". Angka mereka sendiri: menangkap 26% teks AI dan tersilap menandakan 9% teks manusia.
Kemudian Liang dan rakan menerbitkan dalam Patterns pada Julai 2023 penemuan yang sepatutnya menamatkan kategori ini. Dengan tujuh pengesan diuji pada esei TOEFL yang ditulis penutur bukan asli bahasa Inggeris, kadar positif palsu purata ialah 61.3%; satu pengesan menandakan 97.8% daripadanya. Apabila esei yang sama diminta ditulis semula dengan kosa kata yang lebih kaya, kadar itu jatuh kepada 11.6%. Pengesan-pengesan itu tidak pernah mengukur kepengarangan: ia mengukur kefasihan, dan menghukum sesiapa yang bahasa Inggerisnya lebih sederhana.
Universiti Vanderbilt menyahaktifkan pengesan AI Turnitin pada 16 Ogos 2023. Penjelasannya menggunakan pengiraan hipotesis: jika kadar positif palsu 1% yang didakwa dikenakan pada kira-kira 75,000 kertas yang dihantar, sekitar 750 kertas mungkin ditandai secara salah. Itu anggaran risiko, bukannya bilangan pelajar yang benar-benar dituduh. Pengumuman Vanderbilt.
Pengesanan tera air menguji corak penjanaan yang ditentukan, bukannya membuat kesimpulan tentang kepengarangan berdasarkan gaya penulisan. Hasilnya masih bersifat kebarangkalian, dan petikan pendek atau yang banyak disunting mungkin tidak memberikan kesimpulan yang jelas. Hasil tentang penglibatan model tidak sepatutnya menjadi tuduhan terhadap individu tertentu; penyelidikan pemalsuan juga menunjukkan mengapa pengesanan sahaja tidak dapat memastikan kepengarangan.
Peraturan tiba sebelum alatnya
Semua ini bertimbun dalam dua minggu kerana penggubal undang-undang bergerak dahulu.
Akta AI Kesatuan Eropah membelah kewajipan kepada dua. Perkara 50(2) mengikat penyedia: sesiapa yang membina sistem generatif mesti menanda keluarannya secara boleh baca mesin, teks termasuk. Perkara 50(4) mengikat anda: pengguna sistem yang menerbitkan teks janaan AI yang "memaklumkan orang awam tentang perkara yang menyentuh kepentingan awam" mesti mendedahkannya.
Dan yang kedua itu membawa pengecualian yang, bagi kebanyakan pembaca, merupakan intipati praktikal seluruh rejim ini. Kewajipan itu tidak terpakai apabila kandungan tersebut telah melalui semakan manusia atau kawalan editorial dan ada seseorang yang memikul tanggungjawab editorial ke atasnya. Baca dua kali. Jawapan Eropah kepada teks janaan AI bukan sebuah pengesan. Ia seorang manusia bernama yang telah menyemaknya dan bertanggungjawab atasnya.
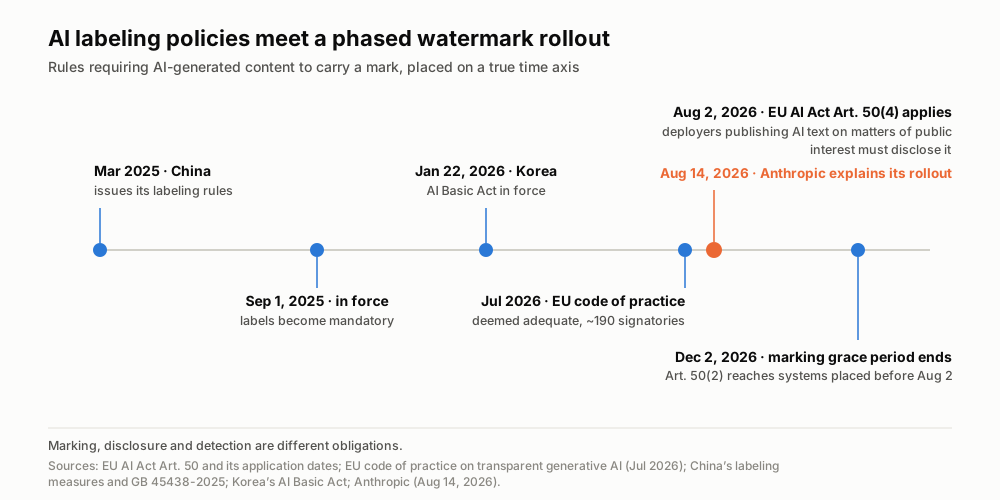
Kewajipan pelabelan tiba mengikut jadual; pengesanan yang boleh digunakan tidak. Sumber: Akta AI Kesatuan Eropah dan tarikh pemakaiannya, kod amalan ketelusan Kesatuan Eropah (Julai 2026), langkah pelabelan China dan piawaian GB 45438-2025, Akta Asas AI Korea, serta pengumuman Anthropic.
Suruhanjaya Eropah menerangkan bahawa kod ketelusannya ialah rangka kerja pematuhan sukarela, bukannya pengganti undang-undang; kira-kira 190 organisasi telah menandatanganinya menjelang akhir Julai 2026. FAQ-nya memberikan tempoh peralihan hingga 2 Disember 2026 bagi sistem yang diletakkan di pasaran sebelum 2 Ogos. Perbezaan ini penting: jadual pelaksanaan penandatangan dan kewajipan undang-undang bukan perkara yang boleh saling menggantikan. Gambaran keseluruhan Suruhanjaya, FAQ Suruhanjaya.
Bidang kuasa lain mempunyai peraturan yang berbeza. Langkah pelabelan China berkuat kuasa pada 1 September 2025, dengan label yang kelihatan dan terbenam di bawah piawaian GB 45438-2025. Akta Asas AI Korea berkuat kuasa pada 22 Januari 2026. Untuk menilai pematuhan, pembaca perlu melihat bidang kuasa dan jenis kandungan yang berkenaan, bukan menganggap terdapat satu peraturan pelabelan global.
Satu lagi ketiadaan wajar diletakkan di sini. Wall Street Journal melaporkan pada 2024 bahawa OpenAI telah membina kaedah tera air teks yang digambarkan secara dalaman sebagai tepat kira-kira 99.9%. Anggap itu laporan akhbar, bukan fakta: angka tersebut tidak pernah disahkan secara bebas dan OpenAI tidak pernah melancarkan penandaan teks. Catatan mereka sendiri bertarikh 11 Jun 2026 tentang pematuhan di Kesatuan Eropah hanya mendokumentasikan asal usul imej, dan mengakui had umum itu dengan kata-kata mereka sendiri: "metadata boleh dibuang, tera air boleh merosot".
Tera air tidak dapat mengesahkan petikan yang berhalusinasi
Damien Charlotin menyelenggara pangkalan data awam keputusan mahkamah di seluruh dunia yang memerlukan hakim menangani kandungan janaan AI yang mengandungi halusinasi. Diambil pada 16 Ogos 2026, ia berada pada 1,922 keputusan. Lintasannya: kira-kira 200 pada pertengahan 2025, 719 menjelang Januari 2026, 1,227 menjelang April, 1,598 pada 9 Jun, dan 1,922 hari ini — 324 ditambah dalam sepuluh minggu terakhir sahaja.
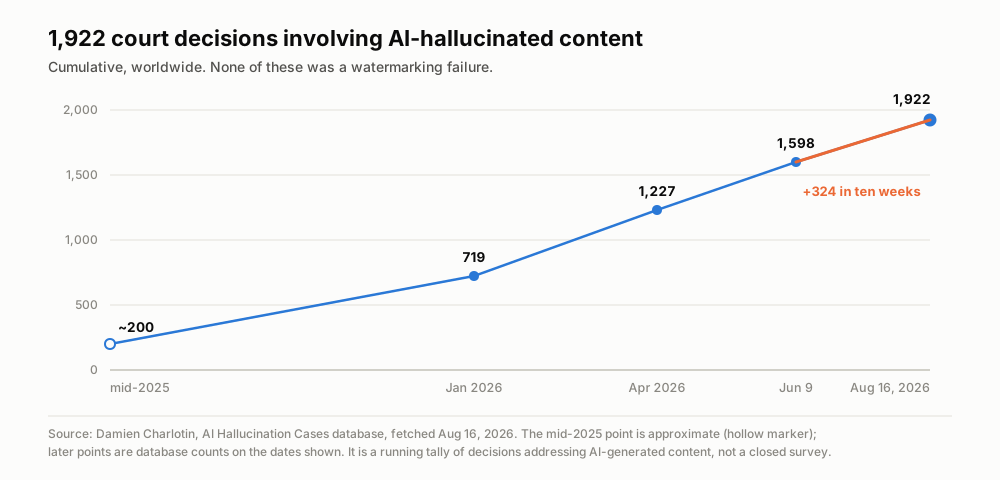
Kes-kes ini merekodkan halusinasi, bukannya keputusan ujian tera air. Tanda asal usul tidak dapat mengesahkan dakwaan faktanya. Sumber: pangkalan data kes halusinasi AI Damien Charlotin, diambil 16 Ogos 2026.
Arketipnya ialah Mata v. Avianca, diputuskan di Daerah Selatan New York pada 22 Jun 2023: satu hujah bertulis yang memetik enam keputusan kehakiman yang tidak wujud, dan denda 5,000 dolar.
Contoh yang paling bermakna melibatkan Anthropic sendiri. Pada Mei 2025, dalam Concord Music v. Anthropic, peguam syarikat itu memfailkan perakuan pakar yang memetik kajian yang dihalusinasikan Claude. Semakan manual tidak mengesannya; peguam memohon maaf kepada mahkamah. Syarikat yang kini menawarkan tera air teks juga pernah terjejas oleh petikan keluaran modelnya sendiri yang tidak disemak secara kritis, dalam litigasinya sendiri dan selepas disemak peguamnya sendiri. Keputusan tera air yang positif sekalipun tidak dapat membuktikan sama ada kajian yang dipetik benar-benar wujud.
Ia menjangkau melampaui mahkamah. Deloitte Australia bersetuju pada Oktober 2025 untuk membayar balik sebahagian laporan kerajaan bernilai 440,000 dolar Australia yang mengandungi rujukan yang tidak wujud dan petikan rekaan daripada satu penghakiman. Pada 18 Mei 2025, Chicago Sun-Times dan Philadelphia Inquirer menyiarkan senarai bacaan musim panas yang diedar melalui sindiket, yang daripada lima belas buku hanya lima yang benar-benar wujud. Liang dan rakan, menganalisis 950,965 makalah dalam arXiv:2404.01268, mendapati kandungan yang diubah suai LLM mencecah 17.5% dalam abstrak sains komputer berbanding 6.3% atau kurang dalam matematik dan portfolio Nature.
Persoalan jumlah juga wajar mendapat angka yang jujur dan bukan yang menggemparkan. Analisis Common Crawl oleh Graphite yang diterbitkan pada Oktober 2025 mendapati kira-kira 51.7% artikel baharu dalam sampel ditulis AI pada Mei 2025 — dan Axios, semasa melaporkannya, menambah kaveat yang penting: bahagian itu mendatar berhampiran separuh dan bukannya terus mendaki. Ini bukan banjir. Ini kelaziman baharu.
Inilah intinya. Tiada satu pun dalam senarai itu merupakan kegagalan tera air. Dalam setiap kes, asal usul tidak pernah dipertikaikan: semua orang tahu ada model terlibat, atau akan menerimanya serta-merta. Yang gagal ialah tiada siapa membuka rujukan itu dan memeriksa sama ada kes itu, kajian itu, atau buku itu benar-benar wujud.
Kesimpulannya: asal usul bukan pengesahan
Panggil sahaja ia kesilapan cop pos. Cop pos membuktikan pejabat mana yang mengendalikan surat itu. Ia tidak pernah mempunyai pendapat tentang sama ada isi surat itu benar. Kita baru sahaja mencurahkan banyak usaha kejuruteraan untuk membina cop pos yang sangat baik, dan sebahagian perbualan awam hampir tersilap menganggapnya sebagai penyemak fakta.
Pegang tiga perkara serentak. Pengesanan positif ialah bukti kemungkinan penglibatan model, bukannya kepengarangan atau kebenaran. Keputusan negatif tidak membuktikan bahawa teks itu ditulis manusia. Liputan bergantung pada penyedia, kuncinya dan model yang menggunakan tera air; liputannya tidak menyeluruh. API pratonton peribadi Anthropic yang dikemas kini juga menetapkan syarat kelayakan, bukannya akses awam tanpa sekatan.
Yang benar-benar tahan diteliti bukanlah tanda pada keluaran, tetapi rekod yang boleh anda terbitkan semula daripada sumbernya: rakaman yang masih wujud, transkrip bercap masa yang membolehkan anda melompat kembali ke detik yang dipersoalkan, satu baris yang dinisbahkan kepada orang yang benar-benar mengucapkannya, satu dakwaan yang boleh dijejak sehingga ke dokumen primer yang boleh anda buka. Kami pernah menghujahkannya tentang terjemahan langsung, di mana nota yang boleh disemak lebih penting daripada keluaran yang lancar, dan tentang transkripsi soal siasat polis, di mana rekod mesti bertahan apabila ada yang membantahnya. Era tera air tidak mengubah hujah itu, sebaliknya menajamkannya: apabila penandaan menjadi sejagat, ayat "ada AI terlibat" berhenti membezakan apa-apa.
Tera air menjawab dari mana sesuatu teks datang. Sesuatu yang menjawab sama ada ia benar belum dibina sesiapa pun, kerana benda itu bukan pengesan. Ia sebuah sumber yang boleh anda datangi semula.
Di mana Telli.sh berada: kami membina tepat sumber yang boleh anda datangi semula itu. Telli.sh merakam mesyuarat, menghasilkan transkrip bercap masa dengan penutur dikenal pasti, dan mengekalkan ringkasannya berlabuh pada audio asalnya — jadi mana-mana baris dalam nota anda boleh dijejak, berbulan kemudian, sehingga ke saat seseorang mengucapkannya. Ini bukan dakwaan tentang mengesan AI. Ini separuh lagi masalahnya: apabila sebuah ringkasan mendakwa sesuatu, anda boleh menyemaknya terhadap rakaman dan bukan sekadar mempercayai ayat itu.
Sumber
- Anthropic, "How Claude's text watermark works" (Ogos 2026)
- Dathathri et al., "Scalable watermarking for identifying large language model outputs," Nature (Oktober 2024)
- Kirchenbauer et al., "A Watermark for Large Language Models," ICML 2023
- Jovanović, Staab & Vechev, "Watermark Stealing in Large Language Models," ICML 2024
- Liang et al., "GPT detectors are biased against non-native English writers," Patterns (Julai 2023)
- Liang et al., "Mapping the Increasing Use of LLMs in Scientific Papers," arXiv:2404.01268
- Damien Charlotin, pangkalan data kes halusinasi AI
- Suruhanjaya Eropah, Perkara 50 Akta AI: kewajipan ketelusan
- Halaman gambar di Wikimedia Commons
