Llama Windows: เริ่มแชต AI ในเครื่องครั้งแรกโดยไม่ต้องตั้งค่าผ่านเทอร์มินัล
ติดตั้ง Llama Windows อย่างปลอดภัย เลือกโมเดล GGUF ที่เหมาะกับพีซี ลองใช้พรอมป์ต์จริงสามแบบ และเชื่อมต่อ API ในเครื่องโดยไม่เปิดเผยเซิร์ฟเวอร์
งาน AI ในเครื่องครั้งแรกควรเป็นเรื่องเล็ก ๆ เช่น เปลี่ยนบันทึกการประชุมสมมติหกข้อให้เป็นรายการสิ่งที่ต้องทำสามข้อ คุณไม่ควรต้องคอมไพล์เอนจิน inference เดาค่าแฟล็กเริ่มทำงานเป็นสิบตัว หรืออัปโหลดเอกสารส่วนตัว เพียงเพื่อดูว่าคอมพิวเตอร์ตอบคำถามได้หรือไม่
Llama Windows ซึ่ง Hugging Face ประกาศเมื่อวันที่ 13 ตุลาคม 2026 นำ runtime ของ llama.cpp มาไว้เบื้องหลังแอปในถาดระบบ Windows แอปช่วยค้นหาและดาวน์โหลดโมเดล จากนั้นให้ทั้งอินเทอร์เฟซแชตในเครื่องและ API สำหรับแอปอื่น ชื่อนี้หมายถึงตัวแอป ไม่ได้จำกัดให้ใช้เฉพาะโมเดล Llama ของ Meta ประกาศเปิดตัว
คู่มือนี้พาคุณติดตั้งอย่างปลอดภัย เลือกโมเดลแรกที่เหมาะสม และเริ่มบทสนทนาที่ตรวจสอบได้ จากนั้นจะลองทำงานที่มีประโยชน์สามอย่างและส่งคำขอไปยัง API ในเครื่องเป็นทางเลือก เริ่มด้วยข้อความสาธารณะหรือข้อมูลสมมติ แล้วค่อยนำข้อมูลละเอียดอ่อนมาใช้เมื่อเข้าใจเวิร์กโฟลว์ทั้งหมดแล้ว
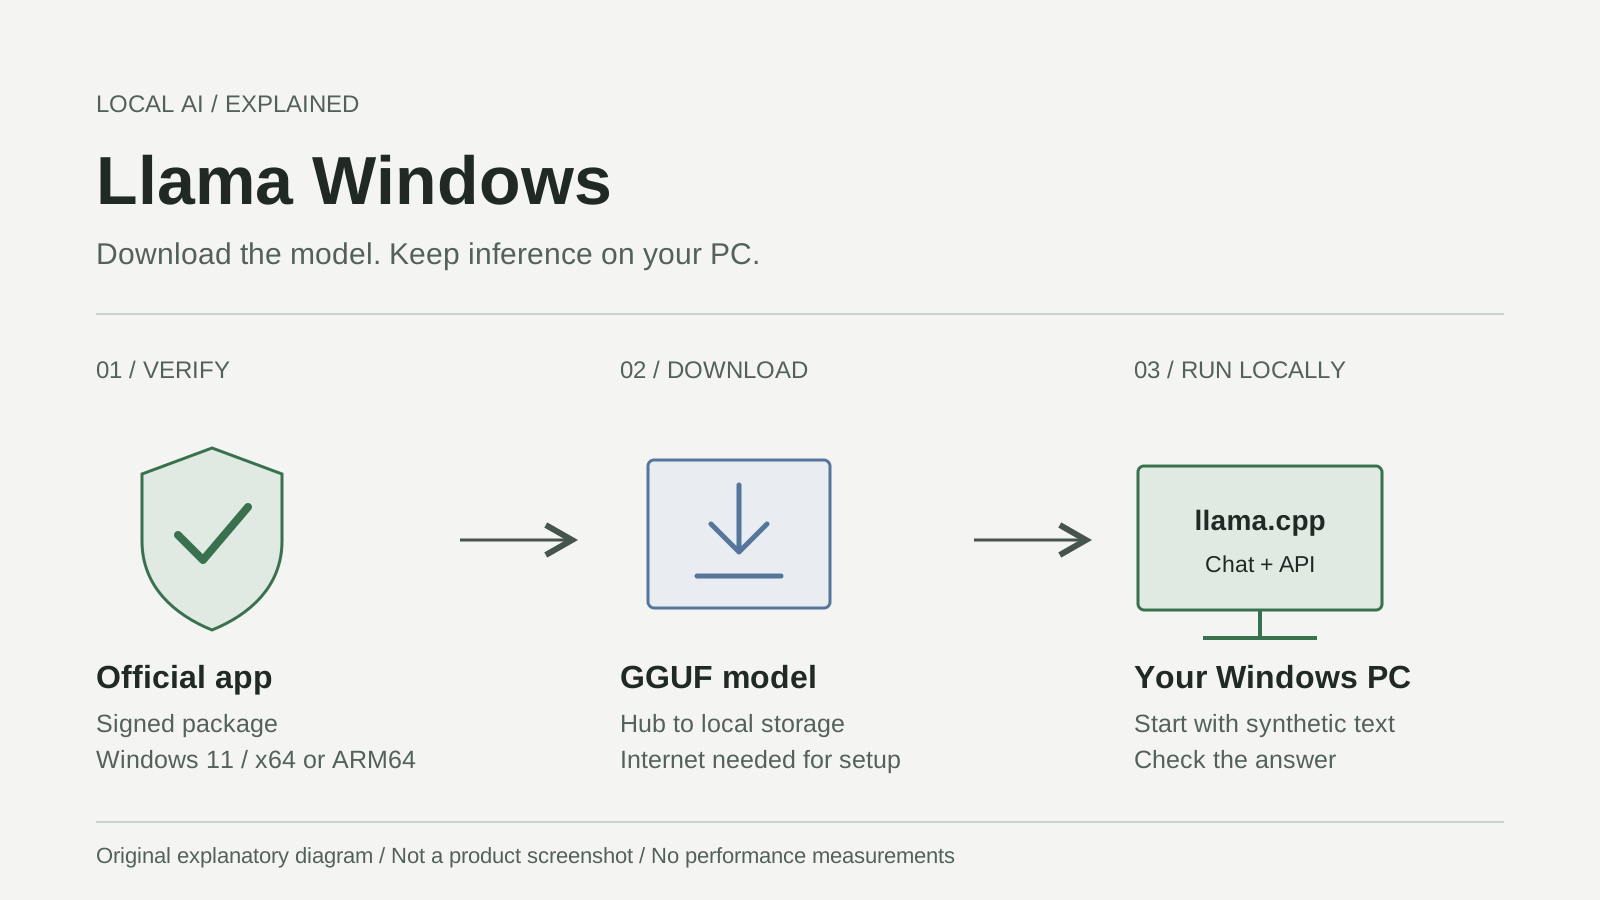
ภาพประกอบอธิบายที่จัดทำขึ้นใหม่ ไม่ใช่ภาพหน้าจอผลิตภัณฑ์ การดาวน์โหลดเพื่อตั้งค่ากับการประมวลผล inference ในเครื่องเป็นคนละขั้นตอน อ้างอิงจากคู่มือติดตั้ง Windows อย่างเป็นทางการ.
ตรวจสอบรุ่น Windows ก่อนเลือกโมเดล
จากการตรวจสอบเมื่อวันที่ 20 ตุลาคม รุ่น Windows ล่าสุดที่เผยแพร่คือ v0.12.0 manifest ของแพ็กเกจนี้กำหนดให้ใช้ Windows.Desktop 10.0.26100.0 ขึ้นไป บิลด์ 26100 ตรงกับ Windows 11 เวอร์ชัน 24H2 ให้ใช้รุ่น Windows ที่ยังได้รับการดูแล ไม่ใช่แค่รุ่นเก่าที่สุดซึ่งติดตั้งได้ รุ่นเผยแพร่, manifest รุ่นเผยแพร่, ข้อมูลรุ่น Windows จาก Microsoft
ค้นหา winver ใน Windows เพื่อดูบิลด์ ในการตั้งค่า Windows เปิด ระบบ > เกี่ยวกับ เพื่อตรวจชนิดระบบและ RAM ที่ติดตั้ง ไฟล์ .msixbundle อย่างเป็นทางการมีบิลด์ x64 และ ARM64: x64 เป็นตัวเลือกทั่วไปสำหรับพีซี Windows ที่ใช้ Intel/AMD ส่วน ARM64 ใช้กับ Windows บน Arm ตัว bundle จะเลือกสถาปัตยกรรมให้ ไม่มีแพ็กเกจรุ่น x86 แบบ 32 บิตในรายการไฟล์ของรุ่นปัจจุบัน รีโพซิทอรี Windows, การจัดแพ็กเกจ bundle
เอกสารติดตั้ง Windows ไม่ได้กำหนด RAM, VRAM หรือ GPU แยกขั้นต่ำแบบเดียวที่ใช้ได้กับทุกเครื่อง ความต้องการขึ้นอยู่กับโมเดลและ context llama.cpp รองรับ inference ด้วย CPU และ GPU backend หลายแบบ แต่ไม่ได้รับประกันว่าจะเร่งความเร็วได้เหมือนกันในทุกพีซี คุณไม่จำเป็นต้องมี RTX Spark โดยเฉพาะ ความสามารถของ llama.cpp
บน Mac ให้ใช้เส้นทางแยก ดาวน์โหลดสำหรับ Mac ที่ llama.app อย่าติดตั้ง bundle ของ Windows หรือนำคำแนะนำไดรเวอร์ Windows มาใช้ ตัวเลขขนาดแอป Mac บนเว็บไซต์ก็ไม่ใช่ข้อกำหนดของตัวติดตั้ง Windows เช่นกัน
ติดตั้งแอปที่ลงนามแล้วโดยไม่ลดความปลอดภัยของ Windows
การติดตั้งด้วยแพ็กเกจปกติไม่ต้องคอมไพล์อะไรหรือติดตั้ง .NET SDK ข้อกำหนดสำหรับการ build จากซอร์สเป็นเรื่องของนักพัฒนา ไม่เกี่ยวกับขั้นตอนเริ่มแชตครั้งแรกนี้ เอกสารติดตั้งอย่างเป็นทางการ
- เปิด llama.app แล้วเลือก ดาวน์โหลดสำหรับ Windows 11 หรือไปตามลิงก์ Releases ในรีโพซิทอรี ยืนยันว่ารุ่นนั้นมาจาก
ggml-org/Llama-Windowsไม่ใช่เว็บไซต์ดาวน์โหลดชื่อคล้ายกัน - เลือก
.msixbundleรุ่นปัจจุบัน ไม่ใช่ไฟล์ archive ของซอร์สโค้ดบน GitHub สำหรับรุ่นที่ตรวจสอบ ไฟล์ชื่อLlamaApp-v0.12.0.msixbundleเปิดหน้ารุ่นเผยแพร่ค้างไว้ระหว่างติดตั้ง - เปิด bundle ด้วย Windows App Installer ตรวจข้อมูลผู้เผยแพร่และลายเซ็นก่อนเลือก ติดตั้ง ตัวตนผู้ลงนามใน manifest v0.12.0 คือ Hugging Face ส่วนชื่อผู้เผยแพร่ที่แสดงคือ Morgan Funtowicz ชื่อที่คุ้นตาเพียงอย่างเดียวไม่ใช่การตรวจสอบลายเซ็น Windows ต้องเชื่อถือการลงนามของแพ็กเกจ ตัวตนแพ็กเกจ
- หาก Windows แจ้งว่าผู้เผยแพร่ไม่รู้จัก ลายเซ็นไม่ถูกต้อง หรือมีข้อจำกัดจากองค์กร ให้หยุด ตรวจไฟล์ทางการอีกครั้ง อัปเดต Windows/App Installer ผ่านช่องทาง Microsoft หรือขอความช่วยเหลือจากผู้ดูแลระบบ อย่าปิด Defender หรือ SmartScreen อย่าข้าม execution policy และอย่านำเข้าใบรับรองที่ไม่รู้จักเพื่อบังคับติดตั้ง วิธีแก้ปัญหา App Installer ของ Microsoft
- เปิด Llama แล้วหาไอคอนในพื้นที่แจ้งเตือนข้างนาฬิกา หากจำเป็นให้ตรวจลูกศรแสดงไอคอนที่ซ่อนอยู่ แอปอาจติดตั้ง runtime llama.cpp ที่จัดการไว้ให้หากยังไม่มี ดังนั้นการเปิดครั้งแรกอาจต้องใช้อินเทอร์เน็ต ขั้นตอนดาวน์โหลด Windows, การตั้งค่า runtime
ปล่อยการตั้งค่าการแชร์เครือข่ายไว้ตามเดิม ใน v0.12.0 Settings > Llama > Listen On ใช้ควบคุมที่อยู่เซิร์ฟเวอร์ โดยค่าเริ่มต้นคือ localhost แชตแรกไม่ต้องมีข้อยกเว้นการเชื่อมต่อขาเข้าหรือที่อยู่ซึ่งคอมพิวเตอร์เครื่องอื่นเข้าถึงได้ บันทึกความปลอดภัยของรุ่นเผยแพร่
โมเดลที่มีขนาดพอดีดิสก์อาจใช้หน่วยความจำไม่พอ
GGUF คือรูปแบบไฟล์โมเดลที่มี weights และ metadata สำหรับเอนจิน inference เช่น llama.cpp ไม่ใช่แบรนด์แชตบอตหรือคะแนนคุณภาพ จุดเริ่มต้นสำหรับการสนทนาควรเป็นโมเดลที่ปรับแต่งให้ทำตามคำสั่งหรือแชต ส่วน base model มีจุดประสงค์อีกแบบ อ่าน model card แทนการเลือกจากจำนวนดาวน์โหลดเพียงอย่างเดียว เอกสาร GGUF ของ Hugging Face, คำแนะนำ model card
จำนวนพารามิเตอร์บอกจำนวนค่าตัวเลขที่โมเดลเรียนรู้: 3B หมายถึงประมาณสามพันล้านพารามิเตอร์ ไม่ใช่ไฟล์ดาวน์โหลดขนาด 3GB การ quantization จัดเก็บค่าเหล่านั้นให้กะทัดรัดขึ้น ชื่ออย่าง Q4_K_M และ Q8_0 ระบุสูตร quantization ต่างกัน ไม่ใช่เวอร์ชันแอป ความแม่นยำระดับต่ำลงอาจลดพื้นที่จัดเก็บและหน่วยความจำ แต่มีข้อแลกเปลี่ยนด้านคุณภาพและความเร็วซึ่งขึ้นกับโมเดลและฮาร์ดแวร์ ไม่ได้แปลว่าจะเร็วหรือดีที่สุดโดยอัตโนมัติ คู่มือ quantization ของ llama.cpp
แยกปริมาณทั้งสี่อย่างนี้ออกจากกัน:
| ปริมาณ | สิ่งที่ต้องเผื่อ | การตัดสินใจสำหรับผู้เริ่มต้น |
|---|---|---|
| พื้นที่ดิสก์ | ไฟล์โมเดลที่ดาวน์โหลด runtime และพื้นที่ชั่วคราวระหว่างดาวน์โหลด | ตรวจไดรฟ์ปลายทางก่อนดาวน์โหลด |
| RAM ระบบ | Windows แอปอื่น ข้อมูลโมเดล และงานของ runtime | เผื่อพื้นที่ไว้สำหรับใช้งานพีซีทั่วไป |
| VRAM ของ GPU | งานที่จัดสรรให้ GPU แยก | อย่าสับสนกับ RAM ระบบ |
| Context | tokens ที่ใช้เก็บคำสั่ง บทสนทนา และผลลัพธ์ที่สร้าง | เริ่มจากขนาดสั้น แทนการเลือกค่าสูงสุด |
Context คือ โต๊ะทำงาน ของบทสนทนา โต๊ะที่ใหญ่ขึ้นวางข้อมูลได้มากขึ้น แต่ก็ใช้หน่วยความจำมากขึ้นด้วย token คือส่วนย่อยของข้อความ ไม่ใช่จำนวนคำตายตัว ภาษาและโค้ดแต่ละแบบถูกแบ่งเป็น token ต่างกัน weights ของโมเดลเป็นเพียงส่วนหนึ่งของการใช้หน่วยความจำ ยังมี key/value cache และ runtime buffers ที่ต้องคำนึงถึงด้วย พารามิเตอร์เซิร์ฟเวอร์ llama.cpp
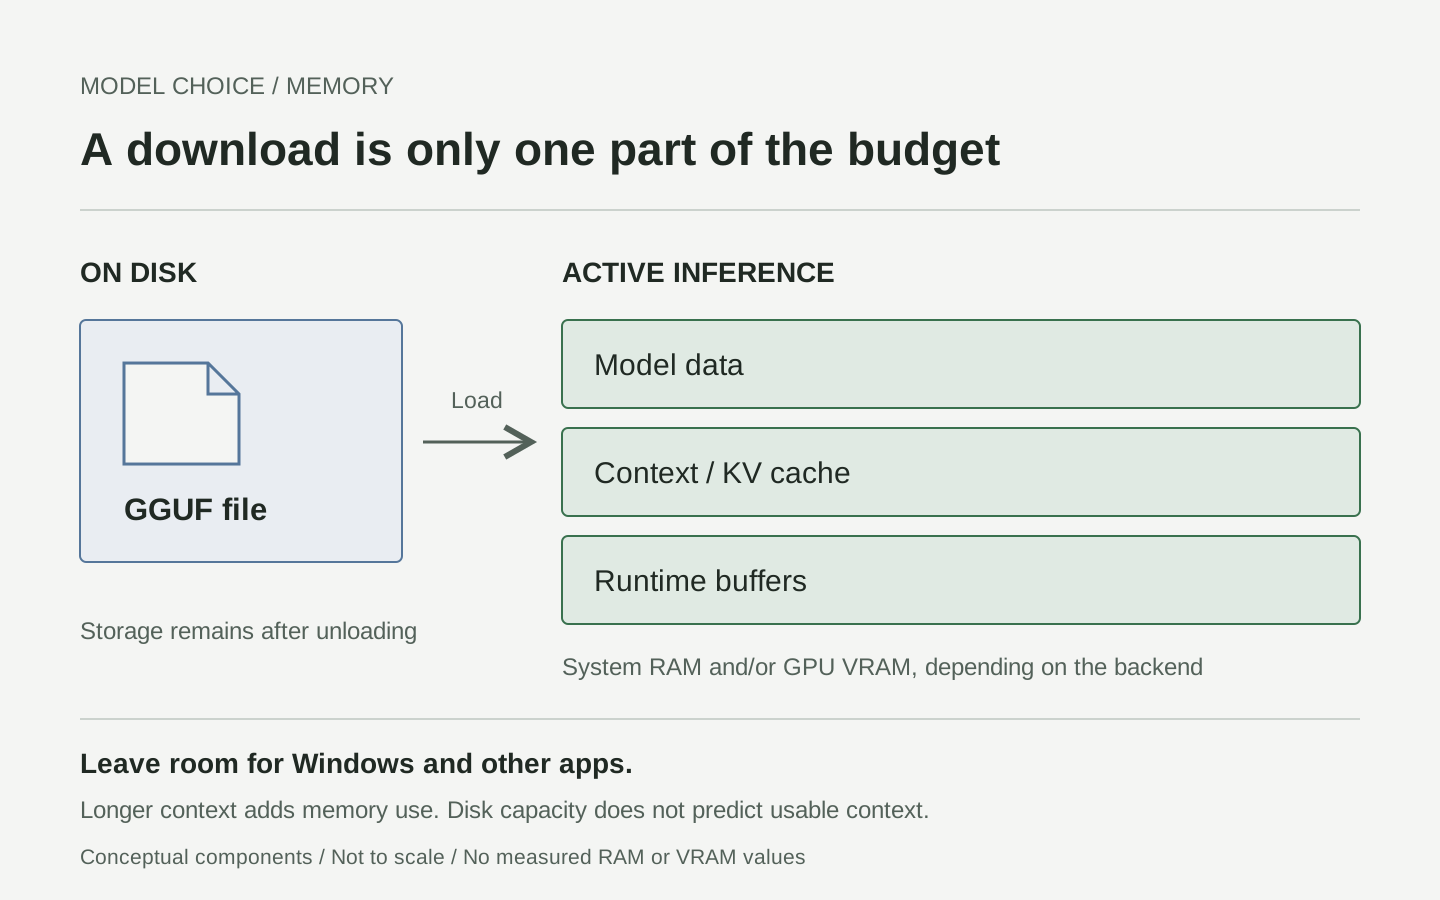
แผนภาพแนวคิดต้นฉบับ ไม่ใช่การวัดการใช้หน่วยความจำจริง แหล่งข้อมูลรายละเอียดโมเดล ประเมินหน่วยความจำของโมเดลรวม context ส่วนการใช้งานทั้งหมดของพีซีมีองค์ประกอบอื่นเพิ่มเติม
เปิดรายละเอียดโมเดลและดูค่าประมาณหน่วยความจำตามความยาว context เลือกโมเดลแชตขนาดเล็กที่แนะนำและ context สั้น ๆ เพื่อให้เหลือพื้นที่สำรอง การมีไฟล์สมมติขนาด 4GB บนพีซี RAM 16GB ไม่ได้พิสูจน์ว่าบทสนทนายาว ๆ จะใช้ได้ด้วย หากเปรียบเทียบ quantization ในภายหลัง ให้คงโมเดล prompt และ context ไว้เหมือนเดิมเพื่อแยกได้ว่าอะไรเปลี่ยน ตรวจใบอนุญาตของโมเดลนั้นก่อนใช้เชิงพาณิชย์ ใบอนุญาต MIT ของแอปไม่ได้ครอบคลุมโมเดลที่ดาวน์โหลดได้ทุกตัว
ทำให้บทสนทนาแรกตรวจสอบได้ง่ายโดยตั้งใจ
บทความเปิดตัวเรียกแผงต่าง ๆ ว่า Recommended Models และ Available แต่ซอร์ส v0.12.0 ที่ตรวจสอบใช้ Models มีตัวคั่น Browse more และ tooltip ของไอคอน เช่น Download model, Load model, Open WebUI และ Stop model ให้ทำตามตัวควบคุมที่มีในรุ่นของคุณ แทนการค้นหาชื่อแผงแบบเก่าไม่รู้จบ ซอร์ส UI Windows ตามรุ่น
- เปิดแผงจากถาดระบบ แล้วตรวจขนาดและรายละเอียดของโมเดลที่แนะนำ สำหรับการใช้งานครั้งแรก เลือกโมเดลสาธารณะที่ไม่ต้องขอสิทธิ์เข้าถึง
- ใช้ตัวควบคุมดาวน์โหลดแล้วรอให้เสร็จ การดาวน์โหลดเสร็จหมายความว่าได้ไฟล์มาแล้ว ไม่ได้หมายความว่า inference กำลังทำงาน
- เลือก context สั้น ๆ ในรายละเอียดโมเดล แล้วใช้ Load model เมื่อโหลดแล้ว เลือก Open WebUI เพื่อเปิดแชตในเครื่อง คู่มือเริ่มต้นอย่างเป็นทางการก็แนะนำให้เลือก context ก่อนเริ่มแชต คู่มือเริ่มต้น
- วาง prompt สังเคราะห์ด้านล่างแล้วส่ง ตรวจคำตอบเทียบกับข้อเท็จจริงที่ให้ อย่าตัดสินว่าสำเร็จเพียงเพราะมีข้อความปรากฏขึ้น
Use only these fictional notes. Return three bullets: owner, task, due date.
If a due date is missing, write "not specified".
Mira will send the draft on October 23.
Leo will check the links on October 24.
Sam will choose a cover image. No deadline was agreed.
คำตอบที่ดีต้องเก็บวันที่ทั้งสองไว้ และระบุว่าไม่ได้กำหนดเส้นตายให้ Sam การแต่งกำหนดส่งขึ้นมาเองถือเป็นความผิดพลาดด้านความถูกต้อง แม้การติดตั้งจะทำงานสมบูรณ์ก็ตาม บันทึก prompt และ model ID ไว้ใช้เปรียบเทียบ แล้วใช้ Stop model เมื่อเสร็จ แอปยังระบุทางลัดโอเวอร์เลย์แชต Alt+Space ด้วย แต่เป็นตัวเลือกเสริม ไม่ใช่ข้อกำหนด README สำหรับ Windows
งานเล็ก ๆ สามแบบแสดงให้เห็นว่าโมเดลในเครื่องเหมาะกับอะไร
ตัวอย่างต่อไปนี้เป็นแบบฝึกหัดประกอบที่ใช้ข้อมูลสมมติ ไม่ใช่ผลลัพธ์ที่บันทึกจากโมเดล แต่ละตัวอย่างมีโจทย์ คำถามติดตาม และเกณฑ์ยอมรับที่ชัดเจน
เปลี่ยนบันทึกคร่าว ๆ เป็นข้อมูลส่งต่องานโดยไม่แต่งเติมมติ
สมมติว่ากลุ่มอาสาสมัครกำลังเตรียมงานช่วงสุดสัปดาห์ วางคำขอนี้:
Make a handoff with Decisions, Actions, and Open questions.
Use only the notes. Quote the supporting phrase for every action.
Notes: We chose the library room. June will confirm capacity by Friday.
Omar offered to bring signs, but nobody accepted the offer yet.
The start time is still undecided.
จุดสำคัญคือแยกข้อผูกมัดออกจากข้อเสนอ ถามต่อว่า “งานใดได้รับมอบหมายอย่างชัดเจน และข้อใดเป็นเพียงข้อเสนอ” ยอมรับผลลัพธ์ก็ต่อเมื่องานของ June ถูกระบุเป็นงานที่มอบหมาย ข้อเสนอของ Omar ยังคงเป็นเพียงข้อเสนอ และไม่มีเวลาเริ่มงานปรากฏ เก็บบันทึกต้นฉบับไว้กับข้อมูลส่งต่องานเพื่อให้คนอื่นตรวจหลักฐานได้
เรียนรู้จากข้อความโดยให้คำถามอยู่ภายในขอบเขตแหล่งข้อมูล
ใช้ข้อความสาธารณสมบัติสั้น ๆ หรือคำอธิบายสมมติที่คุณเขียนขึ้นเอง นี่คือตัวอย่างฝึกที่มีข้อมูลครบในตัว:
Passage: In this fictional greenhouse, a timer waters the plants at 07:00.
A moisture sensor can cancel watering when the soil is already wet.
The timer does not measure temperature.
Create three study questions with answers. Quote the sentence supporting
each answer. Then ask one question the passage cannot answer.
ตรวจทุกข้อความที่อ้างมา ไม่ใช่แค่ดูว่าคำตอบฟังดูสมเหตุสมผล คำถามที่ข้อความตอบไม่ได้อาจถามเกี่ยวกับเกณฑ์อุณหภูมิ แต่โมเดลต้องไม่แต่งตัวเลขขึ้นมา ในรอบที่สอง ขอให้ใช้ถ้อยคำง่ายขึ้นโดยคงข้อเท็จจริงทั้งหมด วิธีนี้ทำให้ตรวจการเขียนใหม่ได้ทีละประโยค แทนการเปิดโอกาสให้เพิ่มบทสอนเรื่องเรือนกระจกทั่ว ๆ ไป
ร่างคำตอบบริการลูกค้าโดยไม่ให้คำมั่นเกินจริง
ก่อนใช้ข้อความลูกค้าจริง ลองฝึกกับ ticket สมมติก่อน:
Write a polite reply under 90 words using only this policy and ticket.
Policy: Refunds require staff review. No approval deadline is promised.
Ticket: My duplicate charge appeared yesterday. Can you refund it today?
Acknowledge the issue and ask for an order reference, not card details.
Do not promise approval, timing, or a completed action.
ปฏิเสธร่างที่บอกว่าดำเนินการคืนเงินแล้วหรือรับประกันว่าจะเสร็จในวันเดียว ขอให้โมเดลขีดเส้นใต้คำมั่นทุกข้อที่ให้ไว้ แล้วตรวจเองอีกครั้ง มีเพียงผู้ที่เข้าถึงระบบสนับสนุนจริงเท่านั้นที่ยืนยันการดำเนินการในบัญชีได้ การรันในเครื่องเปลี่ยนสถานที่ร่างข้อความ ไม่ได้ให้อำนาจโมเดลในการออกคำสั่งคืนเงิน
API ในเครื่องช่วยนำโมเดลเดิมกลับมาใช้ซ้ำ
คุณหยุดแค่แชตก็ได้ สำหรับ editor, script หรือ prototype เอกสารระบุเซิร์ฟเวอร์ที่จัดการไว้ที่ http://localhost:9931 และรองรับคำขอแบบ OpenAI ภายใต้ /v1 นี่คือการรองรับการทำงานในเครื่อง ไม่ใช่การส่งคำขอไปยังคลาวด์ของ OpenAI ตรวจใน Settings หากมีการเปลี่ยนพอร์ต เอกสาร API ของ Llama
เมื่อแอปทำงานและโหลดโมเดลไว้แล้ว ให้เปิด PowerShell เริ่มจากดูโมเดลที่ router มีให้บริการ /models แสดงสถานะการโหลด ส่วน /v1/models เป็น endpoint metadata ที่เข้ากันได้กับ OpenAI คัดลอก ID ที่ตรงทุกตัวอักษรของโมเดลที่คุณโหลดไว้โดยตั้งใจ อย่าเลือกแถวแรกแบบสุ่ม เพราะอาจทำให้มีการโหลดโมเดลอื่น
$base = 'http://localhost:9931'
$headers = @{}
# Only needed if your local server is configured to require a key.
if ($env:LLAMA_LOCAL_API_KEY) {
    $headers.Authorization = "Bearer $env:LLAMA_LOCAL_API_KEY"
}
Invoke-RestMethod -Uri "$base/models" -Headers $headers |
    ConvertTo-Json -Depth 10
ก่อนรันบล็อกที่สอง ให้แทน placeholder ด้านล่างด้วย ID ที่ตรงกันทุกตัวอักษร บล็อกนี้ส่งเฉพาะข้อความสมมติและไม่ต้องใช้ SDK เพิ่ม:
$modelId = 'PASTE-THE-LOADED-MODEL-ID'
if ($modelId -eq 'PASTE-THE-LOADED-MODEL-ID') {
    throw 'Choose the already-loaded model ID from /models first.'
}
$body = @{
    model = $modelId
    messages = @(@{
        role = 'user'
        content = 'Rewrite clearly: Our fictional workshop begins at noon.'
    })
    max_tokens = 96
    stream = $false
} | ConvertTo-Json -Depth 5
$reply = Invoke-RestMethod -Method Post `
    -Uri "$base/v1/chat/completions" -Headers $headers `
    -ContentType 'application/json' -Body $body -TimeoutSec 180
$reply.choices[0].message.content
รูปแบบคำขอและฟิลด์ผลลัพธ์เป็นไปตามคู่มืออ้างอิงเซิร์ฟเวอร์ llama.cpp อย่างเป็นทางการ คง Listen On ไว้ที่ localhost อย่าวาง cloud API key ลงในตัวอย่างนี้ หากได้ข้อผิดพลาด 401 ให้ตรวจการยืนยันตัวตนในเครื่อง อย่าถอดระบบป้องกัน ใน v0.12.0 การเลือกที่อยู่ที่ไม่ใช่ loopback จะทำให้แอปสร้าง key และต้องได้รับการยืนยัน พฤติกรรมความปลอดภัย Windows
การรัน inference ในเครื่องไม่ได้ทำให้การเชื่อมต่อเครือข่ายทั้งหมดหายไป
README ของ Windows ระบุว่า prompt และ inference อยู่ภายในเครื่อง และแอปไม่ส่ง telemetry นอกจากนี้ยังระบุคำขอเครือข่ายสำหรับดาวน์โหลดโมเดลและตรวจอัปเดตรุ่น โดย User-Agent มีเวอร์ชันแอป บิลด์ Windows และสถาปัตยกรรม กิจกรรมเหล่านี้เป็นคนละเรื่องกัน จึงไม่ขัดกับความหมายของคำว่า “ออฟไลน์” คำชี้แจงความเป็นส่วนตัว
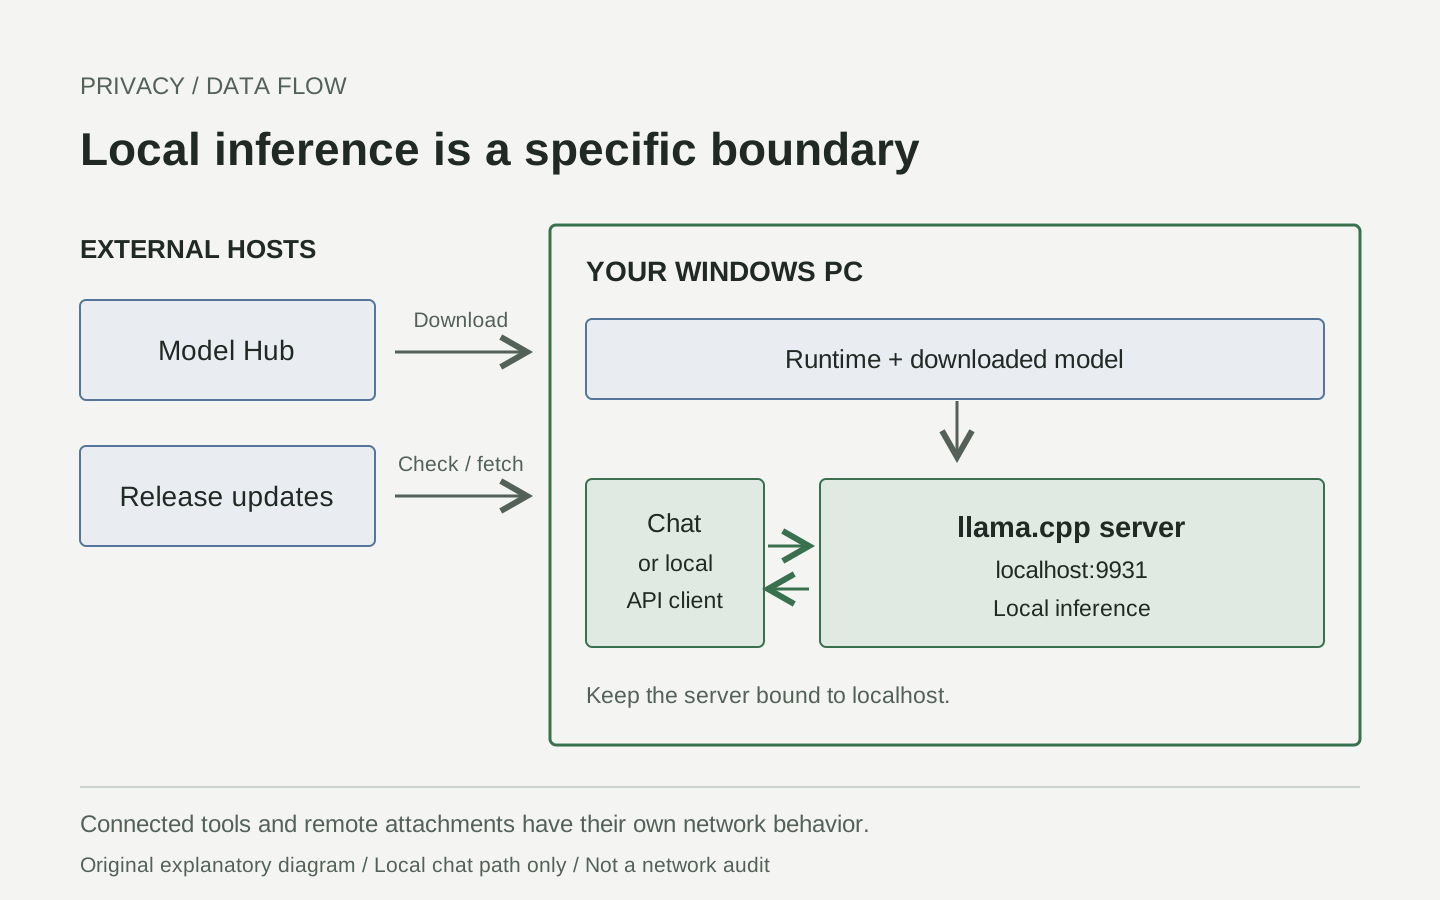
คำอธิบายการไหลของข้อมูลต้นฉบับ โฮสต์ดาวน์โหลดอยู่ภายนอก เส้นทางแชตที่แสดงเป็นการทำงานในเครื่อง แหล่งข้อมูล: เอกสารความเป็นส่วนตัวของ Windows และเอกสารอ้างอิง API
โมเดลที่ดาวน์โหลดแล้วและรองรับสามารถประมวลผล inference ได้โดยไม่ต้องต่ออินเทอร์เน็ต แต่การดาวน์โหลดโมเดลใหม่ยังต้องใช้อินเทอร์เน็ต editor ที่เชื่อมต่ออยู่ ส่วนขยายเบราว์เซอร์ URL ไฟล์แนบระยะไกล หรือเครื่องมือภายนอกที่เปิดใช้งาน ต่างมีพฤติกรรมเครือข่ายของตัวเอง อย่าคิดว่าสิ่งเหล่านี้ได้รับขอบเขตการทำงานเฉพาะในเครื่องแบบเดียวกับเซิร์ฟเวอร์
ก่อนทำงานลับ ให้ตรวจที่เก็บบทสนทนา ส่วนขยายเบราว์เซอร์ ตำแหน่งสำรองข้อมูลและซิงก์ ตลอดจนนโยบายขององค์กร แชตสังเคราะห์แบบออฟไลน์เป็นการตรวจฟังก์ชันที่มีประโยชน์หลังตั้งค่า แต่ไม่ใช่หลักฐานว่าตรวจสอบทุกองค์ประกอบแล้ว อย่าใส่ token หรือ prompt ส่วนตัวลงในบันทึกวินิจฉัยสาธารณะ
แก้ปัญหาเฉพาะขั้นตอนที่ล้มเหลว ไม่ใช่เริ่มติดตั้งใหม่ทั้งหมด
| อาการ | ตรวจสอบก่อน | ขั้นตอนถัดไปที่เป็นประโยชน์ |
|---|---|---|
| ติดตั้ง bundle ไม่ได้ | บิลด์ขั้นต่ำ 26100 สถาปัตยกรรม ลายเซ็น และนโยบายอุปกรณ์ | เก็บข้อความผิดพลาดจาก App Installer ไว้ แล้วใช้การอัปเดตทางการหรือติดต่อผู้ดูแลระบบ |
| ไม่เห็นหน้าต่างแอป | พื้นที่แจ้งเตือนและไอคอนที่ซ่อนอยู่ | เปิดไอคอนในถาดระบบ ไม่ได้คาดว่าจะมีหน้าต่างประจำบน taskbar |
| ดาวน์โหลดโมเดลไม่สำเร็จ | พื้นที่ปลายทาง การเชื่อมต่อ สิทธิ์เข้าถึงแบบจำกัด และข้อความผิดพลาด | แก้สาเหตุนั้นก่อนลองใหม่ เริ่มด้วยโมเดลสาธารณะ |
| ดาวน์โหลดเสร็จแต่โหลดโมเดลไม่ผ่าน | ค่าประมาณ context หน่วยความจำว่าง และข้อผิดพลาด runtime | หยุดโมเดลอื่นที่โหลดอยู่ แล้วลด context หรือขนาดโมเดล |
| ตอบช้า | ขนาดโมเดล ความยาว context และ CPU/GPU backend ที่กำลังใช้งานจริง | เปรียบเทียบด้วย prompt สั้น ๆ อย่าคิดว่าคำแนะนำในแค็ตตาล็อกรับประกันความเร็ว |
| API เชื่อมต่อไม่ได้ | แอปกำลังทำงาน พอร์ตที่ตั้งไว้ และที่อยู่ในเครื่อง | ตรวจสถานะเซิร์ฟเวอร์ก่อนเริ่มเซิร์ฟเวอร์อีกตัว |
| คำตอบลื่นไหลแต่มีข้อมูลเท็จ | ข้อความต้นทางและความเหมาะสมของโมเดล | ลดขอบเขตงานและกำหนดให้ยกข้อความสนับสนุน |
README ปัจจุบันระบุตำแหน่งการตั้งค่าและบันทึกไว้ที่ %LOCALAPPDATA%\Llama ส่วนบทความเปิดตัวระบุเส้นทางบันทึกอีกแบบ ให้ใช้ตัวควบคุมโฟลเดอร์บันทึกในแอป แทนการเดา endpoint /health ที่ระบุไว้ช่วยแยกได้ว่าเซิร์ฟเวอร์โมเดลพร้อมใช้หรือยังโหลดไม่เสร็จ แต่การที่ router ทำงานไม่ได้ยืนยันว่าโมเดลที่เลือกโหลดแล้ว เอกสารที่เก็บข้อมูลปัจจุบัน, พฤติกรรม health ของเซิร์ฟเวอร์
ถือว่าการตั้งค่าครั้งแรกสำเร็จเมื่อผ่านรายการตรวจสอบเหล่านี้
- ติดตั้งแพ็กเกจทางการที่ลงนามแล้วได้โดยไม่ปิดการควบคุมความปลอดภัย
- โมเดลที่เลือกไว้อย่างตั้งใจดาวน์โหลดและโหลดได้สำเร็จหนึ่งโมเดล
- เปิดแชตที่ที่อยู่ในเครื่องและตอบงานสังเคราะห์ได้
- วันที่ ชื่อ และข้อมูลที่ขาดหายตรงกับข้อความที่ให้
- หยุดโมเดลแล้วโหลดใหม่ได้
- หากใช้ API โมเดลที่ตั้งใจเลือกตอบได้ และเซิร์ฟเวอร์ยังจำกัดอยู่ที่ localhost
สรุป: AI ในเครื่องคือเวิร์กโฟลว์ที่คุณตรวจสอบได้
ในความเห็นของเรา การปรับปรุงที่สำคัญไม่ใช่แค่ไม่ต้องพิมพ์คำสั่งเทอร์มินัลหนึ่งบรรทัด แต่คือการทำให้การเลือกโมเดล การใช้หน่วยความจำ ข้อมูลต้นทาง และคำตอบที่ได้เข้าใจง่ายพอจะทำซ้ำได้ เริ่มจากงานเล็ก ๆ ที่คุณตรวจคำตอบได้ แล้วค่อยขยายเมื่อรู้ว่าผลลัพธ์ที่ดีหน้าตาเป็นอย่างไร
แหล่งข้อมูลและสื่อ
ตรวจสอบเมื่อวันที่ 20 ตุลาคม 2026 คู่มือนี้อธิบายเวิร์กโฟลว์ตามเอกสาร ไม่ได้อ้างว่าทดลองติดตั้ง รันโมเดล ส่งคำขอแบบเสียเงิน หรือวัดประสิทธิภาพ ภาพ SVG ทั้งสามชิ้นเป็นภาพอธิบายต้นฉบับ ไม่ใช่ภาพจำลองอินเทอร์เฟซ ดูภาพหน้าจอถาดระบบอย่างเป็นทางการ และตัวอย่างโอเวอร์เลย์ จากผู้เผยแพร่เพื่อดูอินเทอร์เฟซจริง ลิงก์ไปยังภาพเหล่านั้น แต่ไม่ได้นำมาเผยแพร่ซ้ำ
- ประกาศ Hugging Face วันที่ 13 ตุลาคม
- รุ่น Windows แพ็กเกจ และการเปลี่ยนแปลงด้านความปลอดภัย
- คู่มือติดตั้งและเริ่มต้นอย่างเป็นทางการ
- รูปแบบ GGUF และ metadata
- เอกสาร API ในเครื่องและ endpoint
- คู่มืออ้างอิง runtime และเซิร์ฟเวอร์ llama.cpp
เก็บการทดลองไว้ใช้ซ้ำได้
เก็บลิงก์แหล่งข้อมูล prompt, model ID และบันทึกตรวจทานไว้ด้วยกัน แทนที่จะเก็บเฉพาะคำตอบสุดท้าย Telli.sh ช่วยจัดระเบียบบันทึกค้นคว้าเหล่านั้นได้ แต่ไม่ใช่การเชื่อมต่อกับ Llama Windows และไม่ได้รับรองว่าบันทึกของคุณจะอยู่ในเครื่องเท่านั้น สร้างบัญชี Telli.sh