แอป AI ในเครื่องของคุณอัปเป็น llama.cpp 1.0 โดยไม่ทำให้งานเดิมสะดุดได้ไหม?
llama.cpp 1.0 ใช้หมายเลขเวอร์ชันบอกการเปลี่ยนอินเทอร์เฟซ C สาธารณะที่ไม่เข้ากัน ลองตรวจไลบรารี เซิร์ฟเวอร์ในเครื่อง และแพ็กเกจแอปก่อนแทนรุ่นที่ใช้งานอยู่
ทีมวิศวกรเล็ก ๆ นำผู้ช่วยอ่านเอกสารแบบออฟไลน์ไปใช้ในพื้นที่ที่อินเทอร์เน็ตไม่ดี แอปรับย่อหน้าจากคู่มือซ่อมบำรุงแล้วคืนเลขหน้าอ้างอิงกับคำตอบสั้น ๆ บนเครื่องนักพัฒนา llama.cpp รุ่นใหม่เริ่มและให้ข้อความได้ แต่แล็ปท็อปหน้างานยังใช้ตัวเปิดโปรแกรมที่ส่งออปชันเก่า ลึกลงไปอีก แอปคาดว่าคำตอบจะมีฟิลด์ที่การทดสอบด้วยมือของนักพัฒนาไม่ได้ตรวจ ทั้งสามจุดเรียกว่าอัปเกรด llama.cpp เหมือนกัน แต่ต่างพึ่งคนละอินเทอร์เฟซ
เมื่อ 13 พฤศจิกายน 2026 ggml-org ปล่อย llama.cpp และ ggml 1.0.0 เครื่องมือแรกใช้รันโมเดลภาษาและให้ไลบรารีอนุมานชื่อ libllama ตัวหลังมีการดำเนินการกับเทนเซอร์และแบ็กเอนด์ฮาร์ดแวร์ พร้อมไลบรารีชื่อ libggml ผู้ดูแลโครงการประกาศว่าความไม่เข้ากันของอินเทอร์เฟซ C สาธารณะในอนาคตจะสะท้อนผ่านหมายเลขเวอร์ชันหลัก ส่วน llama.cpp 1.0.0 รุ่นนี้ถอดฟังก์ชันที่ประกาศเลิกใช้และออปชันบรรทัดคำสั่งที่เลิกใช้แล้ว ประกาศนโยบายเวอร์ชันจากผู้ดูแล 13 พฤศจิกายน · รีลีส llama.cpp 1.0.0 · รีลีส ggml 1.0.0
ก่อนเปลี่ยนรันไทม์ ลองจัดการเชื่อมต่อเป็นสามกลุ่ม แอปบางตัวบิลด์และลิงก์กับไลบรารี C บางตัวเปิดเซิร์ฟเวอร์ HTTP ในเครื่องแล้วส่งคำขอ บางตัวแจกจ่ายรันไทม์มากับแอปติดตั้งสำเร็จ แอปเดียวอยู่ได้หลายกลุ่ม แต่ละกลุ่มมีการตรวจสั้น ๆ ช่วยให้ตัดสินใจอัปเกรดได้ดีขึ้นกว่าการเห็นเดโมผ่านบนเครื่องนักพัฒนา
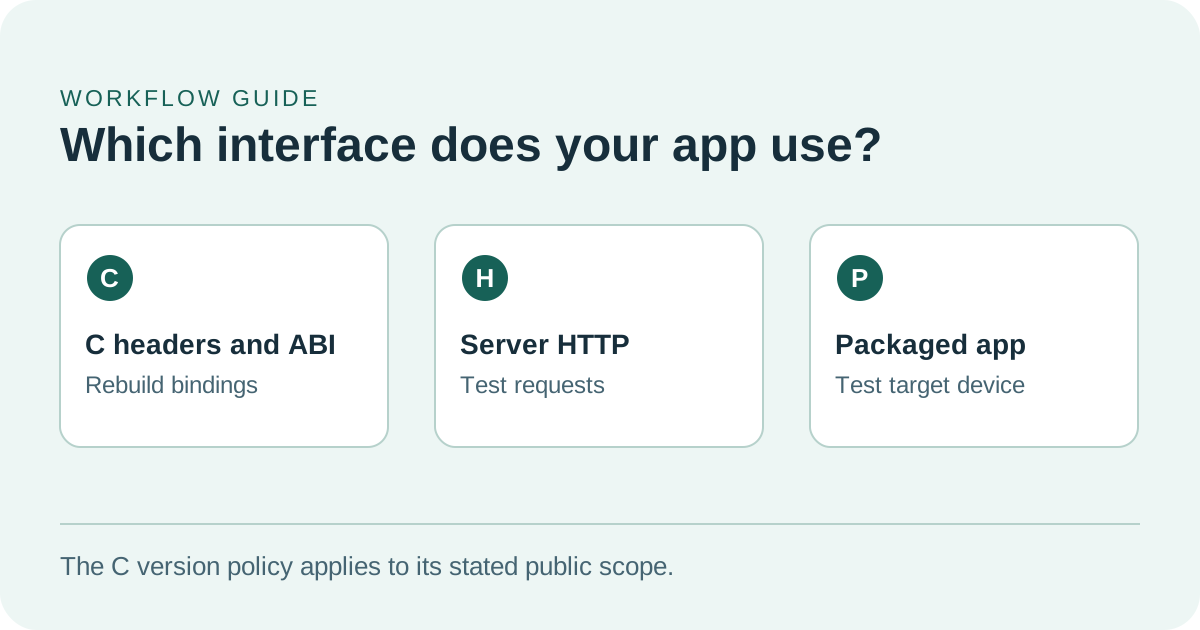
ความเข้ากันได้ของ C คำตอบ HTTP และแพ็กเกจที่ติดตั้งใช้การตรวจคนละแบบ
เวอร์ชัน 1.0 ให้สัญญาณกับการเชื่อมต่อแบบเนทีฟชัดขึ้น
เฮดเดอร์ C อธิบายวิธีที่ซอร์สโค้ดเรียกไลบรารีและบอกคอมไพเลอร์ว่ามีฟังก์ชันกับชนิดข้อมูลอะไร อินเทอร์เฟซระดับไบนารีหรือ ABI กำหนดว่าโค้ดกับไลบรารีที่คอมไพล์แล้วทำงานด้วยกันอย่างไร บิลด์ใหม่จากต้นช่วยเจอประกาศระดับซอร์สที่ถูกถอดได้เร็ว การเปิดแอปที่ลิงก์แล้วใช้ทดสอบสิ่งที่เกิดขึ้นจริงกับไลบรารีที่ติดตั้งบนเครื่องเป้าหมาย แอปที่โหลดไลบรารีเนทีฟของตัวเองควรตรวจทั้งสองอย่าง
นโยบายวันที่ 13 พฤศจิกายนอธิบายว่าการเปลี่ยน C API สาธารณะในโฟลเดอร์ include ที่ทำให้ไม่เข้ากันจะเพิ่มเวอร์ชันหลัก การเพิ่มที่เข้ากันได้ การอัปเดตแบ็กเอนด์ และการรองรับโมเดลอยู่ในเวอร์ชันรอง ส่วนการแก้บั๊กที่ไม่เปลี่ยน API อยู่ในแพตช์ นี่เป็นสัญญาณที่มีประโยชน์กับคนส่งมอบตัวเชื่อมเนทีฟ ส่วนคนแจกตัวเปิดบรรทัดคำสั่งหรือไคลเอนต์ HTTP ยังต้องตรวจออปชันและคำขอที่ผู้ใช้ใช้อยู่ ประกาศนโยบายเวอร์ชันจากผู้ดูแล
การเปลี่ยนแปลงที่แท็กไว้มีตัวอย่างชัดเจน บันทึก llama.cpp 1.0.0 ระบุการถอดฟังก์ชันเลิกใช้ 35 รายการใน llama.h พร้อมระบุแยกถึงการถอด llama_set_warmup และตัวควบคุมการจัดเรียงข้อมูลที่เลิกใช้แล้ว นอกจากนี้ยังย้าย NextN API สำหรับการถอดรหัสแบบคาดการณ์ไปยัง llama.h และบันทึกการเปลี่ยนชื่อที่เกี่ยวกับสถานะ เริ่มจากฟังก์ชันที่คุณใช้ ถ้าคอมไพเลอร์ระบุว่าหาฟังก์ชันไม่เจอ ให้ดูบันทึกรีลีสและเฮดเดอร์สาธารณะปัจจุบันก่อนหาวิธีแทนพฤติกรรมเดิม การเปลี่ยน API ใน 1.0.0 · เฮดเดอร์สาธารณะที่แท็ก 1.0.0
สำหรับผู้ช่วยอ่านคู่มือออฟไลน์ การทดสอบเนทีฟเบื้องต้นคือโหลดไฟล์โมเดลที่รู้จัก ส่งคำถามกับข้อความสั้น ๆ อ่านคำตอบที่สร้าง แล้วปิดโมเดลให้เรียบร้อย ทำลำดับโหลดและปิดซ้ำในโปรเซสแอปที่ผู้ใช้จะรัน หากมีตัวเชื่อมภาษาแยกที่คอมไพล์เอง ให้เช็กว่าบิลด์เลือกเฮดเดอร์ที่ตั้งใจและรันไทม์ที่ติดตั้งโหลดไลบรารีที่ตั้งใจ จดไฟล์ที่ใช้ก่อนอ่านผล คอมไพล์ผ่านกับสำเนาหนึ่งในเครื่องไม่ได้ยืนยันสำเนาที่แพ็กแยกไว้ข้างแอปบนแล็ปท็อปหน้างาน
ทดสอบส่วนที่ผู้ใช้พึ่งจริง
โครงการยังมี llama-server ซึ่งเป็นโปรเซส HTTP ที่มีออปชันบรรทัดคำสั่งและเอกสารเอ็นด์พอยต์ของตัวเอง 1.0.0 เพิ่มเอ็นด์พอยต์ /v1/audio/speech ที่เข้ากันกับ OpenAI เป็นตัวอย่างความสามารถเซิร์ฟเวอร์ที่เปลี่ยนได้ควบคู่กับไลบรารี C รุ่นเดียวกันนี้ถอด --defrag-thold บริการที่แพ็กไว้และยังส่งออปชันดังกล่าวจึงต้องย้ายแม้ไม่ได้เรียกฟังก์ชัน C โดยตรง บันทึกรีลีส 1.0.0 · เอกสารเซิร์ฟเวอร์ที่แท็ก 1.0.0
คู่มือเซิร์ฟเวอร์มีการตรวจสั้น ๆ ใช้คู่กับการทดสอบแอปได้ คำขอที่ /health อาจคืน HTTP 503 ขณะโหลดโมเดล และคืน 200 เมื่อโหลดแล้ว จากนั้นทีมที่ใช้ไคลเอนต์ HTTP อยู่แล้วสามารถส่งคำขอแชต เอ็มเบดดิง หรือคำขอตามงาน แล้วตรวจว่าแยกข้อมูลคำตอบได้ สำหรับสตรีม ให้ลองคำตอบสั้นที่จบปกติและคำตอบยาวที่ผู้ใช้กดยกเลิกผ่านแอป คำขอเอ็นด์พอยต์ง่ายที่สุดที่ผ่านยังไม่ทดสอบปุ่มยกเลิกหรือตัวแยกข้อความ เอกสารสถานะและเอ็นด์พอยต์เซิร์ฟเวอร์ v1.0.0
| สิ่งที่แอปใช้ | ตรวจอย่างแรกหลังอัปเกรด | งานจริงเพิ่มอะไร |
|---|---|---|
| เฮดเดอร์ C สาธารณะและไลบรารีเนทีฟ | บิลด์ใหม่และรันกับไลบรารีที่ตั้งใจ | โหลดโมเดล ส่งคำขอสั้น และคืนทรัพยากรหลายรอบ |
| โปรเซสเซิร์ฟเวอร์ HTTP ในเครื่อง | เปิดด้วยค่าที่บันทึกและรอสถานะพร้อม | ทดสอบคำขอจริง คำตอบแบบสตรีม การยกเลิก และข้อผิดพลาดที่ไคลเอนต์รองรับ |
| แอปเดสก์ท็อปหรือชุดติดตั้งออฟไลน์ที่รวมรันไทม์ | ติดตั้งบนเครื่องตัวแทนและจดไฟล์ที่บิลด์ | เปิดแอปด้วยค่าผู้ใช้เดิมและใช้โมเดลในเครื่องที่รู้จักผ่านรุ่นที่ติดตั้ง |
| แบ็กเอนด์ฮาร์ดแวร์เจาะจง | เช็กแบ็กเอนด์ที่เลือกและว่าโมเดลใช้หน่วยความจำพอไหม | เทียบหน่วยความจำและเวลาบนสเปกช้าที่สุดที่ประกาศรองรับ |
การเชื่อมต่อแบบที่สามมีผลไกลกว่ารายการฟีเจอร์เซิร์ฟเวอร์ ตัวอย่างเช่น แพ็กเกจ Windows อาจต้องมีไลบรารีแบ็กเอนด์ข้างไฟล์รัน ต้องหาโมเดลเดิมของผู้ใช้ได้ และแสดงข้อความที่เข้าใจง่ายเมื่อไฟล์หาย นักพัฒนาอาจมีแบ็กเอนด์ที่ใช้งานได้ติดตั้งแยกอยู่แล้ว การลองแอปใหม่บนเครื่องติดตั้งตัวแทนช่วยเจอไลบรารีที่ขาดซึ่งเครื่องพัฒนามีให้เอง ประกาศวันที่ 13 พฤศจิกายนระบุช่องทางแพ็กเกจและแพลตฟอร์มพรีรีลีสหลายแบบ ใช้แท็กหรือแพ็กเกจตรงกับที่จะปล่อยและบันทึกที่มา หมายเหตุเรื่องแพ็กเกจจากผู้ดูแล
หมายเลขรีลีสบอกไม่ได้ว่าคำตอบจากคู่มือจะมาเร็วแค่ไหน
คนที่รอผู้ช่วยออฟไลน์รับรู้หลายขั้นเป็นการรอครั้งเดียว โมเดลโหลด แอปแปลงคำถามและส่วนเอกสารเป็นโทเคน รันไทม์ประมวลผลอินพุต เริ่มสร้างข้อความ และส่งขึ้นหน้าจอ คู่มือส่วนที่ยาวอาจใช้เวลาส่วนใหญ่ไปกับการประมวลผลอินพุต ส่วนคำตอบที่ตั้งใจให้ยาวอาจหมดเวลาไปกับการสร้างโทเคน แยกวัดเวลาเริ่มแอป จนเห็นข้อความแรก และจนจบ ถ้าแต่ละช่วงสำคัญต่อผู้ใช้
คู่มือที่แท็ก 1.0.0 แยกโหมด llama-bench เป็นประมวลผลพรอมป์ สร้างข้อความ และแบบรวม ระบุด้วยว่าเวลาที่รายงานไม่นับการแปลงเป็นโทเคนและการสุ่มเลือกโทเคน เครื่องมือนี้จึงใช้เทียบสองบิลด์ด้วยการตั้งค่าเดียวกันได้ และตัวเลขต่างจากเวลารอที่ UI วัด จดทั้งสองแบบหากอยากรู้ว่าขั้นตอนไหนดีขึ้น เอกสารเบนช์มาร์กที่แท็ก 1.0.0
เริ่มจากใช้ไฟล์ GGUF เดียวกันทั้งสองบิลด์ ใช้แบ็กเอนด์ฮาร์ดแวร์ การตั้งค่าคอนเท็กซ์ และตัวเลือกการถ่ายงานแบบเดียวกันเท่าที่ทั้งคู่รองรับ บันทึกค่าจริงกับแฮชโมเดล แล้วลองทั้งอินพุตสั้นและยาวเท่าเอกสาร วัดหน่วยความจำสูงสุดที่เห็นในคำขอตัวแทนที่ยาวที่สุดและระดับทรงตัวหลังโหลดด้วย โมเดลที่เปิดได้บนเครื่องว่างอาจชนขีดจำกัดต่างกันเมื่อผู้ใช้เปิดเบราว์เซอร์และโปรแกรมอ่านเอกสารอยู่
รีลีส 1.0.0 ระบุตัวเลือก FP8 สำหรับแคชคีย์และแวลูที่ใช้ตอนอนุมาน รวม f8_e4m3 และแคช expert ในหน่วยความจำโฮสต์ที่ปรับได้สำหรับโมเดล mixture-of-experts ความสามารถเหล่านี้เพิ่มการตั้งค่าที่ควรเทียบ หากแบ็กเอนด์กับโมเดลรองรับ ให้แยกวัดผลจากการย้ายไป 1.0 เปิดใช้บนเครื่องตัวแทนหนึ่งเครื่อง รันอินพุตเดิม และเทียบว่าคำตอบยังตรงข้อกำหนดของแอปไหม วิธีนี้ช่วยตามสาเหตุเมื่อเวลาต่างออกไปหรืออ้างอิงหายโดยไม่ต้องเดาว่าการเปลี่ยนไหนเป็นต้นเหตุ การเปลี่ยนหลักใน 1.0.0
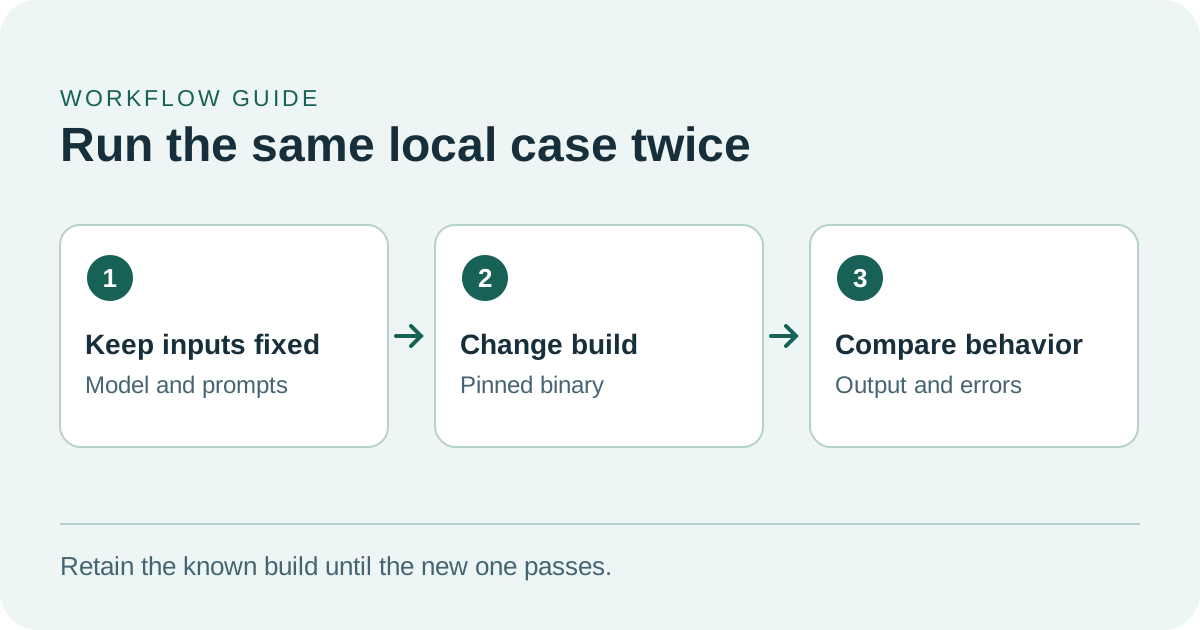
ตรึงโมเดลและอินพุตไว้เพื่อระบุได้ว่าความต่างมาจากการอัปเกรด
ซ้อมย้ายแบบเล็กเพื่อให้การตัดสินใจปล่อยรุ่นมีหลักฐาน
- เลือกสองบิลด์ที่ระบุได้ชัด เก็บบิลด์ที่ใช้อยู่กับตัวเลือก 1.0.0 คนละที่ จดเวอร์ชันแอป รันไทม์ และโมเดล ใช้ checksum ของ GGUF เดียวกันสำหรับแต่ละรอบและจดแบ็กเอนด์ฮาร์ดแวร์ รักษาข้อมูลผู้ใช้และการตั้งค่าแอปเมื่อเปลี่ยนบิลด์
- ใช้เส้นทางเปิดแอปตามปกติ สำหรับทดสอบเซิร์ฟเวอร์เฉพาะ loopback ใช้
llama-server -m ./handbook-model.gguf --host 127.0.0.1 --port 9931เป็นจุดเริ่มหลังแทนไฟล์โมเดลด้วยไฟล์จริงที่ได้รับอนุมัติ ลองคำสั่งของรุ่นใช้งานด้วยเพื่อเจอออปชันเลิกใช้ตั้งแต่ต้น ดูสถานะพร้อมและทดสอบกับไคลเอนต์ที่ผู้ใช้เปิดจริง วิธีตั้งค่าและออปชันเซิร์ฟเวอร์ตามแท็ก - เตรียมคำถามยากไว้สองสามข้อ ลองข้อความสั้นที่มีคำตอบชัด ข้อความยาวที่มีคำศัพท์ใกล้เคียง และคำถามที่ไม่มีคำตอบในข้อความ ระบุผลที่ถือว่าใช้ได้ของแต่ละข้อ ผู้ช่วยควรอ้างหน้าถูกเมื่อเนื้อหามีคำตอบและบอกเมื่อไม่มีหลักฐาน บันทึกข้อผิดพลาดการแยกข้อมูลและผลที่ใช้ไม่ได้แยกจากคุณภาพโมเดล
- เทียบประสิทธิภาพทีละการตั้งค่า บนเครื่องตัวแทน เริ่มด้วย
llama-bench -m ./handbook-model.gguf -p 512 -n 128 -r 5บนแต่ละบิลด์โดยใช้แบ็กเอนด์เดียวกัน จำนวนโทเคนและการทำซ้ำห้าครั้งเป็นตัวอย่าง ควรวัดการเปิดแอป หน่วยความจำ เวลา และลองอินพุตจริงที่ยาวขึ้นด้วยก่อนสรุปประสบการณ์ผู้ใช้ ออปชันเบนช์มาร์กตามแท็ก - รันบิลด์ที่ติดตั้งแล้วและซ้อมย้อนกลับ ลองรุ่นทดสอบบนการติดตั้งใหม่ที่เป็นตัวแทน รีสตาร์ตแล้วทำกรณีใหญ่สุดที่รองรับซ้ำ เช็กว่าหากเปิดไม่ขึ้นยังใช้การตั้งค่าและไฟล์เดิมได้ และกลับไปใช้แอปเวอร์ชันก่อนหน้าได้ เก็บหลักฐานที่ช่วยให้เพื่อนร่วมทีมรู้ว่าเมื่อใดควรพักการปล่อยวงกว้าง
โครงการส่วนใหญ่ต้องการตัวอย่างทดสอบดี ๆ เพียงไม่กี่ชุดเพื่อเจอปัญหาถัดไป เมื่อข้อความยาวตอบช้าลง ให้ดูว่าต่างก่อนข้อความแรก ระหว่างสร้าง หรือที่การแสดงผลของแอป ถ้าคำขอเริ่มล้มเหลวหลังเปลี่ยน ให้บันทึกรูปแบบคำขอและไคลเอนต์ที่ทำให้เกิดก่อนเปลี่ยนพรอมป์หรือโมเดล ถ้าล้มเหลวเฉพาะตัวที่แพ็กไว้ ให้เทียบชุดติดตั้งและโปรเซสจริงกับสำเนาที่นักพัฒนารันได้ การเทียบชุดแรกนี้ให้กรณีชัดเจนแก่ผู้รับผิดชอบแต่ละชั้นเพื่อนำไปทำซ้ำ
การอัปเกรดที่ได้ผลต้องทำซ้ำบนเครื่องที่ต้องใช้งาน
คุณค่าของ llama.cpp 1.0 คือแนวทางที่ชัดขึ้นในการรับมือการเปลี่ยนแปลงของรันไทม์ที่เครื่องมือในเครื่องจำนวนมากพึ่งพา ทีมแอปตอบสนองได้ด้วยบันทึกความเข้ากันได้สั้น ๆ ระบุบิลด์ โมเดล เครื่อง คำขอที่ผู้ใช้ใช้จริง และผล รุ่นถัดไปจึงเริ่มจากการทดสอบงานที่คนพึ่งพาได้ แม้ผู้ดูแลรันไทม์และแอปจะเปลี่ยนคนแล้ว
แหล่งอ้างอิง
- ประกาศนโยบายเวอร์ชันและช่องทางเผยแพร่ของ ggml-org วันที่ 13 พฤศจิกายน 2026
- รีลีส llama.cpp 1.0.0 วันที่ 13 พฤศจิกายน 2026
- รีลีส ggml 1.0.0
- เฮดเดอร์ C สาธารณะของ llama.cpp ที่แท็ก 1.0.0
- เอกสาร llama-server ที่แท็ก 1.0.0
- เอกสาร llama-bench ที่แท็ก 1.0.0
หากต้องการเก็บการตัดสินใจอัปเกรด บันทึกการทดสอบ และการตั้งค่าโมเดลไว้ค้นได้ สร้างบัญชี Telli.sh.