Bolehkah aplikasi AI setempat anda beralih ke llama.cpp 1.0 tanpa mengganggu aliran kerja?
Nombor versi llama.cpp 1.0 kini memberi isyarat apabila antara muka C awam berubah secara tidak serasi. Uji pustaka, pelayan setempat dan pakej aplikasi sebelum menggantikan binaan yang berfungsi.
Sebuah pasukan kejuruteraan kecil membawa pembantu dokumen luar talian ke tapak yang sambungan Internetnya lemah. Pembantu itu menerima perenggan daripada manual penyelenggaraan lalu memberikan jawapan ringkas berserta halaman rujukan. Pada komputer riba pembangun, binaan llama.cpp yang baharu bermula seperti biasa dan menghasilkan teks. Pada komputer riba di tapak, pintasan yang disimpan masih menghantar pilihan lama. Di lapisan lain pula, aplikasi mengharapkan medan respons yang tidak diperiksa ketika ujian manual. Ketiga-tiganya dianggap sebahagian daripada naik taraf llama.cpp, tetapi masing-masing bergantung pada antara muka yang berlainan.
Pada 13 November 2026, ggml-org mengeluarkan llama.cpp dan ggml 1.0.0. llama.cpp menjalankan model bahasa dan menyediakan pustaka inferens bernama libllama. ggml pula menyediakan operasi tensor dan bahagian perisian untuk pelbagai perkakasan melalui pustaka libggml. Penyelenggara menyatakan bahawa perubahan yang memutuskan keserasian antara muka C awam akan dicerminkan pada nombor versi utama. Keluaran llama.cpp 1.0.0 sendiri membuang beberapa panggilan yang telah ditandakan lapuk dan satu pilihan baris perintah yang dihentikan. Pengumuman dasar versi oleh penyelenggara pada 13 November · Keluaran llama.cpp 1.0.0 · Keluaran ggml 1.0.0
Sebelum menukar perisian inferens, kenal pasti bentuk penyepaduan anda. Ada aplikasi yang dibina dan dipautkan dengan pustaka C. Ada yang memulakan pelayan HTTP setempat dan menghantar permintaan kepadanya. Ada juga yang mengedarkan perisian tersebut sebagai sebahagian daripada pakej pemasangan. Aplikasi yang sama boleh termasuk dalam lebih daripada satu kumpulan. Setiap kumpulan boleh menjalankan beberapa semakan ringkas yang memberikan asas keputusan lebih kukuh daripada demo yang kebetulan lancar pada komputer pembangun.
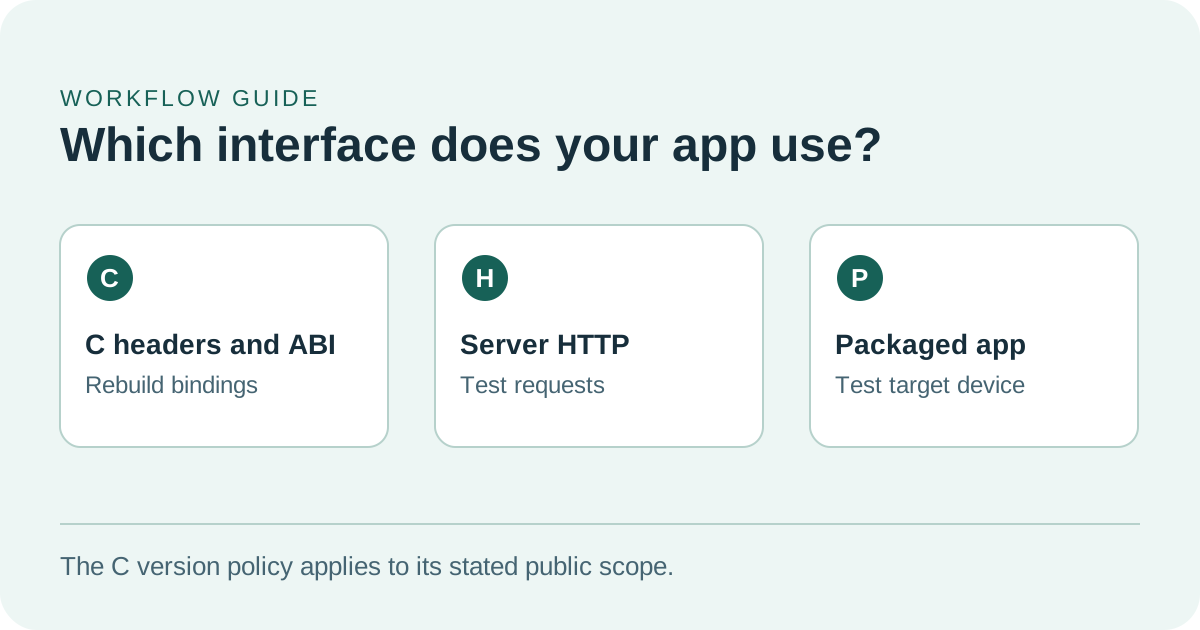
Keserasian C, respons HTTP dan binaan berpakej memerlukan semakan yang berlainan.
Versi 1.0 memberi isyarat yang lebih jelas kepada penyepaduan natif
Fail pengepala C menerangkan cara kod sumber memanggil pustaka: pengkompil dapat mengetahui fungsi dan jenis data yang tersedia. Antara muka binari aplikasi, biasa disebut ABI, menentukan cara kod yang sudah dikompil berhubung dengan pustaka yang juga sudah dikompil. Binaan baharu boleh mendedahkan deklarasi yang sudah dibuang seawal proses kompilasi. Menjalankan aplikasi selepas dipautkan pula menguji kelakuannya dengan pustaka yang terpasang pada komputer sasaran. Aplikasi yang memuatkan sendiri kebergantungan natif wajar menguji kedua-duanya.
Dasar yang diumumkan pada 13 November menetapkan kenaikan versi utama bagi perubahan tidak serasi pada API C awam dalam direktori pengepala projek. Penambahan yang serasi, kemas kini bahagian perkakasan dan sokongan model baharu menggunakan versi kecil. Pembaikan tanpa perubahan API menggunakan versi tampalan. Isyarat itu membantu pembangun pengikatan natif. Pembangun pelancar baris perintah atau klien HTTP masih perlu menguji pilihan dan permintaan yang sudah digunakan pelanggan mereka. Pengumuman dasar versi oleh penyelenggara
Senarai perubahan pada tag memberi contoh yang nyata. Nota llama.cpp 1.0.0 menyenaraikan 35 fungsi lapuk yang dibuang daripada llama.h, di samping menyenaraikan secara berasingan penyingkiran llama_set_warmup dan kawalan penyahserpihan yang ditamatkan. API NextN untuk penyahkodan spekulatif kini berada dalam llama.h, dan terdapat penamaan semula yang berkaitan keadaan. Mulakan dengan panggilan yang digunakan produk anda. Jika pengkompil melaporkan fungsi yang hilang, lihat nota keluaran dan fail pengepala semasa sebelum menentukan pengganti kepada tingkah laku yang bergantung pada fungsi itu. Perubahan API dalam 1.0.0 · Pengepala awam pada tag 1.0.0
Bagi pembantu manual luar talian, ujian asas natif boleh memuatkan fail model yang sudah dikenal pasti, menghantar soalan dengan petikan ringkas, membaca jawapan dan menutup model dengan kemas. Ulang muat dan tutup dalam proses aplikasi yang benar-benar digunakan. Jika ada pengikatan bahasa yang dikompil berasingan, semak binaannya menemui pengepala yang dikehendaki dan versi yang terpasang memuatkan pustaka yang betul. Rekodkan artifak yang digunakan sebelum membaca keputusan. Kompilasi yang lulus dengan satu salinan setempat tidak memberi banyak maklumat tentang salinan berpakej di sebelah aplikasi pada komputer riba di tapak.
Uji bahagian yang sebenarnya diperlukan pengguna
Projek ini turut menyediakan llama-server, proses HTTP dengan argumen baris perintah dan titik akhir yang didokumenkan. Keluaran 1.0.0 menambah titik akhir /v1/audio/speech yang serasi dengan OpenAI, contoh kemampuan pelayan yang boleh berkembang seiring dengan pustaka C. Keluaran sama membuang --defrag-thold. Perkhidmatan berpakej yang masih menggunakan pilihan itu perlu dipindahkan walaupun tidak menggunakan fungsi C secara langsung. Nota keluaran 1.0.0 · Dokumentasi pelayan pada tag 1.0.0
Dokumentasi pelayan mencadangkan semakan kecil yang boleh dijalankan bersama ujian aplikasi. Permintaan kepada /health boleh menerima HTTP 503 ketika model sedang dimuatkan dan menerima 200 apabila model siap. Pasukan yang menggunakan klien HTTP boleh menguji permintaan sembang, pembenaman atau permintaan lain yang benar-benar digunakan dan mengesahkan klien boleh mentafsir respons. Bagi respons berpenstriman, cuba respons ringkas yang tamat seperti biasa dan respons lebih panjang yang dibatalkan oleh pengguna melalui aplikasi. Kejayaan titik akhir mudah tidak menguji butang batal atau penghurai teks. Dokumentasi kesihatan pelayan dan titik akhir v1.0.0
| Kebergantungan aplikasi | Semakan pertama selepas naik taraf | Ujian dalam aliran kerja sebenar |
|---|---|---|
| Pengepala C awam dan pustaka natif | Bina semula dari keadaan bersih dan jalankan dengan pustaka yang dimaksudkan | Muatkan model, buat permintaan ringkas dan lepaskan sumber berulang kali |
| Proses pelayan HTTP setempat | Lancarkan menggunakan tetapan yang disimpan dan tunggu sehingga model sedia | Uji permintaan sebenar, penstriman, pembatalan dan keadaan ralat yang dikendalikan klien |
| Pemasang desktop berpakej atau luar talian | Pasang pada komputer yang mewakili pengguna dan rekod artifak binaan | Buka aplikasi dengan tetapan pengguna sedia ada dan gunakan model setempat yang dikenali daripada binaan terpasang |
| Bahagian perisian bagi perkakasan tertentu | Semak bahagian yang dipilih dan sama ada model muat dalam memori | Bandingkan memori dan masa pada konfigurasi paling perlahan yang dijanjikan sokongan |
Penyepaduan ketiga mempunyai implikasi yang tidak kelihatan dalam senarai ciri pelayan. Contohnya, pakej Windows mungkin memerlukan pustaka untuk perkakasan bersebelahan fail boleh laku, cara yang boleh dipercayai untuk mencari model pengguna dan mesej yang jelas jika fail itu hilang. Komputer pembangun mungkin sudah mempunyai pustaka yang berfungsi daripada pemasangan lain. Menguji pada pemasangan yang mewakili pengguna mendedahkan kebergantungan yang tiada walaupun semuanya berjalan dalam persekitaran pembangunan. Pengumuman 13 November menyenaraikan beberapa kaedah pembungkusan dan platform prakeluaran. Gunakan tag atau binaan pakej yang benar-benar akan diedarkan dan rekod asalnya. Nota pembungkusan oleh penyelenggara
Nombor versi tidak memberitahu bila jawapan manual akan muncul
Bagi pengguna pembantu luar talian, beberapa peringkat dirasakan sebagai satu masa menunggu. Model dimuatkan. Aplikasi memecahkan soalan dan petikan kepada token. Pustaka memproses gesaan, menjana teks dan menghantarnya ke antara muka. Petikan panjang boleh menghabiskan lebih banyak masa pada pemprosesan input, manakala jawapan panjang mengambil lebih banyak masa untuk menjana token. Ukur masa mula, jarak hingga teks pertama kelihatan dan masa keseluruhan secara berasingan jika ketiga-tiganya penting kepada pengguna.
Dokumentasi tag 1.0.0 membezakan tiga mod llama-bench: pemprosesan gesaan, penjanaan teks dan gabungan kedua-duanya. Masa yang dilaporkan tidak termasuk pemecahan token dan pensampelan. Alat itu berguna untuk membandingkan dua binaan di bawah tetapan yang sepadan, tetapi hasilnya berbeza daripada masa menunggu pada antara muka aplikasi. Catat kedua-duanya untuk mengetahui peringkat yang menjadi lebih cekap. Dokumentasi penanda aras pada tag 1.0.0
Gunakan fail model GGUF yang sama untuk kedua-dua binaan. Kekalkan bahagian perisian perkakasan, tetapan konteks dan pemindahan pengiraan yang sama setakat disokong, lalu simpan tetapan dan cincangan fail model. Cuba input ringkas dan satu input sebesar dokumen. Rekod penggunaan memori tertinggi yang boleh diperhatikan semasa permintaan terpanjang yang mewakili penggunaan dan penggunaan stabil selepas model dimuatkan. Model yang bermula pada komputer kosong boleh mencapai had lain apabila pengguna sudah membuka pelayar dan pemapar dokumen.
Keluaran 1.0.0 menyenaraikan pilihan FP8 untuk cache kunci dan nilai inferens, termasuk f8_e4m3, dan cache pakar dalam memori hos yang boleh dilaras untuk model campuran pakar. Pilihan tersebut menambah konfigurasi yang boleh dibandingkan. Jika bahagian perkakasan dan model menyokong tetapan tertentu, ukur kesannya secara berasingan daripada perpindahan ke 1.0. Cuba pada satu komputer yang mewakili penggunaan, jalankan input yang sama dan semak sama ada jawapan memenuhi keperluan aplikasi. Dengan cara itu, perubahan masa atau rujukan halaman yang tertinggal boleh disiasat tanpa meneka perubahan yang menyebabkannya. Perubahan teras keluaran 1.0.0
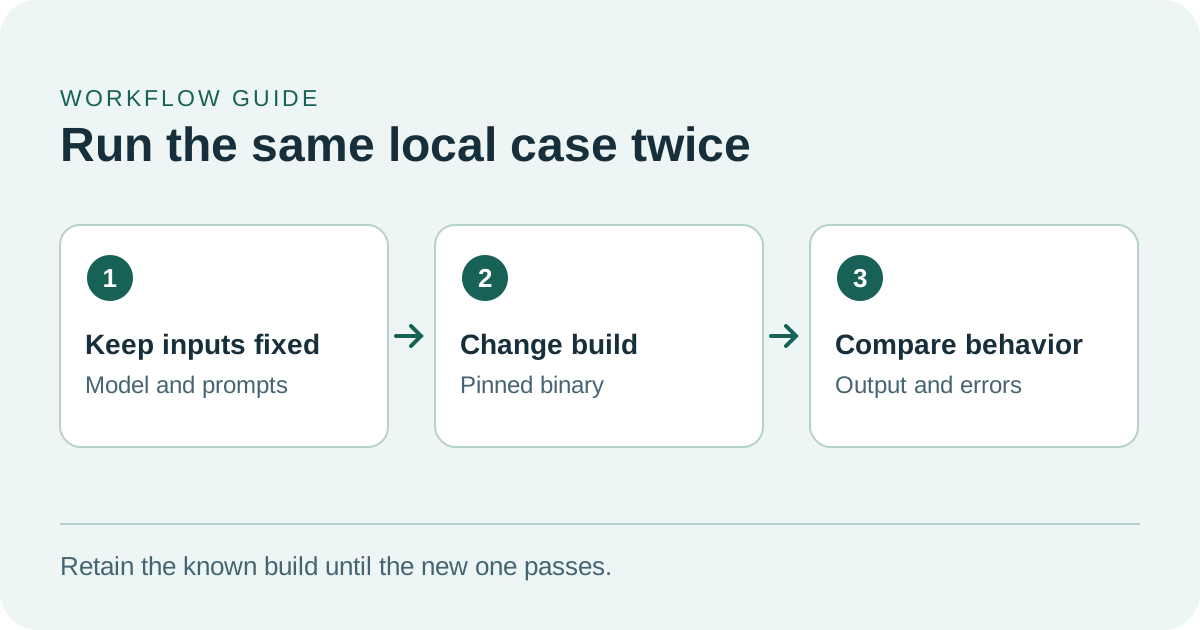
Tetapkan model dan input yang sama supaya kesan naik taraf dapat dikenal pasti.
Latihan perpindahan ringkas memberi asas untuk membuat keputusan
- Pilih dua binaan yang tepat. Simpan binaan yang digunakan sekarang dan calon 1.0.0 di lokasi berasingan. Rekod versi aplikasi, pustaka, model, nilai semak GGUF yang sama bagi setiap percubaan dan bahagian perkakasan. Kekalkan data dan tetapan pengguna semasa menukar binaan.
- Gunakan cara biasa untuk membuka aplikasi. Untuk ujian pelayan pada komputer sendiri sahaja, mulakan dengan
llama-server -m ./handbook-model.gguf --host 127.0.0.1 --port 9931selepas mengganti nama fail dengan model yang telah diluluskan. Jalankan juga perintah yang berada dalam binaan semasa untuk mengesan pilihan yang dihentikan. Semak keadaan sedia dan uji melalui klien sebenar. Persediaan dan pilihan pelayan pada tag - Sediakan beberapa soalan sukar. Cuba petikan ringkas dengan satu jawapan jelas, petikan panjang dengan istilah yang mengelirukan, dan soalan yang tidak terjawab oleh petikan. Tentukan keputusan berguna bagi setiap kes. Pembantu perlu memetik halaman betul jika teks mengandungi jawapan dan memberitahu pengguna apabila bukti tiada. Rekod kegagalan penghurai atau output tidak boleh digunakan berasingan daripada kualiti model.
- Bandingkan satu tetapan prestasi pada satu masa. Pada sebuah komputer yang mewakili pengguna, cuba
llama-bench -m ./handbook-model.gguf -p 512 -n 128 -r 5pada kedua-dua binaan dengan bahagian perkakasan yang sama. Bilangan token dan lima ulangan itu contoh sahaja. Rekod masa mula, memori dan kependaman pada aras aplikasi, serta input sebenar yang lebih panjang sebelum menentukan pengalaman pengguna. Pilihan penanda aras pada tag - Jalankan binaan terpasang dan berlatih untuk kembali. Gunakan calon pada pemasangan bersih yang mewakili pengguna, mulakan semula dan ulang kes terbesar yang disokong. Pastikan kegagalan pelancaran tidak merosakkan tetapan atau fail sedia ada dan versi terdahulu boleh dipulihkan. Simpan bukti yang membantu rakan sepasukan mengetahui bila peluasan edaran patut dihentikan sementara.
Kebanyakan projek hanya memerlukan beberapa kes ujian yang dipilih dengan baik. Apabila petikan panjang mula menjadi perlahan, cari sama ada perbezaannya berlaku sebelum teks pertama muncul, semasa penjanaan atau semasa aplikasi memaparkan hasil. Jika permintaan mula gagal, rekod bentuk permintaan dan klien sebelum menukar gesaan atau model. Jika hanya salinan berpakej bermasalah, bandingkan pemasang dan proses yang dilancarkan dengan salinan pembangun yang berfungsi. Setiap perbandingan awal ini memberi pemilik lapisan berkenaan keadaan yang boleh dihasilkan semula.
Naik taraf yang berjaya patut boleh diulang pada komputer pengguna
Nilai llama.cpp 1.0 ialah menyediakan cara yang lebih jelas untuk mengurus perubahan dalam pustaka yang digunakan banyak aplikasi setempat. Pasukan aplikasi boleh menjawab perubahan itu dengan rekod keserasian ringkas: binaan, model, komputer, permintaan sebenar pengguna dan hasilnya. Apabila versi berikutnya tiba, pasukan boleh bermula daripada perkara yang orang benar-benar perlukan walaupun orang yang menjaga pustaka dan aplikasinya sudah bertukar.
Sumber
- Pengumuman dasar versi dan pengedaran ggml-org, 13 November 2026
- Keluaran llama.cpp 1.0.0, 13 November 2026
- Keluaran ggml 1.0.0
- Pengepala C awam llama.cpp pada tag 1.0.0
- Dokumentasi llama-server pada tag 1.0.0
- Dokumentasi llama-bench pada tag 1.0.0
Untuk menyimpan keputusan naik taraf, nota ujian dan konfigurasi model dalam rekod yang boleh dicari, cipta akaun Telli.sh.