Bisakah aplikasi AI lokal beralih ke llama.cpp 1.0 tanpa mengganggu alur kerja?
llama.cpp 1.0 menandai perubahan yang tidak kompatibel pada antarmuka C publik melalui nomor versi. Uji pustaka, server lokal, dan paket aplikasi sebelum mengganti build yang sudah berjalan.
Sebuah tim teknik kecil membawa asisten dokumen luring ke lokasi dengan koneksi buruk. Asisten mengambil paragraf dari buku pemeliharaan, lalu memberi halaman rujukan dan jawaban singkat. Pada laptop pengembangan, build llama.cpp baru bisa berjalan dan menghasilkan teks. Pada laptop lapangan, peluncur yang tersimpan masih memberikan opsi lama. Di lapisan lain aplikasi mengharapkan kolom respons yang tidak pernah dilihat dalam pemeriksaan manual pengembang. Ketiganya sama-sama disebut peningkatan llama.cpp, tetapi masing-masing bergantung pada antarmuka berbeda.
Pada 13 November 2026, ggml-org merilis llama.cpp dan ggml 1.0.0. Yang pertama menjalankan model bahasa dan menyediakan pustaka inferensi bernama libllama. Yang kedua menyediakan operasi tensor dan backend perangkat keras, dengan pustaka bernama libggml. Pengelola mengumumkan bahwa ketidakcocokan mendatang pada antarmuka C publik ditandai dengan perubahan nomor versi mayor. Rilis llama.cpp 1.0.0 sendiri menghapus pemanggilan yang sudah usang dan satu opsi baris perintah yang dipensiunkan. Pengumuman kebijakan versi dari pengelola, 13 November · Rilis llama.cpp 1.0.0 · Rilis ggml 1.0.0
Sebelum mengganti runtime, kenali jenis integrasi yang dipakai. Sebagian aplikasi dikompilasi dan ditautkan dengan pustaka C. Sebagian menjalankan server HTTP lokal dan mengirim permintaan. Sebagian mendistribusikan runtime sebagai bagian dari aplikasi siap instal. Satu aplikasi bisa masuk lebih dari satu kelompok. Setiap kelompok dapat menjalankan pemeriksaan kecil yang memberi dasar keputusan lebih baik daripada satu demo sukses pada komputer pengembang.
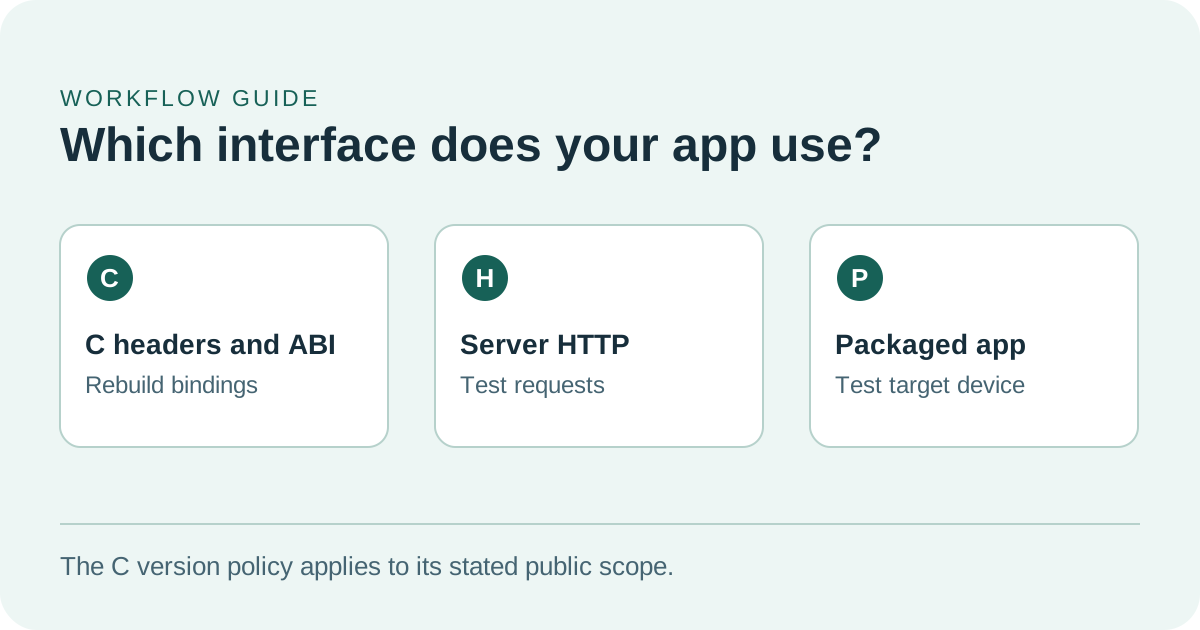
Kompatibilitas C, respons HTTP, dan paket aplikasi memerlukan pemeriksaan berbeda.
Versi 1.0 memberi sinyal lebih jelas untuk integrasi native
Header C mendeskripsikan cara kode sumber memanggil pustaka. Header memberi tahu kompilator fungsi dan tipe data yang tersedia. Antarmuka biner, biasa disebut ABI, mengatur bagaimana kode dan pustaka yang sudah dikompilasi bekerja bersama. Build baru dari awal membantu menemukan deklarasi yang dihapus pada tingkat sumber. Menjalankan aplikasi yang sudah ditautkan menguji perilaku pustaka yang benar-benar terpasang di mesin sasaran. Aplikasi yang memuat dependensi native sendiri perlu keduanya.
Kebijakan 13 November menyebut kenaikan versi mayor bila perubahan C API publik dalam direktori include merusak kompatibilitas. Penambahan yang kompatibel, pembaruan backend, dan dukungan model masuk versi minor. Perbaikan tanpa perubahan API masuk versi patch. Sinyal ini berguna bagi pengelola binding native. Tim yang mendistribusikan peluncur baris perintah atau klien HTTP masih perlu memeriksa opsi dan permintaan yang diandalkan penggunanya. Pengumuman kebijakan versi pengelola
Perubahan yang ditandai dengan tag rilis memberi contoh. Catatan llama.cpp 1.0.0 mencantumkan penghapusan 35 fungsi usang dalam llama.h, selain daftar terpisah untuk penghapusan llama_set_warmup dan kendali defragmentasi yang dipensiunkan. NextN API untuk decoding spekulatif juga pindah ke llama.h, dan ada perubahan nama terkait status. Mulailah dari pemanggilan yang Anda gunakan. Jika kompilator menunjuk fungsi yang hilang, periksa catatan rilis dan header publik terbaru sebelum memutuskan cara mengganti perilaku yang mengandalkannya. Perubahan API 1.0.0 · Header publik pada tag 1.0.0
Untuk asisten buku pemeliharaan luring, uji awal native dapat memuat satu berkas model yang dikenal, mengirim pertanyaan dengan kutipan singkat, membaca jawaban, dan menutup model dengan benar. Ulangi proses muat dan tutup di proses aplikasi yang benar-benar digunakan pengguna. Bila binding bahasa dikompilasi terpisah, pastikan proses build mengambil header yang dimaksud dan runtime terpasang memuat pustaka yang tepat. Catat artefak sebelum membaca hasil. Kompilasi berhasil dengan satu salinan lokal memberi sedikit bukti tentang salinan paket yang berada di samping aplikasi pada laptop lapangan.
Uji bagian yang sungguh diandalkan pengguna
Proyek ini menyediakan llama-server, proses HTTP dengan argumen dan endpoint terdokumentasi sendiri. Rilis 1.0.0 menambahkan endpoint kompatibel OpenAI /v1/audio/speech, contoh kemampuan server yang berkembang bersama pustaka C. Rilis yang sama menghapus --defrag-thold. Layanan dalam paket yang masih memakai opsi itu perlu dimigrasikan walaupun tidak langsung memanggil fungsi C. Catatan rilis 1.0.0 · Dokumentasi server pada tag 1.0.0
Dokumentasi server memberi pemeriksaan kecil yang bisa dilakukan bersama uji aplikasi. Permintaan ke /health bisa menghasilkan HTTP 503 saat model dimuat dan 200 sesudah model siap. Tim yang memakai klien HTTP dapat memeriksa permintaan chat, embedding, atau jenis lain yang dibutuhkan lalu memastikan klien dapat membaca hasil. Untuk fitur streaming, uji respons singkat yang selesai normal dan respons lebih panjang yang dibatalkan lewat aplikasi. Permintaan sederhana yang berhasil belum menguji tombol batal atau parser teks. Dokumentasi status dan endpoint server v1.0.0
| Yang digunakan aplikasi | Pemeriksaan pertama sesudah peningkatan | Yang ditambahkan oleh alur kerja nyata |
|---|---|---|
| Header C publik dan pustaka native | Build ulang dalam lingkungan bersih dan jalankan dengan pustaka yang dimaksud | Muat model, buat permintaan singkat, dan lepaskan sumber dayanya berulang kali |
| Proses server HTTP lokal | Jalankan dengan setelan yang tersimpan dan tunggu sampai model siap | Uji permintaan yang benar-benar dipakai, respons streaming, pembatalan, serta kondisi galat yang ditangani klien |
| Aplikasi desktop atau installer luring yang membundel runtime | Instal di mesin representatif dan catat artefak build | Buka aplikasi dengan setelan pengguna yang ada dan gunakan model lokal yang dikenal dari build terpasang |
| Backend perangkat keras tertentu | Periksa backend terpilih dan apakah model muat di memori | Bandingkan memori dan waktu pada konfigurasi terlambat yang Anda janjikan untuk didukung |
Jenis integrasi ketiga berdampak di luar daftar fitur server. Paket Windows, misalnya, mungkin memerlukan pustaka backend di samping berkas eksekusi, cara andal untuk menemukan model pengguna yang sudah ada, dan pesan jelas saat berkas hilang. Pengembang mungkin sudah memiliki backend yang terpasang terpisah. Mencoba aplikasi baru pada instalasi pengguna yang representatif membantu menemukan dependensi yang hilang karena biasanya disediakan lingkungan pengembangan. Pengumuman 13 November mencantumkan beberapa metode pengemasan dan platform prarilis. Gunakan tag atau build paket yang persis akan didistribusikan dan catat asalnya. Catatan pengemasan dari pengelola
Nomor rilis tidak memberi tahu kapan jawaban dari buku panduan muncul
Pengguna asisten luring merasakan beberapa tahap sebagai satu waktu tunggu. Model dimuat. Aplikasi melakukan tokenisasi pertanyaan dan kutipan dokumen. Runtime memproses prompt, mulai menghasilkan teks, dan mengirimkannya ke antarmuka. Kutipan manual yang panjang dapat menghabiskan sebagian besar waktu untuk memproses input, sedangkan jawaban yang sengaja panjang dapat menghabiskan lebih banyak waktu untuk generasi token. Ukur waktu mulai, waktu sampai teks pertama terlihat, dan waktu hingga selesai secara terpisah jika tiap tahap penting bagi pengguna.
Dokumentasi tag 1.0.0 membedakan tiga mode pada llama-bench, yakni pemrosesan prompt, pembuatan teks, dan gabungan. Durasi yang dilaporkan tidak mencakup tokenisasi dan sampling. Alat ini berguna membandingkan dua build dengan pengaturan sama; hasilnya bisa berbeda dari waktu tunggu yang diukur di antarmuka. Catat keduanya bila ingin mengetahui tahap mana yang membaik. Dokumentasi benchmark pada tag 1.0.0
Mulailah dengan berkas model GGUF yang sama pada kedua build. Samakan backend perangkat keras, pengaturan konteks, dan pilihan offload yang didukung keduanya. Simpan pengaturan yang digunakan beserta hash model. Coba input pendek dan input sepanjang dokumen. Saat mengukur memori, catat puncak yang terlihat pada permintaan representatif terpanjang dan pemakaian stabil setelah model dimuat. Model yang mulai pada laptop kosong bisa menghadapi batas lain saat pengguna sudah membuka peramban dan penampil dokumen.
Rilis 1.0.0 mencantumkan opsi FP8 untuk cache key-value yang dipakai saat inferensi, termasuk f8_e4m3, serta cache expert di memori host yang dapat diatur untuk model mixture-of-experts. Kemampuan ini memberi konfigurasi tambahan untuk dibandingkan. Jika backend dan model mendukungnya, ukur pengaruhnya terpisah dari migrasi 1.0. Terapkan pada satu mesin yang representatif, jalankan ulang input yang sama, dan periksa apakah jawaban tetap memenuhi kebutuhan aplikasi. Dengan begitu, perubahan waktu atau rujukan yang hilang dapat diselidiki tanpa menebak perubahan penyebabnya. Perubahan inti pada rilis 1.0.0
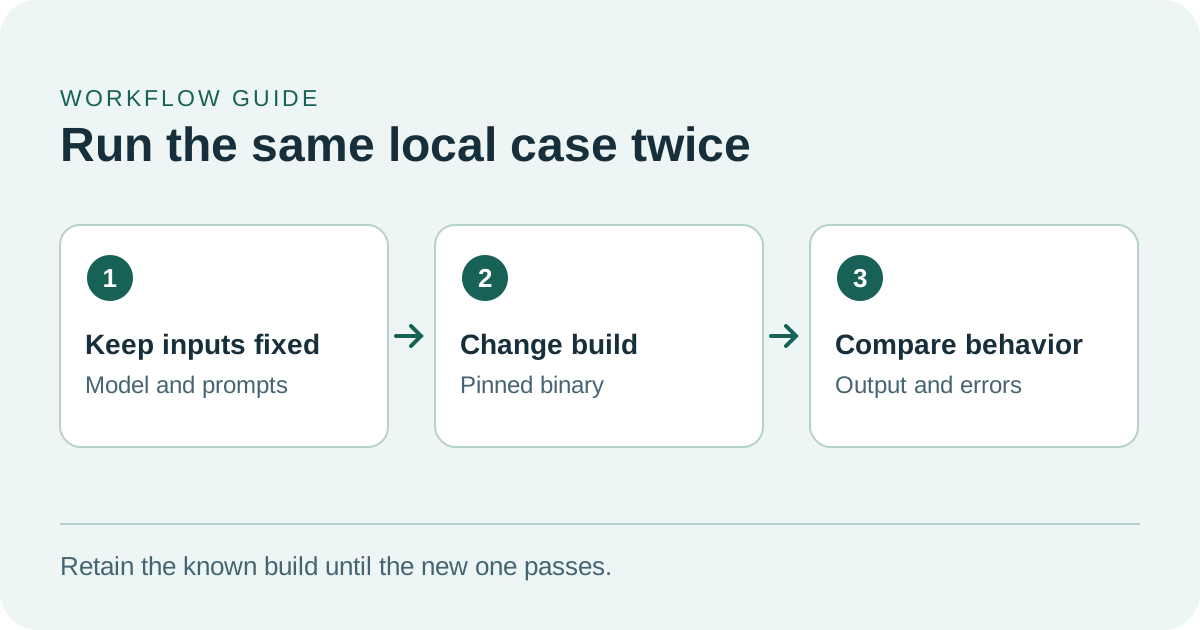
Gunakan model dan input yang sama agar selisih dapat dikaitkan dengan peningkatan.
Latihan migrasi kecil memberi bukti untuk keputusan rilis
- Pilih dua build yang pasti. Simpan build yang sedang dikirim dan kandidat 1.0.0 di tempat terpisah. Catat versi aplikasi, runtime, dan model, checksum GGUF yang sama untuk setiap putaran, serta backend perangkat keras. Jaga data pengguna dan pengaturan aplikasi saat mengganti build.
- Gunakan cara membuka aplikasi yang biasa. Untuk uji server yang hanya memakai loopback,
llama-server -m ./handbook-model.gguf --host 127.0.0.1 --port 9931dapat menjadi titik awal setelah disesuaikan dengan berkas model yang disetujui. Jalankan perintah versi yang sudah dipakai untuk menemukan opsi yang dihentikan. Periksa status siap dan uji melalui klien yang biasanya dibuka pengguna. Penyiapan dan opsi server di tag rilis - Siapkan beberapa pertanyaan sulit. Coba kutipan pendek dengan satu jawaban jelas, kutipan lebih panjang dengan istilah mirip, dan pertanyaan yang tidak dijawab oleh kutipan. Tentukan hasil yang berguna untuk tiap kasus. Asisten perlu merujuk halaman yang tepat saat teks punya jawabannya dan menyebut jika bukti tidak cukup. Catat kesalahan parsing dan keluaran tak berguna secara terpisah dari mutu model.
- Bandingkan satu pengaturan performa pada satu waktu. Di mesin representatif, titik awalnya bisa
llama-bench -m ./handbook-model.gguf -p 512 -n 128 -r 5per build dengan backend yang sama. Jumlah token dan lima pengulangan hanya contoh. Ukur pula startup aplikasi, memori, latensi, dan input nyata yang lebih panjang sebelum menarik kesimpulan untuk pengguna. Opsi benchmark pada tag rilis - Jalankan build terpasang dan latih pemulihan. Pakai kandidat pada instalasi bersih yang representatif, mulai ulang, dan ulangi kasus terbesar yang didukung. Periksa apakah kegagalan membuka tetap menyisakan pengaturan dan berkas yang dapat digunakan, serta apakah Anda dapat kembali ke versi aplikasi sebelumnya. Simpan bukti yang membantu rekan memutuskan kapan peluncuran lebih luas perlu ditunda.
Kebanyakan proyek cukup memiliki sedikit contoh yang terpilih baik untuk menemukan kegagalan berikutnya. Jika kutipan panjang menjadi lambat, cek apakah selisih muncul sebelum teks pertama, saat generasi, atau pada tampilan aplikasi. Jika suatu permintaan mulai gagal setelah perubahan, catat bentuk permintaan dan klien pemicunya sebelum memperbarui prompt atau model. Jika kegagalan hanya terjadi pada versi paket, bandingkan installer dan proses yang dijalankan dengan versi pengembang yang berhasil. Perbandingan awal ini memberi setiap pemilik lapisan kasus konkret yang bisa diulang.
Peningkatan yang berhasil bisa diulang pada mesin yang membutuhkannya
Nilai llama.cpp 1.0 ada pada cara yang lebih jelas menangani perubahan runtime yang banyak alat lokal andalkan. Tim aplikasi bisa menyimpan catatan kompatibilitas ringkas berisi build, model, mesin, permintaan yang digunakan pengguna, dan hasilnya. Dengan demikian versi berikutnya dimulai dengan menguji alur yang diandalkan orang walaupun pengelola runtime atau aplikasi sudah berganti.
Sumber
- Pengumuman kebijakan versi dan distribusi ggml-org, 13 November 2026
- Rilis llama.cpp 1.0.0, 13 November 2026
- Rilis ggml 1.0.0
- Header C publik llama.cpp pada tag 1.0.0
- Dokumentasi llama-server pada tag 1.0.0
- Dokumentasi llama-bench pada tag 1.0.0
Untuk menyimpan keputusan peningkatan, catatan uji, dan pengaturan model agar dapat dicari, buat akun Telli.sh.