Bisakah komputer Anda sendiri menangani takarir dan narasi?
llama.cpp 0.9.0 menambahkan tiga kemampuan audio. Uji transkripsi luring, label pembicara, dan narasi dengan suara bawaan pada perangkat yang sudah Anda gunakan.
Anda punya suntingan kasar demo produk, rekaman dua rekan yang berbicara di atasnya, dan tiga baris narasi yang harus dibuat ulang. Mengirim rekaman ke layanan transkripsi dan naskah ke layanan suara sudah biasa. Menjalankan keduanya di komputer penyuntingan bisa memudahkan revisi berulang, terutama jika materi sumber harus tetap di perangkat itu. Penyunting kini juga bertanggung jawab atas antrean, berkas model, dan pemeriksaan kualitas.
Pada 4 November 2026, proyek inferensi sumber terbuka llama.cpp merilis versi 0.9.0. Rilis ini menambahkan dukungan transkripsi luring dengan NVIDIA Nemotron 3.5 Transcribe, sintesis suara dengan Chatterbox, dan pilihan suara bawaan Pocket TTS tanpa rekaman referensi. Catatan rilis menyebut transkripsi dalam 40 bahasa, konteks melalui prompt, dan pelabelan pembicara. Semua perubahan itu berguna dalam satu alur penyuntingan, dengan kebutuhan yang berbeda bagi komputer dan orang yang meninjau hasilnya. Catatan rilis llama.cpp v0.9.0
Jika mengenal llama.cpp saat mencoba chatbot lokal, namanya bisa membuat rilis ini terdengar lebih terbatas daripada sebenarnya. Ini adalah lingkungan inferensi yang menjalankan arsitektur model yang didukung, dengan alat untuk memuat berkas model yang kompatibel dan melayani permintaan. Pembaruan ini memperluas apa yang bisa dijalankan lewat perangkat tersebut. Aplikasi di sekitarnya tetap menentukan tempat menyimpan audio, cara menampilkan koreksi, dan kapan berkas siap diterbitkan. Proyek llama.cpp
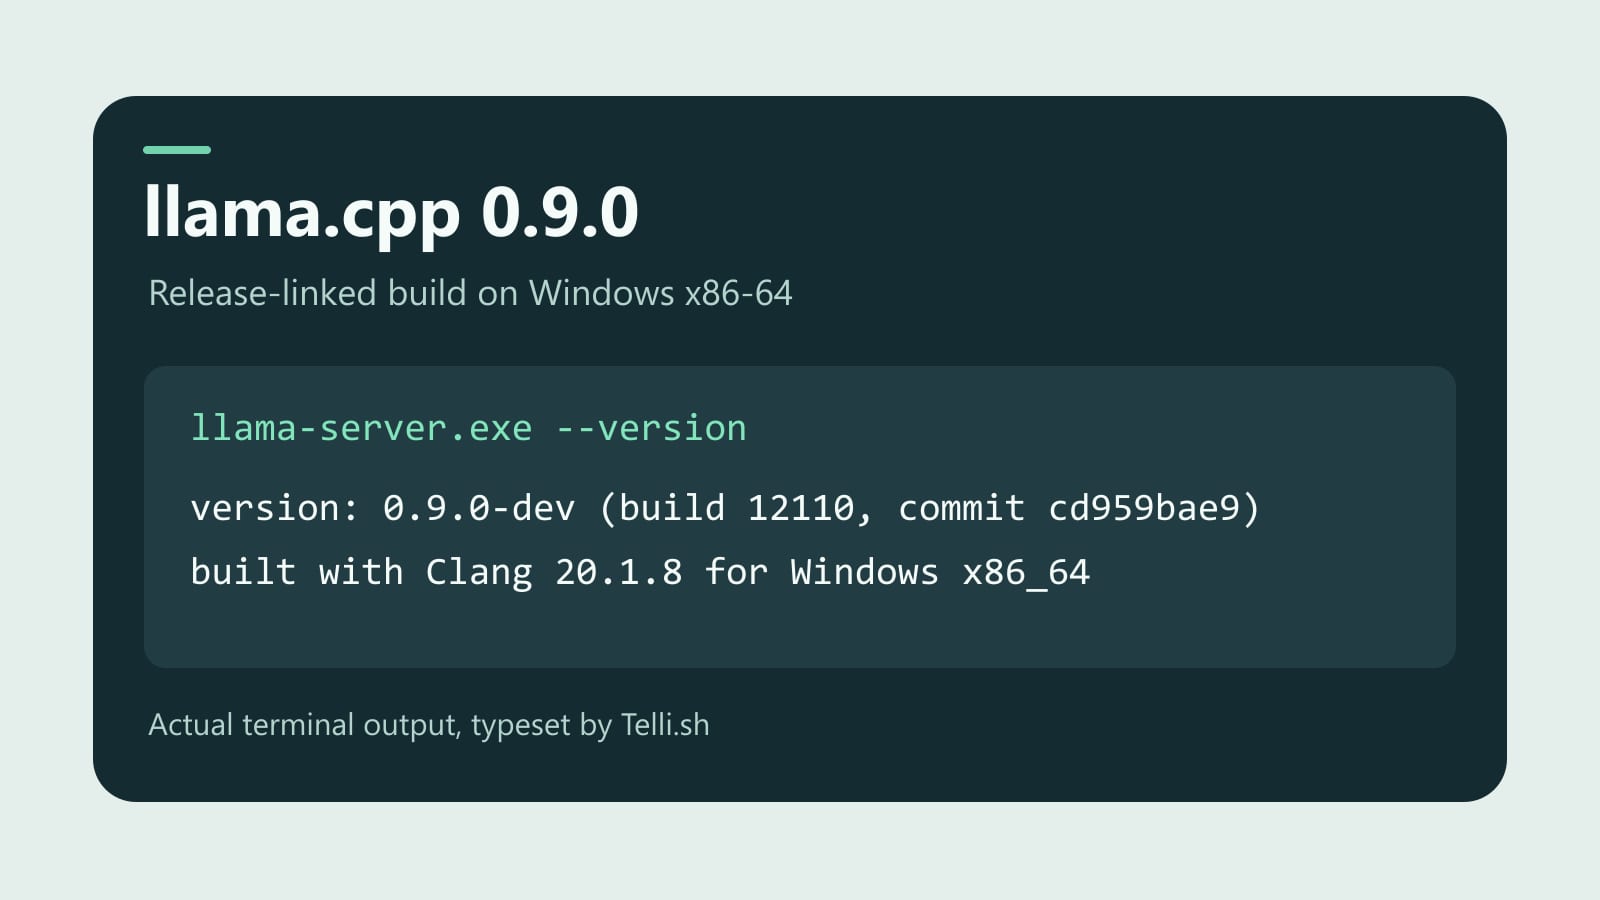
Telli.sh menjalankan build Windows resmi yang ditautkan dari rilis dan menyajikan keluaran versi sebenarnya. Gambar ini mengonfirmasi identitas build. Build b12110 dari rilis
Takarir dimulai dari transkrip yang bisa disunting
Bayangkan seorang rekan merekam panduan sepuluh menit untuk produk yang belum dirilis. Rekan lain menyela untuk mengoreksi nama fitur. Anda membutuhkan transkrip yang bisa ditelusuri, pemisahan kasar siapa mengatakan apa, dan takarir yang muncul pada bingkai yang tepat. Itu tiga keluaran berbeda. Yang pertama berupa teks, yang kedua anotasi editorial, dan yang ketiga memerlukan pengaturan waktu.
Integrasi Nemotron membantu memulai dua pekerjaan pertama. Implementasi yang digabungkan mendukung transkripsi luring dengan konteks opsional dan pelabelan pembicara. Informasi pembicara dapat dipertahankan ketika rekaman diolah per segmen. Catatan pengelola menyebut penanda waktu tiap kata dan streaming berada di luar cakupan integrasi. Alur praktisnya adalah menyalin rekaman yang sudah selesai, memperbaiki teks, lalu menyelaraskan waktu pada tahap penyuntingan atau pembuatan takarir jika dibutuhkan. Integrasi Nemotron 3.5 Transcribe
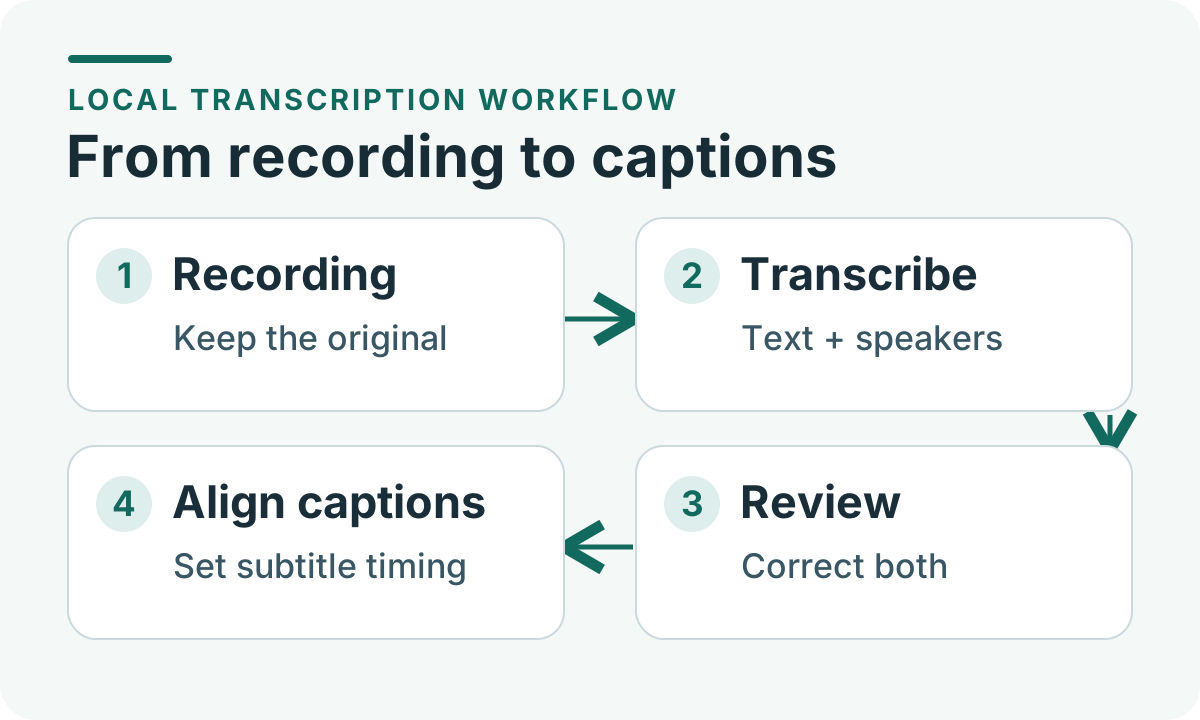
Ilustrasi Telli.sh. Transkrip lokal memberi bahan untuk disunting. Selaraskan takarir setelah teks dan label pembicara diperiksa.
Konteks dalam prompt berguna bagi tim yang memakai istilah jarang terdengar dalam percakapan sehari-hari. Untuk rekaman tentang fitur fiktif Pine Relay, coba daftar pendek nama dan singkatan yang diperkirakan akan disebut, lalu jalankan klip yang sama tanpa daftar. Hitung apakah konteks tambahan memperbaiki nama, menyisipkannya ketika tidak diucapkan, atau mengubah angka dan kata yang tak berkaitan. Jaga daftar cukup ringkas agar pengaruh setiap entri bisa dijelaskan. Asisten transkripsi perlu memudahkan peninjauan kata asing sambil menjaga isi rekaman tetap setia.
Pelabelan pembicara perlu diperiksa sendiri. Dua pembicara dalam wawancara jernih mungkin mudah dibedakan. Tambahkan pembicara ketiga lewat telepon pengeras suara dan beberapa kalimat yang bertumpang tindih, lalu beban koreksinya bisa berubah. Dengarkan perpindahan pembicara serta giliran terpanjang masing-masing. Transkrip bisa memiliki semua kata yang benar tetapi mengaitkan keputusan penting dengan orang yang salah. Pisahkan label buatan model dari nama yang diberikan manusia sampai seseorang yang mengenal rekamannya mengonfirmasi.
Untuk takarir, cocokkan ekspor dengan video. Kalimat yang terlihat baik di dokumen bisa melampaui layar, muncul sebelum pengungkapan penting, atau tetap terlihat ketika pembicara berikutnya sudah mulai. Coba potongan adegan yang mendadak dan selaan singkat pada awal klip. Jika berkas takarir membutuhkan waktu yang andal, masukkan penyelarasan dan koreksi ke dalam perkiraan waktu. Transkrip awal yang bersih tetap berguna meski suntingan akhir dirakit di tempat lain.
Suara bawaan cocok untuk uji pertama
Pertimbangkan bagian lain dari suntingan kasar. Nama fitur berubah sehingga satu baris narasi perlu diganti pada enam rekaman layar. Membuat versi baru secara lokal menjadi percobaan murah setelah model dan perangkat siap. Bagian sulitnya ialah konsistensi dan pengucapan. Audio baru perlu terdengar wajar di antara klip lain, melafalkan nama produk dengan benar, dan sesuai dengan adegannya.
Versi 0.9.0 memasukkan Chatterbox ke model sintesis suara yang didukung llama.cpp. Peninjauan proyek melaporkan uji CUDA untuk Chatterbox Turbo dan Multilingual V3. Peninjau mencoba suara bawaan dan sintesis berbasis referensi serta melampirkan contoh hasilnya. Itu merupakan bukti dari peninjauan integrasi pada konfigurasi tertentu. Langkah berikutnya untuk produksi ialah memeriksa konsistensi suara dan bahasa pada teks serta perangkat yang akan dipakai. Dukungan Chatterbox dan contoh audio pengelola
Pocket TTS memberi pilihan lain. Model yang kompatibel dapat menampilkan nama suara bawaan di bawah voices dalam respons GET /props dari server. Klien dapat meneruskan salah satu nama itu ke rute sintesis suara. Skrip atau aplikasi kecil pun bisa mengisi pemilih suara dari model yang dimuat. Uji pertama dapat memakai suara bawaan tanpa mencari dan menyimpan rekaman seseorang untuk ditiru. Simpan model dan nama suara yang dipilih dalam catatan ekspor agar suntingan berikutnya bisa dimulai dari konfigurasi yang sama. Dukungan suara bawaan Pocket TTS
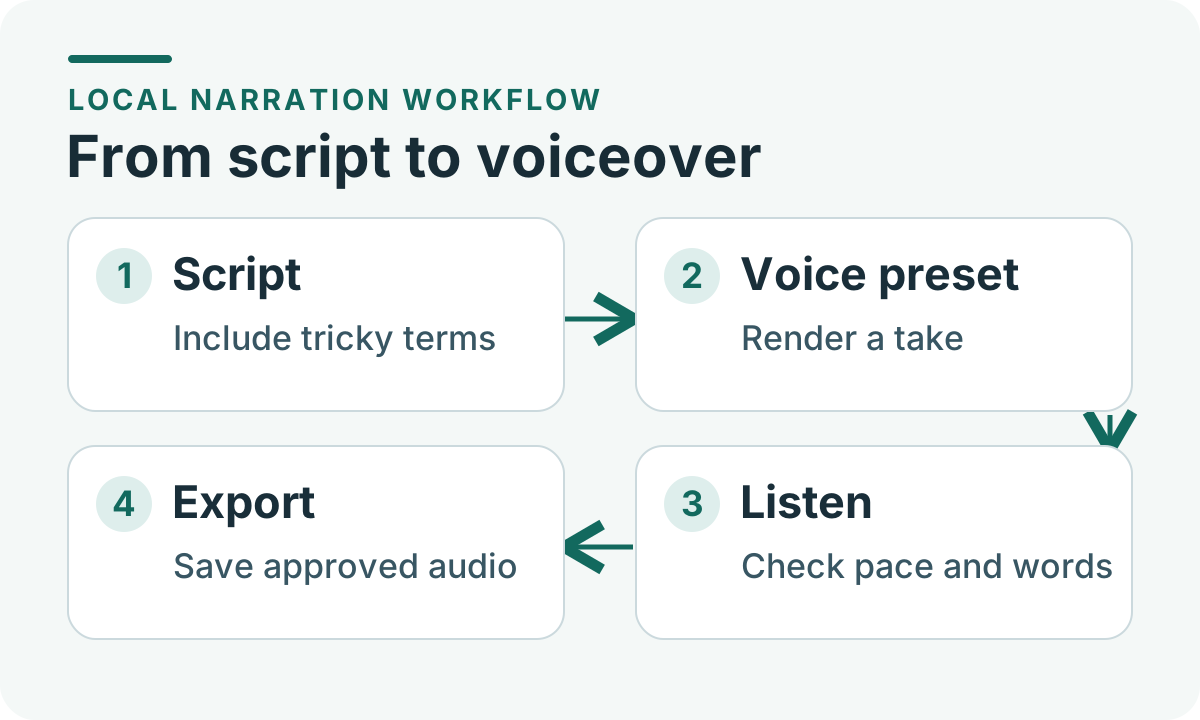
Ilustrasi Telli.sh. Dengarkan audionya sebelum mengekspor. Pilihan suara mencatat apa yang diminta, sedangkan pemeriksaan dengar mengungkap hasilnya.
Mulailah dengan naskah pendek berisi istilah yang biasanya dilewati oleh demo. Tambahkan kode produk, format alamat atau angka dengan satuan, serta kalimat yang nadanya penting. Coba tiga baris terpisah lalu buat audio untuk seluruh paragraf. Suara bisa terdengar konsisten pada kalimat lepas tetapi terlalu cepat saat melafalkan kata penting dalam bacaan panjang. Minta orang yang mengenal bahasa audiens mendengarkan tanpa naskah terlebih dahulu, lalu bandingkan yang ia dengar dengan teks tujuan.
Simpan audio akhir terpisah dari naskah masukan dan rekaman sumber. Jika kemudian menemukan angka yang salah diucapkan, Anda bisa memperbaiki bagian itu tanpa kehilangan suntingan asli. Untuk proyek yang sudah memiliki pengisi suara manusia dengan izin, beri label yang jelas pada rekamannya dan alternatif hasil model agar keduanya tidak tertukar. Suara bawaan adalah pilihan sederhana jika proyek hanya membutuhkan suara yang jelas dan konsisten.
Versi runtime hanya salah satu bagian konfigurasi
Jika tim sudah memakai llama.cpp, rilis ini dapat mengurangi alasan untuk pindah lingkungan inferensi. Tetap dibutuhkan build untuk perangkat sasaran, berkas model yang tepat, dan berkas pendamping khusus seperti proyektor multimodal yang disebut dalam integrasi Nemotron. Bobot model diunduh terpisah dan memiliki ketentuan tersendiri. Periksa dokumentasi runtime dan model sebelum mengemas bagian apa pun untuk tim atau klien lain. Artefak rilis dan Catatan penyiapan integrasi Nemotron
Ukur memori saat pekerjaan berjalan, setelah model selesai dimuat. Ukuran berkas hanya menunjukkan ruang yang ditempati di penyimpanan. Inferensi juga memerlukan ruang untuk eksekusi model, buffer backend, dan pemrosesan antara. Komputer yang berhasil memulai transkripsi masih bisa memperlambat editor saat keduanya memakai GPU. Laptop yang lancar sekali bisa melambat pada percobaan keempat ketika pendinginan dan pekerjaan latar berpengaruh. Catat puncak RAM dan, jika sesuai, memori GPU ketika editor terbuka dalam konfigurasi yang benar-benar akan dipakai.
Pengelola membagikan validasi transkripsi dalam pull request Nemotron, termasuk data ucapan bersih dan rapat, dengan konfigurasi kuantisasi tertentu serta RTX PRO 6000 Blackwell. Hasil itu menjelaskan cara integrasi diperiksa. Untuk keputusan pembelian atau penerapan, ukur rekaman Anda pada perangkat yang dituju. Bahkan dengan perangkat sama, perubahan presisi, bahasa, atau tingkat tumpang tindih ucapan bisa mengubah waktu eksekusi dan beban peninjauan. Validasi dan penyiapan Nemotron
Sederhanakan perbandingan versi. b12144 pada 6 November adalah prarilis tersendiri dengan perubahan tata letak CUDA untuk mixture-of-experts. Untuk menilai penambahan audio, mulai dari rilis bernomor 4 November dan pertahankan berkas serta setelan model. Jika nanti menilai prarilis, catat sebagai percobaan terpisah. Dengan begitu, perubahan dapat ditelusuri ke model audio, backend inferensi, atau aplikasi di sekitarnya. Catatan prarilis 6 November
Pemrosesan lokal juga perlu definisi yang tepat tentang apa yang tetap berada di perangkat. Jika alur desktop memanggil server lokal, aplikasi lain masih bisa mengirim log, menyinkronkan folder keluaran, atau mengambil dependensi. Sebelum memasukkan rekaman sensitif, siapkan biner dan bobot menggunakan komputer uji atau tahap penyiapan khusus. Lalu gunakan klip yang aman saat luring untuk melihat bagian mana yang selesai. Periksa lokasi berkas asli, data sementara, dan ekspor akhir. Runtime lokal membantu membatasi inferensi, sementara aplikasi lain menentukan jalur data keseluruhan.
Coba satu proyek di komputer yang benar-benar digunakan
- Pilih dua masukan singkat yang aman dibagikan. Rekam 30 hingga 60 detik bersama dua orang, dengan sedikit ucapan tumpang tindih dan nama fitur rekaan. Tulis narasi singkat dengan nama yang sama dan satu angka yang sulit. Pertahankan masukan agar dampak perubahan setelan dapat terlihat.
- Tetapkan versi runtime dan model. Pilih sumber v0.9.0 atau build b12110 yang ditautkan untuk sistem Anda. Catat sumber model, nama berkas, dan kuantisasi. Untuk Nemotron lewat
llama-server, catatan integrasi mendokumentasikan--reasoning offkarena templat bawaan dapat mengembalikan penalaran tanpa transkrip. CLI multimodal tidak memerlukan opsi itu. Uji jalur yang memang akan digunakan. Catatan integrasi Nemotron - Ukur eksekusi awal dan ulangi. Catat waktu dari peluncuran hingga hasil pertama serta waktu untuk mendapat hasil setelah model dimuat. Untuk transkripsi, bagi waktu pemrosesan dengan durasi audio untuk memperkirakan lamanya menunggu rekaman panjang. Catat puncak memori dan respons editor. Untuk narasi, waktu dari mengubah satu baris sampai mendengar hasil baru mungkin lebih penting.
- Bandingkan kesalahan menurut biaya koreksinya. Tandai istilah yang terlewat, angka salah, pertukaran pembicara, dan kalimat yang waktunya perlu diatur ulang. Hitung waktu koreksi dalam waktu pengerjaan. Untuk narasi, periksa nama, angka, jeda, dan kesesuaian dengan potongan video. Bandingkan artefak yang sudah diperbaiki selain berkas pertama.
- Tetapkan serah terima sebelum mengotomatisasi. Tentukan siapa yang memeriksa transkrip, di mana takarir diselaraskan, dan bagaimana narasi yang disetujui ditandai. Coba klip kedua setelah yang pertama lolos. Jika berkas gagal, pertahankan masukan dan tampilkan kegagalan pada antrean penyuntingan agar orang bisa menanganinya tanpa mengulang seluruh batch.
Catat pemeriksaan dalam empat kolom spreadsheet: konfigurasi, waktu pemrosesan, waktu koreksi, dan penerimaan. Simpan alasan jika hasil ditolak. Setelah beberapa percobaan, lingkungan lokal mungkin unggul untuk revisi narasi, sementara wawancara kelompok yang bising masih membutuhkan alur berbeda. Itu hasil yang berguna. Pakai tiap komponen di tempat yang menghemat waktu dan catat kapan pilihan cadangan bekerja lebih baik.
Jika sudah memiliki alur transkripsi yang baik, bandingkan dengan rekaman dan kriteria penerimaan yang sama. Anda bisa memindahkan bagian termudah saja, seperti membuat narasi sementara berisiko rendah di komputer kerja. Sebaliknya, alur takarir yang andal bisa memperoleh manfaat dari integrasi lokal bersama di kemudian hari, ketika ada alasan menyatukan layanan model dan implementasi baru sudah memenuhi standar editorial yang berlaku.
Di mana rilis ini paling berguna
Gunakan lebih dahulu untuk pekerjaan berulang. Tim tutorial dapat menyalin rekaman kasar sebelum video meninggalkan komputer penyuntingan dan membuat narasi sementara untuk memeriksa tempo. Peneliti bisa membuat transkrip dari rekaman yang dikuasainya, memperbaiki label pembicara, dan mempertahankan audio sumber. Tim pengembang kecil bisa menguji kedua jalur lewat antarmuka internal yang menampilkan model terpilih, hasil, dan kesalahan.
Rilis ini berpotensi mengurangi perpindahan antaralat khusus sambil menjaga pemeriksaan masing-masing. Model transkripsi perlu mengenali kata dan membedakan pembicara. Model sintesis perlu mengucapkan naskah dengan tepat. Penyunting menentukan kapan hasilnya siap. Ketiga pekerjaan itu kini dapat berbagi perangkat inferensi dan mungkin komputer yang sudah Anda gunakan.
Untuk membuka kembali rekaman yang selesai bersama transkrip dan catatannya, mulai unggahan di Telli.sh.