Liquid LFM3 ชวนถามให้ตรงจุด: โมเดลเล็กตัวไหนเหมาะกับงาน AI บนอุปกรณ์
LFM3 แตกแขนงจากรากฐานร่วมไปสู่โมเดลข้อความ ภาพ เสียง หลายสื่อ และการตัดสินใจ เรียนรู้การเลือกผู้เชี่ยวชาญ วางงบหน่วยความจำจริง และประเมินบนอุปกรณ์ของคุณ
ผู้ช่วยบนอุปกรณ์ที่อ่านใบเสร็จไม่จำเป็นต้องใช้โมเดลเดียวกับผู้ช่วยตอบคำถามด้วยเสียง โปรแกรมที่เลือกจากการกระทำที่อนุญาตสามอย่างก็มีงานอีกแบบ การมองทั้งหมดเป็นงานเดียวอาจทำให้แอปเล็กซับซ้อนเกินจำเป็น
Liquid AI ประกาศ LFM3 เมื่อวันที่ 27 ตุลาคม 2026 เป็นโมเดลระดับประมาณ 2B หกตัวที่แตกแขนงจากรากฐานร่วมขนาด 1.7B ครอบคลุมข้อความ ภาพ เสียง หลายสื่อ และโมเดลตัดสินใจสองแบบ บริษัทเปิดให้ดาวน์โหลดน้ำหนักโมเดล ใช้ Playground และเข้าถึง API ประกาศ LFM3
การตัดสินใจที่น่าสนใจคือบทบาทใดเหมาะกับแอปของคุณ บทความนี้อธิบายตระกูลโมเดลผ่านตัวเลือกที่ใช้ได้จริง แยกไฟล์น้ำหนักขนาดเล็กออกจากงบหน่วยความจำขณะทำงาน และเสนอการประเมินแรกเพื่อดูว่าโมเดลเฉพาะทางมีประโยชน์บนฮาร์ดแวร์ของคุณหรือไม่
 ฮาร์ดแวร์ Raspberry Pi 5 ใช้ประกอบบริบทการประมวลผลปลายทาง ไม่ใช่การทดสอบ LFM3 ของเรา ภาพ: RetroEditor, CC BY 4.0; ปรับขนาดพร้อมเพิ่มขอบ แหล่งภาพ · ใบอนุญาตและหมายเหตุภาพ ข้อมูลผลิตภัณฑ์ทางการ

การเลือกตระกูลโมเดลเฉพาะทางเริ่มจากผลลัพธ์ที่ต้องการ
วิธีเลือกผิดได้เร็วที่สุดคือเริ่มจากรายการอินพุตที่รองรับยาวที่สุด ควรเริ่มจากผลลัพธ์ที่แอปต้องสร้าง ย่อหน้า ข้อความถอดเสียง ฟิลด์ที่มีโครงสร้าง และการเลือกการกระทำที่อนุญาต เป็นสัญญาการทำงานคนละแบบ แม้จะใช้ข้อมูลต้นทางเดียวกันช่วยสร้างทั้งสี่อย่างได้
ประกาศวันที่ 27 ตุลาคมของ Liquid ระบุสี่แขนงตามรูปแบบสื่อและสองแขนงการตัดสินใจ ได้แก่ LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B และ d1-Omni-2B ตารางต่อไปแปลงบทบาทเป็นคำถามเลือกโมเดลให้แอป เป็นแนวทางความเหมาะสม ไม่ใช่การจัดอันดับคุณภาพโดยอิสระ คำอธิบายตระกูลโมเดล
| บทบาทโมเดล | ตัวเลือกในตระกูล LFM3 | คำถามสำหรับแอปของคุณ |
|---|---|---|
| ปฏิสัมพันธ์ด้วยข้อความ | LFM3-1.7B | งานต้องสร้างภาษาจากข้อความหรือไม่ |
| ความเข้าใจภาพและข้อความ | LFM3-VL-2B | คำตอบขึ้นกับสิ่งที่มองเห็นหรือไม่ |
| ปฏิสัมพันธ์ด้านเสียงพูดและเสียง | LFM3-Audio-2B | แอปต้องฟังหรือพูดหรือไม่ |
| ปฏิสัมพันธ์รวมภาพและเสียง | LFM3-Omni-2B | ต้องตีความภาพกับเสียงร่วมกันหรือไม่ |
| การตัดสินใจแบบมีโครงสร้างจากข้อความและภาพ | d1-2B | แสดงผลเป็นการตัดสินใจที่กำหนดชนิดข้อมูลได้หรือไม่ |
| การตัดสินใจแบบมีโครงสร้างที่รวมเสียง | d1-Omni-2B | การตัดสินใจในขอบเขตต้องใช้เสียงด้วยหรือไม่ |
มุมมองของเรา: หน่วยที่มีประโยชน์ของ AI บนอุปกรณ์คือ งานสมบูรณ์ที่เล็กที่สุด โมเดลควรมีความสามารถพอตอบสัญญาของแอปที่ชัดเจน พร้อมวิธีรับมือความไม่แน่นอน ส่วนที่เกินจากนั้นมีต้นทุนการทำงาน การทดสอบ และการเชื่อมต่อที่ต้องพิสูจน์คุณค่า
นึกถึงตระกูลนี้เป็นม้วนเก็บเครื่องมือ บางงานควรพกทุกชิ้น แต่สำหรับการปรับแบบเดิมซ้ำ ๆ การเลือกชิ้นที่เหมาะอาจง่ายกว่า การเปรียบนี้พูดถึงการออกแบบแอป ไม่ใช่กล่าวว่าโมเดลหนึ่งชนะอีกโมเดลเสมอ
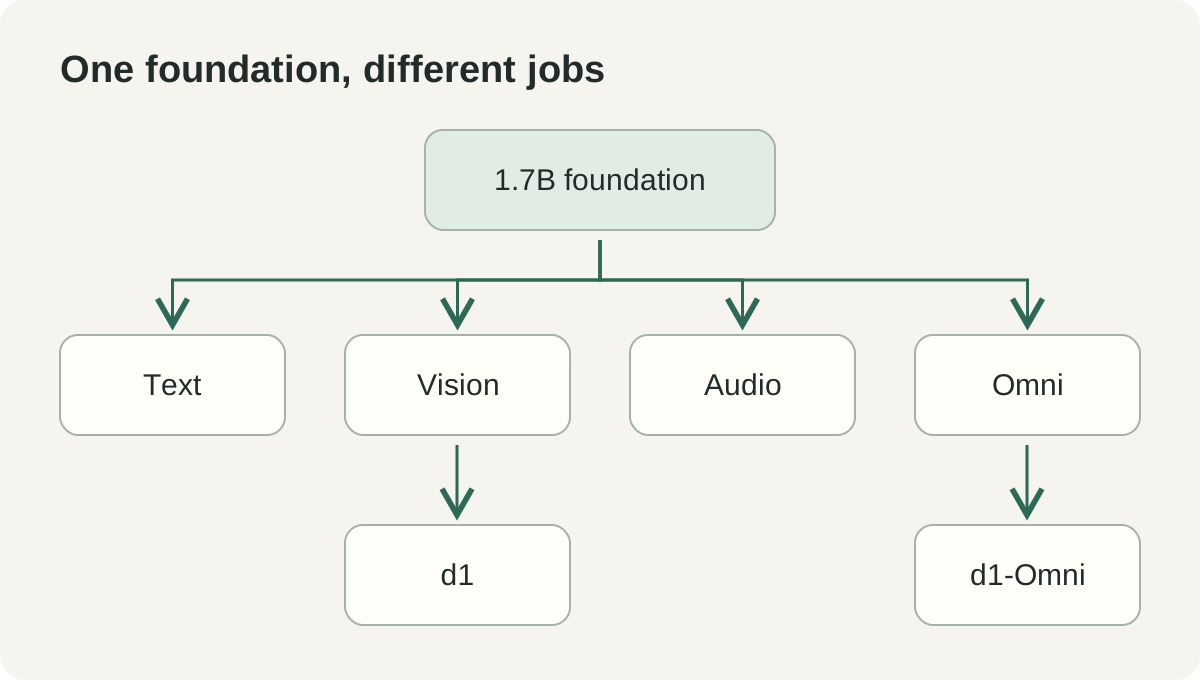 แผนภาพอธิบายบทบาทที่ระบุใน ประกาศ LFM3 ของ Liquid AI จัดกลุ่มตัวเลือกของแอปและละรายละเอียดการทำงานภายใน
น้ำหนักโมเดลที่เปิดให้ดาวน์โหลดเพิ่มทางเลือกติดตั้ง แต่ต้องอ่านใบอนุญาต
การดาวน์โหลดน้ำหนักทำให้นักพัฒนามีสิ่งที่นำไปจัดแพ็กเกจ ประเมิน และปรับได้จริง รองรับการติดตั้งบนอุปกรณ์ซึ่งเส้นทางข้อมูลของแอปอยู่ในการควบคุมของนักพัฒนา เรื่องนี้มีประโยชน์ แต่การมีไฟล์ดาวน์โหลดไม่ได้ตัดสินเงื่อนไขเชิงพาณิชย์ให้แล้ว
แค็ตตาล็อกโมเดล ของ Liquid ที่ตรวจเมื่อ 2 พฤศจิกายน อธิบายการใช้เชิงพาณิชย์ฟรีจนบริษัทมี รายได้ต่อปีเกิน 10 ล้านดอลลาร์สหรัฐ โมเดลการ์ด LFM3-1.7B ระบุ LFM Open License v1.0 ควรอ่านใบอนุญาตที่แนบกับเช็กพอยต์ตรงรุ่นและ หน้าการอนุญาตใช้งานปัจจุบัน ให้สอดคล้องกับการติดตั้ง การเผยแพร่ และสถานะรายได้ที่ตั้งใจ
นี่คือขั้นตอนจัดหาที่ใช้ได้จริง ต้นแบบภายในเล็ก ๆ แอปผู้บริโภคที่ดาวน์โหลดได้ และบริการสำหรับธุรกิจอื่นอาจมีคำถามด้านการแจกจ่ายและภาระผูกพันต่างกัน บันทึกชื่อโมเดล รุ่นแก้ไข และใบอนุญาตไว้กับแอป เพื่อย้อนตรวจการตัดสินใจได้เมื่อโครงการเติบโต
ซอฟต์แวร์รันไทม์กับน้ำหนักโมเดลมีเวอร์ชันแยกกัน โมเดลอาจพร้อมใช้แล้วแต่รันไทม์บนอุปกรณ์ยังไม่รองรับอย่างเข้ากันได้ ตรวจคู่รุ่นที่เอกสารระบุ แทนที่จะสมมติว่าแอปทุกตัวที่โหลดตระกูลก่อนหน้าได้จะโหลดรุ่นใหม่อย่างถูกต้อง
สำหรับทีม บันทึกนี้ควรรวมพรอมป์ต์หรือเทมเพลตที่เช็กพอยต์คาดหวังด้วย ตัวโหลดที่เข้ากันได้ยังให้พฤติกรรมไม่ดีได้หากจัดรูปแบบอินพุตผิด การทำซ้ำได้เริ่มจากรู้ว่าโหลดอะไรจริง และแอปสื่อสารกับมันอย่างไร
น้ำหนักประมาณ 1 GB เป็นเพียงจุดเริ่มต้นของงบหน่วยความจำ
Liquid ระบุในข้อมูลเปิดตัววันที่ 27 ตุลาคมว่าโมเดลข้อความแบบ 4 บิตมีขนาดประมาณ 1 GB โมเดลการ์ดข้อความ ระบุ พารามิเตอร์ 1.73 พันล้านตัว และ บริบทอินพุตรวมเอาต์พุต 256K โทเคน นี่คือสเปกโมเดล ส่วนหน่วยความจำสูงสุดของแอปขึ้นกับงานและรันไทม์ด้วย
ไฟล์น้ำหนักเป็นเพียงส่วนหนึ่งของโปรเซสที่ทำงาน รันไทม์ต้องใช้หน่วยความจำทำงาน การประมวลผลบริบทต้องเก็บสถานะ อินพุตหลายสื่ออาจต้องมีบัฟเฟอร์และตัวเข้ารหัสเพิ่ม โปรแกรมอื่นบนอุปกรณ์แย่งทรัพยากรเดียวกัน ตัวเลขขนาดน้ำหนักไม่บอกว่าแอปทั้งหมดจะยังทำงานสบายภายใต้ภาระหรือไม่
งบตัวอย่างจึงควรเริ่มจากขนาดหน่วยความจำของโปรเซสที่วัดจริง บันทึกแอปขณะว่าง ค่าสูงสุดขณะประมวลผลคำขอที่เป็นตัวแทน และสถานะหลังคำขอซ้ำ ทดสอบความยาวบริบทกับขนาดอินพุตที่ผู้ใช้จะส่งจริง แทนพรอมป์ต์เล็กที่เลือกเพราะใส่ได้ง่าย
หลักเดียวกันใช้กับเวลา การเริ่มระบบ ประมวลผลพรอมป์ต์ และสร้างคำตอบเป็นเวลารอคนละส่วน โมเดลที่สร้างโทเคนเร็วหลังรอนานอาจรู้สึกช้าในแอปโต้ตอบ ส่วนงานชุดอาจสนใจจำนวนรายการที่ทำเสร็จต่อชั่วโมงมากกว่า เลือกตัวชี้วัดให้ตรงปฏิสัมพันธ์
ฟีเจอร์เสียงต้องรวมเส้นทางทั้งหมดจากอินพุตถึงผลที่ใช้ได้ ฟีเจอร์ภาพต้องรวมการจัดการภาพ ฟีเจอร์ตัดสินใจต้องรวมการตรวจผลและส่งต่อการกระทำ สิ่งเหล่านี้เป็นข้อกำหนดประเมินที่คุณกำหนด ไม่ใช่ตัวเลขสมรรถนะจากประกาศ
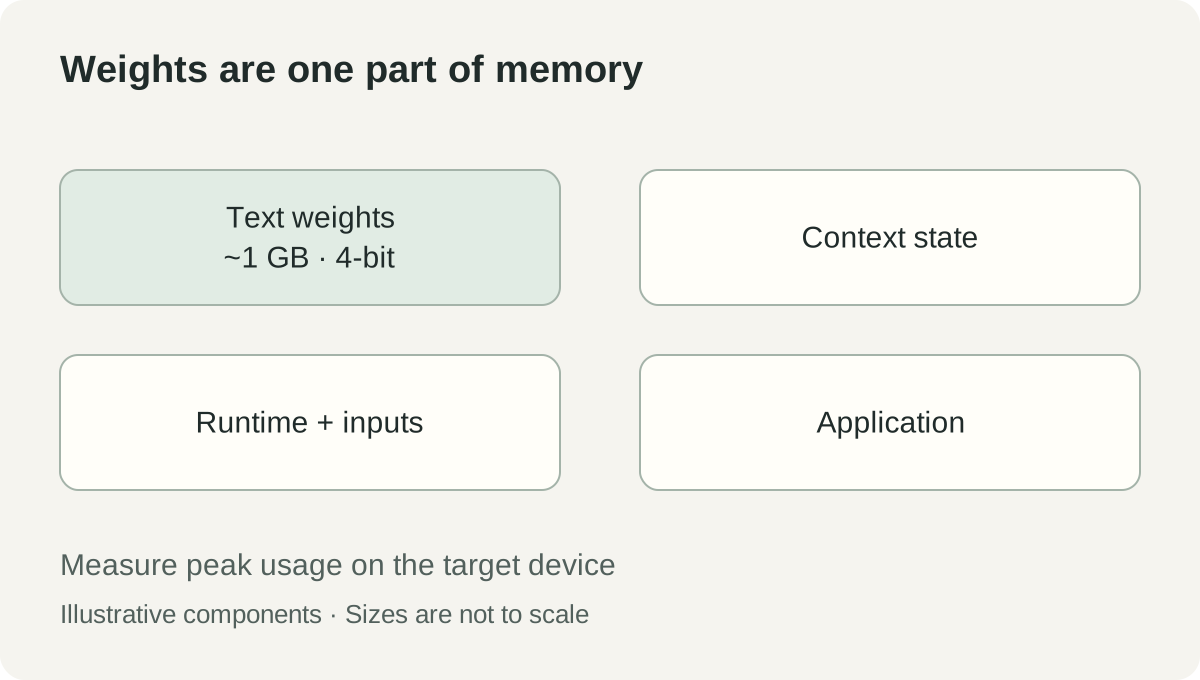 แผนภาพงบหน่วยความจำที่จัดทำขึ้น ความกว้างแต่ละส่วนเป็นตัวอย่าง ไม่ใช่สัดส่วนที่วัดจริง ตัวเลขประมาณ 1 GB หมายถึงขนาดโมเดลข้อความแบบ 4 บิตที่ Liquid เผยแพร่ ไม่ใช่หน่วยความจำรวมของแอป แหล่งข้อมูล
แอปตัวอย่างสามแบบเผยให้เห็นข้อแลกเปลี่ยนต่างกัน
ผู้ช่วยเอกสารแยกการอ่านออกจากการตัดสินใจได้
สมมติแอปธุรกิจเล็กได้รับภาพถ่ายใบเสร็จ งานหนึ่งคืออ่านชื่อร้าน วันที่ และยอดเงินที่มองเห็น อีกงานคือตัดสินว่าเอกสารครบพอให้คนตรวจหรือไม่ ผลลัพธ์ทั้งสองควรตรวจแยกกัน แม้โมเดลเดียวจะช่วยทั้งคู่
เส้นทางภาพและภาษาอาจรองรับคำถามเกี่ยวกับภาพ ส่วนเส้นทางตัดสินใจอาจประเมินการตรวจความครบถ้วนในขอบเขตจำกัด แอปควรเก็บภาพต้นฉบับและแยกฟิลด์ที่สกัดออกจากข้อมูลบัญชีที่ยอมรับแล้ว วันที่ที่ขาดควรยังถือว่าขาดจนกว่าจะมีคนแก้ไข
สร้างชุดประเมินตัวอย่างที่มีภาพชัด ภาพเบลอ เลย์เอาต์แปลก และใบเสร็จในภาษาทำงานจริง วัดข้อผิดพลาดรายฟิลด์และภาระตรวจทาน อัตราสำเร็จรวมที่สูงอาจซ่อนความผิดพลาดซ้ำในฟิลด์ที่สำคัญที่สุดต่อธุรกิจ
ผลผลิตภัณฑ์ที่มีประโยชน์คือคิวตรวจที่สั้นและชัดขึ้น คำอธิบายสละสลวยสำคัญน้อยกว่าการที่ผู้ตรวจดูต้นฉบับและแก้ฟิลด์ได้ ลำดับความสำคัญนี้ช่วยเลือกระหว่างผลลัพธ์ภาษาแบบปลายเปิดกับส่วนติดต่อการตัดสินใจที่จำกัดกว่า
ส่วนติดต่อด้วยเสียงเริ่มจากการกระทำที่อนุญาตไม่กี่อย่างได้
พิจารณาผู้ช่วยแบบไม่ต้องใช้มือสำหรับแอปบนอุปกรณ์ ผู้ใช้ขอค้นหารายการ อ่านสถานะ หรือเตรียมร่างการกระทำได้ ความสามารถด้านเสียงมีค่าเมื่อพูดสะดวกกว่าพิมพ์ แต่แอปยังต้องรู้ว่าคำขอได้รับอนุญาตให้เปลี่ยนอะไร
เริ่มจากชุดคำสั่งเล็กและเส้นทางยืนยันที่มองเห็นได้ เช่น คำขอค้นหาระเบียนทำได้ทันทีภายในข้อมูลที่อนุญาต ส่วนคำขอเปลี่ยนระเบียนอาจแสดงการกระทำที่เสนอให้ตรวจ นโยบายเป็นของแอป ไม่ใช่ขึ้นกับถ้อยคำที่โมเดลบังเอิญสร้าง
ทดสอบสภาพเสียงจริง บทสนทนาพื้นหลัง คำพูดสั้น และชื่อคล้ายกันอาจสร้างรูปแบบล้มเหลวต่างจากประโยคบันทึกเสียงสะอาด รวมกรณีที่ผลลัพธ์ถูกต้องคือถามผู้ใช้อีกครั้ง คำตอบเสียงคล่องแคล่วมีค่าน้อยกว่าปฏิสัมพันธ์ที่ถูกต้องและกู้คืนได้
โมเดลหลายสื่อเหมาะเมื่อคำขอขึ้นกับสิ่งที่เห็นควบคู่กับสิ่งที่พูด หากทุกงานใช้แต่เสียง การเพิ่มประมวลผลภาพต้องมีเหตุผล แนวทางตระกูลโมเดลช่วยรักษาสัดส่วนฟีเจอร์ให้พอดีกับงานตรงนี้
เครื่องมือสนับสนุนบนอุปกรณ์จัดเส้นทางงานได้พร้อมทางออกสำรอง
แอปสนับสนุนตัวอย่างอาจเลือกคิวหนึ่งจากสามคิวโดยใช้ตั๋วงานและภาพหน้าจอแนบ ผลตัดสินใจที่มีขอบเขตอาจตรงงานกว่าคำตอบยาวที่แอปต้องตีความ คำถามที่มีประโยชน์คือเส้นทางที่เลือกเชื่อถือได้พอหรือไม่ โดยมีอัตราตรวจทานที่ยอมรับได้
เก็บผลลัพธ์ “ต้องตรวจทาน” ไว้อย่างชัดเจน ทดสอบตั๋วที่ไม่ตรงคิวใด ภาพหน้าจอขัดแย้ง และกรณีบริบทไม่พอ แอปไม่ควรบังคับให้โมเดลแต่งเส้นทางที่ดูถูกต้องเพียงเพราะสคีมาต้องการคำตอบ
เปรียบเทียบโมเดลกับฐานอย่างง่าย เช่น กฎเดิมและการจัดคิวโดยคน หากฐานเดิมจัดการหมวดหนึ่งได้เชื่อถือได้ โมเดลต้องปรับปรุงส่วนอื่นของเวิร์กโฟลว์ ความใหม่ไม่ใช่เกณฑ์ยอมรับ
สำหรับทุกข้อผิดพลาด ให้เก็บบริบทที่ได้รับอนุญาตมากพอจะเข้าใจสาเหตุ แยกปัญหาอินพุต หมวดกำกวม และข้อผิดพลาดของโมเดล ความต่างนี้บอกว่าควรปรับโมเดล เปลี่ยนนิยามคิว หรือขอข้อมูลต้นทางที่ดีขึ้น
ตารางเบนช์มาร์กเป็นจุดเริ่มต้นสำหรับงานของคุณ
โมเดลการ์ด LFM3-1.7B ทางการ ที่ตรวจเมื่อ 2 พฤศจิกายน แนะนำการดึงข้อมูลหรือค้นหาสำหรับงานใช้ความรู้มาก และเตือนไม่ให้คาดหวังงานเขียนโค้ดแบบเอเจนต์กับการให้เหตุผลหลายขั้นซับซ้อนจากขนาดนี้ คำแนะนำนี้ช่วยวางโมเดลในระบบใหญ่ แม้ตารางเบนช์มาร์กของผู้ขายจะแสดงความก้าวหน้า
ผลเบนช์มาร์กตอบคำถามเฉพาะภายใต้การตั้งค่าเฉพาะ แอปของคุณเพิ่มข้อมูล เครื่องมือ สัดส่วนภาษา และต้นทุนความล้มเหลวของตัวเอง โมเดลอาจดีขึ้นในคะแนนรวมสาธารณะ แต่ยังต้องจัดการอย่างรอบคอบกับหมวดไม่กี่อย่างที่ผู้ใช้พบทุกวัน
แยกการเปรียบเทียบสามส่วนในโครงการนำร่อง หนึ่ง คุณภาพงานเทียบกับเวิร์กโฟลว์ปัจจุบัน สอง ต้นทุนทรัพยากรทั้งหมดบนอุปกรณ์เป้าหมาย สาม งานที่ต้องใช้เพื่อฟื้นจากความล้มเหลว การเปรียบเทียบเหล่านี้อาจมีผู้ชนะต่างกัน
ตัวอย่างเช่น โมเดลทั่วไปบนคลาวด์อาจมีประโยชน์เป็นทางยกระดับเมื่อโมเดลเฉพาะทางบนอุปกรณ์ปฏิเสธ วิธีนี้ต้องมีนโยบายข้อมูลและประสบการณ์ผู้ใช้ชัดเจน การทำงานในเครื่องเป็นทางเลือกติดตั้งที่ต้องตรวจทั่วทั้งแอป รวมบันทึกระบบและคำขอสำรอง
การปรับจูนควรตามหลังช่องว่างที่พิสูจน์แล้ว หากความล้มเหลวมาจากข้อมูลต้นทางขาดหรือนิยามผลลัพธ์ไม่ชัด การฝึกเพิ่มอาจตอกย้ำงานผิด กำหนดสัญญาและตรวจข้อผิดพลาดก่อนตัดสินว่าการปรับแต่งคือขั้นถัดไปที่มีประโยชน์
โครงการนำร่องแรกควรสรุปการตัดสินใจได้ในหน้าเดียว
โมเดลการ์ดข้อความทางการ เชื่อมไปยังรูปแบบเช็กพอยต์และคำแนะนำรันไทม์ เริ่มที่นั่นสำหรับคู่โมเดลกับรันไทม์ที่ตรง ใช้ Playground ทางการตรวจปฏิสัมพันธ์เบื้องต้นได้หากตรงนโยบายข้อมูล ทั้งสองทางไม่แทนการทดสอบการติดตั้งที่คุณจะส่งจริง
- เขียนสัญญาอินพุตและเอาต์พุต ระบุข้อมูลที่อนุญาต ผลที่คาด และผลลัพธ์ส่งตรวจที่ชัด เลือกงานเดียวแทนบุคลิกผู้ช่วยทั่วไป
- เลือกโมเดลและรุ่นแก้ไข จับคู่รูปแบบสื่อกับบทบาทผลลัพธ์ แล้วบันทึกเช็กพอยต์ ใบอนุญาต และรันไทม์ที่เข้ากัน อ่านข้อจำกัดเฉพาะรุ่น
- สร้างชุดประเมินที่เป็นตัวแทน รวมกรณีทั่วไป ยาก คำขอที่ไม่รองรับ และตัวอย่างในภาษาผู้ใช้จริง แยกชุดทดสอบที่กันไว้ออกจากข้อมูลปรับแต่ง
- รันคู่มือเริ่มต้นในสภาพแวดล้อมแยก ทำตามคำแนะนำปัจจุบันด้านการติดตั้งและรูปแบบอินพุตจากโมเดลการ์ด ยืนยันตัวตนโมเดลที่ตอบก่อนเปรียบเทียบผล
- วัดเส้นทางแอปทั้งหมด เก็บความถูกต้อง อัตราส่งตรวจ เวลาแฝง และหน่วยความจำสูงสุดสำหรับขนาดอินพุตจริง บันทึกฮาร์ดแวร์และค่ารันไทม์คู่ตัวเลข
- ทดสอบเส้นทางความไม่แน่นอน ยืนยันว่าข้อมูลขาด ผลลัพธ์ไม่ถูกต้อง และรันไทม์ล้มเหลวนำไปสู่สถานะตรวจทานหรือลองใหม่ที่เข้าใจได้
- ตัดสินใจว่าจะพัฒนาความเฉพาะทางอะไรต่อ ใช้หมวดข้อผิดพลาดซ้ำเลือกว่าจะปรับอินพุต กฎ การดึงข้อมูล การปรับจูน หรือเปลี่ยนโมเดล
รอบแรกอาจเขียนข้อสรุปง่าย ๆ ว่า โมเดลนี้มีประโยชน์กับงานนี้ บนอุปกรณ์นี้ ภายใต้เงื่อนไขตรวจทานเหล่านี้ ข้อสรุปที่จำกัดและทำซ้ำได้มีค่ากว่าการกล่าวกว้างว่า AI บนอุปกรณ์พร้อมทำทุกอย่าง
โมเดลเล็กมีที่ยืนเมื่อทำงานที่นิยามไว้สำเร็จ
LFM3 เพิ่มทางเลือกให้นักพัฒนาที่ต้องการข้อความ ภาพ เสียง หรือการตัดสินใจในขอบเขตใกล้กับแอป ความสำคัญเชิงปฏิบัติมาจากการเลือกบทบาทและประเมินเป็นส่วนหนึ่งของผลิตภัณฑ์ได้
ขั้นถัดไปคือทำให้งานหนึ่งชัดพอที่จะวัดคุณภาพ หน่วยความจำ และการกู้คืนได้ทั้งหมด โมเดลเฉพาะทางมีประโยชน์เมื่อทั้งแอปพึ่งสัญญาของมันได้ และรู้ว่าจะทำอย่างไรเมื่อมันตอบไม่ได้
แหล่งข้อมูล
- Liquid AI: แนะนำ LFM3, 27 ตุลาคม 2026; ตรวจเมื่อ 2 พฤศจิกายน 2026
- แค็ตตาล็อกโมเดล Liquid AI และ ราคาและการอนุญาตใช้งาน, ตรวจเมื่อ 2 พฤศจิกายน 2026
- โมเดลการ์ด LFM3-1.7B ทางการ, ตรวจเมื่อ 2 พฤศจิกายน 2026
- โมเดลการ์ด d1-2B ทางการ, ตรวจเมื่อ 2 พฤศจิกายน 2026
เก็บข้อมูลที่อยู่เบื้องหลังการตัดสินใจ
Telli.sh เป็นทางเลือกหนึ่งสำหรับเก็บเอกสารต้นทางที่ได้รับอนุญาตควบคู่กับบันทึกที่คุณทบทวนแล้ว สร้างพื้นที่บันทึก