Liquid LFM3 mengubah pertanyaan AI lokal: model kecil mana yang benar-benar menuntaskan tugas?
LFM3 membagi fondasi bersama menjadi model teks, visual, audio, omni, dan keputusan. Cara memilih spesialis, menghitung memori saat berjalan, dan mengevaluasinya pada perangkat sendiri.
Asisten lokal yang membaca struk belum tentu memerlukan model yang sama dengan asisten yang menjawab pertanyaan lisan. Program yang memilih di antara tiga tindakan yang diizinkan memiliki tugas berbeda lagi. Menganggap semuanya satu tugas justru dapat membuat aplikasi kecil menjadi terlalu rumit.
Liquid AI mengumumkan LFM3 pada 27 Oktober 2026: enam model kelas sekitar 2B yang bercabang dari fondasi bersama 1.7B, meliputi teks, visual, audio, omni, serta dua varian keputusan. Perusahaan menyediakan bobot terbuka, Playground, dan akses API. Pengumuman LFM3.
Keputusan yang menarik adalah peran mana yang dibutuhkan aplikasi Anda. Panduan ini menjelaskan keluarga tersebut melalui pilihan praktis, membedakan berkas bobot yang ringkas dari anggaran memori saat aplikasi berjalan, dan menawarkan evaluasi awal untuk mengetahui kegunaan sebuah spesialis pada perangkat keras Anda sendiri.
 Perangkat keras Raspberry Pi 5; ilustrasi konteks komputasi tepi, bukan pengujian LFM3 kami. Gambar: RetroEditor, CC BY 4.0; ukuran diubah dengan tambahan margin. Sumber gambar · Lisensi dan catatan gambar. Referensi produk resmi.

Keluarga spesialis dimulai dari keluaran yang Anda perlukan
Cara tercepat untuk salah memilih adalah memulai dari daftar masukan yang paling panjang. Mulailah dari keluaran yang harus dihasilkan aplikasi. Paragraf, transkrip, kolom terstruktur, dan pilihan di antara tindakan yang diizinkan merupakan kontrak yang berbeda, meskipun bahan sumber yang sama dapat membantu menghasilkan keempatnya.
Pengumuman Liquid pada 27 Oktober menyebut empat cabang modalitas dan dua cabang keputusan: LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B, serta d1-Omni-2B. Tabel berikut menerjemahkan peran tersebut menjadi pertanyaan saat memilih komponen aplikasi. Ini panduan kecocokan, bukan pemeringkatan kualitas yang kami uji secara independen. Penjelasan keluarga model.
| Peran model | Kandidat dalam keluarga LFM3 | Pertanyaan untuk aplikasi Anda |
|---|---|---|
| Interaksi teks | LFM3-1.7B | Apakah tugas memerlukan keluaran bahasa dari teks? |
| Pemahaman gambar dan teks | LFM3-VL-2B | Apakah jawaban bergantung pada sesuatu yang terlihat? |
| Interaksi ucapan dan audio | LFM3-Audio-2B | Apakah aplikasi perlu mendengar atau berbicara? |
| Interaksi audiovisual gabungan | LFM3-Omni-2B | Haruskah aplikasi menafsirkan penglihatan dan suara sekaligus? |
| Keputusan terstruktur dari teks dan gambar | d1-2B | Dapatkah hasil dinyatakan sebagai keputusan bertipe? |
| Keputusan terstruktur yang mencakup audio | d1-Omni-2B | Apakah keputusan dengan pilihan terbatas juga harus memakai suara? |
Menurut kami, satuan AI lokal yang berguna adalah tugas lengkap terkecil. Model perlu memiliki kemampuan yang cukup untuk memenuhi kontrak aplikasi yang jelas, disertai cara menghadapi ketidakpastian. Kemampuan tambahan membawa biaya saat berjalan, pengujian, dan integrasi yang harus sepadan dengan manfaatnya.
Bayangkan keluarga ini sebagai gulungan perkakas. Membawa semua perkakas masuk akal untuk pekerjaan tertentu; untuk penyetelan yang berulang, memilih alat yang tepat dapat lebih sederhana. Analogi tersebut menjelaskan desain aplikasi, bukan klaim bahwa suatu model selalu mengungguli model lain.
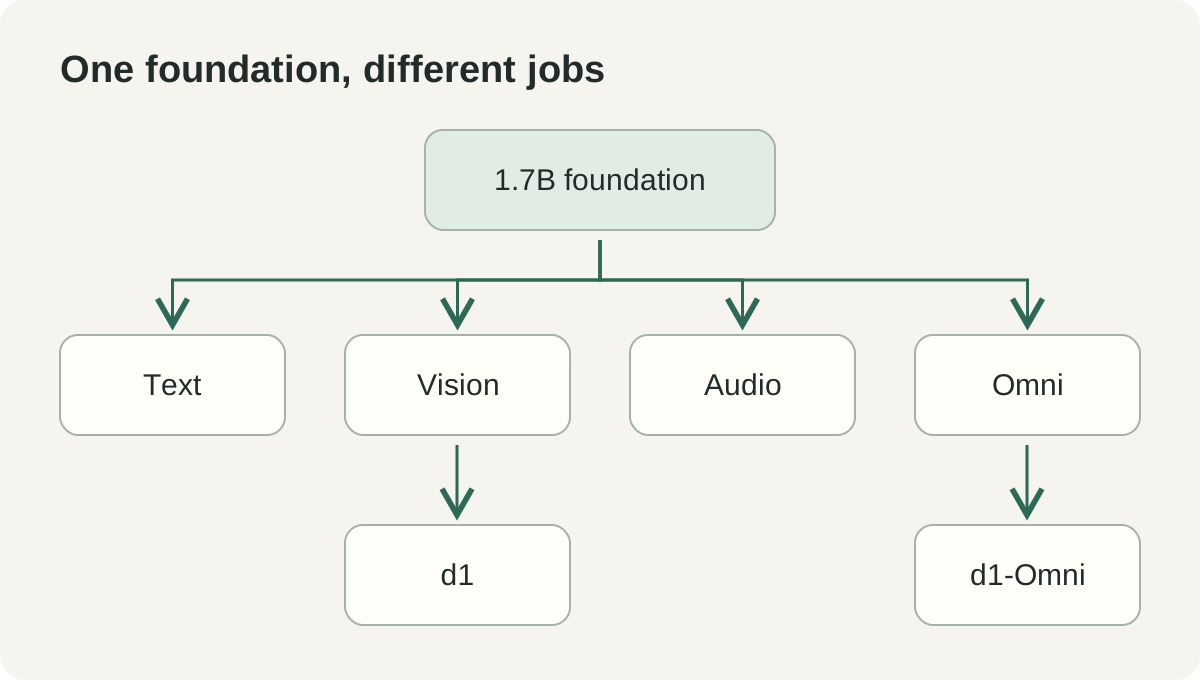 Diagram penjelasan buatan kami tentang peran yang disebut dalam pengumuman LFM3 dari Liquid AI. Diagram mengelompokkan pilihan aplikasi dan tidak menampilkan rincian implementasi internal.
Bobot terbuka memberi pilihan penerapan, dengan lisensi yang perlu dibaca
Mengunduh bobot memberi pengembang sesuatu yang nyata untuk dikemas, dievaluasi, dan disesuaikan. Ini dapat mendukung penerapan lokal dengan aliran data aplikasi tetap berada di bawah kendali pengembang. Hal itu berguna, tetapi tersedianya berkas unduhan belum menjelaskan seluruh ketentuan komersialnya.
Katalog model Liquid, yang diperiksa pada 2 November, menjelaskan penggunaan komersial gratis sampai perusahaan melampaui pendapatan tahunan $10 juta. Kartu model LFM3-1.7B menyebut LFM Open License v1.0. Baca lisensi yang menyertai checkpoint persis yang dipakai serta halaman lisensi terkini, sesuai rencana penerapan, distribusi, dan kondisi pendapatan.
Ini merupakan langkah pengadaan yang praktis. Prototipe internal kecil, aplikasi konsumen yang dapat diunduh, dan layanan untuk bisnis lain dapat menimbulkan pertanyaan distribusi serta kewajiban yang berbeda. Catat pengenal model, revisi, dan lisensinya bersama aplikasi agar keputusan tetap dapat ditelusuri ketika proyek berkembang.
Perangkat lunak runtime dan bobot model juga memiliki versi masing-masing. Model dapat tersedia sementara runtime pada perangkat Anda belum mendukungnya dengan benar. Periksa kombinasi yang didokumentasikan, alih-alih menganggap setiap aplikasi yang mampu memuat keluarga terdahulu juga dapat memuat model baru dengan tepat.
Bagi tim, catatan tersebut perlu mencakup prompt atau templat yang diharapkan checkpoint. Pemuat yang kompatibel tetap dapat menghasilkan perilaku buruk jika format masukannya keliru. Kemampuan mengulangi hasil dimulai dari mengetahui apa yang benar-benar dimuat dan bagaimana aplikasi berkomunikasi dengannya.
Bobot sekitar 1 GB hanyalah awal anggaran memori
Dalam materi peluncuran 27 Oktober, Liquid menyebut ukuran model teks 4-bit sekitar 1 GB. Kartu model teks mencantumkan 1,73 miliar parameter serta konteks masukan dan keluaran gabungan 256K token. Itu spesifikasi model; memori puncak aplikasi juga bergantung pada beban kerja dan runtime.
Berkas bobot hanyalah salah satu bagian proses yang berjalan. Runtime memerlukan memori kerja; pemrosesan konteks memerlukan penyimpanan keadaan; masukan multimedia dapat membutuhkan buffer dan encoder tambahan. Program lain pada perangkat bersaing menggunakan sumber daya yang sama. Angka ukuran bobot dalam judul tidak cukup untuk menentukan apakah seluruh aplikasi tetap nyaman digunakan saat menerima beban.
Karena itu, contoh penyusunan anggaran sebaiknya dimulai dari pemakaian memori proses yang diukur. Catat keadaan aplikasi saat diam, puncak ketika memproses permintaan yang representatif, dan keadaan setelah permintaan berulang. Uji panjang konteks serta ukuran masukan yang benar-benar akan diberikan pengguna, bukan prompt kecil yang dipilih karena mudah dimuat.
Disiplin yang sama berlaku untuk waktu. Startup, pemrosesan prompt, dan pembuatan respons merupakan tiga waktu tunggu yang berbeda. Model yang cepat menghasilkan token setelah jeda panjang tetap dapat terasa lambat dalam aplikasi interaktif; tugas batch mungkin lebih memperhatikan jumlah item selesai per jam. Pilih ukuran yang sesuai dengan interaksinya.
Untuk fitur audio, sertakan seluruh alur dari masukan hingga hasil siap dipakai. Untuk fitur gambar, sertakan penanganan gambar. Untuk fitur keputusan, sertakan validasi dan penyerahan tindakan. Semuanya merupakan persyaratan evaluasi yang Anda tetapkan, bukan angka performa yang diberikan oleh pengumuman produk.
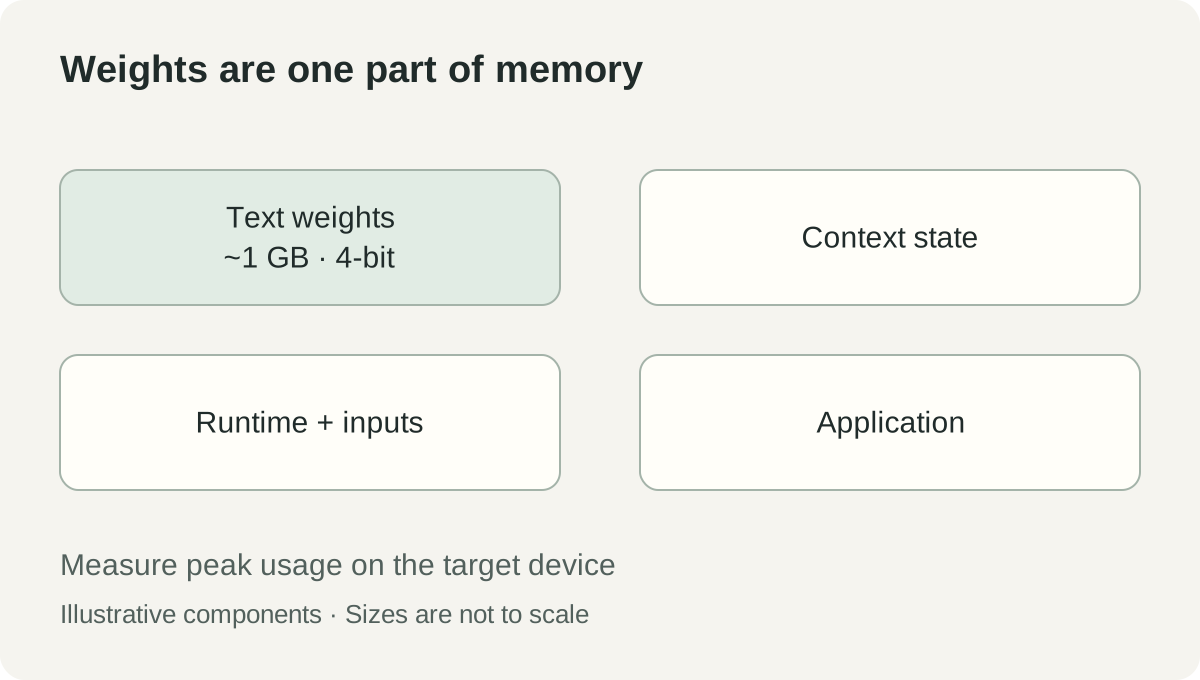 Diagram anggaran memori buatan kami. Lebar segmen hanya ilustrasi dan tidak menunjukkan proporsi hasil pengukuran; angka sekitar 1 GB mengacu pada ukuran model teks 4-bit yang diterbitkan Liquid, bukan seluruh memori aplikasi. Sumber.
Tiga contoh aplikasi memperlihatkan pertimbangan yang berbeda
Pembantu dokumen dapat memisahkan pembacaan dari pengambilan keputusan
Bayangkan aplikasi usaha kecil yang menerima foto struk. Satu tugasnya membaca nama penjual, tanggal, dan jumlah yang terlihat. Tugas lainnya menentukan apakah dokumen sudah cukup lengkap untuk diperiksa seseorang. Kedua keluaran perlu divalidasi secara terpisah, meskipun satu model berkontribusi pada keduanya.
Alur visual-bahasa dapat mendukung pertanyaan tentang gambar; alur keputusan dapat dievaluasi untuk pemeriksaan kelengkapan dengan hasil terbatas. Aplikasi perlu mempertahankan gambar sumber dan membedakan kolom hasil ekstraksi dari data pembukuan yang telah diterima. Tanggal yang hilang harus tetap dianggap hilang sampai seseorang menyelesaikannya.
Susun contoh kumpulan evaluasi berisi gambar jelas, gambar buram, tata letak tidak lazim, dan struk dalam bahasa kerja yang sebenarnya. Ukur kesalahan per kolom dan beban peninjauan. Tingkat keberhasilan keseluruhan yang tinggi dapat menyembunyikan kesalahan berulang pada kolom yang paling penting bagi usaha tersebut.
Hasil produk yang berguna adalah antrean peninjauan yang lebih pendek dan lebih jelas. Keindahan penjelasan model kurang penting dibanding kemampuan pemeriksa melihat sumber dan mengoreksi kolom. Prioritas ini membantu memilih antara keluaran bahasa terbuka dan antarmuka keputusan yang lebih terbatas.
Antarmuka lisan dapat dimulai dengan sedikit tindakan yang diizinkan
Pertimbangkan contoh asisten tanpa sentuhan untuk aplikasi lokal. Pengguna dapat meminta pencarian item, pembacaan statusnya, atau penyiapan draf tindakan. Kemampuan audio berguna saat berbicara lebih mudah daripada mengetik, tetapi aplikasi tetap perlu mengetahui perubahan apa yang boleh dilakukan sebuah permintaan.
Mulailah dengan kosakata tindakan yang kecil serta jalur konfirmasi yang terlihat. Misalnya, permintaan menemukan catatan dapat langsung berjalan dalam data yang diizinkan, sementara permintaan yang akan mengubah catatan menampilkan usulan tindakan untuk diperiksa. Kebijakan merupakan milik aplikasi, bukan ditentukan oleh susunan kata yang kebetulan dihasilkan model.
Uji kondisi akustik yang sebenarnya. Percakapan latar, ucapan singkat, dan nama yang mirip dapat menghasilkan pola kegagalan berbeda dari kalimat rekaman yang bersih. Sertakan kasus ketika hasil yang benar adalah meminta pengguna mengulangi permintaan. Jawaban lisan yang lancar kurang berguna dibanding interaksi yang tepat dan dapat dipulihkan.
Kandidat omni menjadi relevan ketika permintaan bergantung pada apa yang terlihat sekaligus apa yang diucapkan. Jika setiap tugas hanya memakai ucapan, pemrosesan visual tambahan perlu alasan. Di sinilah pendekatan keluarga model dapat membantu menjaga fitur tetap sebanding dengan tugasnya.
Alat dukungan lokal dapat mengarahkan pekerjaan sambil menyediakan jalan keluar
Contoh aplikasi dukungan mungkin memilih di antara tiga antrean berdasarkan tiket dan tangkapan layar lampiran. Keluaran keputusan terbatas dapat lebih langsung sesuai dengan tugas tersebut dibanding jawaban panjang yang masih harus ditafsirkan aplikasi. Pertanyaan yang berguna adalah apakah rute terpilih cukup andal dengan tingkat peninjauan yang dapat diterima.
Sediakan hasil eksplisit “perlu ditinjau”. Uji tiket yang tidak cocok dengan antrean mana pun, tangkapan layar yang bertentangan, serta kasus dengan konteks tidak cukup. Aplikasi tidak semestinya memaksa model mengarang rute yang sah hanya karena skema mewajibkannya.
Bandingkan model dengan patokan sederhana, seperti aturan yang sudah dipakai dan pengalihan oleh manusia. Jika patokan tersebut sudah menangani sebuah kategori dengan andal, model perlu memperbaiki bagian alur kerja yang lain. Kebaruan bukan kriteria penerimaan.
Untuk setiap kesalahan, simpan konteks yang diizinkan secukupnya agar penyebabnya dapat dipahami. Pisahkan masalah masukan, kategori yang ambigu, dan kesalahan model. Pembedaan ini menunjukkan apakah yang perlu diperbaiki adalah model, definisi antrean, atau bahan sumber yang harus lebih baik.
Tabel benchmark menjadi titik awal untuk beban kerja Anda sendiri
Kartu model LFM3-1.7B resmi, yang diperiksa pada 2 November, menyarankan retrieval atau pencarian untuk pekerjaan yang sarat pengetahuan serta memperingatkan keterbatasan untuk pemrograman agentik dan penalaran banyak langkah yang kompleks pada ukuran ini. Panduan tersebut membantu menempatkan model dalam sistem yang lebih besar, sekalipun tabel benchmark vendor menunjukkan kemajuan.
Hasil benchmark menjawab pertanyaan tertentu dalam konfigurasi tertentu. Aplikasi Anda menambahkan data, alat, distribusi bahasa, serta biaya kegagalannya sendiri. Sebuah model dapat membaik pada skor agregat publik tetapi tetap membutuhkan banyak pekerjaan untuk beberapa kategori yang ditemui pengguna setiap hari.
Pisahkan tiga perbandingan dalam uji coba. Pertama, bandingkan kualitas tugas dengan alur kerja saat ini. Kedua, bandingkan seluruh biaya sumber daya pada perangkat sasaran. Ketiga, bandingkan pekerjaan untuk memulihkan kegagalan. Ketiganya dapat menghasilkan pemenang yang berbeda.
Misalnya, model generalis di cloud dapat berguna sebagai jalur eskalasi ketika spesialis lokal menolak. Susunan seperti itu memerlukan kebijakan data dan pengalaman pengguna yang eksplisit. Operasi lokal merupakan pilihan penerapan yang perlu diverifikasi pada seluruh aplikasi, termasuk pencatatan log dan permintaan fallback.
Fine-tuning sebaiknya mengikuti kesenjangan yang telah terbukti. Jika kegagalan berasal dari bahan sumber yang tidak tersedia atau definisi keluaran yang tidak jelas, pelatihan tambahan dapat menguatkan tugas yang keliru. Tentukan kontrak dan periksa kesalahan sebelum memutuskan bahwa penyesuaian adalah langkah berikutnya yang berguna.
Uji coba pertama sebaiknya cukup dijelaskan dalam satu halaman keputusan
Kartu model teks resmi menautkan format checkpoint dan petunjuk runtime. Mulailah dari sana untuk kombinasi model/runtime yang persis akan dipakai; gunakan Playground resmi untuk pemeriksaan interaksi awal jika sesuai dengan kebijakan data Anda. Kedua cara tersebut tidak menggantikan pengujian penerapan yang benar-benar akan dikirimkan kepada pengguna.
- Tuliskan kontrak masukan dan keluaran. Nyatakan bahan yang diizinkan, hasil yang diharapkan, dan keluaran peninjauan yang eksplisit. Pilih satu tugas, bukan persona asisten serbaguna.
- Pilih kandidat dan revisinya. Cocokkan modalitas serta peran keluaran, lalu catat checkpoint, lisensi, dan runtime yang kompatibel. Baca batasan khusus model tersebut.
- Buat kumpulan evaluasi yang representatif. Sertakan kasus biasa, kasus sulit, permintaan yang tidak didukung, dan contoh dalam bahasa pengguna yang sebenarnya. Pisahkan bahan evaluasi yang ditahan dari data penyesuaian.
- Jalankan panduan awal resmi dalam lingkungan terisolasi. Ikuti petunjuk dependensi dan format terkini pada kartu model. Pastikan identitas model yang dikembalikan sebelum membandingkan keluaran.
- Ukur seluruh alur aplikasi. Catat ketepatan, tingkat peninjauan, latensi, dan memori puncak untuk ukuran masukan yang realistis. Rekam perangkat keras dan pengaturan runtime bersama angkanya.
- Uji jalur ketidakpastian. Pastikan informasi yang hilang, keluaran tidak valid, dan kegagalan runtime berakhir pada keadaan peninjauan atau pengulangan yang dapat dipahami.
- Putuskan bagian berikutnya yang perlu dispesialisasi. Gunakan kategori kesalahan berulang untuk memilih perbaikan masukan, aturan lebih jelas, retrieval, fine-tuning, atau model lain.
Pada putaran pertama, keputusan tertulisnya dapat sederhana: kandidat ini berguna untuk tugas ini pada perangkat ini, dengan syarat peninjauan berikut. Kesimpulan yang sempit dan dapat diulangi lebih berharga daripada klaim umum bahwa AI lokal sudah siap untuk segala hal.
Model kecil layak dipakai ketika menuntaskan tugas yang jelas
LFM3 memperluas pilihan pengembang yang ingin menempatkan teks, penglihatan, suara, atau keputusan terbatas dekat dengan aplikasi. Arti praktisnya muncul dari kemampuan memilih peran tersebut dan mengevaluasinya sebagai bagian produk.
Langkah berikutnya adalah membuat satu tugas cukup jelas agar kualitas, memori, dan pemulihannya dapat diukur. Spesialis menjadi berguna ketika seluruh aplikasi dapat mengandalkan kontraknya dan mengetahui apa yang harus dilakukan saat model tidak dapat menjawab.
Sumber
- Liquid AI: Memperkenalkan LFM3, 27 Oktober 2026; diperiksa 2 November 2026.
- Katalog model Liquid AI serta harga dan lisensi, diperiksa 2 November 2026.
- Kartu model LFM3-1.7B resmi, diperiksa 2 November 2026.
- Kartu model d1-2B resmi, diperiksa 2 November 2026.
Simpan bahan di balik sebuah keputusan
Telli.sh merupakan salah satu pilihan untuk menyimpan bahan sumber yang diizinkan bersama catatan yang sudah Anda periksa. Buat ruang kerja catatan.