30 GPU trên một máy chủ có rút ngắn hàng đợi AI trong phòng thí nghiệm?
LIQID UltraStack cấp card AMD Instinct MI350P riêng cho từng phiên bản mô hình. Hãy đối chiếu phép đo với 20 GPU và dự phóng cho 30 GPU, rồi kiểm tra thời gian chờ mà nhóm nghiên cứu thực sự gặp.
Lúc chín giờ sáng, một nhóm nghiên cứu bắt đầu trích văn bản từ các bản quét hôm qua. Nhóm thứ hai gửi ghi chú đi dịch, còn nhóm thứ ba muốn tìm nhanh câu trả lời trong sách hướng dẫn của một thiết bị. Nếu ba tác vụ dùng chung hàng đợi suy luận, một câu hỏi ngắn có thể phải chờ sau cả lô tài liệu lớn. Đến lúc có câu trả lời, người cần có lẽ đã quay lại lục tệp PDF.
Ngày 12 tháng 11 năm 2026, hãng hạ tầng LIQID mô tả cấu hình UltraStack kết nối 4 đến 30 bộ tăng tốc AMD Instinct MI350P với một máy chủ AMD EPYC 9005 hai socket. Thiết kế phục vụ mà hãng công bố đặt một phiên bản mô hình trên mỗi card. Nhờ vậy, một tác vụ OCR có thể tiếp tục chạy trong lúc những GPU khác dịch văn bản hoặc trả lời câu hỏi. LIQID công bố sẽ trình diễn tại SC26 ở Chicago, trong thời gian triển lãm dự kiến từ 17 đến 19 tháng 11. Thông báo ngày 12 tháng 11 và hình ảnh hệ thống chính thức của LIQID · Lịch SC26
Thiết kế này phù hợp khi phòng thí nghiệm cần nhiều tác vụ hoàn thành đúng giờ và từng mô hình có thể chạy gọn trên một card. Bắt đầu từ thời gian người dùng phải chờ. Sau đó hỏi GPU riêng có thể giảm phần chờ do tác vụ khác gây ra hay không, điểm nghẽn tiếp theo nằm ở đâu, và mức cải thiện có đáng với điện năng và chi phí của hệ thống không. Phần lớn câu hỏi có thể được kiểm tra bằng thử nghiệm nhỏ hơn nhiều so với cấu hình lắp đủ card.
Mỗi GPU có 144 GB bộ nhớ riêng
Trong sơ đồ LIQID công bố, máy chủ AMD EPYC kết nối các card MI350P qua mạng liên kết PCIe Gen 5. Các card có thể đặt trong những khung GPU riêng nối với máy chủ. AMD công bố mỗi MI350P có 144 GB HBM3E riêng và giao diện card PCIe 5.0 x16. Trong cấu hình một mô hình mỗi card, mô hình sử dụng bộ nhớ của GPU được cấp. Mỗi phiên bản mô hình có thể xử lý nhiều yêu cầu, tùy giới hạn của phần mềm phục vụ và hạn mức bộ nhớ. Bảng thông số UltraStack của LIQID · Thông số AMD MI350P
Hai mươi card có tổng cộng 2,88 TB HBM3E theo đơn vị thập phân. Con số đó giúp tính số phiên bản mô hình độc lập mà hệ thống có thể chạy. Với tác vụ được phân vào card số bảy, dung lượng cần xét đầu tiên vẫn là 144 GB. Nếu mô hình chỉ chạy vừa khi chia tham số và trạng thái đang xử lý qua nhiều GPU, hãy đánh giá phương án phân bổ và đo hiệu năng riêng cho phương án đó. Kết quả mở rộng của LIQID áp dụng cho các phiên bản chạy độc lập trên những card riêng. Thiết lập thử nghiệm và số liệu bộ nhớ của LIQID
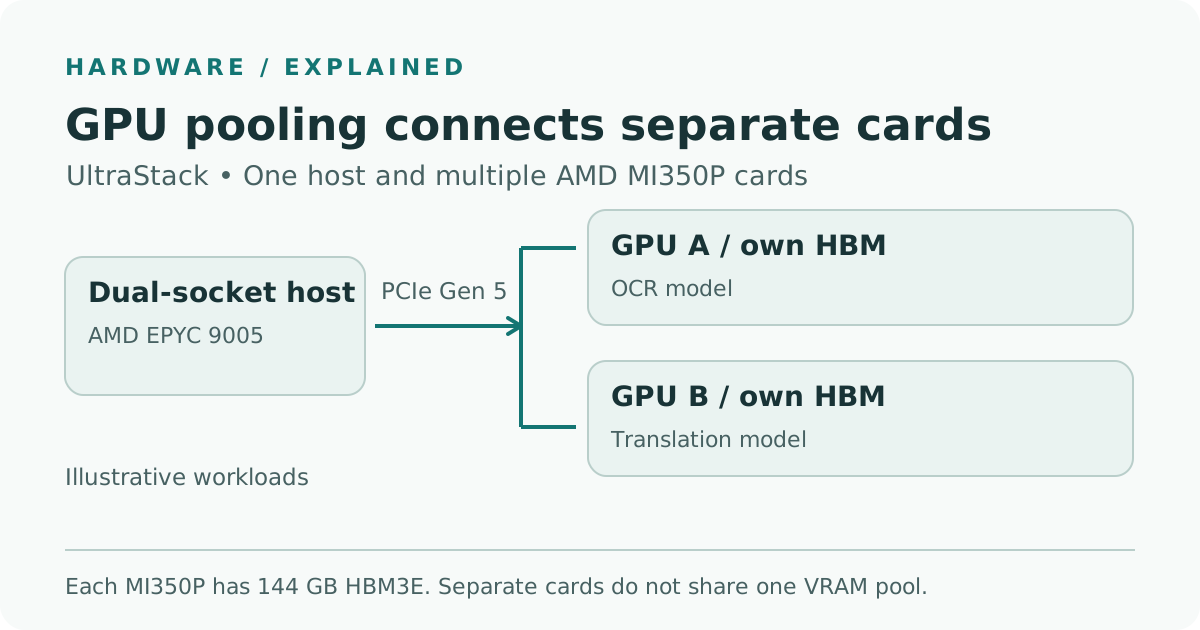
Minh họa của Telli.sh dựa trên mô tả phần cứng từ LIQID và thông số card của AMD. Sơ đồ minh họa cách phục vụ độc lập và lược bỏ khung máy cùng thiết bị ngoại vi của máy chủ.
Số tham số giúp thu hẹp lựa chọn, nhưng hai mô hình có cùng số tham số có thể cần lượng bộ nhớ khác nhau. Bắt đầu với đúng trọng số và độ chính xác số của chúng. Kế đến, chừa chỗ cho môi trường chạy và bộ đệm mà mô hình dùng để nhớ các token trước trong lúc tạo token mới. Với dịch vụ nhận nhiều yêu cầu dài cùng lúc, hãy khởi chạy mô hình dự định dùng và theo dõi bộ nhớ trong chính tổ hợp đó. Một câu lệnh ngắn trên card đang rảnh cho biết dịch vụ có khởi động được không. Chạy kéo dài với các đầu vào dài nhất được chấp nhận mới cho biết bạn có thể tiếp tục nhận việc hay không.
Hàng đợi riêng phát huy tác dụng khi tác vụ đến với nhịp khác nhau
Hãy hình dung kho lưu trữ của một trường đại học số hóa cả phỏng vấn lẫn hồ sơ giấy. Khi thử nghiệm, một GPU có thể chạy mô hình tài liệu để OCR, GPU thứ hai chép lời phỏng vấn và GPU thứ ba xử lý bản dịch ngắn. Sau một tuần thu thập số liệu, card thứ tư có thể chạy thêm một phiên bản cho dịch vụ bận nhất. Cấp hàng đợi riêng và xác định lượng việc mỗi dịch vụ được nhận cùng lúc. Như vậy, một lượng trang quét tồn đọng sẽ ít có cơ hội làm chậm bản dịch ngắn do tranh chấp cùng bộ tăng tốc.
Giả sử kho lưu trữ nhận yêu cầu dịch văn bản sau khi OCR. Bạn có thể cho các công đoạn của những tài liệu khác nhau chạy chồng lên nhau. Tài liệu đầu tiên có thể vào bước dịch khi tài liệu thứ hai bắt đầu OCR. Riêng bản dịch của tài liệu nào vẫn cần kết quả OCR từ chính tài liệu đó. Hãy đo thời gian từ lúc tải lên đến khi có kết quả dùng được cho tài liệu đó, cùng với số tài liệu hoàn tất trong cả quy trình. Một thiết kế xử lý nhiều tài liệu hơn mỗi giờ vẫn có thể khiến một dịch giả phải chờ trang cần dùng.
Với một tổ hợp khác, hãy hình dung phòng thí nghiệm kỹ thuật dùng trợ lý đọc tài liệu ban ngày và xử lý nhật ký thiết bị cũ ban đêm. Trợ lý cần phản hồi đầu tiên trong một khoảng dự đoán được sau khi nhà nghiên cứu hỏi. Tác vụ ban đêm cần xong đúng hạn và thường chịu được thời gian tạm dừng. Trước khi dành mỗi dịch vụ một card cố định, hãy đo tỷ lệ thời gian mỗi GPU dành cho các dịch vụ. Nếu trợ lý rảnh phần lớn ngày nhưng đột ngột bận sau buổi họp, phiên bản thứ hai luôn được giữ chỗ vẫn có chi phí trong lúc lưu lượng thấp. Một hệ thống đang xử lý được đợt tăng tải bằng tác vụ theo lịch hoặc hàng đợi riêng là mốc so sánh hữu ích.
Cách bố trí mô hình cũng ảnh hưởng đến phục hồi. Một máy chủ giảm bớt một số việc cấu hình, và tất cả dịch vụ trên đó vẫn phụ thuộc vào máy ấy. Ghi rõ tác vụ nào chờ được sau bảo trì, tác vụ nào cần lên lại trước, và tác vụ nào cần nơi phục vụ thứ hai. Với quy trình tài liệu, lưu kết quả trung gian để khi khởi động lại có thể tiếp tục từ những phần trích xuất đã xong. Với công việc tương tác, thống nhất mức gián đoạn chấp nhận được hoặc chuẩn bị một điểm truy cập khác. Số card trên máy chính cho biết năng lực suy luận khi hoạt động bình thường. Thời gian phục hồi cần một phép thử riêng.
LIQID đo được 89.000 token đầu ra mỗi giây với 20 GPU
Tài liệu thông lượng của LIQID mô tả một mô hình cỡ 7B ở độ chính xác FP4 và mức đồng thời 128 do hãng báo cáo. Mỗi GPU phục vụ một phiên bản riêng. Gộp các card lại, LIQID báo khoảng 89.000 token đầu ra mỗi giây với 20 GPU. Ước tính khoảng 133.000 token mỗi giây cho 30 GPU là ngoại suy từ mức tăng quan sát được trong thử nghiệm 20 GPU. Cả hai con số đều nói về đầu ra cộng gộp của cấu hình đã thử hoặc dự phóng. Nhà nghiên cứu gửi một yêu cầu sẽ gặp thời gian chờ, thời gian xử lý đầu vào và tốc độ tạo token của chính yêu cầu đó. Báo cáo thông lượng và phương pháp thử của LIQID
| Thử nghiệm của LIQID | Số GPU | Tổng token đầu ra mỗi giây | Căn cứ |
|---|---|---|---|
| Cỡ 7B, FP4 | 1 | 4.653 | LIQID đo |
| Cỡ 7B, FP4 | 10 | 44.383 | LIQID đo |
| Cỡ 7B, FP4 | 20 | Khoảng 89.000 | LIQID đo |
| Cỡ 7B, FP4 | 30 | Khoảng 133.000 | LIQID ngoại suy từ 20 GPU |
| Cỡ 72B, FP8, có giới hạn độ trễ tương tác | 8 | 1.256 | Phép đo riêng của LIQID |
Thử nghiệm 72B FP8 riêng đặt mục tiêu có token đầu tiên trong tối đa hai giây ở phân vị 99 và ít nhất 30 token đầu ra mỗi giây cho mỗi người dùng. LIQID báo kết quả đo với 2, 4 và 8 card trong thử nghiệm đó. Kích cỡ mô hình, độ chính xác số và điều kiện phục vụ khác phép đo thông lượng 7B. Dùng kết quả tương tác làm tham chiếu cho loại thử nghiệm này, rồi áp dụng ngưỡng độ trễ của bạn cho các câu lệnh và mức đồng thời dự kiến. Phương pháp đo và kết quả tương tác của LIQID
Các số của mô hình 7B cho thấy vì sao nên lặp lại cùng phép đo khi thêm những phiên bản mô hình giống hệt. Với nhóm lên kế hoạch chạy nhiều loại tác vụ, còn một câu hỏi khác. Nếu yêu cầu phải đọc nhiều tệp nhỏ, lấy dữ liệu từ kho lưu trữ để dựng ngữ cảnh, hoặc chờ CPU chuẩn bị ảnh thì sao? Chạy lại cùng dấu vết tải hai lần với cùng mô hình và số GPU, trước tiên với từng dịch vụ riêng, rồi với cả tổ hợp. Nếu chạy kết hợp làm tăng thời gian chờ trong khi mức dùng GPU vẫn thấp, hãy kiểm tra CPU của máy chủ, hoạt động hệ thống tệp và cách định tuyến yêu cầu trước khi bổ sung bộ tăng tốc.
Đo kết quả dùng được trong giới hạn độ trễ
Bắt đầu với bài thử mà hệ thống hiện tại có thể chạy. Chẳng hạn, lấy một bộ gồm 200 tài liệu đại diện đã được duyệt với ngôn ngữ và số trang quét đã biết, sau đó phát lại nhật ký thời điểm các yêu cầu tương tác đến đã được ẩn danh, đồng thời với lô tài liệu. Giữ nguyên tổ hợp đầu vào trên hai hệ thống. Nếu thay đổi phần cứng hoặc phần mềm buộc phải đổi độ chính xác số, hãy kiểm tra lại chất lượng kết quả trên cùng mẫu. Chỉ đếm kết quả hoàn chỉnh và vượt qua các bước kiểm tra thông thường của nhóm.
- Xác định kết quả đạt yêu cầu. Với trợ lý, đặt mục tiêu cho phản hồi đầu tiên và toàn bộ quá trình. Chẳng hạn, token đầu tiên trong hai giây ở phân vị 95 trên mẫu tương tác. Với trích xuất hàng loạt, chọn hạn chót mỗi ngày và số trang tối thiểu vượt qua bước xác thực. Đây là những ngưỡng ví dụ cho bài thử đề xuất. Trong thử nghiệm 72B riêng, LIQID đặt giới hạn token đầu tiên ở phân vị 99.
- Ghi thời gian ở từng chặng của mỗi yêu cầu. Ghi lúc yêu cầu đến, lúc một tiến trình bắt đầu xử lý, lúc có kết quả đầu tiên và lúc kết thúc. Gắn nhãn theo loại tác vụ và ghi các lần thử lại. Dựa vào các mốc đó, bạn có thể so sánh thời gian chờ trong hàng đợi riêng với thời gian hệ thống thực sự xử lý. Tổng thời gian có thể che mất một hàng đợi dài nếu suy luận chỉ chiếm một phần ngắn.
- Thay đổi một yếu tố rồi phát lại lưu lượng. So sánh hàng đợi chung với các hàng đợi riêng trong khi vẫn giữ nguyên từng phiên bản mô hình trên đúng card. Sau đó tách thay đổi cách chia card thành thử nghiệm khác. Giữ nguyên giới hạn độ dài câu lệnh và đầu ra, thứ tự đầu vào và bước kiểm tra chất lượng. Dùng cùng cách làm nóng hệ thống trước mỗi lượt. Xem cả giai đoạn đông yêu cầu lẫn lưu lượng trung bình. Một tác vụ lớn đến không đúng lúc là khi hàng đợi riêng cần cho thấy tác dụng.
- Xem số liệu máy chủ và đồng hồ đo cùng kết quả. Trong cùng khoảng thời gian, ghi mức dùng bộ tăng tốc và bộ nhớ, CPU và RAM máy chủ, hoạt động đọc ghi và công suất điện đầu vào của hệ thống. Báo thời gian hoàn tất ở phân vị 95 theo loại tác vụ, số trang hoặc yêu cầu thành công mỗi giờ, và năng lượng trên mỗi kết quả đạt. Xem số yêu cầu bị loại và hết thời gian chờ bên cạnh các phân vị để chúng vẫn hiện rõ trong đánh giá.
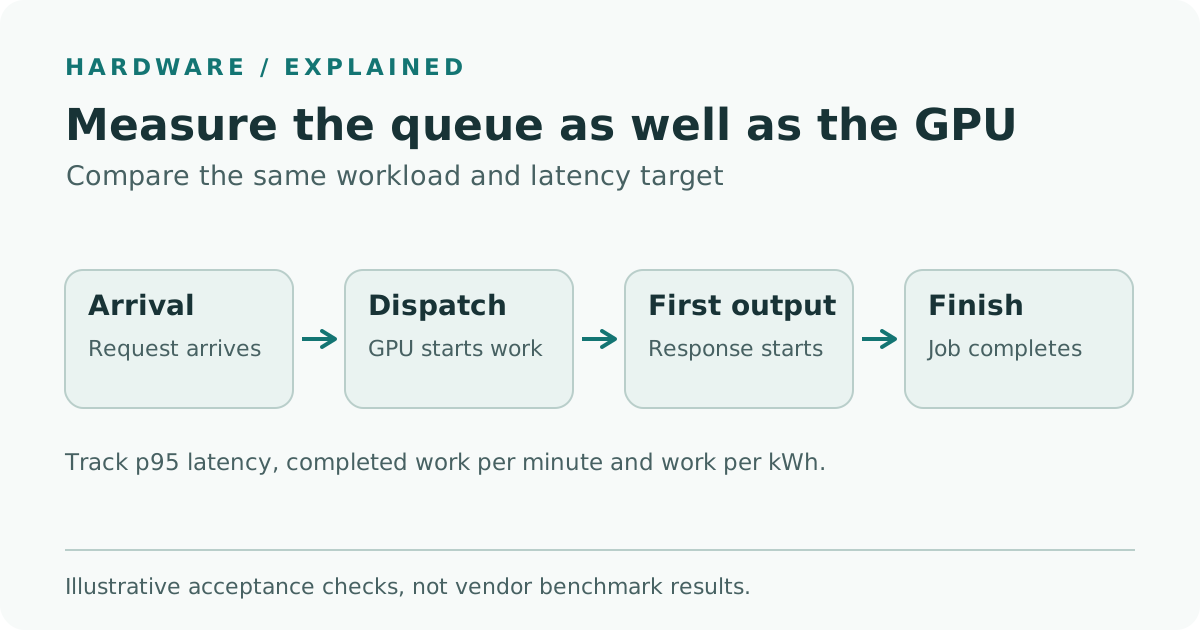
Minh họa của Telli.sh về bài thử nghiệm thu đề xuất. Thay đổi về thời gian chờ, phản hồi đầu tiên hoặc hoàn tất có thể chỉ ra những giới hạn khác nhau.
Vẽ riêng phân bố độ trễ cho từng dịch vụ. P95 là ngưỡng thời gian mà 95% sự kiện đo được hoàn thành trước hoặc đúng ngưỡng. P95 có thể thay đổi dù trung vị đứng yên, điều đáng quan tâm nếu một nhà phân tích thường bắt đầu công việc vào lúc đông nhất. Ghi số quan sát của từng phân bố. Phân vị từ năm tác vụ chạy qua đêm cho biết một điều khác với phân vị từ hàng trăm yêu cầu tương tác. Nếu dịch vụ bận liên tục giảm thời gian chờ, giữ chất lượng tương đương và ít hết hạn hơn, đó là cơ sở tốt hơn để cấp card riêng so với một con số thông lượng cực đại.
Bài so sánh cũng cần giữ cùng phạm vi đo. Để tính hiệu quả năng lượng, đếm đầu ra dùng được trong một khoảng cố định và đo điện của cùng nhóm thiết bị ở cả hai cấu hình. Nếu chỉ đo máy chủ và các khung GPU, gọi kết quả là năng lượng của hệ thống CNTT. Nếu tính cả kho lưu trữ dùng chung hoặc làm mát, hãy áp dụng nhất quán cho cả hai thiết kế. Ghi công suất khi để rảnh đối với dịch vụ chạy suốt ngày đêm. Hệ thống nhanh có ít phút làm việc hơn cho mỗi tác vụ, nhưng một hệ thống đứng chờ cả đêm với công suất rảnh cao hơn có thể dùng nhiều điện hơn trong ngày.
Con số 22 kW cần được xem xét theo nơi lắp đặt
LIQID nêu khoảng 22 kW cho cả hệ thống đủ 30 GPU làm mát bằng không khí. AMD công bố công suất bo mạch điển hình tối đa 600 W mỗi MI350P và mức cấu hình được 450 W. Nhân 30 với 600 W cho 18 kW đối với riêng các card ở mức công suất bo mạch đó. Mức khoảng 22 kW do LIQID báo áp dụng cho cả hệ thống rộng hơn. Điện toàn cơ sở, cấu hình giá máy và khả năng làm mát phụ thuộc vào nơi lắp đặt. Chạy ở 450 W cũng có thể đổi thông lượng hữu ích, vì vậy hãy so sánh hai mức điện trên cùng tải và cùng tiêu chí chất lượng nếu hãng hỗ trợ cả hai cho cấu hình báo giá. Hướng dẫn công suất hệ thống của LIQID · Thông số bo mạch AMD MI350P
Mời nhóm quản lý cơ sở tham gia trước khi chọn cấu hình lớn hơn. Xem lại số khung chính xác, khả năng tải điện của mạch khi chạy bình thường và khi dùng nguồn dự phòng, khả năng giải nhiệt ở điều kiện khí đầu vào của bạn và liệu nơi lắp có chịu được tải quay lại mức tối đa ngay sau khi khởi động lại hay không. Dùng báo giá để xác định bên nào phụ trách dịch vụ, hỗ trợ và điều chỉnh điện năng. Theo dõi những mục đó cùng chi phí do hàng đợi tài liệu kéo dài. Một máy chủ có thể giảm số máy cần quản lý, nhưng mật độ công suất của nó có thể thay đổi danh sách phòng phù hợp.
LIQID quảng bá hệ thống 4 đến 30 GPU qua quy trình đặt hàng với đối tác, tùy hàng có sẵn. Trang sản phẩm mô tả quy trình giao hàng 4–6 tuần và gắn mốc bốn tuần được quảng bá với thời điểm xác nhận đơn đặt mua. Hãy xin báo giá cấu hình có ghi ngày và cam kết giao cho đúng nơi lắp đặt. LIQID ghi lịch triển lãm SC26 tại McCormick Place bắt đầu ngày 17 tháng 11. Hướng dẫn đặt hàng qua đối tác và giao hàng của LIQID · Thông báo SC26 của LIQID
Bạn sẵn sàng trả tiền để bỏ bao nhiêu thời gian chờ?
Một bộ tăng tốc dành riêng cho dịch có thể đáng tiền nếu nhóm sau cần đoạn đã dịch ngay. Cũng card đó có thể rảnh gần cả tuần ở nơi mọi bản dịch đều chờ tới ngày mai được. Bắt đầu với cấu hình nhỏ nhất mô phỏng được các tác vụ đồng thời của phòng thí nghiệm, rồi lặp lại vài lần khoảng bận nhất. Tăng năng lực ở nơi chờ ít hơn thực sự cải thiện kết quả. Với kho lưu trữ, điều kiện nghiệm thu có thể cụ thể đến mức kỹ thuật viên nhận câu trả lời đúng lúc trong khi toàn bộ lô quét của ngày vẫn hoàn tất trước khi bàn giao.
Nguồn
- Thông báo SC26 và hình ảnh UltraStack chính thức của LIQID, ngày 12 tháng 11 năm 2026
- Trang sản phẩm LIQID UltraStack với AMD Instinct MI350P và thông tin đặt hàng, công suất, kiểm tra ngày 15 tháng 11 năm 2026
- Bảng thông số LIQID UltraStack, kiểm tra ngày 15 tháng 11 năm 2026
- Phương pháp và kết quả đo giai đoạn 3 của LIQID, kiểm tra ngày 15 tháng 11 năm 2026
- Thông số card AMD Instinct MI350P, kiểm tra ngày 15 tháng 11 năm 2026
- Lịch chính thức của hội nghị và triển lãm SC26 năm 2026
Để lưu ghi chú thử nghiệm, biểu đồ và quyết định triển khai ở cùng một nơi có thể tìm kiếm, tạo tài khoản Telli.sh.