GPU 30 ตัวบนเซิร์ฟเวอร์เดียวช่วยลดเวลารอคิว AI ในห้องแล็บได้ไหม?
LIQID UltraStack ให้โมเดลแต่ละอินสแตนซ์ใช้การ์ด AMD Instinct MI350P ของตัวเอง เทียบผลวัดของผู้ผลิตที่ 20 GPU กับค่าคาดการณ์ที่ 30 GPU แล้วทดสอบเวลารอที่นักวิจัยเจอจริง
เก้าโมงเช้า ทีมวิจัยเริ่มดึงข้อความจากเอกสารที่สแกนไว้เมื่อวาน อีกทีมส่งบันทึกมาแปล ส่วนทีมที่สามอยากหาคำตอบสั้น ๆ จากคู่มือเครื่องมือวิจัย ถ้าทั้งหมดใช้คิวประมวลผลเดียวกัน คำถามสั้น ๆ อาจต้องรอหลังเอกสารชุดใหญ่ พอคำตอบมาถึง คนที่ต้องการอาจกลับไปเปิด PDF หาเองแล้ว
วันที่ 12 พฤศจิกายน 2026 ผู้ให้บริการโครงสร้างพื้นฐาน LIQID อธิบายการจัดระบบ UltraStack ที่เชื่อมตัวเร่ง AMD Instinct MI350P จำนวน 4 ถึง 30 ตัวกับโฮสต์ AMD EPYC 9005 แบบสองซ็อกเก็ตหนึ่งเครื่อง แบบให้บริการที่เผยแพร่ใช้โมเดลหนึ่งอินสแตนซ์ต่อการ์ดหนึ่งใบ งาน OCR จึงทำต่อได้ระหว่างที่ GPU คนละตัวจัดการงานแปลหรือตอบคำถาม LIQID ประกาศว่าจะสาธิตในงาน SC26 ที่ชิคาโก ช่วงนิทรรศการมีกำหนดวันที่ 17–19 พฤศจิกายน ประกาศวันที่ 12 พฤศจิกายนและภาพระบบอย่างเป็นทางการของ LIQID · กำหนดการ SC26
แนวทางนี้เหมาะเมื่อห้องแล็บต้องให้งานหลายอย่างเสร็จตามเวลา และแต่ละโมเดลใส่ในการ์ดใบเดียวได้ เริ่มจากระยะเวลาที่คนต้องรอ แล้วดูว่าการแยก GPU จะลดส่วนที่เกิดจากงานอื่นได้ไหม ข้อจำกัดต่อไปจะอยู่ตรงไหน และผลที่ดีขึ้นคุ้มกับค่าไฟและค่าระบบหรือไม่ คำถามส่วนใหญ่ทดสอบได้ด้วยระบบทดลองที่เล็กกว่ารุ่นติดตั้งการ์ดครบมาก
GPU แต่ละตัวมีหน่วยความจำของตัวเอง 144 GB
ในผังที่ LIQID เผยแพร่ โฮสต์ AMD EPYC เชื่อมการ์ด MI350P ผ่านโครงข่าย PCIe Gen 5 การ์ดอาจอยู่ในแชสซี GPU แยกที่ต่อกับโฮสต์ AMD ระบุว่าการ์ด MI350P แต่ละใบมี HBM3E เฉพาะตัว 144 GB และอินเทอร์เฟซ PCIe 5.0 x16 เมื่อวางโมเดลหนึ่งตัวต่อการ์ดหนึ่งใบ โมเดลจะใช้หน่วยความจำของ GPU ที่ได้รับจัดสรร โมเดลแต่ละอินสแตนซ์รับคำขอหลายรายการได้ภายในขีดจำกัดของซอฟต์แวร์ให้บริการและหน่วยความจำ เอกสารข้อมูล LIQID UltraStack · สเปก AMD MI350P
การ์ด 20 ใบมี HBM3E รวม 2.88 TB เมื่อใช้หน่วยฐานสิบ ตัวเลขนี้ช่วยนับว่าระบบรองรับโมเดลที่ทำงานแยกกันได้กี่อินสแตนซ์ สำหรับงานที่อยู่บนการ์ดใบที่เจ็ด จุดตั้งต้นยังคงเป็น 144 GB ถ้าโมเดลจะรันได้ก็ต่อเมื่อกระจายพารามิเตอร์และสถานะการทำงานไปหลาย GPU ให้ประเมินวิธีกระจายงานนั้นและทดสอบประสิทธิภาพแยกโดยตรง ตัวเลขการเพิ่มขนาดของ LIQID ครอบคลุมอินสแตนซ์อิสระที่รันบนการ์ดคนละใบ การจัดการทดสอบและตัวเลขหน่วยความจำของ LIQID
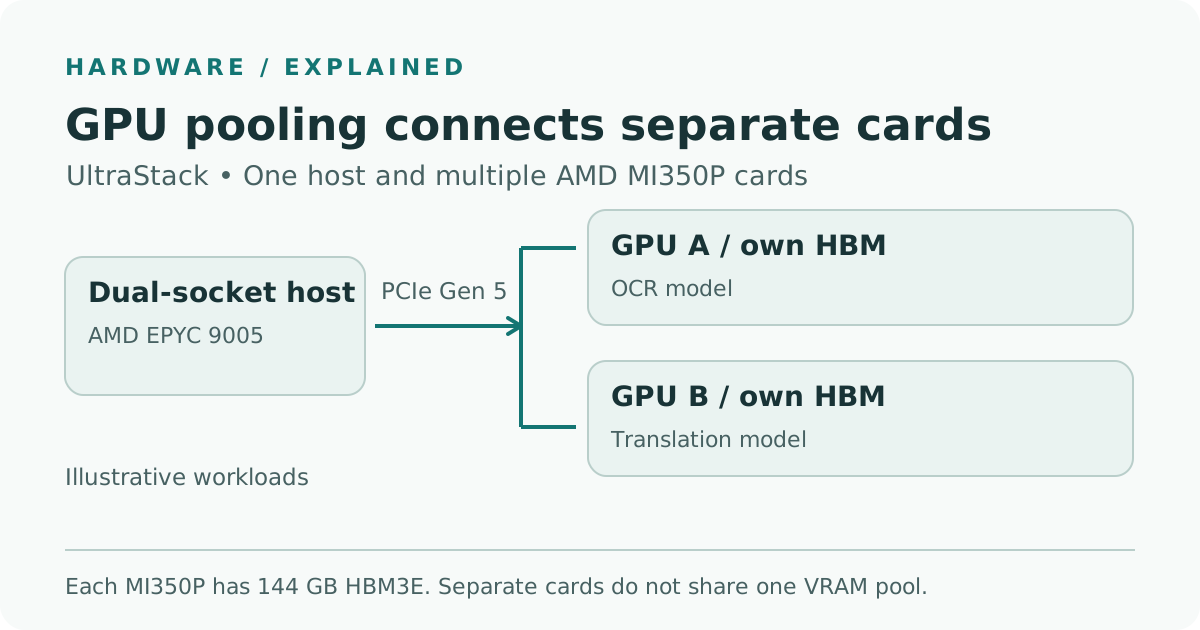
ภาพประกอบจาก Telli.sh อ้างอิงคำอธิบายฮาร์ดแวร์ของ LIQID และสเปกการ์ดของ AMD แผนภาพแสดงตัวอย่างการให้บริการแบบแยกกัน และละรายละเอียดแชสซีกับอุปกรณ์ต่อพ่วงของโฮสต์ไว้
จำนวนพารามิเตอร์ช่วยคัดตัวเลือกให้เหลือน้อยลง แต่โมเดลสองตัวที่มีจำนวนเท่ากันอาจใช้หน่วยความจำต่างกัน เริ่มจากค่าน้ำหนักจริงและความละเอียดเชิงตัวเลขที่ใช้ จากนั้นเผื่อให้รันไทม์และแคชที่โมเดลใช้เก็บข้อมูลโทเคนก่อนหน้าระหว่างสร้างโทเคนเพิ่ม สำหรับบริการที่รับคำขอยาวหลายรายการพร้อมกัน ให้เปิดโมเดลที่จะใช้แล้วสังเกตหน่วยความจำกับงานผสมแบบนั้น การลองคำสั่งสั้น ๆ บนการ์ดที่ว่างบอกได้ว่าบริการเริ่มได้หรือไม่ การรันต่อเนื่องกับอินพุตยาวที่สุดที่อนุญาตบอกได้ว่าจะรับงานต่อไปได้ไหม
คิวแยกช่วยเมื่องานเข้ามาคนละจังหวะ
ลองนึกถึงคลังเอกสารของมหาวิทยาลัยที่กำลังแปลงทั้งบทสัมภาษณ์และเอกสารกระดาษเป็นดิจิทัล ในการทดลอง อาจให้ GPU หนึ่งตัวรันโมเดล OCR อีกตัวถอดเสียงบทสัมภาษณ์ และตัวที่สามรับงานแปลสั้น ๆ หลังเก็บข้อมูลหนึ่งสัปดาห์ การ์ดใบที่สี่อาจเปิดอินสแตนซ์เสริมให้บริการที่ยุ่งที่สุด ให้แต่ละบริการมีคิวของตัวเองและกำหนดจำนวนงานที่จะรับพร้อมกัน เอกสารสแกนที่ค้างจึงมีโอกาสน้อยลงที่จะทำให้งานแปลสั้น ๆ ช้าเพราะแย่งใช้ตัวเร่งตัวเดียวกัน
สมมติว่าคลังได้รับคำขอให้แปลข้อความต่อจาก OCR แต่ละขั้นสามารถคาบเกี่ยวกันได้เมื่อทำงานกับคนละเอกสาร เอกสารฉบับแรกอาจเข้าสู่ขั้นแปล ขณะที่ฉบับที่สองเริ่ม OCR ส่วนการแปลเอกสารแต่ละฉบับยังต้องรอผล OCR ของฉบับนั้น วัดเวลาตั้งแต่อัปโหลดจนได้ผลที่นำไปใช้ได้สำหรับเอกสารนั้น พร้อมกับจำนวนเอกสารที่เสร็จตลอดกระบวนการ ระบบที่ทำได้หลายฉบับขึ้นต่อชั่วโมงยังอาจทำให้คนแปลต้องรอหน้าที่ต้องใช้
อีกแบบหนึ่งคือห้องแล็บวิศวกรรมที่ใช้ผู้ช่วยอ่านเอกสารในเวลากลางวันและประมวลผลบันทึกเครื่องมือเก่าในเวลากลางคืน ผู้ช่วยต้องเริ่มตอบในเวลาที่คาดการณ์ได้หลังนักวิจัยถาม งานกลางคืนมีกำหนดเสร็จและมักหยุดพักเป็นช่วงได้ วัดสัดส่วนเวลาที่ GPU แต่ละตัวใช้กับบริการเหล่านี้ก่อนจัดการ์ดประจำให้แต่ละบริการ ถ้าผู้ช่วยว่างเกือบทั้งวันแต่งานเข้าพร้อมกันหลังประชุมแล็บ การกันอินสแตนซ์ที่สองไว้ตลอดก็มีต้นทุนในช่วงที่คำขอน้อย ระบบเดิมที่รับช่วงงานพุ่งด้วยการจัดตารางหรือแยกคิวได้อยู่แล้วเป็นตัวเทียบที่ดี
การวางโมเดลมีผลกับการกู้ระบบด้วย โฮสต์เดียวช่วยลดงานตั้งค่าบางส่วน และทุกบริการยังพึ่งเครื่องนั้นอยู่ จดว่างานใดรอหลังการบำรุงรักษาได้ บริการใดต้องกลับมาก่อน และงานใดต้องมีจุดให้บริการสำรอง สำหรับสายงานเอกสาร ให้บันทึกผลระหว่างขั้นเพื่อเริ่มต่อจากส่วนที่ดึงข้อความเสร็จแล้ว สำหรับงานโต้ตอบ ให้ตกลงช่วงเวลาที่ระบบหยุดได้หรือเตรียมจุดเชื่อมต่ออื่น จำนวนการ์ดบนโฮสต์หลักบอกความสามารถในการอนุมานเมื่อระบบทำงานตามปกติ ส่วนเวลากู้ระบบต้องทดสอบแยก
LIQID วัดได้ 89,000 โทเคนเอาต์พุตต่อวินาทีที่ 20 GPU
รายงานอัตราประมวลผลของ LIQID ระบุโมเดลระดับ 7B ที่ใช้ FP4 และค่าการทำงานพร้อมกันที่ 128 โดย GPU แต่ละตัวให้บริการอินสแตนซ์ของตัวเอง เมื่อนับรวมทุกการ์ด LIQID รายงานประมาณ 89,000 โทเคนเอาต์พุตต่อวินาทีที่ 20 GPU ค่าประมาณ 133,000 โทเคนเอาต์พุตต่อวินาทีสำหรับ 30 GPU มาจากการขยายแนวโน้มที่วัดได้ในการทดสอบ 20 GPU ทั้งสองตัวเลขเป็นอัตราเอาต์พุตรวมของระบบที่วัดหรือคาดการณ์ นักวิจัยที่ส่งคำขอเดียวจะเจอเวลารอคิว เวลาประมวลผลอินพุต และความเร็วสร้างคำตอบของคำขอนั้น รายงานอัตราประมวลผลและวิธีทดสอบของ LIQID
| การทดสอบของ LIQID | จำนวน GPU | โทเคนเอาต์พุตรวมต่อวินาที | ที่มาของตัวเลข |
|---|---|---|---|
| ระดับ 7B, FP4 | 1 | 4,653 | LIQID วัด |
| ระดับ 7B, FP4 | 10 | 44,383 | LIQID วัด |
| ระดับ 7B, FP4 | 20 | ประมาณ 89,000 | LIQID วัด |
| ระดับ 7B, FP4 | 30 | ประมาณ 133,000 | LIQID คาดการณ์จาก 20 GPU |
| ระดับ 72B, FP8 มีข้อจำกัดด้านเวลาโต้ตอบ | 8 | 1,256 | ผลวัดอีกชุดของ LIQID |
การทดสอบ 72B FP8 อีกชุดตั้งเป้าให้ได้โทเคนแรกภายในสองวินาทีที่เปอร์เซ็นไทล์ 99 และสร้างโทเคนเอาต์พุตอย่างน้อย 30 ตัวต่อวินาทีต่อผู้ใช้ LIQID รายงานผลวัดการทดลองนี้บนการ์ด 2, 4 และ 8 ใบ ขนาดโมเดล ความละเอียดเชิงตัวเลข และเงื่อนไขให้บริการต่างจากการวัดอัตราประมวลผลของ 7B ใช้ผลการโต้ตอบเป็นค่าอ้างอิงสำหรับการทดสอบลักษณะนี้ แล้วใช้เป้าหมายเวลาแฝงของคุณกับคำสั่งและจำนวนคำขอพร้อมกันที่คาดไว้ วิธีทดสอบและผลการโต้ตอบของ LIQID
ตัวเลข 7B แสดงประโยชน์ของการรันการทดสอบเดิมซ้ำเมื่อเพิ่มอินสแตนซ์โมเดลที่เหมือนกัน สำหรับทีมที่วางแผนงานผสม ยังมีคำถามอีกข้อ ถ้าคำขอใช้เวลาส่วนหนึ่งไปกับการอ่านไฟล์เล็กหลายไฟล์ ประกอบบริบทจากระบบจัดเก็บ หรือรอ CPU เตรียมภาพจะเกิดอะไรขึ้น? เล่นรูปแบบคำขอเดิมซ้ำสองครั้ง โดยใช้โมเดลและจำนวน GPU เท่าเดิม รอบแรกแยกแต่ละบริการ รอบที่สองเปิดทั้งหมดพร้อมกัน ถ้าการเปิดพร้อมกันทำให้รอคิวนานขึ้นทั้งที่การใช้งาน GPU ยังต่ำ ให้ตรวจ CPU ของโฮสต์ กิจกรรมระบบไฟล์ และการส่งคำขอ ก่อนเพิ่มตัวเร่ง
วัดผลงานที่ใช้ได้ภายใต้เพดานเวลาแฝง
เริ่มจากการทดสอบที่ระบบปัจจุบันรันได้ เช่น ใช้เอกสารตัวอย่าง 200 ฉบับที่ได้รับอนุญาตและทราบภาษาและจำนวนหน้าสแกน แล้วให้คำขอแบบโต้ตอบเข้ามาตามเวลาที่บันทึกไว้โดยลบข้อมูลระบุตัวตน พร้อมกับประมวลผลชุดเอกสาร ใช้ส่วนผสมอินพุตเดิมทั้งสองระบบ หากการเปลี่ยนฮาร์ดแวร์หรือซอฟต์แวร์ต้องเปลี่ยนความละเอียดเชิงตัวเลข ให้ตรวจคุณภาพผลลัพธ์ซ้ำกับตัวอย่างเดิม นับเฉพาะงานที่เสร็จและผ่านการตรวจตามปกติของทีม
- กำหนดว่าผลที่ผ่านเกณฑ์เป็นอย่างไร สำหรับผู้ช่วย ให้ตั้งเป้าการเริ่มตอบและเวลาตั้งแต่ต้นจนจบ เช่น ได้โทเคนแรกภายในสองวินาทีที่เปอร์เซ็นไทล์ 95 ของตัวอย่างคำขอแบบโต้ตอบ สำหรับงานดึงข้อมูลเป็นชุด ให้กำหนดเวลาส่งงานรายวันและจำนวนหน้าขั้นต่ำที่ต้องผ่านการตรวจ นี่คือเกณฑ์ตัวอย่างสำหรับการทดสอบที่เสนอ ส่วนการทดลอง 72B อีกชุดของ LIQID ใช้ขีดจำกัดเวลาได้โทเคนแรกที่เปอร์เซ็นไทล์ 99
- บันทึกว่าคำขอใช้เวลาที่ช่วงไหน จดเวลาที่คำขอเข้ามา เวลาที่ตัวประมวลผลเริ่มทำงาน เวลาออกผลแรก และเวลาที่เสร็จ ระบุประเภทงานและบันทึกการลองใหม่ เวลาเหล่านี้ช่วยแยกเวลารอในคิวออกจากเวลาที่ระบบลงมือประมวลผล ตัวเลขรวมค่าเดียวอาจซ่อนคิวยาวไว้เมื่อการอนุมานใช้เวลาเพียงสั้น ๆ
- เปลี่ยนทีละอย่างแล้วเล่นคำขอเดิมซ้ำ เทียบคิวรวมกับคิวแยกโดยให้โมเดลแต่ละอินสแตนซ์อยู่บนการ์ดใบเดิม จากนั้นค่อยแยกทดสอบการเปลี่ยนวิธีจัดสรรการ์ด ใช้ขีดจำกัดคำสั่งและผลลัพธ์ ลำดับอินพุต และเกณฑ์คุณภาพชุดเดิม อุ่นระบบเหมือนกันก่อนแต่ละรอบ ตรวจทั้งช่วงงานล้นและช่วงงานเฉลี่ย งานใหญ่ที่เข้าผิดจังหวะคือช่วงที่คิวแยกควรแสดงผลให้เห็น
- ดูค่าของโฮสต์และมิเตอร์ควบคู่กับผล ในช่วงเวลาเดียวกัน ให้จดอัตราใช้งานตัวเร่งและหน่วยความจำ การใช้ CPU และ RAM ของโฮสต์ การอ่านเขียน และกำลังไฟฟ้าขาเข้าระบบ รายงานเวลาเสร็จที่เปอร์เซ็นไทล์ 95 แยกตามประเภทงาน จำนวนหน้าหรือคำขอที่สำเร็จต่อชั่วโมง และพลังงานต่อผลที่สำเร็จ ดูจำนวนงานที่ถูกตัดทิ้งและหมดเวลาควบคู่กับเปอร์เซ็นไทล์ เพื่อให้มองเห็นงานที่ไม่ได้รับการประมวลผลด้วย
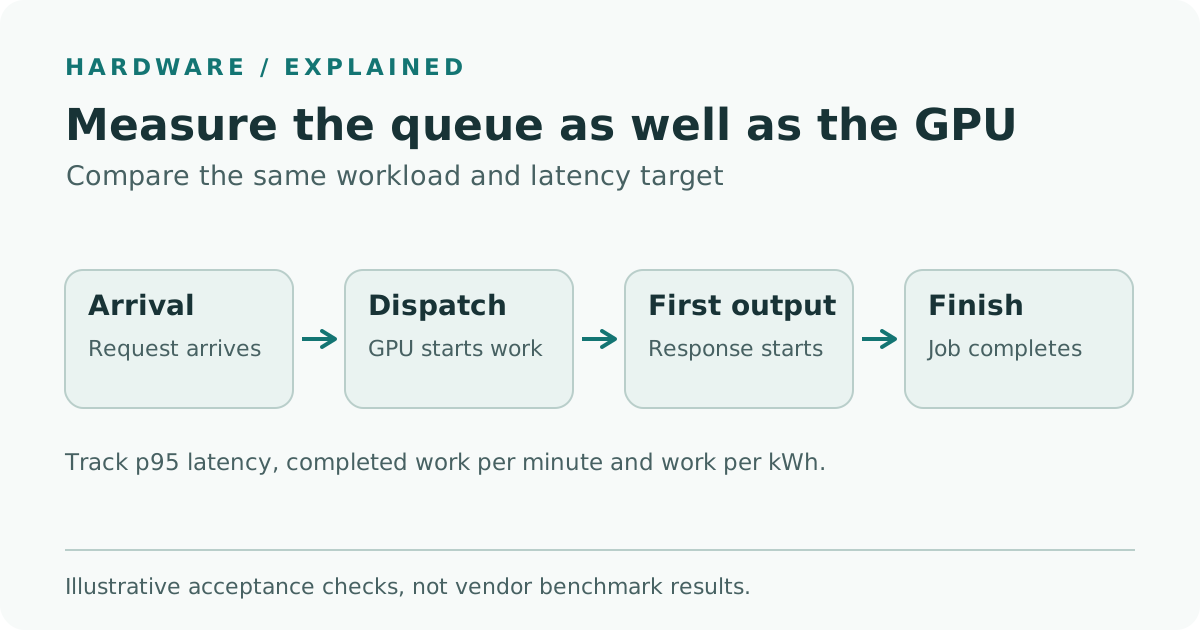
ภาพประกอบจาก Telli.sh สำหรับการทดสอบรับมอบที่เสนอ การเปลี่ยนแปลงของเวลารอคิว เวลาเริ่มตอบ หรือเวลาเสร็จอาจชี้ไปที่ข้อจำกัดคนละจุด
สร้างกราฟแจกแจงเวลาแฝงของแต่ละบริการแยกกัน P95 คือเวลาที่งาน 95 เปอร์เซ็นต์จากการวัดเสร็จภายในนั้น ค่านี้เปลี่ยนได้แม้ค่ามัธยฐานจะนิ่ง ซึ่งมีผลหากนักวิเคราะห์เริ่มทำงานตรงช่วงที่คำขอหนาแน่นเป็นประจำ จดจำนวนตัวอย่างของแต่ละกราฟด้วย เปอร์เซ็นไทล์จากงานกลางคืนห้างานสื่อคนละอย่างกับค่าที่มาจากคำขอแบบโต้ตอบหลายร้อยรายการ หากบริการช่วงที่ยุ่งรอคิวสั้นลงต่อเนื่อง คุณภาพใกล้เคียงเดิม และหมดเวลาน้อยลง นั่นเป็นหลักฐานในการจัดการ์ดเฉพาะที่ดีกว่าตัวเลขอัตราประมวลผลสูงสุด
การเปรียบเทียบต้องใช้ขอบเขตการวัดเดียวกันด้วย เพื่อดูประสิทธิภาพพลังงาน ให้นับผลที่ใช้ได้ในช่วงเวลาคงที่และวัดไฟของอุปกรณ์กลุ่มเดียวกันทั้งสองระบบ หากวัดเฉพาะเซิร์ฟเวอร์และแชสซี GPU ให้ระบุว่าเป็นพลังงานของระบบไอที ถ้านับระบบจัดเก็บร่วมและการทำความเย็น ให้รวมแบบเดียวกันทั้งสองระบบ จดกำลังไฟช่วงว่างด้วยเมื่อประเมินบริการที่เปิดตลอดวัน ระบบที่เร็วกว่าทำงานต่อรายการในเวลาน้อยลง แต่ระบบที่เปิดรอตลอดคืนด้วยกำลังไฟขณะว่างที่สูงกว่าอาจใช้พลังงานรวมต่อวันมากขึ้น
ตัวเลข 22 kW ต้องดูร่วมกับสถานที่ติดตั้ง
LIQID ระบุว่าระบบระบายความร้อนด้วยอากาศที่ติดตั้ง GPU ครบ 30 ตัวใช้ไฟประมาณ 22 kW AMD ระบุกำลังไฟบอร์ดสูงสุดตามสภาพใช้งานทั่วไปที่ 600 W ต่อ MI350P และปรับเป็น 450 W ได้ เมื่อคูณ 30 ด้วย 600 W จะได้ 18 kW เฉพาะการ์ดที่ระดับกำลังไฟนั้น ส่วนตัวเลข 22 kW ครอบคลุมระบบโดยรวม ไฟที่สถานที่ใช้ การจัดไฟและพื้นที่แร็ก และความสามารถในการระบายความร้อนขึ้นอยู่กับจุดติดตั้ง การตั้ง 450 W อาจเปลี่ยนอัตรางานที่ใช้ได้ด้วย จึงควรเทียบทั้งสองระดับไฟด้วยภาระงานและเกณฑ์คุณภาพชุดเดียวกัน ถ้าผู้ขายรองรับทั้งสองค่าในสเปกที่เสนอราคา ข้อมูลกำลังไฟระบบจาก LIQID · สเปกบอร์ด AMD MI350P
ให้ทีมดูแลอาคารและระบบไฟเข้ามาร่วมก่อนเลือกรุ่นใหญ่ขึ้น ตรวจจำนวนแชสซี พิกัดวงจรในภาวะปกติและขณะใช้ระบบสำรอง ความสามารถในการระบายความร้อนที่สภาวะอากาศขาเข้าของพื้นที่ และความพร้อมรับโหลดกลับขึ้นเต็มทันทีหลังรีสตาร์ต ใช้ใบเสนอราคาเพื่อดูว่าใครรับผิดชอบงานบริการ การสนับสนุน และการปรับกำลังไฟ พิจารณาเรื่องเหล่านี้ควบคู่กับต้นทุนของคิวเอกสารที่ยาว แม้โฮสต์เดียวอาจลดจำนวนเซิร์ฟเวอร์ที่ต้องดูแล ความหนาแน่นของกำลังไฟก็อาจเปลี่ยนว่าห้องใดใช้วางระบบได้
LIQID เสนอระบบ 4 ถึง 30 GPU ผ่านกระบวนการสั่งซื้อกับพาร์ตเนอร์ โดยขึ้นอยู่กับสินค้าคงเหลือ หน้าผลิตภัณฑ์อธิบายกระบวนการจัดส่ง 4–6 สัปดาห์ และระบุว่าระยะเวลาสี่สัปดาห์ที่โฆษณานับจากการยืนยันใบสั่งซื้อ ขอใบเสนอราคาที่ระบุวันที่ สเปก และกำหนดส่งสำหรับจุดติดตั้งจริง LIQID แจ้งกำหนดออกแสดงที่ McCormick Place ในงาน SC26 ตั้งแต่ 17 พฤศจิกายน ข้อมูลสั่งซื้อผ่านพาร์ตเนอร์และการจัดส่งของ LIQID · ประกาศงาน SC26 ของ LIQID
เวลารอที่ลดลงเท่าไรจึงคุ้มที่จะจ่าย?
ตัวเร่งที่จัดไว้ให้แปลโดยเฉพาะอาจคุ้มถ้าทีมถัดไปต้องใช้ข้อความแปลทันที การ์ดใบเดียวกันอาจว่างเกือบทั้งสัปดาห์ที่งานแปลทุกชิ้นรอถึงวันพรุ่งนี้ได้ ให้เริ่มจากระบบที่เล็กที่สุดที่จำลองงานพร้อมกันในห้องแล็บได้ แล้วทดสอบช่วงที่ยุ่งที่สุดซ้ำหลายรอบ เพิ่มขีดความสามารถตรงที่การรอสั้นลงยังช่วยให้งานดีขึ้น สำหรับคลังเอกสาร เกณฑ์รับมอบอาจชัดเจนถึงขั้นที่ช่างเทคนิคได้คำตอบทันเวลา ขณะที่เอกสารสแกนทั้งชุดของวันก็เสร็จก่อนส่งงานต่อ
แหล่งข้อมูล
- ประกาศ SC26 และภาพ UltraStack อย่างเป็นทางการของ LIQID วันที่ 12 พฤศจิกายน 2026
- หน้าผลิตภัณฑ์ LIQID UltraStack ที่ใช้ AMD Instinct MI350P พร้อมข้อมูลการสั่งซื้อและกำลังไฟ ตรวจเมื่อ 15 พฤศจิกายน 2026
- เอกสารข้อมูล LIQID UltraStack ตรวจเมื่อ 15 พฤศจิกายน 2026
- วิธีและผลทดสอบประสิทธิภาพระยะที่ 3 ของ LIQID ตรวจเมื่อ 15 พฤศจิกายน 2026
- สเปกการ์ด AMD Instinct MI350P ตรวจเมื่อ 15 พฤศจิกายน 2026
- กำหนดการทางการของการประชุมและนิทรรศการ SC26 ปี 2026
หากต้องการเก็บบันทึกการทดสอบ กราฟ และเหตุผลที่เลือกวิธีติดตั้งไว้ในที่เดียวที่ค้นหาได้ สมัครบัญชี Telli.sh