Bolehkah 30 GPU pada satu pelayan memendekkan barisan kerja AI di makmal?
LIQID UltraStack memberikan kad AMD Instinct MI350P berasingan kepada model yang berlainan. Bezakan ujian 20 GPU daripada unjuran 30 GPU, kemudian ukur masa menunggu yang benar-benar dialami penyelidik.
Pada pukul sembilan pagi, sebuah pasukan penyelidikan mula mengekstrak teks daripada imbasan semalam. Pasukan kedua menghantar nota untuk diterjemahkan dan yang ketiga mahukan jawapan segera daripada manual alat. Jika semua kerja memasuki barisan inferens yang sama, pertanyaan ringkas boleh tersekat di belakang kelompok dokumen yang besar. Apabila jawapan tiba, orang yang memerlukannya mungkin sudah kembali menyelak PDF.
Pada 12 November 2026, pembekal infrastruktur LIQID menerangkan konfigurasi UltraStack yang menghubungkan 4 hingga 30 pemecut AMD Instinct MI350P kepada sebuah hos AMD EPYC 9005 dwisoket. Dalam reka bentuk penyajian yang diterbitkan, setiap kad menjalankan satu tika model. Ini membolehkan kerja OCR terus berjalan sementara GPU lain mengurus terjemahan atau pertanyaan. LIQID mengumumkan demonstrasi pada SC26 di Chicago, semasa pameran yang dijadualkan pada 17–19 November. Pengumuman LIQID pada 12 November dan imej rasmi sistem · Tarikh SC26
Reka bentuk itu masuk akal jika makmal perlu menyiapkan beberapa jenis kerja tepat pada masanya dan setiap model muat pada satu kad. Mulakan dengan masa menunggu yang dialami pengguna. Kemudian tanya berapa banyak masa itu berpunca daripada kerja lain, had apa yang mungkin muncul selepas GPU diasingkan dan sama ada penambahbaikan berbaloi dengan kuasa serta kos sistem. Sebahagian besar soalan itu boleh diuji tanpa memenuhi semua ruang kad dalam konfigurasi maksimum.
Setiap GPU mempunyai 144 GB memorinya sendiri
Dalam susun atur yang diterbitkan LIQID, hos AMD EPYC disambungkan kepada kad MI350P melalui fabrik PCIe Gen 5. Kad boleh berada dalam casis GPU berasingan yang dihubungkan kepada hos. AMD menyatakan 144 GB HBM3E khusus bagi setiap MI350P dan antara muka kad PCIe 5.0 x16. Dalam susunan satu model bagi setiap kad, setiap tika model menggunakan memori GPU yang ditetapkan kepadanya. Tika itu boleh mengendalikan beberapa permintaan, tertakluk pada perisian penyajian dan had memori. Helaian data LIQID UltraStack · Spesifikasi AMD MI350P
Dua puluh kad mempunyai jumlah HBM3E sebanyak 2.88 TB dalam unit perpuluhan. Jumlah itu berguna untuk mengira bilangan tika model bebas yang boleh ditempatkan dalam sistem. Untuk kerja pada kad nombor tujuh, kiraannya masih bermula pada 144 GB. Jika model hanya muat apabila parameter dan keadaan kerja dibahagikan antara beberapa GPU, nilai strategi pengagihan tersebut dan uji prestasinya secara khusus. Penskalaan yang dilaporkan LIQID merujuk kepada tika bebas pada kad berasingan. Susunan ujian dan angka memori LIQID
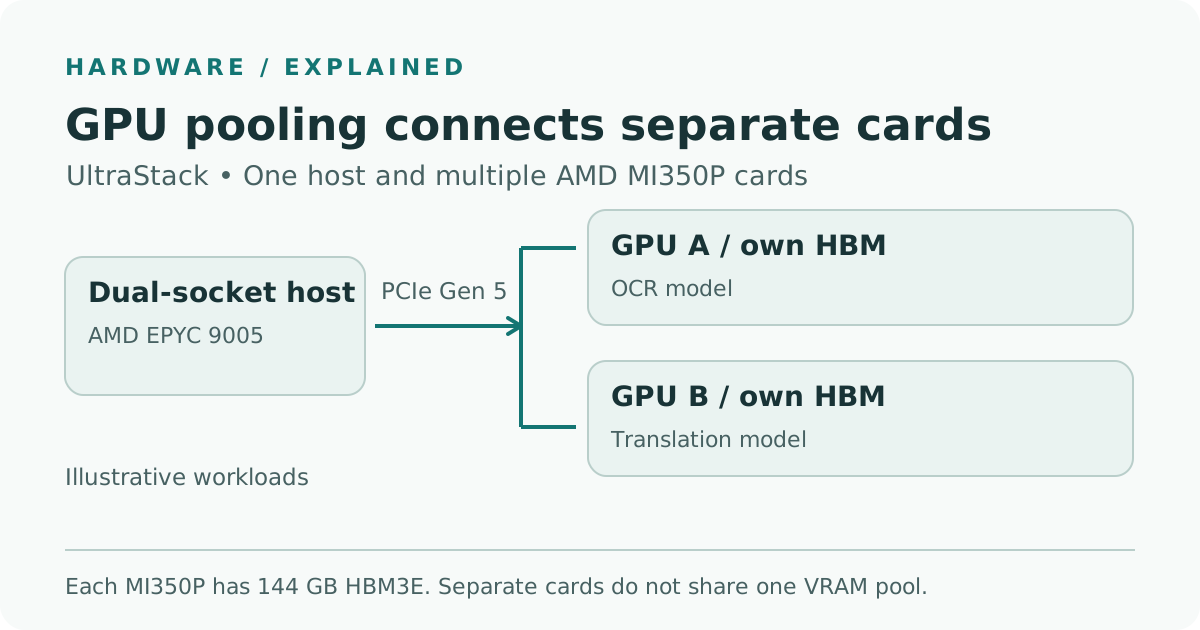
Ilustrasi Telli.sh berdasarkan perihal perkakasan LIQID dan spesifikasi kad AMD. Rajah menunjukkan contoh penyajian bebas; casis dan peranti sampingan hos tidak ditunjukkan.
Bilangan parameter membantu mengecilkan pilihan, tetapi dua model dengan bilangan parameter yang sama boleh memerlukan memori yang berlainan. Mulakan dengan wajaran yang tepat dan ketepatan angkanya. Sediakan juga ruang untuk persekitaran masa jalan dan cache yang digunakan model bagi menyimpan maklumat token terdahulu apabila menjana token baharu. Untuk perkhidmatan yang menerima beberapa permintaan panjang serentak, lancarkan model yang dirancang dan perhatikan memori bagi campuran permintaan sebenar. Gesaan pendek pada kad yang tidak sibuk menguji sama ada perkhidmatan boleh bermula. Ujian berterusan dengan input terpanjang yang diterima menunjukkan sama ada perkhidmatan masih boleh menerima kerja.
Barisan berasingan berguna apabila kadar ketibaan kerja berbeza
Bayangkan arkib universiti mendigitalkan temu bual bersama rekod kertas. Dalam percubaan, satu GPU boleh menjalankan model dokumen untuk OCR, satu lagi mentranskripsikan temu bual dan kad ketiga mengendalikan terjemahan ringkas. Selepas seminggu mengumpul data penggunaan, kad keempat boleh menjalankan salinan kedua bagi perkhidmatan paling sibuk. Sediakan barisan berasingan bagi setiap perkhidmatan dan tentukan berapa banyak kerja yang boleh diterima pada satu masa. Ini mengurangkan kemungkinan kelompok imbasan yang tertunggak melambatkan terjemahan ringkas kerana kedua-duanya berebut pemecut yang sama.
Andaikan arkib menerima permintaan untuk menterjemahkan teks selepas OCR. Langkah yang berbeza boleh bertindih untuk dokumen yang berbeza. Dokumen pertama boleh masuk ke peringkat terjemahan manakala dokumen kedua memulakan OCR. Namun, terjemahan dokumen tertentu masih memerlukan hasil OCR dokumen itu. Ukur masa dari muat naik hingga memperoleh hasil yang boleh digunakan bagi dokumen tersebut, di samping mengira dokumen yang disiapkan dalam seluruh aliran kerja. Reka bentuk yang menyiapkan lebih banyak dokumen dalam sejam masih boleh menyebabkan seorang penterjemah menunggu satu halaman.
Untuk campuran lain, bayangkan makmal kejuruteraan menggunakan pembantu dokumen pada waktu siang dan memproses log alat lama pada waktu malam. Pembantu siang memerlukan masa respons pertama yang dapat dijangka selepas penyelidik bertanya. Kerja malam mempunyai tarikh akhir tetapi sering boleh dijeda. Ukur bahagian masa setiap GPU digunakan bagi perkhidmatan tersebut sebelum menentukan kad yang diperuntukkan secara tetap. Jika pembantu jarang digunakan kecuali sejurus selepas mesyuarat makmal, salinan kedua yang dikhaskan tetap ada kos ketika trafik rendah. Bandingkan dengan pemasangan yang sudah menyerap lonjakan itu melalui kerja berjadual atau barisan berasingan.
Penempatan model turut mempengaruhi pemulihan. Satu hos memudahkan sebahagian kerja konfigurasi, tetapi semua perkhidmatan padanya bergantung pada hos tersebut. Tentukan perkhidmatan yang boleh menunggu selepas penyelenggaraan, yang perlu dipulihkan dahulu dan yang memerlukan lokasi penyajian kedua. Untuk aliran kerja dokumen, simpan hasil pertengahan supaya selepas dimulakan semula, kerja boleh disambung dari peringkat pengekstrakan yang selesai. Untuk kerja interaktif, persetujui tempoh gangguan yang boleh diterima atau sediakan titik akhir alternatif. Bilangan kad pada hos utama mewakili kapasiti inferens semasa beroperasi seperti biasa. Masa pemulihan perlu diuji secara berasingan.
LIQID mengukur 89,000 token keluaran sesaat dengan 20 GPU
Ringkasan prestasi LIQID menerangkan model kelas 7B pada ketepatan FP4 dengan tahap keserentakan yang dilaporkan sebanyak 128. Setiap GPU menjalankan tika tersendiri. Dengan 20 GPU, LIQID melaporkan kadar gabungan kira-kira 89,000 token keluaran sesaat. Anggaran bagi 30 GPU, kira-kira 133,000 token keluaran sesaat, dibuat dengan melanjutkan penskalaan yang diperhatikan dalam ujian 20 GPU. Kedua-dua angka merujuk jumlah keluaran bagi susunan yang diuji atau diunjurkan. Bagi seorang penyelidik yang membuat satu permintaan, pengalaman ditentukan oleh masa menunggu, pemprosesan input dan kelajuan penjanaan untuk permintaan itu. Ringkasan dan kaedah ujian prestasi LIQID
| Ujian LIQID | Bilangan GPU | Jumlah token keluaran/s | Bukti |
|---|---|---|---|
| Kelas 7B, FP4 | 1 | 4,653 | Ukuran LIQID |
| Kelas 7B, FP4 | 10 | 44,383 | Ukuran LIQID |
| Kelas 7B, FP4 | 20 | Kira-kira 89,000 | Ukuran LIQID |
| Kelas 7B, FP4 | 30 | Kira-kira 133,000 | Unjuran LIQID daripada 20 GPU |
| Kelas 72B, FP8, had kependaman interaktif | 8 | 1,256 | Ukuran LIQID yang berasingan |
Ujian 72B FP8 yang berasingan menetapkan sasaran masa ke token pertama tidak melebihi dua saat pada persentil ke-99, dan sekurang-kurangnya 30 token keluaran sesaat bagi setiap pengguna. LIQID melaporkan ukuran dengan 2, 4 dan 8 kad untuk ujian itu. Saiz model, ketepatan dan keadaan penyajian berbeza daripada percubaan daya pemprosesan model 7B. Gunakan ujian interaktif sebagai rujukan untuk kelas beban tersebut, kemudian gunakan sasaran kependaman sendiri pada gesaan dan tahap keserentakan yang anda jangka. Kaedah penanda aras dan keputusan interaktif LIQID
Angka 7B memberikan sebab untuk mengulang penanda aras yang sama sambil menambah tika model yang serupa. Namun, untuk pasukan yang merancang beban bercampur, persoalan lain kekal terbuka. Bagaimana jika permintaan menghabiskan sebahagian masa membaca banyak fail kecil, membina konteks daripada storan atau menunggu CPU menyediakan imej? Mainkan semula corak permintaan yang sama dua kali dengan model dan bilangan GPU yang tetap: uji dahulu setiap perkhidmatan secara berasingan, kemudian keseluruhan campuran. Jika masa menunggu bertambah apabila kerja digabungkan sedangkan penggunaan GPU rendah, periksa CPU hos, aktiviti sistem fail dan penghalaan permintaan sebelum menambah pemecut.
Ukur kerja yang berguna dalam had kependaman
Mulakan dengan ujian yang boleh dijalankan oleh pemasangan semasa. Sebagai contoh, gunakan 200 dokumen yang diluluskan dan mewakili beban sebenar, dengan bahasa dan bilangan halaman imbasan yang diketahui. Serentak dengan kelompok itu, mainkan semula log masa ketibaan permintaan interaktif yang sudah dinyahkenal. Gunakan campuran input yang sama pada kedua-dua sistem. Jika perubahan perkakasan atau perisian memerlukan ketepatan lain, uji semula kualiti pada sampel yang sama. Kira hanya hasil yang siap dan melepasi semakan biasa pasukan.
- Tentukan hasil yang boleh diterima. Untuk pembantu, tetapkan sasaran respons pertama dan masa dari mula hingga selesai. Contohnya, token pertama sampai dalam dua saat pada persentil ke-95 untuk sampel interaktif anda. Untuk pengekstrakan kelompok, pilih tarikh akhir harian dan jumlah minimum halaman yang lulus pengesahan. Itu ialah contoh sasaran ujian yang dicadangkan. LIQID menggunakan had persentil ke-99 untuk token pertama dalam eksperimen 72B yang berasingan.
- Catat masa yang dihabiskan pada setiap peringkat permintaan. Log apabila permintaan tiba, mula diproses, mengeluarkan hasil pertama dan selesai. Tandakan jenis kerja dan rekod cubaan semula. Cap masa tersebut membolehkan anda membezakan masa menunggu daripada masa kerja aktif. Angka tunggal dari mula hingga selesai boleh menyembunyikan barisan panjang apabila langkah inferens itu sendiri pantas.
- Ubah satu perkara dan mainkan semula trafik. Bandingkan barisan bersama dengan barisan berasingan sementara tika model yang sama kekal pada kad yang sama. Uji perubahan agihan kad sebagai eksperimen lain. Kekalkan had gesaan dan keluaran, urutan input serta semakan kualiti, dan mulakan setiap ujian selepas proses pemanasan yang konsisten. Lihat waktu paling sibuk serta keadaan trafik purata. Kesan barisan berasingan seharusnya dapat dilihat apabila satu tugas besar tiba pada waktu yang paling tidak sesuai.
- Lihat ukuran hos dan meter bersama keputusan kerja. Catat penggunaan pemecut dan memori, CPU dan RAM hos, aktiviti baca dan tulis serta kuasa masukan sistem dalam tempoh yang sama. Laporkan masa siap persentil ke-95 bagi setiap jenis kerja, halaman atau permintaan yang berjaya setiap jam dan tenaga bagi setiap hasil yang berjaya. Sertakan kerja yang digugurkan atau tamat masa agar permintaan yang ditolak kekal kelihatan.
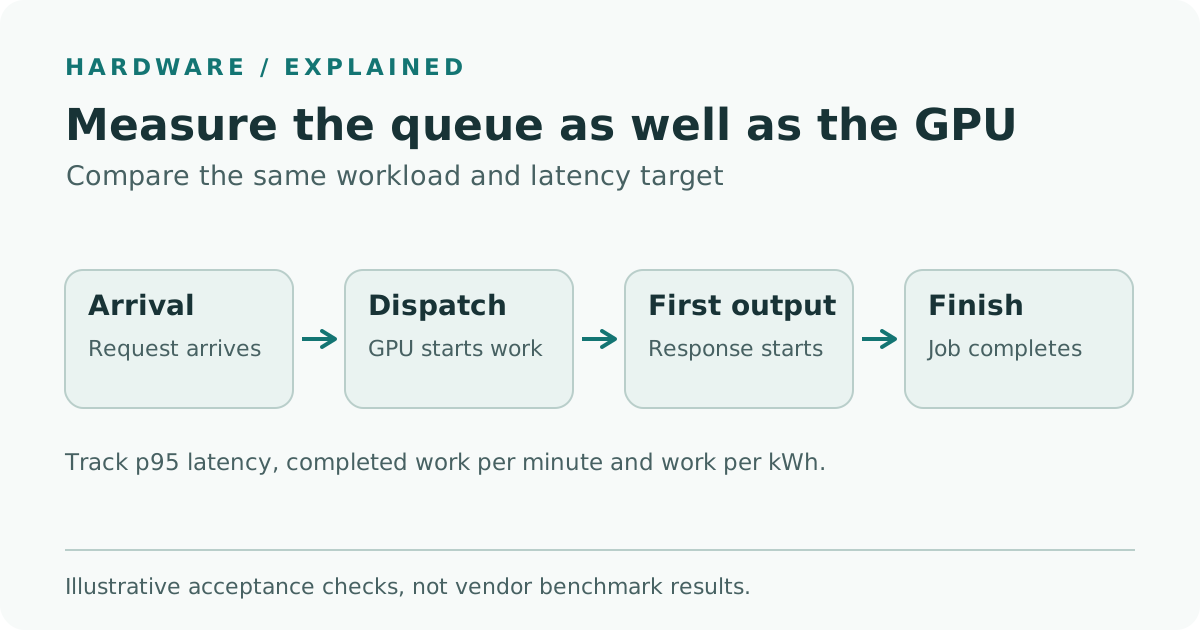
Ilustrasi Telli.sh untuk ujian penerimaan yang dicadangkan. Perubahan masa menunggu, respons pertama atau masa siap boleh menunjukkan punca kekangan yang berlainan.
Plot taburan kependaman berasingan bagi setiap perkhidmatan. P95 ialah tempoh yang mencukupi untuk menyiapkan 95 peratus daripada peristiwa yang diukur. Angka itu boleh berubah walaupun median kekal, dan perbezaannya penting jika penganalisis sering datang pada waktu paling sibuk. Sediakan bilangan sampel bagi setiap taburan. Persentil daripada lima tugas semalaman memberikan maklumat yang berbeza daripada persentil ratusan permintaan interaktif. Masa menunggu yang terus berkurang dengan kualiti setara dan lebih sedikit luput masa memberi alasan yang lebih kuat untuk memberikan kad khas kepada perkhidmatan sibuk berbanding nombor daya pemprosesan tertinggi.
Sempadan pengukuran juga mesti sama. Untuk menilai kecekapan tenaga, kira hasil yang berguna dalam satu tempoh tetap dan ukur peralatan yang sama dalam kedua-dua konfigurasi. Jika meter hanya mengukur pelayan dan casis GPU, laporkan hasil sebagai penggunaan tenaga sistem IT. Jika storan bersama atau penyejukan diambil kira, lakukannya secara konsisten bagi kedua-dua reka bentuk. Catat kuasa semasa melahu jika menilai perkhidmatan sepanjang masa. Sistem pantas memerlukan lebih sedikit minit aktif bagi setiap kerja, tetapi pemasangan yang menunggu sepanjang malam pada kuasa melahu yang lebih tinggi mungkin menggunakan lebih banyak tenaga dalam sehari.
Angka 22 kW perlu dinilai bersama kemudahan pemasangan
LIQID menyatakan kira-kira 22 kW bagi sistem 30 GPU penuh dengan penyejukan udara. AMD menyatakan kuasa papan tipikal maksimum sebanyak 600 W untuk setiap MI350P dan tetapan 450 W yang boleh dikonfigurasi. Darabkan 30 dengan 600 W untuk mendapatkan 18 kW bagi kad sahaja pada kuasa papan tersebut. Angka 22 kW yang dilaporkan merujuk kepada sistem yang lebih luas. Bekalan elektrik bangunan, keperluan rak dan kapasiti penyejukan bergantung pada pemasangan. Tetapan 450 W juga boleh mengubah kadar hasil yang berguna. Jika pembekal menyokong kedua-dua tetapan pada konfigurasi dalam sebut harga, bandingkan kedua-duanya dengan beban dan syarat kualiti yang sama. Panduan kuasa sistem LIQID · Spesifikasi papan AMD MI350P
Libatkan pasukan kemudahan sebelum memilih konfigurasi yang lebih besar. Semak bilangan casis, kapasiti litar semasa operasi biasa dan redundan, penyingkiran haba pada keadaan udara masuk dan kemampuan pemasangan menanggung lonjakan beban apabila dihidupkan semula. Gunakan sebut harga untuk mengetahui pihak yang mengurus servis, sokongan dan pelarasan kuasa. Pertimbangkan semuanya bersama kos barisan dokumen yang panjang. Satu hos mungkin mengurangkan bilangan pelayan yang perlu ditadbir, tetapi kepadatan kuasa boleh menentukan bilik mana yang sesuai untuk menempatkan peralatan.
LIQID menawarkan sistem 4 hingga 30 GPU melalui proses pesanan rakan niaga, tertakluk pada stok. Laman produk menunjukkan aliran penghantaran 4–6 minggu, dan mengaitkan tempoh empat minggu yang diiklankan dengan pengesahan pesanan pembelian. Minta sebut harga bertarikh untuk konfigurasi tepat dan komitmen penghantaran ke tapak pemasangan. LIQID menyenaraikan pameran SC26 di McCormick Place bermula 17 November. Panduan pesanan rakan niaga dan penghantaran LIQID · Pengumuman SC26 LIQID
Berapa banyak masa menunggu wajar dibayar untuk dikurangkan?
Memberikan pemecut khusus untuk terjemahan boleh berbaloi jika pasukan seterusnya memerlukan teks yang diterjemah serta-merta. Kad yang sama mungkin melahu hampir sepanjang minggu apabila semua terjemahan boleh disiapkan esok. Mulakan dengan konfigurasi terkecil yang dapat mewakili kerja serentak di makmal anda, dan ulang tempoh paling sibuk beberapa kali. Tambah kapasiti di tempat masa menunggu yang lebih pendek masih membawa hasil yang lebih baik. Untuk arkib, ukuran kejayaan boleh semudah seorang juruteknik memperoleh jawapan tepat pada waktunya sementara imbasan harian lengkap sebelum serahan.
Sumber
- Pengumuman SC26 LIQID dan imej rasmi UltraStack, 12 November 2026
- Laman LIQID UltraStack dengan AMD Instinct MI350P, maklumat pesanan dan kuasa, disemak 15 November 2026
- Helaian data LIQID UltraStack, disemak 15 November 2026
- Kaedah dan keputusan penanda aras Fasa 3 LIQID, disemak 15 November 2026
- Spesifikasi kad AMD Instinct MI350P, disemak 15 November 2026
- Tarikh rasmi acara dan pameran SC26 2026
Untuk menghimpunkan nota ujian, carta dan keputusan pelaksanaan di satu tempat yang boleh dicari, cipta akaun Telli.sh.