Bisakah 30 GPU di satu server memangkas antrean AI di laboratorium?
LIQID UltraStack memberi tiap model kartu AMD Instinct MI350P tersendiri. Bedakan hasil uji 20 GPU dari proyeksi 30 GPU, lalu ukur waktu tunggu yang benar-benar dialami peneliti.
Pukul sembilan pagi, sebuah tim peneliti mulai mengambil teks dari hasil pemindaian kemarin. Tim kedua mengirim catatan untuk diterjemahkan, dan tim ketiga ingin segera mendapat jawaban dari buku petunjuk alat. Jika ketiganya masuk ke antrean inferensi yang sama, satu pertanyaan pendek bisa tertahan di belakang sekumpulan dokumen yang besar. Saat jawabannya muncul, orang yang membutuhkannya mungkin sudah kembali membuka PDF.
Pada 12 November 2026, penyedia infrastruktur LIQID menjelaskan konfigurasi UltraStack yang menghubungkan 4 hingga 30 akselerator AMD Instinct MI350P ke satu host AMD EPYC 9005 soket ganda. Dalam rancangan penyajian model yang dipublikasikan, setiap kartu menjalankan satu instans model. Dengan demikian, OCR bisa terus bekerja sementara GPU lain menangani terjemahan atau pertanyaan. LIQID mengumumkan demonstrasi SC26 di Chicago saat pameran yang dijadwalkan pada 17–19 November. Pengumuman LIQID 12 November dan gambar resmi sistem · Jadwal SC26
Rancangan ini masuk akal jika beberapa pekerjaan laboratorium harus selesai tepat waktu dan setiap model muat di satu kartu. Mulailah dari waktu tunggu yang dialami pengguna. Tanyakan berapa lama penundaan akibat pekerjaan lain, batas apa yang mungkin muncul setelah GPU dipisah, dan apakah perbaikannya sepadan dengan daya dan biaya sistem. Sebagian besar pertanyaan itu bisa diuji dengan konfigurasi yang jauh lebih kecil daripada sistem yang semua kartunya terpasang.
Setiap GPU memiliki 144 GB memori tersendiri
Dalam susunan yang dipublikasikan LIQID, host AMD EPYC terhubung ke kartu MI350P melalui jaringan interkoneksi PCIe Gen 5. Kartu bisa berada pada sasis GPU terpisah yang tersambung ke host. AMD mencantumkan HBM3E khusus sebesar 144 GB per MI350P dan antarmuka kartu PCIe 5.0 x16. Dalam konfigurasi satu model per kartu, setiap instans menggunakan memori pada GPU yang ditugaskan kepadanya. Setiap instans dapat menangani beberapa permintaan, tergantung perangkat lunak penyajian dan batas memorinya. Lembar spesifikasi LIQID UltraStack · Spesifikasi AMD MI350P
Dua puluh kartu memiliki total HBM3E 2,88 TB dalam satuan desimal. Angka itu berguna untuk menghitung berapa banyak instans model terpisah yang dapat dijalankan sistem. Untuk pekerjaan di kartu ketujuh, titik awalnya tetap 144 GB. Jika model baru muat ketika parameter dan data kerjanya dibagi ke beberapa GPU, nilai strategi pembagian tersebut dan buat tolok ukur khusus. Penskalaan yang dilaporkan LIQID mengacu pada instans independen di kartu yang berbeda. Konfigurasi uji dan angka memori LIQID
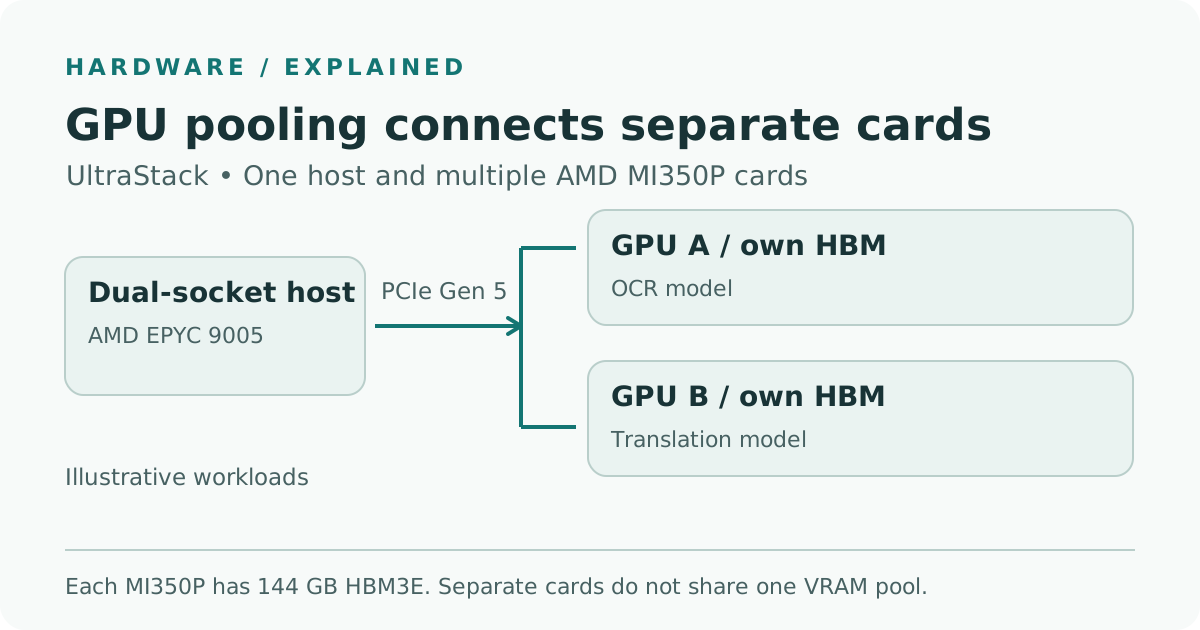
Ilustrasi Telli.sh berdasarkan penjelasan perangkat keras LIQID dan spesifikasi kartu AMD. Diagram menunjukkan contoh model yang berjalan terpisah, tanpa menggambarkan sasis atau perangkat pendukung host.
Jumlah parameter membantu mempersempit pilihan, tetapi dua model dengan jumlah yang sama bisa membutuhkan memori berbeda. Mulai dari bobot yang tepat dan presisinya. Sisakan ruang untuk runtime dan cache yang menyimpan informasi token sebelumnya ketika model menghasilkan token baru. Untuk layanan yang menerima beberapa permintaan panjang sekaligus, jalankan model yang diusulkan dan amati memori di bawah campuran permintaan yang sebenarnya. Prompt pendek pada kartu yang kosong hanya menunjukkan bahwa layanan dapat dimulai. Pengujian yang berkelanjutan dengan input terpanjang yang diizinkan menunjukkan apakah layanan masih dapat menerima pekerjaan.
Antrean terpisah membantu ketika laju kedatangan pekerjaan berbeda
Bayangkan arsip universitas mendigitalkan wawancara dan dokumen kertas. Saat uji coba, satu GPU bisa menjalankan model dokumen untuk OCR, GPU kedua mentranskripsikan wawancara, dan GPU ketiga menangani terjemahan singkat. Setelah tersedia data pemakaian selama seminggu, kartu keempat dapat menjalankan instans tambahan untuk layanan tersibuk. Berikan antrean sendiri kepada tiap layanan dan tentukan jumlah pekerjaan yang boleh diterima sekaligus. Dengan demikian, sekumpulan halaman yang menumpuk tidak mudah menunda terjemahan singkat karena keduanya berebut akselerator yang sama.
Andaikan arsip ingin menerjemahkan teks setelah OCR. Tahap-tahap dapat bertumpang tindih untuk dokumen yang berbeda. Dokumen pertama bisa masuk tahap terjemahan saat dokumen kedua mulai diproses OCR. Namun, menerjemahkan dokumen tertentu tetap memerlukan hasil OCR dokumen tersebut. Ukur waktu dokumen itu dari saat diunggah sampai hasilnya bisa digunakan, sekaligus jumlah dokumen yang selesai di seluruh rangkaian. Rancangan yang memproses lebih banyak dokumen per jam masih bisa membuat seorang penerjemah menunggu satu halaman.
Untuk campuran pekerjaan lain, bayangkan laboratorium teknik memakai asisten dokumen pada siang hari dan memproses log instrumen lama pada malam hari. Asisten perlu memberi respons pertama dalam waktu yang dapat diperkirakan setelah peneliti bertanya. Pekerjaan malam juga punya tenggat, tetapi biasanya bisa dijeda. Ukur porsi waktu tiap GPU yang dipakai untuk setiap layanan sebelum mengkhususkan satu kartu secara permanen. Jika asisten jarang dipakai kecuali sesudah rapat laboratorium, instans kedua tetap memakan biaya ketika lalu lintas sepi. Bandingkan dengan sistem yang sudah dapat menyerap lonjakan itu melalui pekerjaan terjadwal atau antrean terpisah.
Penempatan model juga memengaruhi pemulihan. Satu host mempermudah sebagian pengaturan, tetapi semua layanan di dalamnya bergantung pada host tersebut. Tentukan layanan yang boleh menunggu setelah pemeliharaan, yang harus kembali lebih dahulu, dan yang membutuhkan lokasi penyajian kedua. Untuk alur dokumen, simpan hasil perantara agar pekerjaan dapat dilanjutkan dari tahap ekstraksi yang sudah selesai. Untuk pekerjaan interaktif, sepakati durasi gangguan yang dapat diterima atau sediakan titik akses lain. Jumlah kartu pada host utama menunjukkan kapasitas inferensi dalam operasi normal. Waktu pemulihan harus diuji tersendiri.
LIQID mengukur sekitar 89.000 token keluaran per detik dengan 20 GPU
Ringkasan tolok ukur LIQID menjelaskan model kelas 7B dengan presisi FP4 dan tingkat konkurensi yang dilaporkan sebesar 128. Setiap GPU melayani instansnya sendiri. Dengan 20 GPU, LIQID melaporkan total sekitar 89.000 token keluaran per detik. Perkiraan sekitar 133.000 token keluaran per detik pada 30 GPU adalah ekstrapolasi dari pola penskalaan uji 20 GPU. Keduanya menunjukkan total keluaran gabungan untuk susunan yang diuji atau diproyeksikan. Pengalaman seorang peneliti yang mengirim satu permintaan bergantung pada waktu antre, waktu pemrosesan masukan, dan kecepatan generasi permintaannya sendiri. Ringkasan laju pemrosesan dan metode tolok ukur LIQID
| Uji LIQID | Jumlah GPU | Total token keluaran/detik | Dasar angka |
|---|---|---|---|
| Kelas 7B, FP4 | 1 | 4.653 | Pengukuran LIQID |
| Kelas 7B, FP4 | 10 | 44.383 | Pengukuran LIQID |
| Kelas 7B, FP4 | 20 | Sekitar 89.000 | Pengukuran LIQID |
| Kelas 7B, FP4 | 30 | Sekitar 133.000 | Proyeksi LIQID dari 20 GPU |
| Kelas 72B, FP8, batas latensi interaktif | 8 | 1.256 | Pengukuran terpisah oleh LIQID |
Pengujian 72B FP8 yang terpisah menargetkan waktu ke token pertama paling lama dua detik pada persentil ke-99 dan setidaknya 30 token keluaran per detik per pengguna. LIQID melaporkan hasil pada 2, 4, dan 8 kartu untuk eksperimen tersebut. Ukuran model, presisi, dan kondisi penyajian berbeda dari uji laju pemrosesan 7B. Pakai hasil interaktif sebagai acuan untuk jenis pengujian tersebut, lalu terapkan sasaran latensi sendiri dengan prompt dan tingkat konkurensi yang Anda perkirakan. Metode tolok ukur dan hasil interaktif LIQID
Angka 7B memberi alasan untuk mengulang tolok ukur yang sama ketika menambahkan instans model identik. Namun, bagi tim yang merencanakan pekerjaan campuran, ada pertanyaan lain. Bagaimana jika permintaan menghabiskan waktu membaca banyak berkas kecil, menyusun konteks dari penyimpanan, atau menunggu CPU menyiapkan gambar? Putar ulang lalu lintas yang sama dua kali dengan model dan jumlah GPU yang sama. Uji setiap layanan sendiri, kemudian semuanya sekaligus. Jika pemakaian GPU tetap rendah tetapi waktu antre meningkat pada pengujian gabungan, periksa CPU host, aktivitas sistem berkas, dan perutean permintaan sebelum menambah akselerator.
Ukur hasil yang berguna di bawah batas latensi
Mulailah dari pengujian yang bisa dijalankan pada sistem yang sudah ada. Misalnya, gunakan 200 dokumen yang telah disetujui dan mewakili beban sebenarnya, dengan bahasa dan jumlah halaman pindai yang diketahui. Bersamaan dengan batch itu, putar ulang catatan waktu kedatangan permintaan interaktif yang sudah dianonimkan. Gunakan campuran masukan yang sama pada kedua sistem. Jika perubahan perangkat keras atau perangkat lunak memaksa Anda mengganti presisi, uji kembali kualitas pada sampel yang sama. Hitung hanya hasil yang selesai dan lolos pemeriksaan yang biasa dilakukan tim.
- Tentukan hasil yang bisa diterima. Untuk asisten, tetapkan sasaran respons pertama dan waktu dari awal hingga selesai. Sebagai contoh, token pertama muncul dalam dua detik pada persentil ke-95 untuk sampel interaktif Anda. Untuk ekstraksi batch, tentukan tenggat harian dan jumlah minimum halaman yang lolos pemeriksaan. Itu adalah contoh sasaran untuk usulan pengujian. Pada eksperimen 72B yang terpisah, LIQID memakai batas persentil ke-99 untuk token pertama.
- Catat waktu pada setiap tahap permintaan. Catat saat permintaan datang, mulai diproses oleh pelaksana, menghasilkan keluaran pertama, dan selesai. Tandai jenis pekerjaan dan catat percobaan ulang. Dengan catatan waktu tersebut, Anda bisa memisahkan waktu antre dari waktu pemrosesan aktif. Satu angka dari awal sampai selesai bisa menyembunyikan antrean lama ketika tahap inferensinya sendiri singkat.
- Ubah satu hal dan putar ulang lalu lintas. Bandingkan antrean bersama dengan antrean terpisah sementara instans model yang sama tetap di kartu yang sama. Sesudah itu, uji perubahan pembagian kartu sebagai eksperimen tersendiri. Pertahankan batas prompt dan keluaran, urutan input, serta pemeriksaan kualitas. Mulailah setiap pengujian setelah pemanasan yang sama. Amati waktu tersibuk dan lalu lintas rata-rata. Manfaat antrean terpisah semestinya terlihat saat satu pekerjaan besar datang pada waktu yang tidak tepat.
- Amati host dan meter daya bersamaan dengan hasilnya. Catat utilisasi dan memori akselerator, CPU dan RAM host, aktivitas baca tulis, dan daya masuk sistem dalam rentang waktu yang sama. Laporkan waktu penyelesaian persentil ke-95 per jenis pekerjaan, jumlah halaman atau permintaan yang berhasil per jam, dan energi per hasil yang berhasil. Sertakan pekerjaan yang terputus atau habis waktu agar pekerjaan yang tidak terlayani tidak hilang dari laporan.
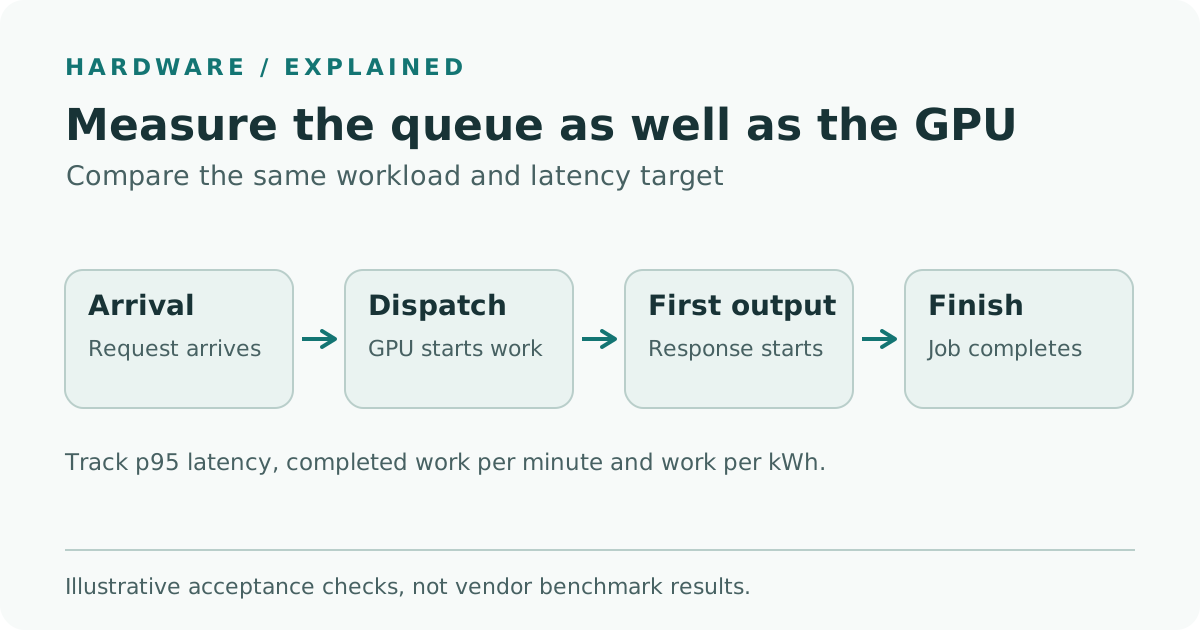
Ilustrasi Telli.sh tentang usulan uji penerimaan. Perubahan waktu antre, waktu respons pertama, atau waktu selesai dapat menunjuk ke hambatan yang berbeda.
Buat distribusi latensi untuk masing-masing layanan. P95 adalah waktu yang mencakup penyelesaian 95 persen peristiwa yang diukur. Angka ini bisa bergeser walaupun mediannya tetap, dan perbedaan itu penting ketika seorang analis berulang kali mengakses layanan saat jam sibuk. Catat jumlah sampel untuk setiap distribusi. Persentil dari lima pekerjaan malam memberi informasi yang berbeda dari persentil ratusan permintaan interaktif. Penurunan waktu antre yang konsisten dengan kualitas setara dan lebih sedikit permintaan yang habis waktu lebih meyakinkan sebagai alasan memberi kartu khusus daripada sekadar angka laju pemrosesan tertinggi.
Perbandingan juga membutuhkan batas pengukuran yang sama. Untuk menilai efisiensi energi, hitung keluaran yang berguna dalam rentang tetap dan ukur peralatan yang sama pada kedua konfigurasi. Jika meter hanya mencakup server dan sasis GPU, beri label hasilnya sebagai energi sistem TI. Bila penyimpanan bersama atau pendinginan termasuk dalam perbandingan, hitung dengan cara yang sama di kedua susunan. Catat daya saat menganggur jika layanan berjalan 24 jam. Sistem cepat membutuhkan lebih sedikit menit aktif untuk tiap pekerjaan, tetapi instalasi dengan daya diam lebih tinggi sepanjang malam dapat memakai lebih banyak energi dalam sehari.
Angka 22 kW perlu dibahas dengan tim fasilitas
LIQID menyebut sekitar 22 kW untuk sistem penuh 30 GPU dengan pendinginan udara. AMD menyebut daya papan tipikal maksimum 600 W untuk tiap MI350P dan opsi konfigurasi 450 W. Perkalian 30 dengan 600 W menghasilkan 18 kW untuk kartu saja pada angka daya papan tersebut. Angka 22 kW yang dilaporkan mencakup sistem yang lebih luas. Kebutuhan listrik gedung, penyediaan rak, dan kapasitas pendinginan bergantung pada instalasi. Menjalankan kartu pada 450 W juga dapat mengubah laju hasil yang berguna. Jika vendor mendukung kedua pengaturan pada konfigurasi penawaran Anda, bandingkan keduanya dengan beban dan syarat kualitas yang sama. Panduan daya sistem LIQID · Spesifikasi papan AMD MI350P
Libatkan tim fasilitas sebelum memilih konfigurasi yang lebih besar. Periksa jumlah sasis, kapasitas sirkuit dalam pengoperasian normal maupun redundan, pembuangan panas pada kondisi udara masuk setempat, dan kemampuan instalasi menangani lonjakan beban setelah dinyalakan kembali. Gunakan penawaran untuk mengetahui siapa yang akan menangani servis, dukungan, dan penyesuaian daya. Bandingkan semua itu dengan biaya antrean dokumen yang panjang. Satu host mungkin mengurangi jumlah server yang dikelola, tetapi kepadatan daya yang dibutuhkan bisa menentukan ruangan mana yang dapat menampung peralatan tersebut.
LIQID menawarkan sistem 4 hingga 30 GPU melalui pemesanan mitra, bergantung pada stok. Laman produknya menjelaskan alur pengiriman 4–6 minggu dan mengaitkan waktu tunggu empat minggu yang diiklankan dengan konfirmasi pesanan pembelian. Mintalah penawaran bertanggal untuk konfigurasi sebenarnya dan komitmen pengiriman ke lokasi pemasangan. LIQID menjadwalkan partisipasinya dalam pameran SC26 di McCormick Place mulai 17 November. Panduan pemesanan melalui mitra dan pengiriman LIQID · Pengumuman SC26 dari LIQID
Berapa lama waktu tunggu yang sepadan dengan biaya untuk memangkasnya?
Menugaskan satu akselerator khusus untuk terjemahan bisa sepadan jika tim berikutnya memerlukan bagian yang diterjemahkan segera. Kartu yang sama bisa menganggur hampir sepanjang minggu jika semua terjemahan boleh menunggu hingga besok. Mulailah dari konfigurasi terkecil yang bisa mewakili pekerjaan serentak di laboratorium, lalu ulangi jam tersibuk beberapa kali. Tambah kapasitas saat pengurangan waktu tunggu masih memperbaiki hasil. Bagi arsip, kriteria penerimaan bisa sesederhana petugas mendapat jawaban tepat waktu sementara seluruh hasil pindai harian tetap selesai sebelum serah terima.
Sumber
- Pengumuman SC26 dari LIQID dan gambar resmi UltraStack, 12 November 2026
- Laman UltraStack dengan AMD Instinct MI350P dari LIQID, panduan pemesanan dan daya, diperiksa 15 November 2026
- Lembar spesifikasi LIQID UltraStack, diperiksa 15 November 2026
- Metode dan hasil tolok ukur LIQID fase 3, diperiksa 15 November 2026
- Spesifikasi kartu AMD Instinct MI350P, diperiksa 15 November 2026
- Jadwal resmi acara dan pameran SC26 2026
Untuk mengumpulkan catatan pengujian, grafik, dan keputusan penerapan di satu tempat yang dapat ditelusuri, buat akun Telli.sh.