Granite Switch 4.1: เปลี่ยนเสียงภาษาอังกฤษให้เป็นทางเลือกถัดไปที่นำไปใช้ได้
ลอง Granite Switch 4.1 แล้วสร้างเวิร์กโฟลว์ใช้งานจริงสำหรับแชต ถอดเสียงภาษาอังกฤษ และตัดสินใจ พร้อมคำแนะนำเรื่องการตั้งค่า หน่วยความจำ ความเป็นส่วนตัว และต้นทุน
คำขอที่พูดออกมามักต้องทำงานสามอย่างที่ต่างกัน: ฟังคำพูด อธิบายว่าหมายถึงอะไร และตัดสินใจว่าควรทำอะไรต่อ Granite Switch 4.1 รวมความสามารถเหล่านี้ไว้หลัง endpoint เดียว แทนที่จะให้คุณประกอบเซิร์ฟเวอร์โมเดลอิสระสามชุดเข้าด้วยกัน
ประกาศของ IBM เมื่อวันที่ 15 ตุลาคม 2026 เปิดตัวรุ่น 8B และ 30B ที่ประกอบความสามารถไว้พร้อมใช้ ทั้งแชต decision adapter ทั่วไป การคัดกรองความปลอดภัย Guardian และการรู้จำเสียงพูด จุดดึงดูดในทางปฏิบัติคือเส้นทางที่สั้นลงจากบันทึกเสียงภาษาอังกฤษไปสู่การกระทำที่ตรวจทานได้ บทความเปิดตัวของ IBM วันที่ 15 ตุลาคม 2026
คู่มือนี้เริ่มจากแบบฝึกหัดเล็ก ๆ ในเบราว์เซอร์ แล้วแสดงการตั้งค่าในเครื่องและเวิร์กโฟลว์สมจริงสามแบบ นอกจากนี้ยังอธิบายจุดที่ต้องระวัง: เสียงภาษาอังกฤษไม่ได้แปลว่ารองรับเสียงหลายภาษา คะแนนการตัดสินใจไม่ใช่หลักฐานยืนยัน และขนาดไฟล์น้ำหนักโมเดลไม่ใช่งบหน่วยความจำ GPU ทั้งหมด
ภาพหลัก: แผนผังบรรณาธิการต้นฉบับ แสดงเสียงภาษาอังกฤษเปลี่ยนเป็นข้อความถอดเสียง แล้วแยกเป็นคำตอบแชต ตัวเลือกการตัดสินใจ และการคัดกรองความปลอดภัย ก่อนให้คนตรวจทานการกระทำ ภาพนี้ไม่ใช่หน้าจอทางการหรือคำกล่าวอ้างด้านประสิทธิภาพ
ได้ผลลัพธ์แรกที่มีประโยชน์ก่อนติดตั้งอะไร
เริ่มที่ เดโม Speech to Decisions อย่างเป็นทางการ IBM ลิงก์เดโมนี้จากประกาศวันที่ 15 ตุลาคม ส่วนเอกสารของเดโมอธิบายการป้อนเสียงจากไมโครโฟนสด คำบรรยายหัวข้อสั้น ๆ การตรวจความปลอดภัย และการตัดสินแบบใช่/ไม่ใช่ เอกสารเดโมอย่างเป็นทางการ ตรวจสอบเมื่อ 18 ตุลาคม 2026
-
เปิดเดโมและใช้เฉพาะข้อมูลสมมติที่ไม่ละเอียดอ่อน บริการนี้โฮสต์จากระยะไกล ไม่ได้ประมวลผลในเครื่อง
-
หากแอปพร้อมใช้งาน ให้อนุญาตการเข้าถึงไมโครโฟน แล้วพูดประโยคต่อไปนี้ เป็นภาษาอังกฤษ ซึ่งเป็นภาษาที่ ASR รองรับ:
ข้อความธรรมดาThe replacement keyboard arrived damaged. Please send a new one. I can share a photo tomorrow. -
หยุดบันทึกแล้วเทียบข้อความถอดเสียงที่แสดงกับสิ่งที่พูด ตรวจคำอธิบายหัวข้อและธงผลการตัดสินที่มีแยกกัน
-
ตรวจว่าคำขอ สินค้าที่เสียหาย และการติดตามผลที่สัญญาไว้ยังอยู่ครบ อย่านับป้ายหัวข้อที่ดูเข้าท่าว่าสำเร็จ หากข้อความถอดเสียงทำคำปฏิเสธหายหรือเปลี่ยนรายการสินค้า
นี่คือจุดตรวจแรกที่มีประโยชน์: อินพุตหนึ่งรายการที่เข้าใจได้และเอาต์พุตที่คุณตรวจได้ ไม่ใช่คำรับประกันเรื่องถ้อยคำที่ตรงเป๊ะ เวลาแฝง หรือการเปิดเดโมได้ตลอด หาก Space ใช้ไม่ได้หรือองค์กรห้ามอัปโหลดเสียงภายนอก ให้ไปเส้นทางในเครื่องด้านล่างแทนการส่งข้อมูลส่วนตัวไปที่อื่น
Switch สลับอะไรจริง ๆ?
language model พื้นฐานทำหน้าที่แชตทั่วไป adapter คือชุดการปรับแต่งที่ฝึกเพิ่มเติมขนาดเล็กกว่าเพื่อเชี่ยวชาญงานเฉพาะ decision adapter เลือกจากตัวเลือกที่ติดป้ายกำกับ ส่วน guardian-core คัดกรองข้อความเพื่อหาความเสี่ยงด้านความปลอดภัยบางประเภท แอปพลิเคชันเลือก adapter ผ่าน chat template แทนการโหลด language model เต็มชุดอีกตัว repository Granite Switch ตรวจสอบเมื่อ 18 ตุลาคม 2026
เสียงทำงานอีกเส้นทางหนึ่ง automatic speech recognition หรือ ASR แปลงคลื่นเสียงเป็นข้อความก่อนส่งให้ language model อ่าน ตัวรู้จำเสียงที่รวมมาให้คือโมเดล Granite Speech TurboCTC ภาษาอังกฤษของ IBM ขนาด 470M พารามิเตอร์ ตรวจสอบเมื่อ 18 ตุลาคม 2026 โมเดล Granite Speech TurboCTC ของ IBM ให้คิดว่าข้อความถอดเสียงนั้นเป็น ใบรับช่วงงาน: ทุกขั้นตอนหลังจากนั้นขึ้นอยู่กับคำที่บันทึกไว้ เก็บข้อความนี้คู่กับสรุปที่เรียบเรียงแล้ว เพื่อให้ผู้อ่านย้อนตรวจการตัดสินใจที่น่าสงสัยกลับไปยังอินพุตได้
| Checkpoint | สถานะและจุดเริ่มต้นที่ตั้งใจไว้ | สิ่งที่คาดหวังด้านเสียง |
|---|---|---|
granite-switch-4.1-8b | เปิดตัวแล้ว รุ่นพร้อมใช้ที่เล็กกว่า | รวม ASR ภาษาอังกฤษ |
granite-switch-4.1-30b | เปิดตัวแล้ว โมเดลพื้นฐานขนาดใหญ่กว่า พร้อมชุดความสามารถเดียวกัน | รวม ASR ภาษาอังกฤษ |
granite-switch-4.1-3b-preview | รุ่นพรีวิวที่มีชุด adapter ต่างออกไป | ไม่ใช่ชุดที่เปิดตัวพร้อมรองรับเสียง |
model card ของ 8B เปิดตัว 14 ตุลาคม 2026 แยกรุ่นที่รองรับเสียงออกจากตระกูลพรีวิวที่ไม่มีเสียง ส่วน card ของ 30B และ card ของ 3B preview ซึ่งตรวจสอบเมื่อ 18 ตุลาคม อธิบายองค์ประกอบของแต่ละรุ่น รุ่นพรีวิวที่เล็กกว่าใช้แทนรุ่นรองรับเสียงไม่ได้ทันที
card ของ 8B ระบุภาษาแชต 12 ภาษา ได้แก่ อังกฤษ เยอรมัน สเปน ฝรั่งเศส ญี่ปุ่น โปรตุเกส อาหรับ เช็ก อิตาลี เกาหลี ดัตช์ และจีน รายการภาษานั้นไม่ได้ทำให้ตัวรู้จำเสียงเริ่มต้นรองรับภาษาอื่นนอกจากอังกฤษ
เลือกระบบปฏิบัติการก่อนคัดลอกคำสั่ง
สำหรับการตั้งค่า CUDA/vLLM ในคู่มือนี้ ให้เลือก Linux ที่มี NVIDIA GPU และไดรเวอร์เข้ากันได้ บน Windows ให้ใช้ WSL ที่ตั้งค่า GPU access เรียบร้อยแล้ว คำสั่ง Bash เหล่านี้ไม่ใช่คำสั่ง PowerShell โดยตรง บน macOS ให้เริ่มจากแบบฝึกหัดที่โฮสต์ไว้หรือโฮสต์ Linux GPU แทนการคิดว่าสูตร CUDA นี้ใช้กับ Apple Silicon ได้ แนวทางติดตั้ง vLLM GPU ตรวจสอบเมื่อ 18 ตุลาคม 2026
vLLM-Metal และ runtime อื่นมีเส้นทางความเข้ากันได้ของตัวเอง การที่ runtime รองรับระบบปฏิบัติการของคุณไม่ได้ยืนยันว่า checkpoint Switch รุ่นนี้ adapter และ audio cascade ทั้งหมดจะทำงานที่นั่น ต้องมีตัวอย่างที่ตรงกันก่อนเลือกเส้นทางดังกล่าว
เริ่มในเครื่องด้วยแชตก่อน แล้วค่อยเพิ่มเสียงและการตัดสินใจ
ใช้โฟลเดอร์ทำงานใหม่ในเทอร์มินัล Linux หรือ WSL Bash ติดตั้ง Git และ Python 3.12 ก่อน แล้วตรวจว่า nvidia-smi มองเห็น GPU snapshot ของ repository ที่ใช้ในตัวอย่างนี้ต้องการ Python >=3.11,<3.14, PyTorch >=2.11.0, Transformers >=5.16,<=5.17.0 และ vLLM >=0.26.0,<0.31.0 ข้อกำหนดแพ็กเกจ ณ revision 7e72456 ตรวจสอบเมื่อ 18 ตุลาคม 2026
- ติดตั้งแพ็กเกจ Switch และ dependency สำหรับเสียงพร้อมกัน วิธีนี้ pin สูตรจาก source แทนการพึ่ง wheel ที่เผยแพร่มานานแล้ว
git clone https://github.com/generative-computing/granite-switch.git
cd granite-switch
git checkout 7e724560f9a9449bba2f08e16e8678c4dd6a06e7
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install -e '.[vllm,audio]' openai
python -m pip check
extras แต่ละชุดมีหน้าที่เฉพาะ: [hf] เพิ่มการ inference ผ่าน Hugging Face, [compose] เพิ่มเครื่องมือประกอบโมเดล และ [audio] ดึง dependency ถอดรหัสเสียงของ vLLM การติดตั้งแค่ vllm ไม่ได้ติดตั้งปลั๊กอิน Switch ให้ด้วย ให้รักษาชุด PyTorch/CUDA ที่ resolve แล้วให้เข้ากับไดรเวอร์ อย่าแก้ resolver error ด้วยการถอดการตรวจ dependency การใช้งานครั้งแรกจะดาวน์โหลดน้ำหนักโมเดล จึงควรเตรียมเวลาและพื้นที่ดิสก์สำหรับ checkpoint ก่อนเริ่มบันทึกเสียง
- เปิดเซิร์ฟเวอร์ที่รับการเชื่อมต่อเฉพาะ loopback หนึ่งตัว ค่าจำกัด context และ concurrency ด้านล่างเป็นจุดเริ่มต้นแบบระมัดระวัง ไม่ใช่การรับประกันว่าจะพอดีกับฮาร์ดแวร์
VLLM_PLUGINS=register_granite_switch \
python -m vllm.entrypoints.openai.api_server \
  --model ibm-granite/granite-switch-4.1-8b \
  --host 127.0.0.1 --port 8000 \
  --max-model-len 4096 --max-num-seqs 1 \
  --gpu-memory-utilization 0.80 --enable-prefix-caching
แพ็กเกจลงทะเบียน register_granite_switch ไว้ใน vllm.general_plugins vLLM ค้นพบ entry point ที่ติดตั้งไว้ ส่วน environment variable จะเลือกปลั๊กอินนี้อย่างชัดเจน สูตรนี้ไม่ต้องใช้สคริปต์ลงทะเบียนที่คัดลอกมาเองหรือวิธีแก้ --trust-remote-code source สำหรับการลงทะเบียนของ Switch และ ระบบปลั๊กอิน vLLM ตรวจสอบเมื่อ 18 ตุลาคม 2026
- ตรวจคำตอบแชตทั่วไป ในเทอร์มินัล Bash อีกหน้าต่างหนึ่ง รอให้เซิร์ฟเวอร์พร้อม แล้วรัน:
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"Rewrite this request clearly without adding facts: The replacement keyboard arrived damaged. Please send a new one."}],"max_tokens":120,"temperature":0}'
อ่านข้อความ assistant ภายใน JSON คำตอบที่ดีคือรักษาคำขอโดยไม่แต่งหมายเลขคำสั่งซื้อ กำหนดเวลา หรือการอนุมัติคืนเงินขึ้นมาเอง การได้รับ HTTP response ไม่ใช่การตรวจว่าคำตอบมีประโยชน์
- ส่งไฟล์ WAV ภาษาอังกฤษสั้น ๆ วางไฟล์บันทึกที่ได้รับความยินยอมและไม่มีข้อมูลละเอียดอ่อนชื่อ
request.wavไว้ในโฟลเดอร์ repository เปิดใช้ virtual environment เดิมในเทอร์มินัลที่สอง บันทึกโค้ดต่อไปนี้เป็นtry_audio.pyแล้วรันpython try_audio.py
import base64
from pathlib import Path
from openai import OpenAI

audio_bytes = Path("request.wav").read_bytes()
message_parts = [
    {"type": "text", "text": "List the requests in this recording. Do not add facts."},
    {"type": "input_audio", "input_audio": {
        "format": "wav",
        "data": base64.b64encode(audio_bytes).decode("ascii"),
    }},
]
local = OpenAI(api_key="unused", base_url="http://127.0.0.1:8000/v1")
reply = local.chat.completions.create(
    model="ibm-granite/granite-switch-4.1-8b",
    messages=[{"role": "user", "content": message_parts}],
    max_tokens=160,
    temperature=0,
)
print(reply.choices[0].message.content)
ผลลัพธ์นี้เป็นคำตอบของ language model ที่ใช้ข้อความถอดเสียงซึ่ง cascade แทรกเข้ามาภายใน ไม่ใช่ไฟล์ ASR ดิบที่ไม่ผ่านการแตะต้อง คู่มือเสียงอธิบาย cascade และรูปแบบอินพุต หากต้องตรวจสองขั้นตอนแยกกัน ให้ใช้แอปพลิเคชันที่เปิดดูข้อความถอดเสียงได้ เอกสารเสียง ตรวจสอบเมื่อ 18 ตุลาคม 2026
- ลองการตัดสินใจแบบมีขอบเขตหนึ่งครั้งด้วยข้อความที่ตรวจแล้ว เปิดเซิร์ฟเวอร์ค้างไว้ แล้วส่ง:
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"State:\nThe replacement keyboard arrived damaged. Please send a new one."},{"role":"user","content":"### DECISION\nQuestion:\nWhich queue should review this request?\n\nOptions:\nA: Damaged-item replacements\nB: Account access\nC: Human triage because neither category fits\n\nReply with exactly one option label."}],"chat_template_kwargs":{"adapter_name":"decision"},"max_tokens":1,"temperature":0}'
ตัวอย่างนี้ทดสอบการเลือก adapter และขอเพียงหนึ่งป้ายกำกับ ไม่ได้ขอรายงานความน่าจะเป็น หากต้องการความน่าจะเป็น ให้ทำตาม ตัวอย่าง decision ใน model card ตรวจสอบเมื่อ 18 ตุลาคม 2026: ตรวจว่าป้ายเป็น token เดียว ขอ logprob_token_ids แล้ว normalize ค่าระหว่างป้ายตัวเลือก อย่าใช้ประโยคที่แชตสร้างขึ้นว่า "ฉันมั่นใจ 95%" แทน เอกสาร readout ของ decision adapter ตรวจสอบเมื่อ 18 ตุลาคม อธิบาย softmax ระดับตัวเลือก
ทำให้สามเวิร์กโฟลว์ตรวจทานได้ ไม่ใช่แค่ทำงานอัตโนมัติ
ตัวอย่างต่อไปนี้เป็นการประยุกต์เชิงภาพประกอบ ไม่ใช่รายงานการทดลอง เริ่มจากเอาต์พุตที่ช่วยให้คนตรวจงานได้ แล้วค่อยเพิ่มการกระทำที่มีผลสำคัญหลังประเมินกรณีตัวอย่างแล้ว
จัดเส้นทางข้อความเสียงจากลูกค้า ใช้ ASR เก็บคำขอ ใช้แชตเขียนสรุปอย่างเป็นกลาง และใช้คำถาม decision เลือกระหว่างเปลี่ยนสินค้า ช่วยเรื่องบัญชี หรือส่งให้คนตรวจ เก็บเสียงต้นฉบับไว้เชื่อมกับข้อความถอดเสียงที่ตรวจแล้ว ประโยคอย่าง "do not cancel my order" (ห้ามยกเลิกคำสั่งซื้อของฉัน) ควรเป็นกรณีทดสอบที่ตั้งใจเตรียมไว้ ไม่ใช่เพิ่งนึกถึงหลังสร้างระบบยกเลิกอัตโนมัติ
เกณฑ์ยอมรับผลเป็นรูปธรรม: คิวที่เลือกตรงกับคำพูดจริงหรือไม่ และเจ้าหน้าที่บริการลูกค้าแก้ไขได้ก่อนส่งอะไรออกไปหรือไม่ ธงความปลอดภัยอาจขอให้ตรวจเพิ่ม แต่ไม่ควรทิ้งคำร้องเรียนของลูกค้าที่กำลังไม่พอใจไปเงียบ ๆ
เปลี่ยนอัปเดตโครงการให้เป็นงานฉบับร่าง ในบันทึกภาษาอังกฤษสมมติ เพื่อนร่วมงานพูดว่า "I can review the draft Friday, but I cannot approve the budget." (ฉันตรวจร่างได้วันศุกร์ แต่อนุมัติงบไม่ได้) ให้แชตแยกสิ่งที่รับปากออกจากสิ่งที่ไม่รับปาก จากนั้นถาม decision adapter ว่ามีการอนุมัติงบ ระบุว่าไม่มี หรือยังไม่ชัดเจน เปิดทางเลือก "ไม่ชัดเจน" ไว้เมื่อเสียงหรือบริบทไม่พอ ให้คนตรวจวันที่กับผู้รับผิดชอบก่อนเพิ่มงานลง tracker ที่ใช้ร่วมกัน
เตรียมรายการติดตามผลการสัมภาษณ์ เมื่อได้รับอนุญาตจากผู้พูด ให้ถอดเสียงช่วงสัมภาษณ์ภาษาอังกฤษสั้น ๆ แล้วร่างคำถามเกี่ยวกับรายละเอียดที่ขาด ใช้การตัดสินใจแบบมีขอบเขต เช่น "ข้อความช่วงนี้ระบุวันส่งมอบไว้อย่างชัดเจนหรือไม่?" แทน "บุคคลนี้น่าเชื่อถือหรือไม่?" เก็บข้อความต้นทางที่รองรับแต่ละธงไว้ด้วย วิธีนี้ช่วยแก้ข้อเห็นต่างได้โดยไม่ตีความโมเดลเป็นคำตัดสินเกี่ยวกับตัวผู้พูด
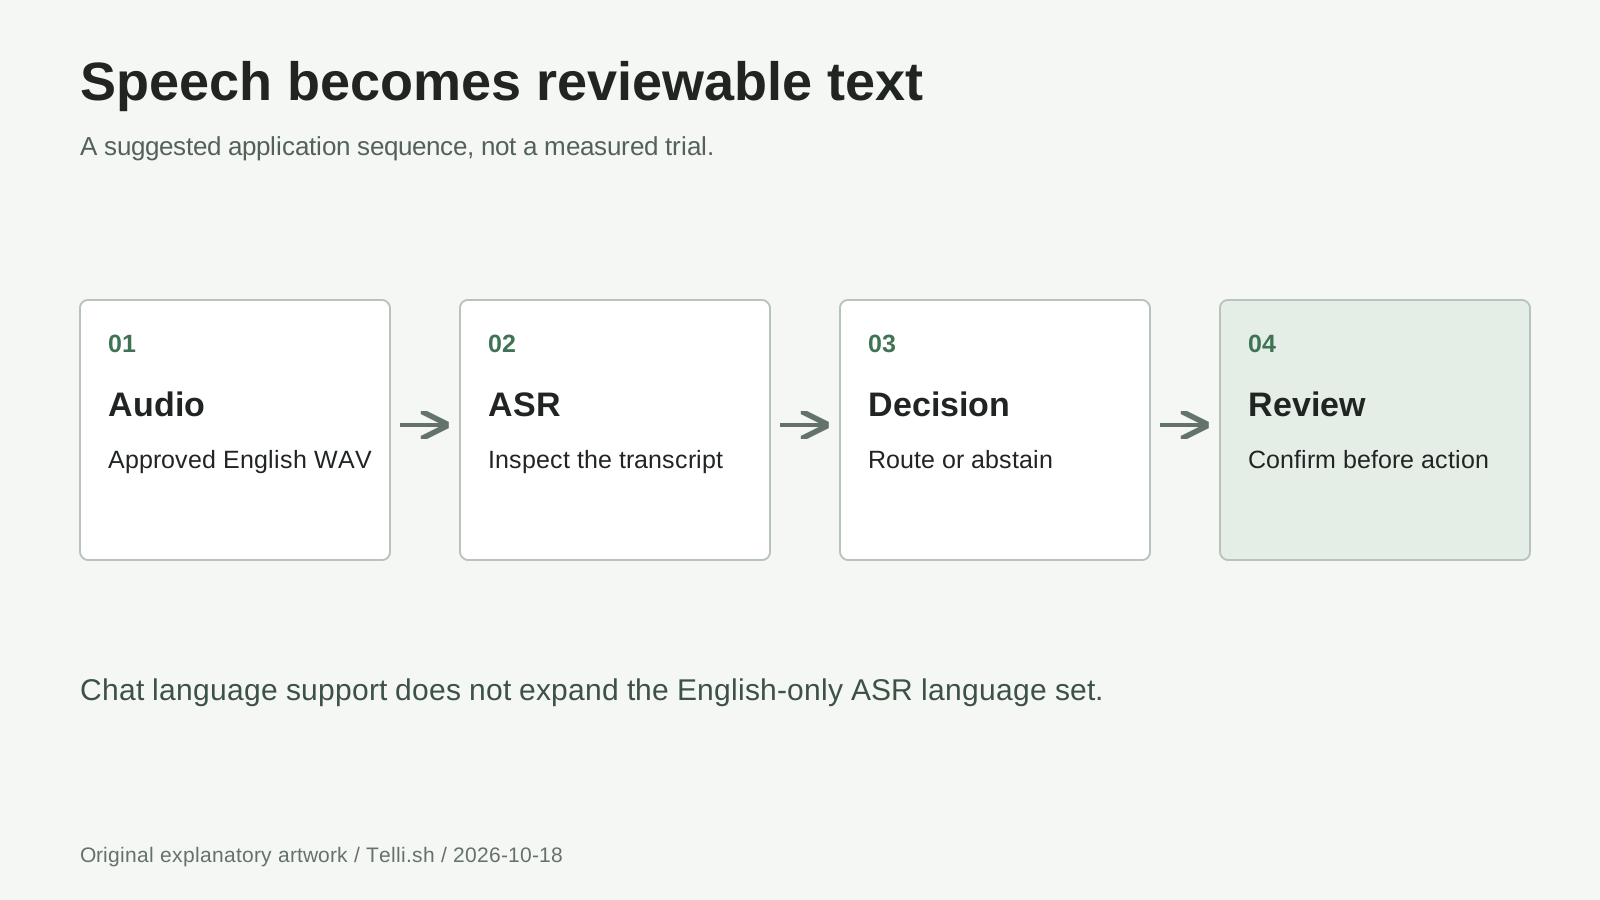
แผนผังเวิร์กโฟลว์ต้นฉบับ: เก็บเสียงและข้อความถอดเสียงไว้ สร้างผลลัพธ์ที่ได้มาทีหลังแยกจากกัน แล้วตรวจทานก่อนดำเนินการ ภาพนี้แสดงตัวอย่างการประยุกต์ข้างต้น ไม่ใช่ส่วนติดต่ออย่างเป็นทางการ ส่วน cascade พื้นฐานอธิบายไว้ใน คู่มือเสียง ตรวจสอบเมื่อ 18 ตุลาคม 2026
ทำไมหลายความสามารถจึงใช้ context ร่วมกันได้?
key/value cache เก็บข้อมูล attention ที่คำนวณจาก token ก่อนหน้า Activated LoRA หรือ aLoRA ช่วยให้ specialist เริ่มทำงานหลัง context ที่ใช้ร่วมกันได้ แทนที่จะต้องประมวลผล prefix ทั้งหมดซ้ำแบบ adapter ทั่วไป IBM อธิบายแนวทางพื้นฐานนี้ในงานวิจัยเมื่อ 17 เมษายน 2025 งานวิจัย IBM เรื่อง aLoRA
Switch ใช้สถานะ cache ของโมเดลพื้นฐานที่ผ่าน normalization เพื่อไม่ให้ specialist ใช้สถานะที่ถูกปรับเฉพาะของกันและกันปะปนกัน ในระดับแอป ให้คง prefix หลักฐานไว้เหมือนเดิมแล้วต่อท้ายคำถามเฉพาะงาน การเขียนข้อความถอดเสียงใหม่ต่างกันสำหรับทุกการตรวจจะบั่นทอนการ reuse prefix เอกสารกลไก Switch ตรวจสอบเมื่อ 18 ตุลาคม 2026
การใช้ cache ร่วมกันเป็นกลไกเพิ่มประสิทธิภาพ ไม่ใช่ inference ฟรี prefix caching ลดการประมวลผลพรอมป์ต์ซ้ำ แต่ไม่ได้ตัดการสร้างคำตอบหรือการรู้จำเสียงออก เอกสาร prefix caching ของ vLLM ตรวจสอบเมื่อ 18 ตุลาคม 2026 มุมมองของเรา: ให้เปรียบเทียบเวิร์กโฟลว์ทั้งหมดที่ผ่านการตรวจทานแล้ว ไม่ใช่ความเร็วพาดหัวแบบแยกส่วน
คิดงบให้ครอบคลุมงานทั้งหมด ไม่ใช่แค่น้ำหนัก 8B
ตัวอย่างคำนวณสำหรับการวางแผน: พารามิเตอร์ 8 พันล้านตัวที่ใช้สองไบต์ต่อตัวกินพื้นที่ราว 16GB หรือ 14.9GiB; 30 พันล้านตัวกินราว 60GB หรือ 55.9GiB นี่เป็นตัวอย่างคำนวณขนาดน้ำหนักพื้นฐาน ไม่ใช่ขนาด checkpoint หรือข้อกำหนด VRAM ขั้นต่ำ และยังไม่รวม adapter, speech encoder, cache, buffer ชั่วคราว และ overhead ของ runtime
context ที่ยาวขึ้นและ sequence ที่ทำงานพร้อมกันมากขึ้นเพิ่มแรงกดดันต่อหน่วยความจำ เพดาน context ที่โฆษณาไว้ไม่ได้แปลว่าควรจองทั้งหมดไว้กับการทดลองแรก vLLM ระบุว่าการลด max_model_len และ max_num_seqs เป็นวิธีควบคุมหน่วยความจำ แนวทางหน่วยความจำ vLLM ตรวจสอบเมื่อ 18 ตุลาคม 2026
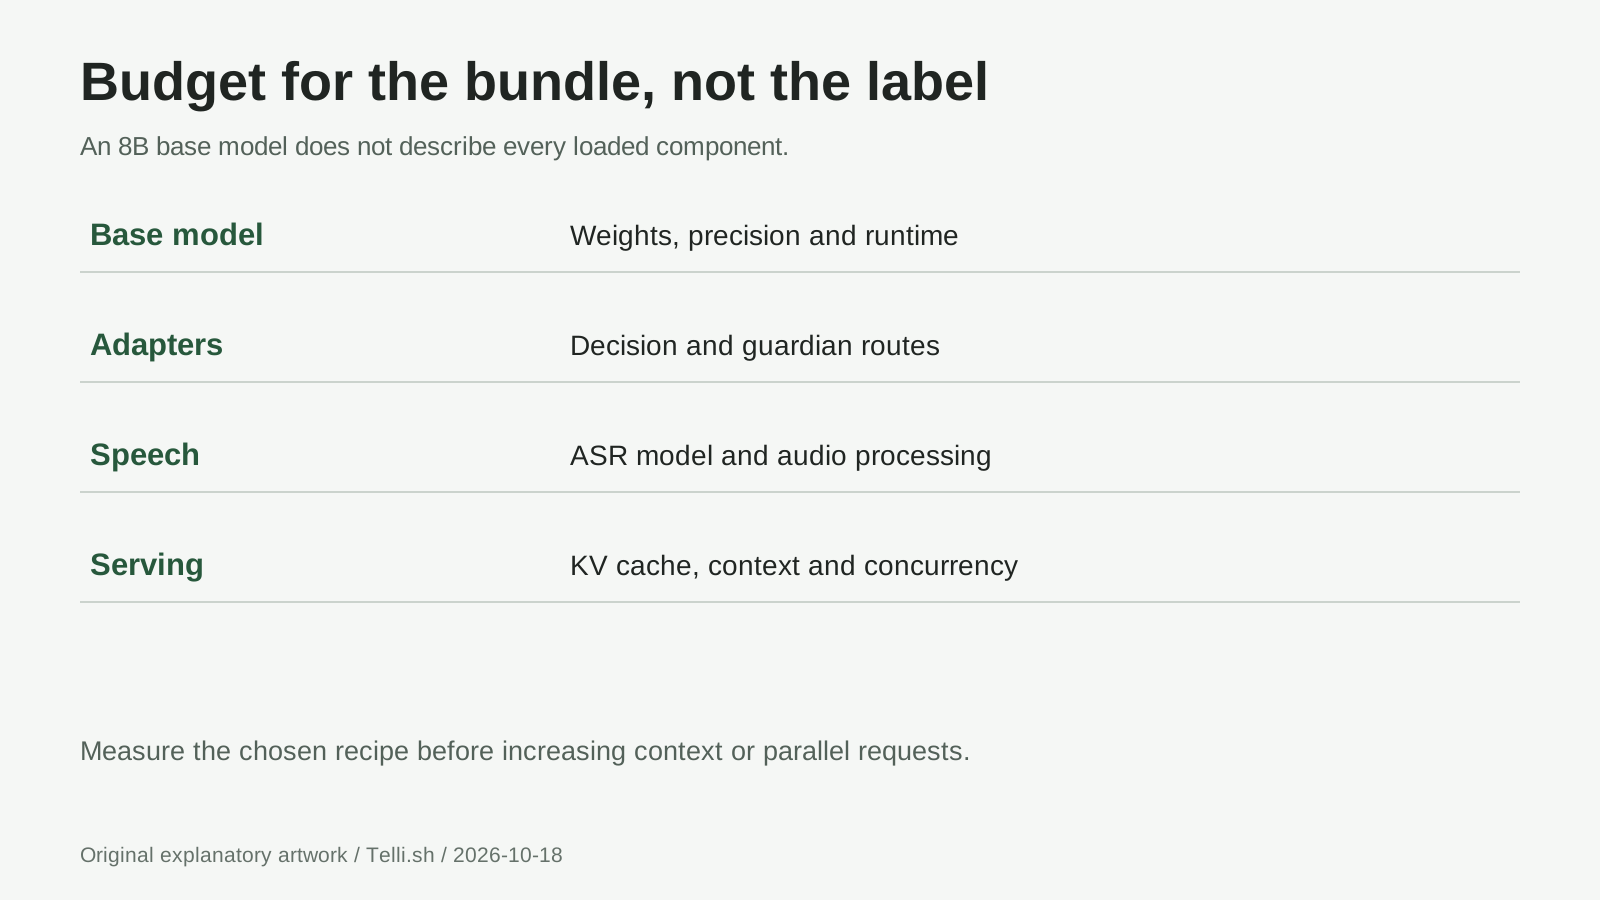
รายการตรวจหน่วยความจำต้นฉบับ ไม่ได้แสดงสัดส่วนจริง: น้ำหนักพื้นฐาน + adapter + น้ำหนักและ activations ของ ASR + KV cache + พื้นที่เผื่อ runtime/จอแสดงผล คู่มือเสียง เตือนว่าการจอง cache ล่วงหน้าอาจเหลือพื้นที่ไม่พอสำหรับ ASR ตรวจสอบเมื่อ 18 ตุลาคม 2026
ทดสอบแชตสั้น คลิปสั้น และอินพุตปกติที่ยาวที่สุดแยกกัน จดข้อสังเกตเรื่องหน่วยความจำสูงสุด เวลาเสร็จ และข้อผิดพลาด การลดการจอง cache อาจเหลือที่ให้เสียงมากขึ้น แต่ไม่ทำให้น้ำหนักที่ใหญ่เกินไปพอดี การใช้ตัวเลือก quantized ต้องตรวจความเข้ากันได้กับ Switch adapter และเสียงแยกต่างหาก ไม่ใช่ดูเพียงว่าดาวน์โหลดเล็กลง
ผูกต้นทุนและความเป็นส่วนตัวไว้กับทางเลือกการติดตั้ง
ไลเซนส์โมเดล Apache-2.0 ไม่ได้ทำให้การใช้งานไร้ต้นทุน การใช้งานในเครื่องกินทรัพยากรฮาร์ดแวร์ ไฟฟ้า พื้นที่จัดเก็บ และเวลาบำรุงรักษา ส่วน endpoint ที่โฮสต์ไว้เพิ่มค่าบริการของผู้ให้บริการและข้อกำหนดการจัดการข้อมูล อย่าคิดว่ามีราคาต่อหนึ่งนาทีของ Granite Switch ที่ใช้ได้ทุกกรณี ในโครงการนำร่อง ให้หารต้นทุน compute และการตรวจทานทั้งหมดด้วยจำนวนงานที่เสร็จสำเร็จ โดยนับคำขอที่ล้มเหลวและการแก้ไขด้วย
ตัวอย่างงบสมมติทำให้เห็นภาพ: ใช้บริการผู้ให้บริการ 10 ชั่วโมง ในอัตรา $1 ต่อชั่วโมง เท่ากับค่า compute $10 ยังไม่รวมพื้นที่จัดเก็บ การส่งข้อมูล และการตรวจโดยคน ตัวเลขนี้เป็นอินพุตเพื่อสาธิต ไม่ใช่ราคาบริการที่เสนอขาย ชั่วโมงที่ endpoint เปิดทิ้งไว้โดยไม่มีงานก็มีต้นทุนเช่นกัน
สำหรับงานละเอียดอ่อน ให้ตัดสินใจก่อนบันทึกเสียงว่าเสียง ข้อความถอดเสียง cache, logs และ backups จะอยู่ที่ใด การผูกเซิร์ฟเวอร์กับ loopback จำกัดการเข้าถึงเครือข่าย แต่ไม่ได้กำหนดกติกาการเก็บรักษาข้อมูลหรือปิด telemetry ของทุกไลบรารี ให้เซิร์ฟเวอร์ไม่รับการเชื่อมต่อจากอินเทอร์เฟซสาธารณะ ตรวจ dependency และ logging ขออนุญาตผู้พูด และกำหนดการลบไฟล์เสียงต้นฉบับกับระเบียนที่ได้มาทีหลังแยกกัน เดโมที่โฮสต์ไว้เหมาะสำหรับเรียนรู้ ไม่ใช่ปลายทางเริ่มต้นสำหรับการประชุมลับ
แก้ขั้นตอนที่ล้มเหลวก่อนเปลี่ยนทั้งระบบ
ยังไม่ทราบสถาปัตยกรรม ตรวจว่า virtual environment มี granite-switch อยู่ vLLM ใช้ environment นั้น และ VLLM_PLUGINS มี register_granite_switch อ่านข้อผิดพลาด import ของปลั๊กอินรายการแรกก่อนเปลี่ยนแพ็กเกจ
แชตทำงานแต่เสียงล้มเหลว ยืนยัน release ID ที่รองรับเสียง dependency [audio] และไฟล์ WAV จริง ไม่ใช่แค่เปลี่ยนนามสกุล ตรวจเวอร์ชัน Transformers และหน่วยความจำที่เหลือ การติดตั้งไลบรารีถอดรหัสเสียงทำให้ checkpoint แบบ text-only กลายเป็น checkpoint เสียงไม่ได้
ชื่อหรือเครื่องหมายวรรคตอนผิด ตัวรู้จำ CTC ภาษาอังกฤษเริ่มต้นให้ข้อความตัวพิมพ์เล็ก ไม่มีเครื่องหมายวรรคตอน และไม่มีการกำหนดภาษาในขั้น decode เก็บข้อความดิบนี้ไว้ การเติมวรรคตอนเป็นการแก้ไขข้อมูลที่ได้มาในภายหลัง cascade อาจส่งต่อข้อผิดพลาดถอดเสียงไปยังการตัดสินใจภายหลังได้ ข้อจำกัดด้านเสียง ตรวจสอบเมื่อ 18 ตุลาคม 2026
คลิปยาวเกิน context ย่ออินพุตหรือแบ่งเป็นช่วงที่มีความหมาย โดยเก็บการอ้างอิงต้นทางไว้ ข้อความถอดเสียงใช้พื้นที่ context ต้องเหลือที่พอสำหรับคำถามและคำตอบ การเพิ่มขีดจำกัด context ยังเปลี่ยนงบหน่วยความจำด้วย
ควรรู้อะไรก่อนพึ่งพาโมเดลนี้?
มันพูดคำตอบออกเสียงได้ไหม? เส้นทางเสียงที่รวมมานี้คือ ASR ไม่ใช่ text-to-speech แอปที่ต้องการเสียงตอบกลับต้องมีองค์ประกอบ TTS แยกต่างหาก
ถอดเสียงได้ครบทั้ง 12 ภาษาแชตหรือไม่? ไม่ได้ หากใช้ตัวรู้จำภาษาอังกฤษเริ่มต้น คู่มือเสียงอธิบายการเปลี่ยน backend ASR เพื่อป้อนเสียงหลายภาษา ซึ่งเป็นการตั้งค่าอีกแบบที่ต้องประเมิน
ความน่าจะเป็น 0.95 ของตัวเลือกหมายความว่าถูกต้องจริง 95% หรือไม่? ไม่ใช่ เป็นการกระจายของโมเดลเหนือชุดตัวเลือกที่ให้ ไม่ใช่อัตราความสำเร็จที่ตรวจยืนยันในโดเมนของคุณ ตัวเลือกไม่ครบ ข้อความถอดเสียงผิด และคำถามกำกวมยังทำให้โมเดลเอนเอียงไปทางหนึ่งอย่างมากได้ ให้ประเมินตัวอย่างที่มีป้ายกำกับและกำหนดกติกาการงดตัดสินก่อนทำงานอัตโนมัติ เอกสาร decision adapter ตรวจสอบเมื่อ 18 ตุลาคม 2026
Guardian พิสูจน์ว่าคำตอบเป็นความจริงหรือไม่? ไม่ได้ การคัดกรองความปลอดภัยต่างจากการตรวจสอบข้อเท็จจริง release ที่ประกอบมาพร้อมใช้ไม่มี specialist ทุกตัวจากคอลเลกชัน Granite Libraries ที่กว้างกว่า ให้ตรวจรายการ adapter ก่อนออกแบบเวิร์กโฟลว์ตรวจความถูกต้อง
บทสรุป: endpoint เดียวก็ยังต้องมีร่องรอยหลักฐาน
Granite Switch 4.1 มีประโยชน์ที่สุดเมื่อแชตช่วยอธิบาย เสียงให้คำพูดที่ตรวจทานได้ และการตัดสินใจแบบมีขอบเขตช่วยจัดสิ่งที่จะทำต่อ การเสิร์ฟโมเดลแบบ modular ลดการทำโครงสร้างพื้นฐานซ้ำ แต่เวิร์กโฟลว์ของคุณยังรับผิดชอบเรื่องความยินยอม หลักฐาน และอำนาจในการลงมือ
เริ่มด้วยเสียงสั้นหนึ่งรายการและการตัดสินใจที่ย้อนกลับได้หนึ่งข้อ ขยายงานก็ต่อเมื่อผู้รับผิดชอบผลลัพธ์ยังเข้าใจข้อความถอดเสียง การตีความ และการกระทำได้ชัดเจน
แหล่งข้อมูล
วันที่เผยแพร่: บทความเปิดตัวของ IBM ลงวันที่ 15 ตุลาคม 2026 ส่วน model card ของ 8B ระบุวันที่ 14 ตุลาคม 2026 ตรวจเอกสารที่ลิงก์ไว้เมื่อ 18 ตุลาคม 2026 คำแนะนำการตั้งค่าดัดแปลงจากเอกสารปฐมภูมิ ไม่ใช่ผลประสิทธิภาพจากการทดลองจริง แผนภาพเป็นภาพประกอบบรรณาธิการต้นฉบับ ไม่มีการนำภาพจากผู้ผลิตมาเผยแพร่ซ้ำ
- บทความเปิดตัว IBM, model card 8B, model card 30B และ card 3B preview: ขอบเขตการเปิดตัวและความต่างของ checkpoint
- repository Granite Switch, ข้อกำหนดแพ็กเกจที่ pin ไว้ และ คู่มือเสียง: การติดตั้ง สถาปัตยกรรม และข้อจำกัดของเสียง
- เดโมเสียงอย่างเป็นทางการ, เอกสารเดโม และ โน้ตบุ๊กเปรียบเทียบ aLoRA race อย่างเป็นทางการ: ตัวอย่างให้สำรวจ ไม่ใช่ผลวัดจากคู่มือนี้
- คำอธิบาย aLoRA ของ IBM วันที่ 17 เมษายน 2025 และ เอกสาร vLLM: กลไกและข้อกำหนดการใช้งานที่กล่าวถึงข้างต้น
คำแนะนำ Telli.sh ที่ไม่บังคับ: เก็บแหล่งข้อมูลไว้เบื้องหลังการตัดสินใจ
เก็บไฟล์เสียงต้นฉบับ บันทึก และผลลัพธ์ที่ตรวจแล้วไว้ด้วยกัน เพื่อให้การตัดสินใจภายหลังยังมีบริบท สร้างบัญชี Telli.sh เพื่อจัดระเบียบเอกสารอ้างอิงเหล่านั้นเมื่อเวิร์กโฟลว์ของคุณเติบโตขึ้น