GPT-6.1 Terra คิดค่าอินพุต 1 ดอลลาร์ต่อล้านโทเคน แล้วงานที่เสร็จจริงมีต้นทุนเท่าไร
GPT-6.1 Terra ลดราคาโทเคนมาตรฐานสำหรับการให้เหตุผลจากภาพและการใช้คอมพิวเตอร์ มาดูวิธีประเมินงานที่ยอมรับได้ การลองใหม่ เวลาตรวจทาน และระบบที่เชื่อมต่อโมเดล
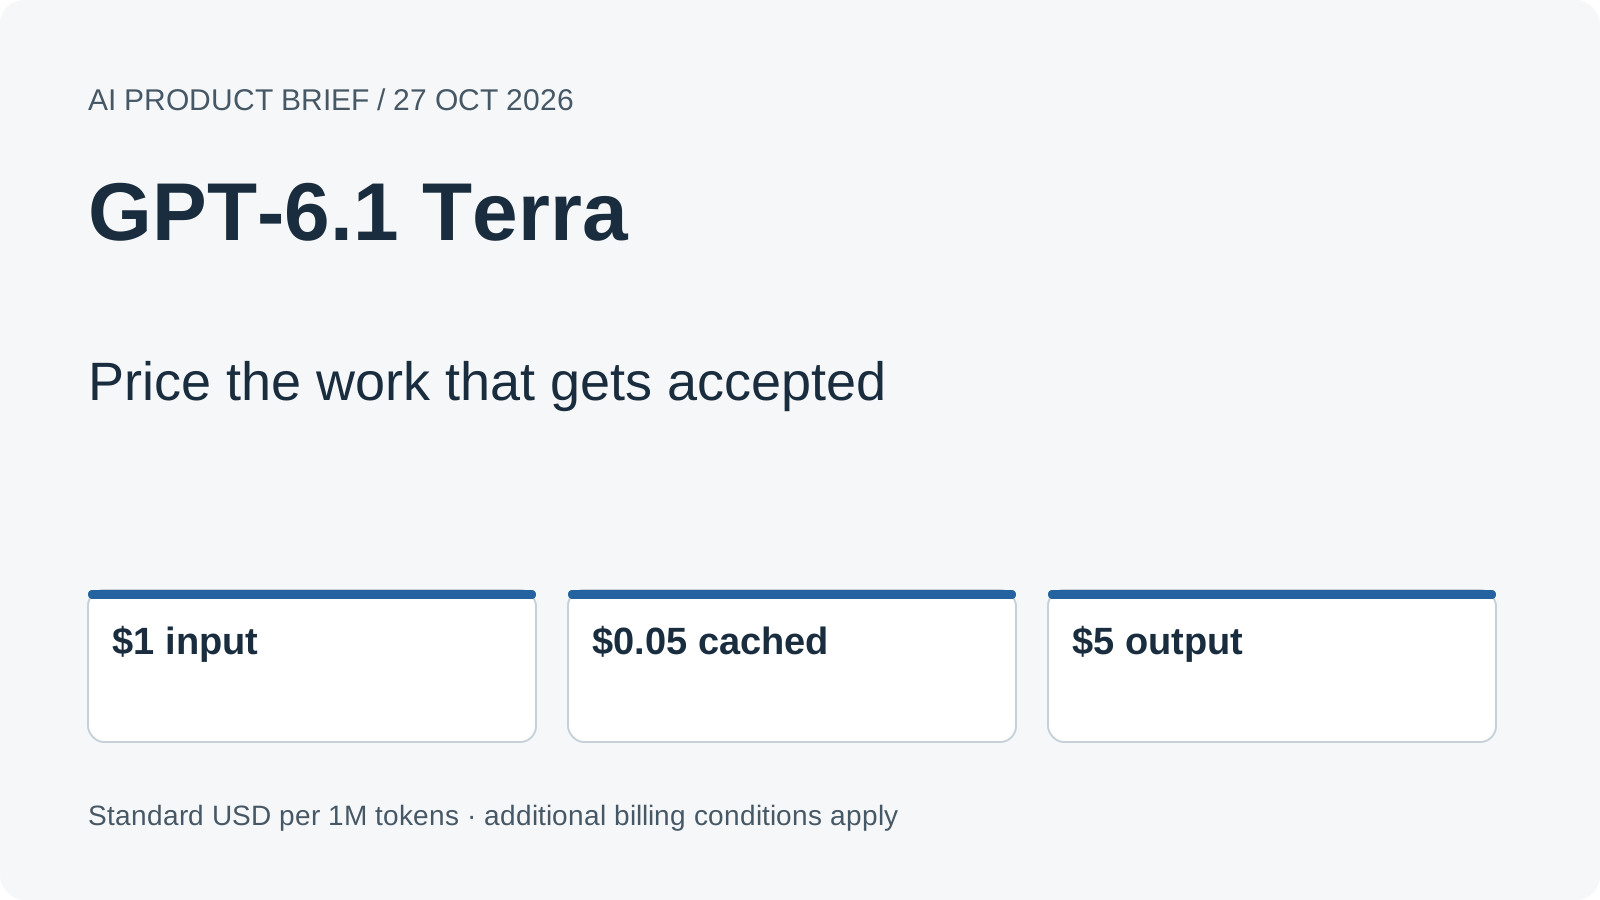
แผนภาพอธิบายต้นฉบับโดย Ken Jo อ้างอิงจากแหล่งข้อมูลที่ระบุไว้ด้านล่าง
ด้านหนึ่งของหน้าจอมีใบแจ้งหนี้ อีกด้านมีแบบฟอร์มบัญชี การอ่านยอดเงินเป็นงานหนึ่ง แต่การเลือกผู้ขายให้ถูก ใส่สกุลเงินให้ตรง และรู้ว่าระเบียนที่บันทึกมีอยู่จริงเป็นงานที่ใหญ่กว่า ความต่างนี้สำคัญเป็นพิเศษเมื่อโมเดล AI เป็นผู้คลิก
OpenAI เปิดตัว GPT-6.1 Terra เมื่อวันที่ 26 ตุลาคม 2026 โดยราคา API มาตรฐานอยู่ที่ อินพุต 1 ดอลลาร์ต่อล้านโทเคน อินพุตที่อยู่ในแคช 0.05 ดอลลาร์ต่อล้านโทเคน และเอาต์พุต 5 ดอลลาร์ต่อล้านโทเคน บริษัทวางตำแหน่งโมเดลสำหรับการให้เหตุผลจากภาพ การใช้คอมพิวเตอร์ และการเขียน พร้อมระบุว่าราคามาตรฐานต่ำกว่า GPT-5.6 Terra และ GPT-6.1 Sol 50% ดู ประกาศอย่างเป็นทางการ และ system card ที่ระบุวันที่
ราคาที่ลดลงทำให้ทดลองได้มากขึ้น แต่การตัดสินใจว่าการทดลองใดควรกลายเป็นขั้นตอนทำงานต้องใช้ตัวชี้วัดอีกแบบ นั่นคือต้นทุนของผลลัพธ์ที่ยอมรับได้ บทความนี้พาไปดูสามกรณีใช้งาน ตัวอย่างคำนวณที่เปิดเผยสมมติฐาน และวิธีประเมินโมเดลโดยไม่สับสนระหว่างการเรียกเครื่องมือสำเร็จกับงานที่เสร็จจริง
โมเดลเลือกการกระทำภายในระบบที่เป็นผู้ลงมือ
Terra เป็นโมเดลจาก OpenAI บริษัทผู้พัฒนา ChatGPT และ Codex การเลือกโมเดลนี้ทำให้แอปพลิเคชันได้ความสามารถด้านภาษาและภาพชุดหนึ่ง ส่วนแอปพลิเคชันที่ล้อมรอบยังเป็นผู้กำหนดว่าจะมองเห็นหน้าจอใด เรียกเครื่องมืออะไรได้ และเครื่องมือเข้าถึงบัญชีใดได้บ้าง
ลองมองตัวอย่างใบแจ้งหนี้เป็นขั้นตอนทำงานสมมติ โมเดลดูแบบฟอร์ม เสนอการกระทำ และรับภาพที่อัปเดตหลังเครื่องมือดำเนินการ ภาพใหม่สำคัญ เพราะการคลิกที่ดูถูกต้องอาจเปิดแผงอื่น แสดงข้อผิดพลาดในการตรวจข้อมูล หรือยังบันทึกไม่เสร็จ ขั้นตอนทำงานต้องรู้สถานะที่เกิดขึ้นก่อนดำเนินต่อ
การใช้คอมพิวเตอร์จึงเป็นวงรอบ ไม่ใช่คำตอบครั้งเดียว การเชื่อมต่อที่มีประโยชน์เชื่อมการสังเกต การกระทำ และการตรวจสถานะผลลัพธ์เข้าด้วยกัน ทั้งยังระบุว่าเมื่อไรควรหยุด ถามคน หรือรายงานว่าขาดข้อมูลที่จำเป็น แม้โมเดลจะตีความหน้าจอได้ดี การตัดสินใจเหล่านี้ก็ยังเป็นส่วนของการออกแบบแอปพลิเคชัน
เอกสารการใช้คอมพิวเตอร์ของ OpenAI ซึ่งตรวจเมื่อ 27 ตุลาคม แยกเหตุการณ์กิจกรรมเบราว์เซอร์ออกจากสถานะสุดท้ายของทั้งเทิร์น และมีการควบคุมว่าจะรวมภาพหน้าจอในเอาต์พุตแบบสตรีมหรือไม่ นักพัฒนาสามารถใช้เหตุการณ์แสดงความคืบหน้า พร้อมตรวจแยกต่างหากว่าผลลัพธ์ที่ขอมีอยู่จริง
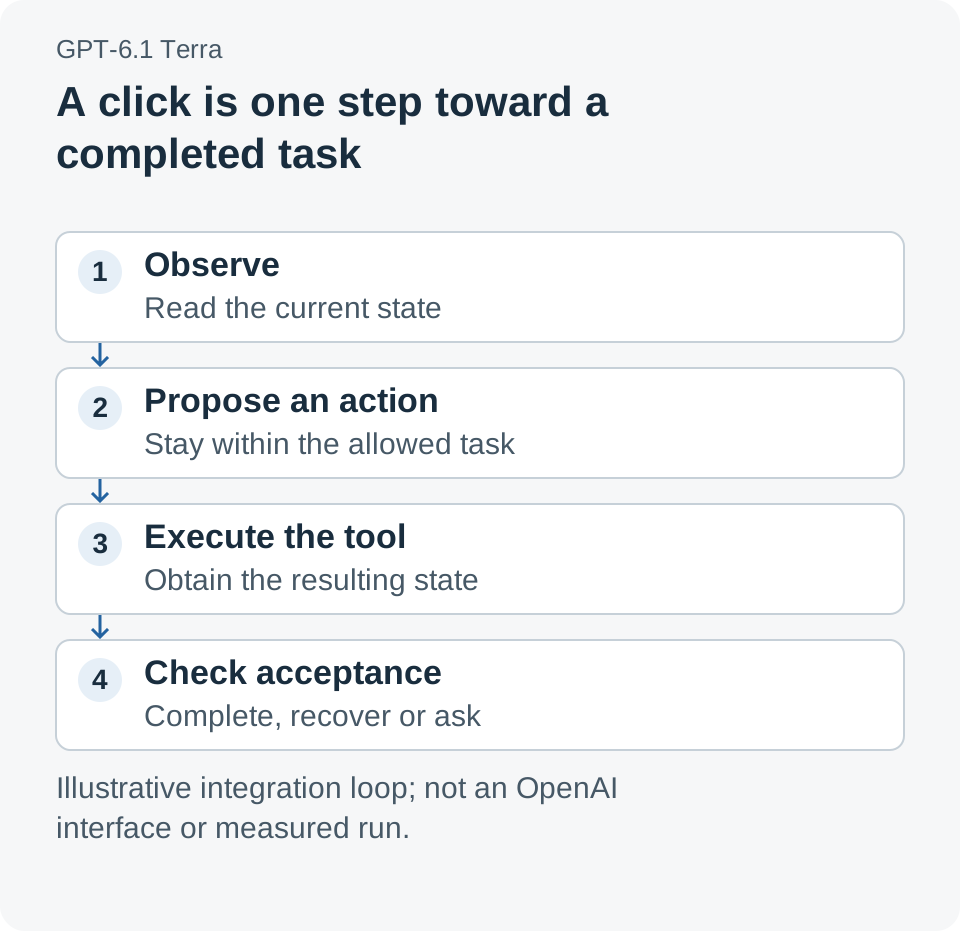
วงรอบการใช้คอมพิวเตอร์แบบตัวอย่าง แอปพลิเคชันจัดหาเครื่องมือและสิทธิ์ ส่วนการตรวจรับบอกว่างานที่ขอเสร็จหรือยัง เป็นภาพอธิบายที่จัดทำขึ้นเอง ไม่ใช่ภาพหน้าจอของ OpenAI
ตารางราคาเป็นจุดเริ่มต้นของงบสำหรับภาระงาน
อัตรามาตรฐานในประกาศวันที่ 26 ตุลาคมเปรียบเทียบได้ตรงไปตรงมาเมื่อใช้เงื่อนไขการคิดเงินเดียวกัน อินพุตและเอาต์พุตราคาไม่เท่ากัน ส่วนอินพุตแคชเป็นอีกหมวดหนึ่ง คำตอบยาวหรือวงรอบสังเกตที่เกิดซ้ำจึงเปลี่ยนยอดเรียกเก็บได้ แม้จำนวนคำขอของผู้ใช้จะคงเดิม
| ประเภทโทเคน | ราคามาตรฐานต่อ 1 ล้านโทเคน | สิ่งที่ควรวัดในการทดลอง |
|---|---|---|
| อินพุต | $1.00 | อินพุตที่คิดเงินรวมทุกครั้งที่พยายาม |
| อินพุตแคช | $0.05 | การใช้แคชได้จริง ไม่ใช่สมมติว่าจะใช้ซ้ำได้ |
| เอาต์พุต | $5.00 | เอาต์พุตที่คิดเงินทั้งหมดของการรัน |
model card ที่ตรวจเมื่อ 27 ตุลาคมระบุเงื่อนไขคิดเงินเพิ่มเติม การเขียนแคชมีอัตราแยก คำขอที่เกิน 272,000 โทเคนอินพุตมีการปรับราคาสำหรับบริบทยาว และโหมดบริการอาจเปลี่ยนราคา ควรใช้ราคาที่ตรงกับคำขอจริง แทนการถือว่าราคาต่ำสุดในตารางใช้ได้กับทุกกรณี
ตัวอย่างคำนวณต่อไปนี้สมมติการประมวลผลมาตรฐาน ไม่ใช้แคช และคำขออยู่ต่ำกว่าเกณฑ์บริบทยาว แต่ละครั้งใช้อินพุตที่คิดเงิน 10,000 โทเคนและเอาต์พุต 1,000 โทเคน จึงมีค่าโทเคน 0.01 + 0.005 = 0.015 ดอลลาร์ต่อครั้ง จำนวนโทเคนนี้เลือกมาเพื่อคำนวณ ไม่ใช่ค่าที่วัดจาก Terra หรือขั้นตอนใบแจ้งหนี้
ความต่างนี้เป็นฐานของงบที่มีประโยชน์ เริ่มจากหาค่าใช้จ่ายต่อความพยายามภายใต้สมมติฐานชัดเจน แล้วจึงถามว่าต้องลองกี่ครั้ง ใช้บริการอื่นอะไร และต้องตรวจทานเท่าไรก่อนมีคนยอมรับผลลัพธ์
การลองใหม่และการตรวจทานเปลี่ยนต้นทุนของงานที่ผ่านการยอมรับ
สมมติชุดงานหนึ่งมีคำขอ 100 งาน ในกรณีแรกระบบลอง 100 ครั้งและรับงานได้ 90 งาน อีกกรณีหนึ่งงานกู้คืนทำให้ต้องลอง 150 ครั้งและรับได้ 95 งาน ความสำเร็จที่เพิ่มขึ้นมีประโยชน์ แต่การเปรียบเทียบต้นทุนเปลี่ยนไปด้วย
ตารางเพิ่มกรณีที่สาม โดยให้คนตรวจ 30 รายการ รายการละ 20 วินาที และสมมติค่าแรง 30 ดอลลาร์ต่อชั่วโมง รวม 600 วินาทีหรือ 10 นาที คิดเป็น 5 ดอลลาร์ จำนวนงาน จำนวนที่ผ่าน และค่าแรงทั้งหมดเป็นตัวอย่าง ไม่ใช่ผลวัดของผลิตภัณฑ์
| ชุดงานสมมติ | ค่าโทเคน | ค่าตรวจทาน | งานที่รับได้ | ค่าใช้จ่ายต่องานที่รับได้ |
|---|---|---|---|---|
| ลอง 100 ครั้ง | $1.50 | $0.00 | 90 | $0.0167 |
| ลอง 150 ครั้ง | $2.25 | $0.00 | 95 | $0.0237 |
| ลอง 150 ครั้งพร้อมการตรวจตามที่ระบุ | $2.25 | $5.00 | 95 | $0.0763 |
ตัวหารคืองานที่รับได้ ไม่ใช่จำนวนคำตอบที่สร้าง ข้อความแจ้งสำเร็จที่เขียนดีไม่ได้เพิ่มตัวหารหากระเบียนถูกบันทึกผิด ในทางกลับกัน ขั้นตอนที่ถามยืนยันสั้น ๆ อาจให้ผลที่มีประโยชน์กว่าการเดินหน้าด้วยความมั่นใจทั้งที่ข้อมูลไม่ครบ
อาจเรียกงานส่วนเพิ่มนี้ว่า บิลเพื่อให้งานเสร็จ คือทรัพยากรที่ต้องใช้เพื่อเปลี่ยนการพยายามกระทำให้เป็นผลลัพธ์ที่ยอมรับได้ ราคาโทเคนเป็นเพียงหนึ่งรายการ ค่าบริการเครื่องมือ สภาพแวดล้อมดำเนินงาน การกู้คืน และการตรวจของคนก็อาจเพิ่มเข้ามา ตารางละบริการเหล่านี้เพื่อให้เห็นเลขคำนวณชัด แต่ประมาณการใช้งานจริงควรรวมสิ่งที่ระบบใช้จริง
ในมุมมองของเรา ผลสำคัญที่สุดของโมเดลราคาถูกลงคือมีพื้นที่ให้ปรับปรุงการทำงานจนเสร็จ ทีมสามารถเปรียบเทียบคำสั่ง ดูกรณีล้มเหลว และทดสอบทางกู้คืนได้ การลดราคาคำตอบที่ยังไม่ได้ตรวจมีประโยชน์น้อยกว่าการนำเงินที่ประหยัดไปทำให้งานต้องแก้ไขน้อยลง
เริ่มจากร่างรายการใบแจ้งหนี้ที่มีจุดจบชัดเจน
กรณีแรกคือผู้ช่วยงานเจ้าหนี้ที่เตรียมร่างระเบียนจากใบแจ้งหนี้ที่ให้มา ใช้บัญชีทดสอบและเอกสารตัวอย่างจำนวนจำกัด ระบุผู้ขาย สกุลเงิน ยอดเงิน และช่องอ้างอิงที่ต้องการก่อนให้โมเดลใช้งานแบบฟอร์ม
ผลที่รับได้คือร่างที่บันทึกแล้ว มีค่าตรงกับเอกสารต้นทาง และเรียกดูรหัสระเบียนได้ การคลิก Save เป็นเพียงเหตุการณ์ระหว่างทาง ขั้นตอนควรตรวจระเบียนหรือสถานะยืนยัน และแจ้งช่องที่ยังไม่ชัดเจนแทนการเติมด้วยการเดาที่ดูสมเหตุผล
ชุดทดลองควรมีทั้งเอกสารทั่วไปและตัวอย่างยากที่ตั้งใจสร้าง เช่น สกุลเงินไม่ชัด ขาดรหัสผู้ขาย หรือหมายเลขใบแจ้งหนี้ซ้ำกับที่มีอยู่ แต่ละกรณีเผยความผิดพลาดต่างกัน การอ่านข้อความถูก เลือกบัญชีถูก และหลีกเลี่ยงระเบียนซ้ำเป็นคนละส่วนของงาน
ทำการทดลองแรกให้เล็กพอที่จะตรวจทุกผลลัพธ์ หากผิดพลาด ให้หาการสังเกตหรือการกระทำแรกที่ผิด แทนการเขียนคำสั่งทั้งหมดใหม่พร้อมกัน การวิเคราะห์ที่เจาะจงช่วยแยกว่าเป็นปัญหาการอ่านเอกสาร การนำทาง ข้อมูลบัญชี หรือการตรวจรับ
กรณีนี้เป็นตัวอย่างออกแบบแอปพลิเคชัน ไม่ได้อ้างว่า Terra มีตัวเชื่อมระบบบัญชีมาให้ หรือบทความได้ทดสอบผลิตภัณฑ์บัญชีใด โมเดลเป็นเพียงส่วนหนึ่งของขั้นตอนที่ต้องจัดหาเครื่องมือและกฎธุรกิจเพิ่มเติม
การจับคู่แค็ตตาล็อกทดสอบการตัดสินภาพก่อนลงมือ
กรณีที่สองคือจับคู่ภาพสินค้ากับรายการเดิมในแค็ตตาล็อก model card ของ OpenAI ที่ตรวจสอบเมื่อวันที่ 27 ตุลาคมระบุการจับคู่ภาพสินค้าเป็นหนึ่งในการใช้งานที่ตั้งใจไว้ สำหรับร้านค้า ผลที่มีประโยชน์อาจเป็นข้อเสนอรายการที่ตรงกัน พร้อมข้อมูลพอให้ผู้ตรวจแยกความคล้ายทางภาพออกจากสินค้าที่ถูกต้องจริง
สร้างชุดประเมินเล็ก ๆ ที่มีกรณีง่าย บรรจุภัณฑ์คล้ายกัน และภาพที่ขาดรายละเอียด เก็บรหัสคำตอบที่ถูกแยกจากคำสั่งที่ให้โมเดล ขอรหัสที่เสนอและลักษณะที่มองเห็นซึ่งสนับสนุนการเลือก โดยเปิดทางให้ตอบว่ายังสรุปไม่ได้เมื่อภาพไม่พอ
ผลที่ยังสรุปไม่ได้อาจเป็นคำตอบที่ถูก หากสองบรรจุภัณฑ์ต่างกันเฉพาะข้อมูลที่มองไม่เห็น ขั้นตอนต้องขอภาพอื่นหรือรหัสที่ไม่อาศัยภาพ คำอธิบายบรรจุภัณฑ์ที่ลื่นไหลไม่อาจสร้างหลักฐานที่ไม่มีในอินพุต
เริ่มจากข้อเสนอการจับคู่ก่อนอนุญาตให้แก้แค็ตตาล็อก จะทำให้ตรวจเกณฑ์รับงานง่ายและได้ชุดข้อผิดพลาดที่ทีมเข้าใจ หากเพิ่มขั้นเขียนภายหลัง ให้ประเมินว่าร่างคำอธิบายรักษาข้อเท็จจริงที่ยืนยันแล้วหรือไม่ แทนการนำรายละเอียดที่ยังไม่ยืนยันมาจากความคล้ายทางภาพ
พอร์ทัลเก่าทำให้การกู้คืนเป็นส่วนของงาน
กรณีที่สามคือเตรียมร่างการแก้ไขในพอร์ทัลภายในที่มีหน้าจอเบราว์เซอร์ งานอาจเป็นค้นหาระเบียน เปลี่ยนคำอธิบายตามที่ให้ และทิ้งไว้ให้คนอนุมัติ ประโยชน์เกิดจากการเชื่อมคำขอทางธุรกิจที่เข้าใจได้เข้ากับลำดับการกระทำบนหน้าจอ
กรณียากมักเกี่ยวกับสถานะ เซสชันอาจหมดอายุ ช่องบังคับอาจปรากฏหลังการเลือกก่อนหน้า หรือหน้าอาจอัปเดตช้ากว่าคาด การประเมินที่มีประโยชน์บันทึกการตอบสนองต่อเงื่อนไขเหล่านี้ แทนการนับเพียงเส้นทางนำทางที่ง่ายที่สุด
กำหนดขอบเขตการกู้คืนก่อนทดลอง เช่น แอปอาจอนุญาตให้สังเกตเพิ่มหนึ่งครั้งเมื่อไม่แน่ใจว่าบันทึกแล้วหรือยัง จากนั้นหยุดให้ตรวจหากยังไม่ชัด นี่เป็นตัวอย่างนโยบาย ไม่ใช่ข้อจำกัดของ Terra ช่วยให้ทีมมีพฤติกรรมที่จำกัดขอบเขตและทดสอบได้ รวมถึงป้องกันวงรอบที่ไม่ก่อผลแต่กินทรัพยากร
แยกความล้มเหลวของการเชื่อมต่อจากความล้มเหลวของโมเดลด้วย เครื่องมือเข้าไม่ถึงหน้า บัญชีไม่มีสิทธิ์แก้ไข และโมเดลเลือกปุ่มผิดต้องแก้คนละแบบ การเก็บหมวดเหล่านี้ให้เห็นชัดช่วยทั้งการประเมินต้นทุนและการเพิ่มคุณภาพ
การเปิดให้ใช้บอกจุดเริ่มต้น ไม่ได้บอกว่าทุกบัญชีทำอะไรได้บ้าง
ประกาศวันที่ 26 ตุลาคมระบุ Terra ใน ChatGPT Work และ Codex สำหรับ Plus, Pro, Enterprise และ Edu รวมถึง API ID gpt-6.1-terra นี่คือช่องทางเข้าถึงโมเดล ส่วนเครื่องมือและสิทธิ์ในงานหนึ่งยังขึ้นกับผลิตภัณฑ์ บัญชี และการเชื่อมต่อที่ใช้
สำหรับนักพัฒนา model card ที่ตรวจสอบเมื่อวันที่ 27 ตุลาคมระบุ Responses API สำหรับเรียกเครื่องมือ และตั้ง reasoning effort เริ่มต้นเป็น medium ควรบันทึกโมเดลและค่าการให้เหตุผลในการประเมินเพื่อเปรียบเทียบสองครั้งได้อย่างมีความหมาย การเปลี่ยนโมเดล คำสั่ง และสภาพแวดล้อมพร้อมกันทำให้ตีความความต่างได้ยาก
ทีมที่ใช้ Work หรือ Codex ควรเริ่มจากงานที่รองรับอยู่แล้วและดูการควบคุมจริง ส่วนแอปที่สร้างเองควรใช้เอกสารการเชื่อมต่อปัจจุบันเพื่อกำหนดสภาพแวดล้อมและการกระทำที่อนุญาต รหัสโมเดลเพียงอย่างเดียวไม่ได้สร้างการเชื่อมต่อที่ยืนยันตัวตนแล้วกับแอปของบริษัท
เปรียบเทียบการตั้งค่าบนงานและเกณฑ์รับเดียวกัน
การทดลองแรกควรเล็กพอตรวจได้ แต่หลากหลายพอครอบคลุมเงื่อนไขที่จะพบจริง เลือกกฎรับงานก่อนเห็นผลที่สร้าง ขั้นตอนต่อไปนี้เป็นวิธีประเมินที่เสนอ ไม่ใช่ผลเบนช์มาร์ก
- เลือกงานที่มีขอบเขตหนึ่งงาน ระบุเอาต์พุตและผู้ตัดสินว่ายอมรับได้หรือไม่ ครั้งแรกควรเป็นร่างหรือการกระทำในสภาพแวดล้อมทดสอบ
- เตรียมชุดกรณีคงที่ รวมอินพุตปกติ ข้อมูลขาด และการขัดจังหวะหน้าจอที่เกี่ยวข้อง เก็บผลที่คาดไว้นอกคำสั่งของโมเดล
- บันทึกการตั้งค่า เก็บ model ID ค่าการให้เหตุผล คำสั่ง เวอร์ชันเครื่องมือ และสิทธิ์บัญชีที่เกี่ยวข้อง
- กำหนดกฎหยุดและกู้คืน ระบุเมื่อไรให้สังเกตเพิ่ม เมื่อไรการลองใหม่มีประโยชน์ และเมื่อไรคนต้องแก้ความไม่แน่นอน
- เก็บผลที่สังเกตได้ บันทึกผลที่รับได้ ผลผิด กรณียังไม่จบ จำนวนครั้ง เวลาที่ผ่านไป และการใช้งานที่คิดเงิน สถานะเครื่องมือเป็นเพียงส่วนหนึ่งของบันทึก
- เพิ่มต้นทุนดำเนินงานจริง รวมค่าเครื่องมือและสภาพแวดล้อมที่ใช้ รวมถึงเวลาตรวจที่วัดได้ แล้วหารด้วยงานที่รับได้ภายใต้นิยามเดียวกัน
- เปลี่ยนตัวแปรสำคัญทีละหนึ่ง เปรียบเทียบคำสั่งหรือค่าการให้เหตุผลใหม่บนกรณีเดิม ดูว่าความล้มเหลวใดเปลี่ยนไปก่อนขยายการทดลอง
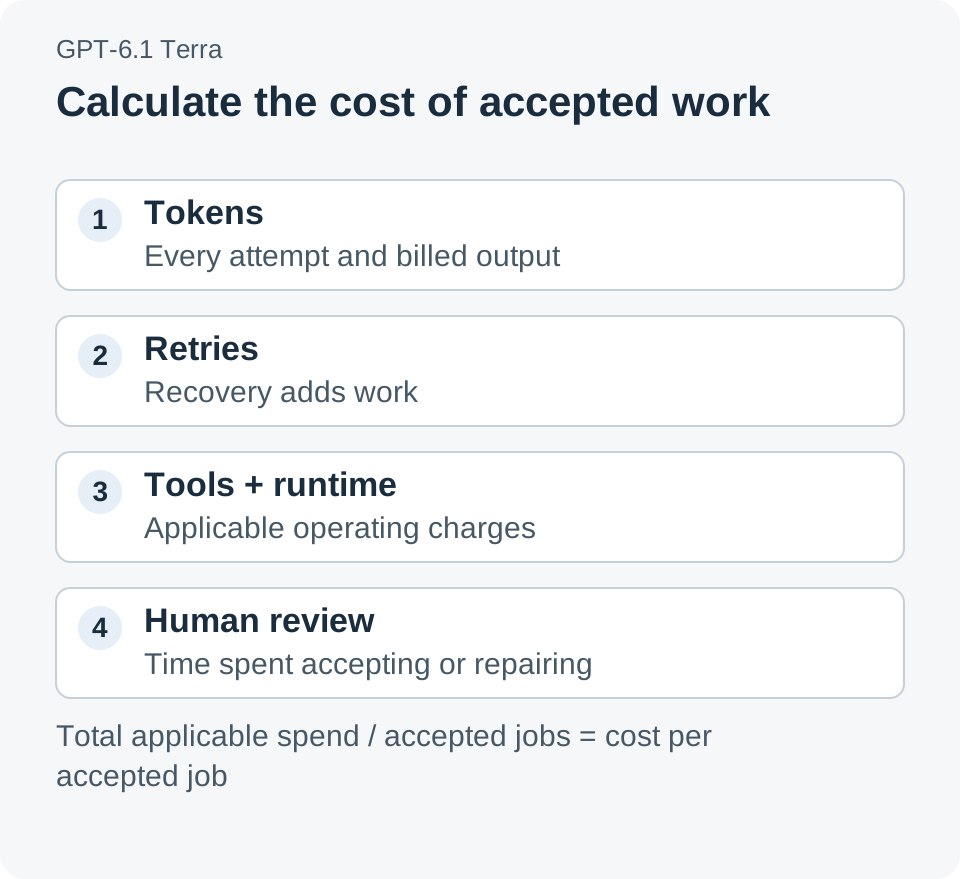
แบบจำลองต้นทุนที่เสนอ: รวมทรัพยากรที่งานใช้จริง แล้วหารด้วยจำนวนงานที่รับได้ องค์ประกอบเหล่านี้เป็นกรอบประเมิน ไม่ใช่ผลวัดการใช้งาน Terra ที่เผยแพร่
บันทึกนี้มีประโยชน์แม้ผลครั้งแรกจะน่าผิดหวัง เพราะชี้ว่าควรปรับการตีความภาพ การออกแบบงาน ความน่าเชื่อถือของเครื่องมือ หรือปริมาณการแก้ไขโดยคน จึงเป็นฐานตัดสินว่าจะทำอะไรอัตโนมัติต่อได้ดีกว่าดูต้นทุนเฉลี่ยต่อคำขออย่างเดียว
การใช้คอมพิวเตอร์ที่ถูกลงมีความหมายเมื่อทำให้งานเสร็จได้ในงบ
ราคาโทเคนมาตรฐานที่ต่ำลงของ Terra เปิดโอกาสให้ทดสอบละเอียดขึ้นและรองรับงานมากขึ้นในงบเดิม คำถามทางธุรกิจคือการเชื่อมต่อหนึ่งสามารถเปลี่ยนโอกาสนั้นเป็นผลที่รับได้ โดยใช้แรงตรวจและกู้คืนในระดับจัดการได้หรือไม่
โมเดลที่อ่านหน้าจอและเลือกคลิกได้มีประโยชน์ ส่วนขั้นตอนที่แสดงว่าอะไรเปลี่ยน รู้ว่าเมื่อไรเสร็จ และนับความพยายามที่ใช้ไปได้ คือสิ่งที่ทีมสามารถประเมินและปรับปรุงต่อได้
แหล่งข้อมูล
- Introducing GPT-6.1 Terra, OpenAI, 26 ตุลาคม 2026: จุดประสงค์ ราคามาตรฐานเปิดตัว และช่องทางเข้าถึง
- GPT-6.1 Terra system card, OpenAI, 26 ตุลาคม 2026: วันที่เผยแพร่และบริบทการประเมิน
- GPT-6.1 Terra model card, ตรวจ 27 ตุลาคม 2026: model ID จุดเรียกเครื่องมือ ค่าการให้เหตุผล และเงื่อนไขคิดเงิน
- เอกสารเชื่อมต่อการใช้คอมพิวเตอร์, ตรวจ 27 ตุลาคม 2026: กิจกรรมเบราว์เซอร์ ภาพหน้าจอ และกลไกการเชื่อมต่อ
ทั้งสามสถานการณ์ ตัวเลขต้นทุน และขั้นตอนประเมินเป็นตัวอย่าง การคำนวณดอลลาร์ใช้อัตรามาตรฐานที่ระบุและสมมติฐานที่เลือกไว้อย่างชัดเจน ไม่ใช่ผลวัดความหน่วง ความแม่นยำ หรือต้นทุนดำเนินงาน
คำแนะนำจาก Telli.sh: เก็บบันทึกทดลอง เอกสารอ้างอิง และเหตุผลที่แก้ขั้นตอนทำงานให้กลับมาดูได้ง่าย สร้างบัญชี Telli.sh เพื่อจัดระเบียบบันทึกการประเมินของคุณ