Bisakah notebook GPU dihentikan lalu eksperimennya dilanjutkan?
GKE Workspaces dari Google berjalan di klaster sendiri serta menggabungkan berkas persisten, sesi akselerator yang bisa dilanjutkan, dan IDE di browser. Tiap lapisan membawa biaya berbeda.
Sudah pukul enam sore. Notebook akhirnya memuat model dan menghasilkan keluaran yang layak ditelaah. Jika sesi dihentikan, besok Anda mungkin harus menyiapkan ulang lingkungan dan memuat kembali model. Jika terus dijalankan, akselerator yang langka bisa menganggur semalaman.
Google mengumumkan GKE Workspaces pada 4 November. Lingkungan pengembangan sumber terbuka ini berjalan di klaster Google Kubernetes Engine milik tim. Dasbor di browser dapat menjalankan JupyterLab atau VS Code dengan sumber daya yang sudah dikonfigurasi. Proyek ini dibangun di atas Kubeflow Workspaces dan mendokumentasikan cara menjeda dan melanjutkan sesi yang didukung. Tim perlu menentukan status apa yang dibutuhkan besok dan sumber daya apa yang harus tetap dialokasikan untuk menyimpannya.
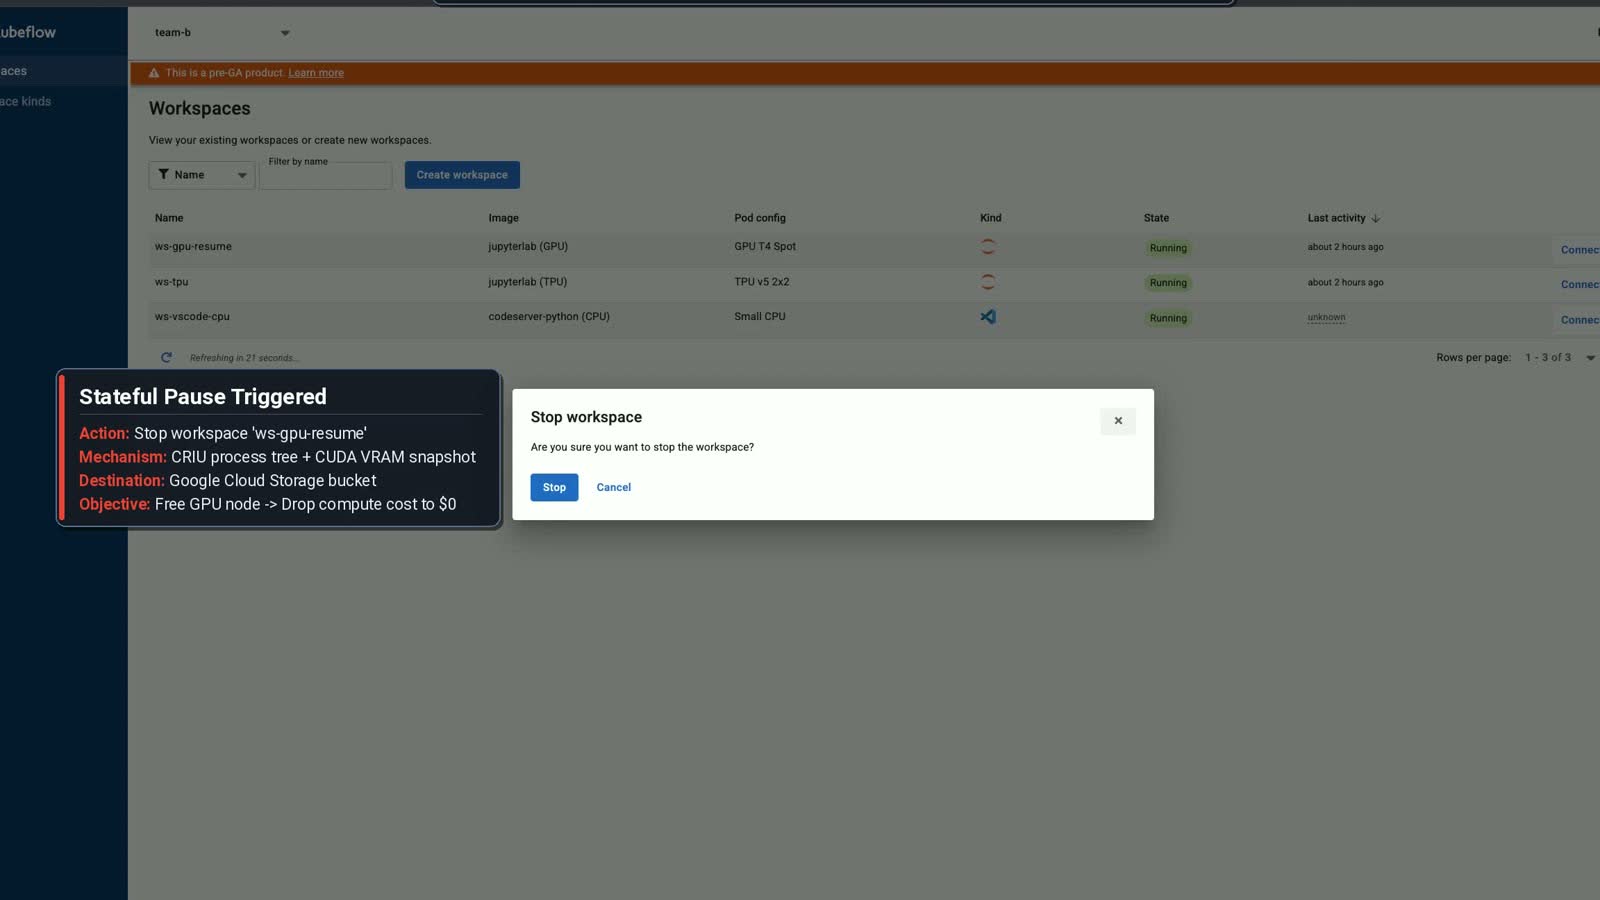
Cuplikan terpotong dari demo notebook GKE Workspaces yang bisa dilanjutkan, Apache 2.0. Sumber gambar · Lisensi.
Berkas notebook dan sesi aktif menyimpan hal yang berbeda
Menjeda notebook GPU. Ilustrasi asli Telli.sh.
Menyimpan notebook mempertahankan sel yang Anda tulis dan keluaran yang sudah disimpan. Disk dapat menyimpan himpunan data dan checkpoint agar dapat digunakan proses baru. Status sesi aktif tidak otomatis tersimpan seluruhnya. Eksperimen bisa mempunyai variabel yang sudah diinisialisasi, model di akselerator, dan status perantara yang membutuhkan waktu untuk dibuat ulang.
Google menjelaskan penggunaan GKE Pod Snapshots untuk menyimpan status workspace aktif yang didukung sambil melepaskan sumber daya komputasi. Berkas workspace tetap berada di penyimpanan persisten. Saat sesi dilanjutkan, kapasitas yang kompatibel dan snapshot harus tersedia. Dengan syarat praktis pada lingkungan yang mendasarinya, jeda memungkinkan eksperimen dilanjutkan lebih jauh daripada sekadar membuka ulang berkas tersimpan.
| Lapisan | Contoh | Pertanyaan perencanaan |
|---|---|---|
| Berkas persisten | Notebook, bobot dalam cache, hasil, dan dependensi | Apakah berkas ini tetap ada setelah proses baru dimulai? |
| Checkpoint aplikasi | Checkpoint pelatihan atau status eksekusi yang disimpan | Bisakah pekerjaan dilanjutkan tanpa proses lama? |
| Snapshot workspace | Proses aktif atau status akselerator yang didukung | Apakah perangkat keras dan lingkungan ini mendukung pemulihannya? |
| Kapasitas klaster | Node, kuota akselerator, atau reservasi | Apakah komputasi benar-benar dilepas dan tersedia lagi nanti? |
Reproduksibilitas dan kemudahan membantu bagian alur kerja yang berbeda. Snapshot membantu orang yang ingin segera melanjutkan sesi. Notebook yang dapat direproduksi dan checkpoint aplikasi memudahkan orang lain menjalankan ulang pekerjaan atau memindahkannya ke lingkungan berbeda. Simpan keduanya untuk eksperimen yang penting.
Tim riset bisa menjeda sesi GPU di antara rapat sambil tetap memasukkan kode ke repositori dan menyimpan artefak model di lokasi yang persisten. Jika snapshot gagal dipulihkan, tim punya jalur alternatif. Pekerjaan pelatihan jangka panjang juga dapat menyimpan checkpoint secara berkala meski workspace yang memulainya mendukung jeda.
Workspace yang dihentikan tetap memiliki biaya
Lacak tagihan sebenarnya. Ilustrasi asli Telli.sh.
Manfaat ekonomi langsungnya adalah menghindari penggunaan komputasi saat tidak ada yang bekerja. Tagihan sesungguhnya bergantung pada apa yang dilakukan klaster setelah sesi berhenti. Node bisa tetap berjalan karena digunakan pod lain. Reservasi masih bisa membawa biaya atau komitmen. Disk persisten dan snapshot yang disimpan tetap menjadi bagian sistem.
Mulailah dengan contoh hipotesis. Jika peneliti membiarkan akselerator yang tidak digunakan tetap dialokasikan selama 12 jam setelah bekerja, menjeda sesi memberi platform kesempatan untuk melepaskan 12 jam akselerator tersebut. Itu peluang untuk memulihkan kapasitas. Dampak finansial bergantung pada penyediaan dan penagihan node serta akselerator. Jika node tetap harus aktif untuk pekerjaan lain, dampaknya mungkin lebih terasa pada penjadwalan daripada pada tagihan saat itu.
Perbandingan yang adil juga memperhitungkan waktu. Menyimpan snapshot memerlukan sumber daya, memulihkan status berukuran besar butuh waktu, dan akselerator yang diinginkan mungkin tidak segera tersedia. Pada klaster yang sibuk, menyerahkan perangkat kepada orang lain bisa berarti meski tim telah berkomitmen pada satu kumpulan kapasitas.
Catat kapan pekerjaan aktif berakhir, kapan workspace berhenti, dan kapan node kembali tersedia. Lalu ukur kapan pengguna yang melanjutkan sesi bisa menjalankan sel berikutnya. Catatan ini menunjukkan apakah kebijakan jeda mengembalikan kapasitas yang berarti tanpa membuat orang mengantre di awal hari kerja berikutnya.
Tim platform tetap menentukan aturan workspace
Layanan mandiri mengubah siapa yang menekan tombol. Administrator tetap menentukan image yang boleh dijalankan, akselerator yang boleh diminta, dan cara klaster menangani kuota serta isolasi. Repositori GKE Workspaces menyebut proyek ini sebagai kode berlisensi Apache 2.0 dan menjelaskan statusnya sebagai proyek tanpa dukungan resmi Google. Masukkan pemasangan dan pengoperasian sebagai tanggung jawab tim teknik saat mengevaluasinya.
Insinyur ML mungkin memerlukan IDE yang familier, memori yang cukup, dan akses ke data eksperimen. Pemilik platform juga memikirkan identitas bawaan, izin penyimpanan, cara menghentikan beban kerja, dan image yang bisa menerima pembaruan. Kebutuhan ini bisa berjalan bersama jika jenis workspace memperlihatkan konsekuensi tiap pilihan. Notebook CPU kecil dan sesi eksperimen GPU dapat menggunakan setelan awal yang berbeda.
Rilis ini juga menjelaskan opsi akselerator dan koneksi untuk alat lokal atau agen. Periksa petunjuk konfigurasi untuk klaster dan skenario Anda sebelum menganggap opsi-opsinya dapat dipertukarkan. Pemulihan khusus perangkat keras, akses antarklaster, dan sambungan pengembangan lokal masing-masing memiliki prasyarat. Mulailah dari kasus sederhana ketika anggota tim dapat memeriksa workspace dan memastikan klaster mana yang menjalankannya.
Lakukan satu uji coba jeda dan pemulihan
- Baca panduan deployment proyek dan persyaratan terbaru lingkungan GKE Anda untuk snapshot dan akselerator. Siapkan workspace pengujian dengan izin serta batas sumber daya yang sesuai dengan alur kerja yang diusulkan.
- Jalankan notebook yang bisa direproduksi. Simpan masukan, checkpoint aplikasi perantara, dan berkas hasil berukuran kecil. Catat waktu dan alokasi sumber daya sebelum menjeda.
- Jeda workspace dan periksa keadaan sumber daya klaster. Periksa apakah pod sudah berhenti, akselerator dapat dijadwalkan kembali, dan penyimpanan apa yang tersisa.
- Lanjutkan workspace. Pastikan berkas dan status aktif sesuai harapan, lalu jalankan satu sel yang menggunakan model yang telah dimuat. Ukur waktu dari permintaan melanjutkan hingga notebook bisa digunakan.
- Coba pemulihan yang sama dari berkas dan checkpoint aplikasi yang telah disimpan. Ini memberi jalur alternatif sekaligus pembanding saat pemulihan snapshot lambat atau tidak tersedia.
- Tinjau setelan waktu menganggur bersama tim. Tentukan apa yang dihitung sebagai ketidakaktifan dan apakah pekerjaan jangka panjang perlu jenis workspace sendiri atau penanganan khusus.
Uji juga pemulihan dengan batas kuota atau pada klaster yang sibuk. Demo lancar pada klaster kosong bisa menyembunyikan kesulitan memperoleh kapasitas saat beberapa pengguna kembali sekaligus. Uji coba ini bertujuan mengetahui perilaku sistem saat sumber daya langka.
Hitung ke mana waktu GPU digunakan
Bayangkan satu workstation pengembang dipakai 40 jam dalam seminggu. Mesin yang tetap dialokasikan selama seminggu mencatat 168 jam. Jika platform bisa melepaskan node GPU setiap kali pekerjaan berhenti dan mengembalikannya hanya selama 40 jam tersebut, alokasi node berkurang 128 jam sebelum menghitung overhead snapshot dan pemulihan. Contoh ini tidak mengasumsikan harga cloud atau pola penggunaan tertentu. Angkanya menggambarkan batas atas pola alokasi tersebut karena node bersama bisa tetap menjalankan pekerjaan yang berguna pada periode yang sama.
Tim bisa membuat perbandingan lebih realistis memakai acuan dari kumpulan GPU sendiri. Untuk tiap interval pengujian, catat jam node, apakah pekerjaan lain memakai node, dan besarnya data workspace yang disimpan. Catat pula waktu dari permintaan melanjutkan hingga sel berikutnya dapat dijalankan. Jika node tetap tersedia karena beban kerja kedua masih aktif, menjeda notebook dapat membebaskan kapasitas bagi beban tersebut tanpa menurunkan tagihan. Itu hasil berbeda yang juga berguna.
Waktu pembuatan snapshot termasuk dalam perhitungan. Jika jeda berlangsung lama sementara pod lama tetap dialokasikan, ambang menganggur yang agresif bisa menyebabkan lebih banyak interupsi dengan sedikit penghematan komputasi. Jika pemulihan memerlukan beberapa menit saat autoscaler mencari GPU yang kompatibel, pengembang yang kembali dari istirahat singkat bisa menunggu lebih lama daripada waktu yang dihemat kebijakan. Ukur beberapa durasi menganggur untuk menentukan kapan jeda sepadan.
Pilih status yang perlu disimpan sebelum mengaktifkan jeda
Repositori GKE Workspaces menjelaskan alur VS Code stateless dan contoh JupyterLab stateful yang terpisah. Contoh kedua mendemonstrasikan pemulihan notebook berbasis GPU, termasuk contoh model Qwen2.5 3B pada satu T4. Snapshot pod Kubernetes dan contohnya memiliki batas kompatibilitas tertentu. Dokumentasi GKE Google menjelaskan peran GKE Sandbox serta konfigurasi node dan image yang kompatibel. Untuk contoh GPU, pastikan node baru memiliki model GPU didukung yang sama dan lingkungan yang kompatibel sebelum mengandalkan pemulihan.
Tentukan apa yang diharapkan pengguna saat melihat tombol jeda. Sebagian berharap berkas, keluaran, dan status editor tetap ada. Yang lain berharap sel Python berikutnya menemukan objek yang masih ada di RAM atau model yang berada di VRAM. Himpunan data bersama bisa berada di penyimpanan objek eksternal dan di luar snapshot. Catat status mana yang dapat dipulihkan workspace pilihan Anda, di mana berkas biasa disimpan secara persisten, dan apa yang dilakukan jika pemulihan gagal.
Uji lain yang berguna adalah kegagalan sebelum sesi dilanjutkan. Di namespace pengujian, buat kapasitas kompatibel sementara tidak tersedia dan pastikan workspace melaporkan status yang jelas, alih-alih membuat beberapa pemulihan yang bersaing. Periksa apakah pemilik bisa pulih dari berkas atau keluaran yang disimpan ketika proses dalam memori tidak dapat dilanjutkan. Lalu hapus snapshot pengujian dan pastikan aturan penyimpanan dan retensinya bekerja sesuai harapan.
Bahas biaya bersama tim
Peneliti ingin pekerjaannya bisa dilanjutkan. Tim platform ingin kapasitas GPU yang langka kembali ke kumpulan bersama. Penanggung jawab penagihan ingin tahu apakah suatu alokasi benar-benar berakhir. Satu sampel dapat menjawab ketiganya jika uji coba mencatat waktu menganggur, penempatan node, ukuran snapshot, pemulihan yang berhasil, dan waktu pemulihan secara terpisah. Tambahkan catatan bantuan untuk kasus gagal dan cara bagi pengguna untuk mengetahui apakah workspace dijeda, menunggu kapasitas, atau siap.
Gunakan acuan itu untuk memilih kebijakan menganggur menurut kelas beban kerja. Sesi notebook panjang dengan model yang lama dimuat mungkin memperoleh manfaat dari penyimpanan status memori antarshift. Eksperimen singkat yang dimulai dari skrip tersimpan mungkin cukup dengan berkas persisten dan proses baru. Keduanya dapat berbagi kumpulan sumber daya tanpa menjanjikan waktu pemulihan yang sama.
Masukkan uji melanjutkan sesi ke daftar periksa rilis
Peningkatan platform dapat mengganti image yang memulai workspace atau kumpulan node penyedia kapasitas GPU. Sebelum menerapkannya untuk tim, buat notebook pengujian pada konfigurasi lama dan periksa apa yang terjadi pada konfigurasi baru. Uji harus membedakan pemulihan yang berhasil dari sesi baru yang membuka berkas notebook yang sama. Baca nilai yang hanya ada dalam proses pengujian aktif, lalu pastikan berkas yang digunakan proses itu masih tersedia.
Jika peningkatan membuat snapshot lama tidak berlaku, beri pengguna kesempatan menyimpan hasil penting dan jelaskan jalur alternatif. Uji pembersihan snapshot yang kedaluwarsa secara terpisah. Uji pemulihan membuktikan workspace tertentu bisa kembali. Uji pembersihan memperlihatkan berapa banyak status lama yang tersisa setelah orang berhenti menggunakannya.
Pertahankan pekerjaan yang paling sulit dibuat ulang
Workspace lebih berguna jika pengguna tidak lagi perlu memikirkan daur hidup mesin dan tetap dapat memulihkan pekerjaan. Ini bergantung pada pemisahan berkas, checkpoint, snapshot, dan kapasitas. Pilih sekumpulan status minimum agar pekerjaan mudah dilanjutkan dan pastikan proyek masih bisa direproduksi tanpa sesi semula.
Jika tim dapat menjawab apa yang tetap di disk, apa yang harus dipulihkan, dan kapan komputasi dikembalikan, tim bisa menetapkan kebijakan menganggur yang benar-benar akan dipakai orang.
Sumber
-
Pengumuman Google Open Source Blog pada 4 November dan rekaman layar workspace
-
Kode sumber GKE Workspaces, status dukungan, dan dokumentasi pemasangan
Untuk menyimpan catatan percakapan dan keputusan di balik pekerjaan Anda yang dapat ditelusuri, Buat akun Telli.sh.