Google memajukan terjemahan langsung, OpenAI membuka API suara dupleks penuh: apa yang kekal selepas perbualan?
GPT-Live-1 kini tersedia dalam API pada harga $0.05 seminit suara, tiga bulan selepas terjemahan pertuturan langsung 70 bahasa oleh Google. Apa yang diukur oleh harga dan penanda aras yang diterbitkan, apa yang tidak, dan mengapa minit mesyuarat, idea bersama serta sumber yang disimpan semakin penting apabila berbual menjadi lebih mudah.
Ilustrasi konsep asal. Perbualan yang lebih semula jadi dan rekod berguna perbualan itu ialah matlamat reka bentuk pelengkap, bukan peringkat terukur keluaran produk.
Perkara paling menggembirakan tentang pengumuman AI suara terkini ialah kemungkinan yang dekat dengan kehidupan harian: menyampaikan fikiran hingga selesai dalam bahasa sendiri, menjelaskannya semasa bercakap, dan terus mengambil bahagian dengan selesa. Kurang masa menunggu terjemahan, kurang perlu berlatih ayat dalam fikiran sebelum bersuara. Lebih banyak perhatian boleh diberikan kepada maksud sebenar orang lain.
Google memperkenalkan Gemini 3.5 Live Translate pada 9 Jun 2026. OpenAI memperkenalkan model GPT-Live dupleks penuhnya dalam ChatGPT pada 8 Julai, kemudian mengeluarkan GPT-Live-1 dalam API pada 10 September. Kedua-duanya produk berbeza dengan tujuan yang berbeza, tetapi turutan ini menunjukkan arah ke interaksi lisan yang lebih berterusan. Pengumuman OpenAI terkini memperluaskan akses untuk pembangun; ia bukan penampilan pertama GPT-Live. Pengumuman Jun Google, Pengenalan Julai OpenAI, Keluaran API September OpenAI.
Pada pandangan saya, kemajuan ini mendekatkan dunia yang kurang dibatasi halangan bahasa dalam kehidupan seharian. Namun, satu lagi soalan menjadi semakin penting: apabila berbual lebih mudah, bagaimana kita mengekalkan nilai daripada perbualan itu? Minit mesyuarat, perkongsian idea dan sumber yang disimpan ialah sebahagian daripada jawapannya.
Suara dupleks penuh mengubah cara menunggu dalam perbualan
Dupleks penuh bermaksud sistem boleh mendengar dan bercakap pada masa yang sama. OpenAI menerangkan GPT-Live-1 dengan cara ini dalam dokumentasi model semasanya, di samping keupayaan untuk mewakilkan penaakulan dan penggunaan alat kepada ejen bahagian belakang. Itu adalah kenyataan tentang interaksi serentak, bukan sijil terjemahan yang sempurna. Dokumentasi model GPT-Live-1, disemak pada 11 September 2026.
Bayangkan membetulkan pembantu semasa ia menerangkan rancangan: "Sebenarnya, pelanggan berada di Madrid, bukan Mexico City." Antara muka pertuturan yang berguna perlu melihat pembetulan itu sebelum meneruskan dengan andaian yang salah. Ia juga perlu membezakan pembetulan daripada pengakuan ringkas, atau jeda untuk berfikir daripada jemputan untuk mengambil alih. Kualiti pertukaran bergantung pada pertimbangan kecil tersebut.
Antara muka suara yang lebih lama sering menjadikan struktur gilirannya mudah dilihat. Anda bercakap, menunggu untuk memproses, mendengar, dan kemudian mencuba lagi. Pemprosesan yang lebih pantas membantu, tetapi interaksi masih boleh berasa janggal apabila sistem meneka bahawa anda selesai terlalu awal. Reka bentuk dupleks penuh menangani pertindihan itu sendiri, dan bukannya menganggap setiap saat pertuturan sebagai mesej tertutup dengan kemas.
Sudah ada isyarat konkrit, jika terhad, mengapa itu penting. OpenAI melaporkan bahawa syarikat pembelajaran bahasa Speak mengalami hampir 80% kurang gangguan semasa pemikiran pelajar berhenti seketika dalam penilaian awal terhadap sistem berasaskan giliran sebelumnya. Itu adalah hasil rakan kongsi yang dilaporkan oleh vendor, bukan penemuan bebas untuk setiap bahasa atau tetapan. Ia mengukur tingkah laku gangguan, bukan peningkatan 80% dalam ketepatan terjemahan. Laporan pelancaran API OpenAI, 10 September 2026.
Angka OpenAI yang lebih luas menunjukkan arah yang sama, dengan batasan yang sama juga. OpenAI melaporkan bahawa GPT-Live-1 mencatat skor 30 mata peratusan lebih tinggi daripada GPT-Realtime-2.1 dalam Full Duplex Bench, ujian tentang jeda, giliran bercakap, gangguan dan respons ringkas seperti “hmm” atau “ya” semasa mendengar. Apabila digandingkan dengan GPT-6 Astra pada tahap penaakulan sederhana, ia menduduki tempat pertama dalam Tau3, yang menilai tugasan khidmat pelanggan dan perbankan secara lisan menggunakan Pass@1, termasuk 97 tugasan pengetahuan perbankan. Kedua-duanya ialah penilaian OpenAI sendiri terhadap tingkah laku perbualan dan penyiapan tugasan; kedua-duanya bukan skor ketepatan terjemahan. Ringkasan penilaian OpenAI, 10 September 2026.
Bagi seseorang yang bercakap bahasa kedua, jeda berfikir mungkin tepat di mana penyertaan menjadi sukar. Pembantu yang menunggu dengan sewajarnya meninggalkan ruang untuk mencari perkataan. Pembantu yang menerima pembetulan menjadikannya lebih murah untuk mencuba. Itulah sebab praktikal untuk teruja dengan interaksi suara semula jadi melebihi betapa mengagumkan bunyi demonstrasi.
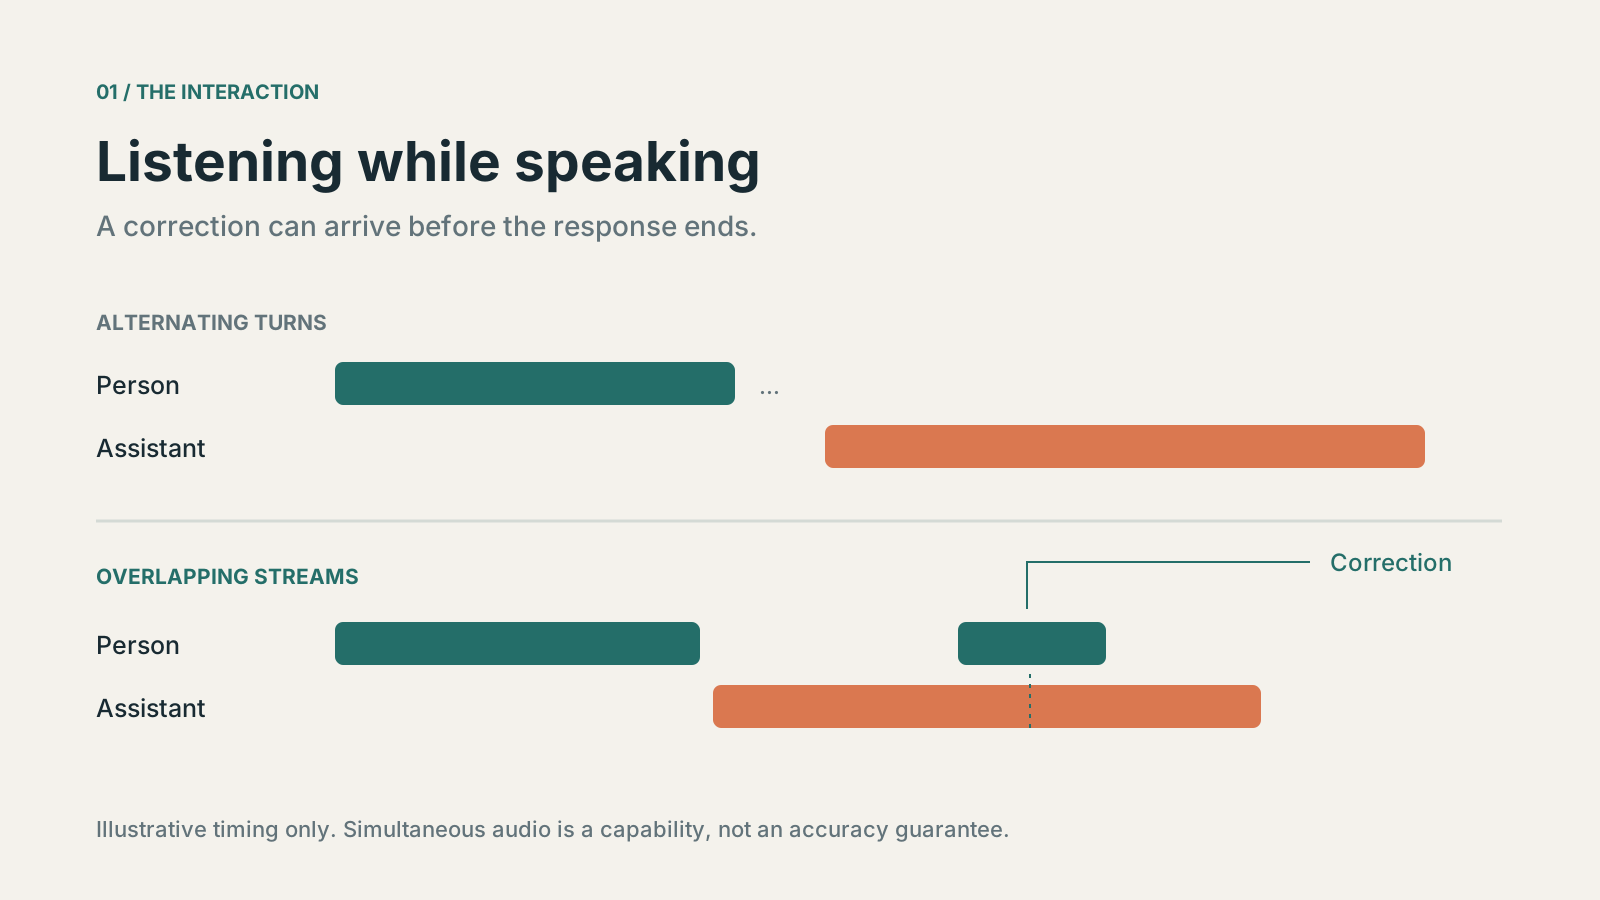
Masa konseptual sahaja; bar tidak mewakili kependaman yang diukur. Dupleks penuh menerangkan input dan output serentak, manakala pengendalian gangguan yang berguna masih bergantung pada model dan aplikasi.
Terjemahan langsung dan pembantu perbualan mempunyai tugas berbeza
Pengumuman Jun Google menerangkan terjemahan pertuturan berterusan merentas lebih daripada 70 bahasa. Model ini menghasilkan pertuturan yang diterjemahkan sambil mendengar, mengimbangi keperluan untuk lebih konteks berbanding kekal dekat dengan pembesar suara. Google mengatakan ia tinggal beberapa saat di belakang, yang merupakan jangkaan yang lebih berguna daripada membayangkan kelewatan sifar. Keluaran pembangun ialah pratonton awam. Huraian pelancaran Google, 9 Jun 2026.
Angka skala dalam pengumuman itu cukup terperinci. Terjemahan pertuturan dalam Google Meet akan berkembang daripada 5 bahasa yang disokong kepada lebih daripada 70, dan daripada hanya menterjemah ke dan dari bahasa Inggeris kepada lebih daripada 2,000 gabungan bahasa dalam satu mesyuarat. Ia bermula sebagai pratonton peribadi untuk pelanggan Workspace perniagaan terpilih, dengan pelancaran yang lebih meluas kemudian pada 2026. Grab sedang menguji model ini untuk urusan menjemput penumpang antara pemandu dan pengembara, kes penggunaan yang melibatkan lebih daripada 10 juta panggilan suara sebulan. Pengumuman itu memetik pujian rakan kongsi tentang kualiti, ketepatan dan kependaman rendah tanpa menerbitkan skor berangka. Angka pelancaran Google, 9 Jun 2026.
Terdapat perbezaan yang patut dikekalkan. Panduan Terjemahan Langsung Google menerangkan penterjemah yang memproses strim audio secara berterusan, dengan tetapan khusus terjemahan dan tiada sokongan untuk alatan atau arahan am. GPT-Live-1 ialah model perbualan yang boleh berfungsi dengan ejen yang berasingan. Seseorang membantu membawa maksud penutur ke dalam bahasa lain; yang lain mengambil bahagian dalam pertukaran. Mereka tidak sepatutnya dipersembahkan sebagai perkhidmatan yang boleh ditukar ganti. Panduan Terjemahan Langsung Google, dokumentasi model OpenAI, disemak pada 11 September 2026.
| Pencapaian | Apa yang diumumkan | Perkara yang tidak ditetapkan |
|---|---|---|
| Google, 9 Jun 2026 | Gemini 3.5 Live Translate; terjemahan ucapan berterusan; pratonton awam pembangun | Kualiti yang sama untuk setiap pasangan bahasa atau akses segera dalam setiap produk Google |
| OpenAI, 8 Julai 2026 | Pelancaran GPT-Live dalam ChatGPT, dengan pendengaran dan pertuturan serentak | Ketepatan peringkat jurubahasa sejagat |
| OpenAI, 10 September 2026 | Akses API GPT-Live-1 untuk membina aplikasi suara | Penyepaduan automatik ke dalam setiap mesyuarat atau perkhidmatan mengambil nota |
Skop keluaran datang daripada tiga pengumuman yang dipautkan di atas. Ini adalah garis masa, bukan kedudukan prestasi.
Jika digabungkan, perkembangan ini menunjukkan arah yang menarik: terjemahan boleh menjadi lebih berterusan dan interaksi dengan pembantu boleh menjadi kurang tegar. Menyambungkan keupayaan tersebut ke dalam pengalaman mesyuarat berbilang bahasa yang boleh dipercayai kekal sebagai kerja aplikasi. Seseorang masih perlu memutuskan audio siapa yang ditafsirkan, ke mana hasilnya, cara pembetulan dikendalikan dan perkara yang dilihat oleh peserta.
Angka yang diterbitkan: $0.05 seminit, tanpa skor ketepatan
Seminit suara GPT-Live-1 dalam API berharga $0.05, dicaj mengikut saat tanpa dibundarkan ke atas kepada seminit penuh. Harga itu hanya meliputi lapisan suara hadapan; model bahagian belakang dan alatan yang diwakilkan oleh sesi dicaj secara berasingan pada kadar biasa. Dokumentasi model OpenAI, disemak pada 11 September 2026.
Kiraannya mudah, tetapi juga mudah disalah tafsir. Sesi 30 minit berharga $1.50 untuk masa lapisan suara, sejam $3.00, dan 100 jam sebulan berjumlah $300 sebelum sebarang penaakulan bahagian belakang. Aplikasi yang memberikan sesi berasingan kepada setiap peserta mesyuarat akan menggandakan angka tersebut mengikut bilangan sesi. Pengumuman Jun Google tidak menyenaraikan harga untuk Gemini 3.5 Live Translate, jadi artikel ini tidak membandingkan kedua-duanya dari segi kos.
| Angka | Nilai | Sumber dan tarikh | Apa yang diukur |
|---|---|---|---|
| Harga API GPT-Live-1 | $0.05 seminit, dicaj mengikut saat | OpenAI, 10 September 2026 | Lapisan suara sahaja; model bahagian belakang dan alatan dicaj berasingan |
| Full Duplex Bench | +30 mata peratusan berbanding GPT-Realtime-2.1 | OpenAI, 10 September 2026 | Jeda, giliran bercakap dan gangguan, bukan terjemahan |
| Tau3 | Tempat pertama, bersama GPT-6 Astra (sederhana) | OpenAI, 10 September 2026 | Kejayaan tugasan lisan (Pass@1), termasuk 97 tugasan perbankan |
| Penilaian awal Speak | Hampir 80% kurang gangguan semasa jeda berfikir | OpenAI (petikan rakan kongsi), 10 September 2026 | Tingkah laku gangguan berbanding sistem berasaskan giliran terdahulu |
| Penggunaan suara ChatGPT | Lebih daripada 150 juta orang seminggu | OpenAI, 8 Julai 2026 | Penggunaan Voice dan Dictation, bukan kualiti |
| Gemini 3.5 Live Translate | 70+ bahasa, dikesan secara automatik | Google, 9 Jun 2026 | Liputan, bukan kualiti setiap pasangan bahasa |
| Terjemahan pertuturan Google Meet | 5 → 70+ bahasa; 2,000+ gabungan setiap mesyuarat | Google, 9 Jun 2026 | Naik taraf yang dirancang, bermula dengan pratonton peribadi |
| Kelewatan terjemahan | “Hanya beberapa saat di belakang penutur” | Google, 9 Jun 2026 | Huraian vendor, bukan angka yang diukur |
Setiap angka dilaporkan oleh vendor dan diambil daripada pengumuman serta dokumentasi yang dipautkan dalam artikel ini. Tiada satu pun merupakan skor ketepatan terjemahan berangka, seperti penilaian manusia atau metrik automatik untuk sesuatu pasangan bahasa.
Jurang itu paling penting bagi sesiapa yang sedang memilih alat untuk mesyuarat berbilang bahasa. Penanda aras interaksi memberitahu sama ada sistem tahu menunggu, mendengar dan pulih dengan baik; ia tidak memberitahu sama ada perkataan “Isnin” masih betul selepas diterjemahkan ke bahasa Korea. Kaveat OpenAI pada Julai tentang loghat bukan penutur asli dalam sesetengah bahasa dan ketiadaan skor setiap pasangan bahasa daripada Google membawa kepada peraturan praktikal yang sama: uji pasangan bahasa yang benar-benar digunakan oleh pasukan anda sebelum bergantung pada mana-mana satu untuk membuat keputusan.
Mengurangkan halangan bahasa bermula dengan keberanian bersuara
Pertimbangkan mesyuarat projek selama 30 minit hipotesis dengan empat orang yang paling selesa dalam tiga bahasa berbeza. Faedah terjemahan pertuturan yang lebih baik bukan semata-mata kerana setiap orang mendengar lebih banyak perkataan. Kumpulan itu boleh bertanya soalan susulan sebelum ketidakpastian menjadi salah faham. Idea tentatif boleh dinyatakan tanpa terlebih dahulu digilap menjadi bahasa kedua.
Itu mengubah ekonomi penyertaan dalam erti kata yang sangat biasa: menyumbang memerlukan sedikit usaha. Orang yang pendiam dengan pengalaman yang relevan mempunyai cara lain dalam perbincangan. Orang yang mengetuai mesyuarat boleh menghabiskan lebih sedikit masa untuk membina semula ayat yang terganggu. Penjelasan boleh berlaku apabila ia berguna, sementara semua orang masih ingat perkara yang dibincangkan.
Saya menjangkakan perkara itu penting dalam pasukan jauh, perbincangan bilik darjah, perbualan pelanggan dan pertukaran tidak formal semasa dalam perjalanan. Ini adalah jangkaan tentang tempat teknologi boleh membantu, bukan mendakwa bahawa pengalaman yang sama sudah tersedia untuk semua orang. Pasangan bahasa, loghat, perbendaharaan kata, kualiti mikrofon dan produk di sekeliling semuanya kekal sebagai sebahagian daripada hasilnya.
Suara yang kedengaran semula jadi perlu dinilai berasingan daripada ketepatan maknanya. Dalam pengumuman Julai, OpenAI menyatakan bahawa sesetengah bahasa mungkin mempunyai loghat bukan penutur asli atau batasan kelancaran. Maka, bahasa yang benar-benar digunakan perlu diuji, bukannya membuat kesimpulan umum daripada demonstrasi bahasa Inggeris yang lancar. Itu ialah catatan ketika pelancaran, bukan penilaian terkini untuk semua pelaksanaan pada September. OpenAI pengenalan GPT-Live dan kaveat bahasa, 8 Julai 2026
Cita-cita yang betul ialah penyertaan yang lebih luas dengan cara yang mudah untuk menjelaskan. Tarikh, amaun, nama seseorang atau janji bersyarat hendaklah mudah disemak. Sistem boleh berbunyi yakin manakala peserta masih perlu berkata, "Sila tunjukkan ayat itu kepada saya." Menunjukkan teks dan mengekalkan teks asal, di mana peserta telah bersetuju untuk merakam, memberikan permintaan itu ke suatu tempat untuk pergi.
Mesyuarat yang lancar masih memerlukan rekod keputusan
Kembali kepada mesyuarat andaian tadi. Seseorang mencadangkan pelancaran pada Jumaat jika semakan keselamatan selesai. Orang lain memilih Isnin supaya pasukan sokongan mempunyai lebih masa untuk bersedia. Kumpulan bersetuju dengan Isnin dan menetapkan orang yang bertanggungjawab, tetapi satu prasyarat masih belum diselesaikan. Ringkasan yang hanya menyimpan Jumaat sebagai cadangan awal terlepas keputusan sebenar mesyuarat.
Tiada peningkatan dalam irama perbualan yang menghilangkan perbezaan antara cadangan, syarat dan keputusan. Orang yang bekerja dalam bahasa yang sama sudah perlu membezakan mereka. Interaksi berbilang bahasa menjadikannya lebih berharga untuk mengekalkan laluan daripada pernyataan asal kepada perkataan yang diterjemahkan dan tindakan akhir yang dipersetujui.
Untuk rekod mesyuarat praktikal, saya ingin pembaca yang terlepas panggilan untuk mencari tiga perkara dengan cepat: perkara yang diputuskan oleh kumpulan, siapa yang bertanggungjawab untuk langkah seterusnya dan soalan yang masih terbuka. Tarikh akhir hendaklah digambarkan sebagai dipersetujui hanya apabila ia dipersetujui. Jika sumbernya tidak jelas, rekod itu harus membawa ketidakpastian itu ke hadapan dan bukannya mengemasnya menjadi kesimpulan palsu.
Ini tidak memerlukan mengubah setiap perbualan menjadi arkib yang lengkap. Nota keputusan ringkas boleh menjadi lebih berguna daripada halaman transkrip yang tidak dibezakan. Hubungan penting adalah antara akaun ringkas dan bahan sokongan: perkataan asal yang berkaitan, rakaman apabila tersedia dan dibenarkan, dan dokumen yang sedang dibincangkan oleh kumpulan itu.
Hubungan itu juga memudahkan pembetulan. Peserta boleh menunjukkan ayat asal, membetulkan ringkasan dan berkongsi keputusan yang telah diperbetulkan. Tanpanya, orang seterusnya mungkin meringkaskan ringkasan lagi sehingga salah faham awal dianggap sebagai fakta yang pasti. Interaksi suara yang lebih baik memudahkan perbualan; rekod yang baik membolehkan hasilnya disemak kemudian.
Idea yang dikongsi perlu disertakan sumbernya
Idea berguna jarang bermula dan berakhir dalam satu panggilan. Seseorang mencari artikel, menyimpan petikan, bertanya soalan mengenainya dan membawa soalan itu ke mesyuarat. Orang lain menambah contoh balas daripada video atau kertas penyelidikan. Langkah seterusnya bergantung pada keupayaan untuk menyambung semula bahagian tersebut selepas perbualan tamat.
Sebab itulah menyimpan sumber web masih berguna walaupun AI suara sangat baik. URL membolehkan kita kembali kepada sumber asal, petikan terpilih menunjukkan bahagian penting, dan nota peribadi menerangkan sebab ia disimpan. Setiap unsur mempunyai peranan berbeza. Apabila disimpan bersama, unsur ini menyampaikan idea dengan lebih lengkap berbanding satu perenggan AI yang dikongsi tanpa konteks.
“Kita patut mengubah pengalaman awal pengguna baharu” belum memberi konteks yang cukup kepada orang yang menyambung kerja. “Artikel ini membuat kita menilai semula lima minit pertama; inilah petikan, perbincangan dan eksperimen yang dipersetujui” memberikan bahan untuk diteliti. Contoh ini andaian, tetapi bezanya nyata: kesimpulan sahaja meminta kepercayaan; alasan dan sumber membolehkan perbincangan diteruskan.
Disiplin yang sama melindungi sumber daripada dikaburkan menjadi ulasan. Sebut harga hendaklah kekal dikenal pasti sebagai sebut harga. Terjemahan ialah tafsiran sumber itu, dan ringkasan mesyuarat ialah pandangan terbitan lain. Memastikan peranan tersebut kelihatan membolehkan orang ramai tidak bersetuju secara produktif tanpa perlu membina semula apa yang orang pada asalnya berkata.
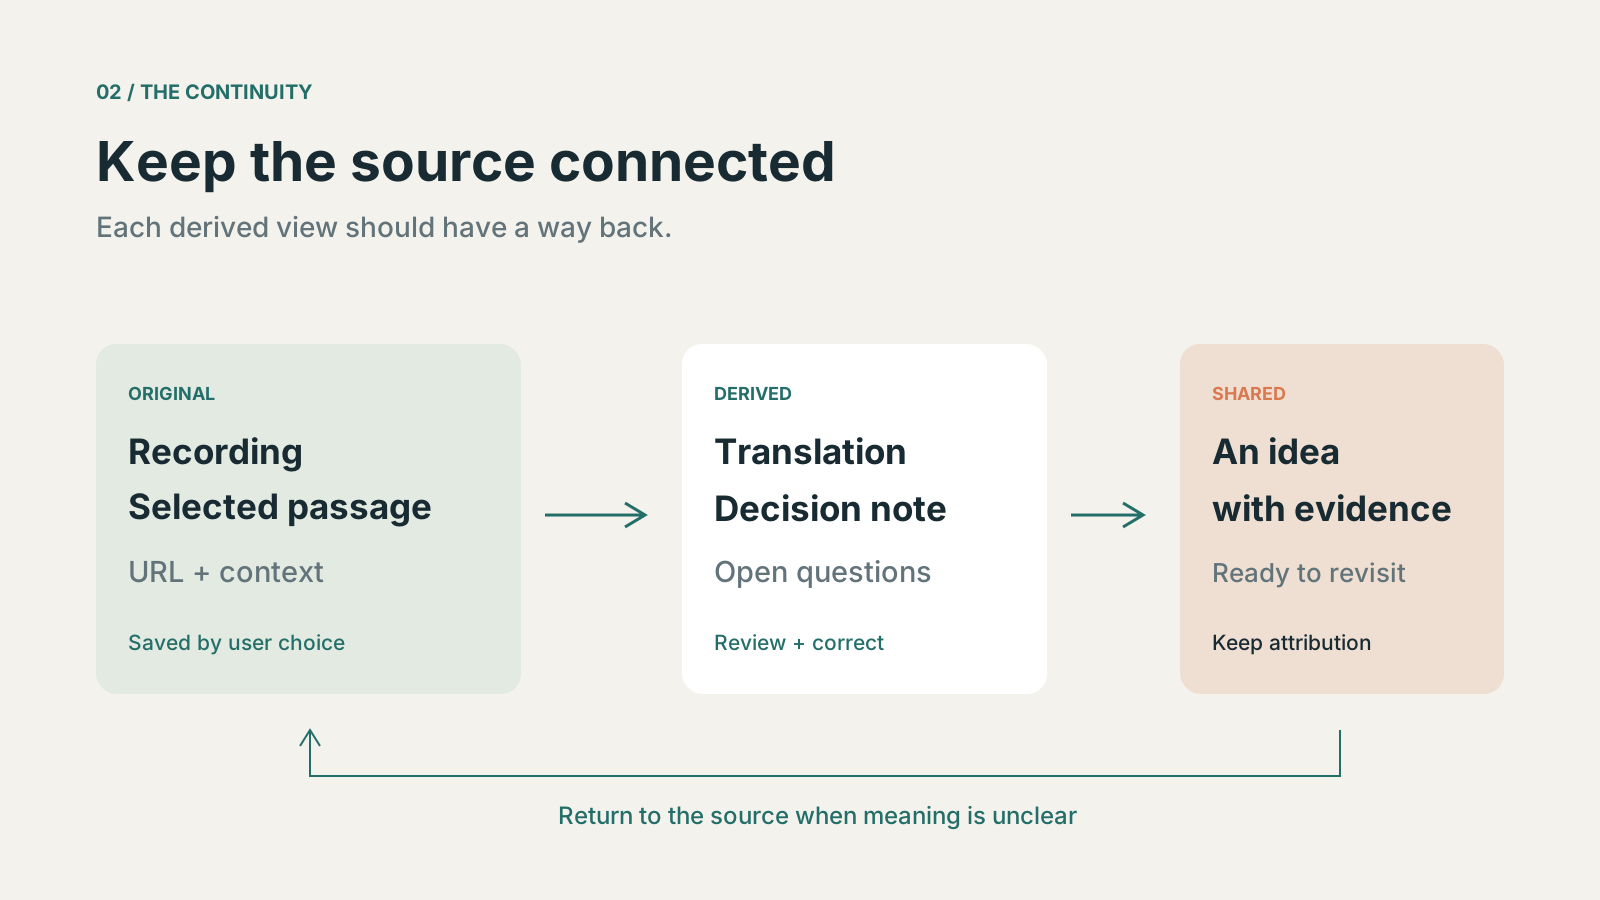
Aliran kerja asal yang dicadangkan. Kekalkan bahan sumber yang dibenarkan, jadikan teks terbitan boleh dibetulkan dan pastikan sambungan kelihatan apabila berkongsi. Gambar rajah tidak mendakwa bahawa setiap pautan adalah ciri automatik hari ini.
Konteks perlu kekal selepas panggilan tamat
Sistem suara juga mula memisahkan perbualan daripada kerja yang berlaku di belakangnya. Dokumentasi perwakilan OpenAI menerangkan bahawa ucapan langsung dan kerja yang diwakilkan boleh diteruskan secara bebas; respons bahagian belakang yang lengkap tidak membuktikan bahawa pengguna mendengar jawapannya. Ini ialah peringatan kejuruteraan yang berguna tentang masalah produk yang lebih luas: pengalaman lisan dan hasil yang tahan lama adalah perkara yang berasingan untuk disahkan. Dokumentasi perwakilan OpenAI, disemak pada 11 September 2026.
Untuk pengguna harian, soalannya lebih mudah. Apabila panggilan ditamatkan, bolehkah saya mencari keputusan esok? Bolehkah rakan sekerja memahami mengapa kami berjaya? Bolehkah saya kembali ke artikel yang mencabar andaian kami, tanpa mencari merentasi sejarah sembang, penyemak imbas dan rakaman? Soalan-soalan itu kekal walaupun setiap ayat ditafsirkan dengan indah.
Terdapat sebab untuk optimis tentang halangan bahasa menjadi kurang dominan. Kita harus mengalu-alukan alat yang membolehkan lebih ramai orang menyumbang dengan selesa. Jangkaan saya ialah perbualan yang lebih mudah akan meningkatkan nilai menghubungkan apa yang kita katakan dengan perkara yang kita simpan, kongsi dan akhirnya lakukan. Pertemuan itu tidak semestinya hidup selama-lamanya; hasil yang berguna harus bertahan dalam panggilan.
Hala tuju yang kami inginkan untuk Telli.sh
Bagi Telli.sh, hala tujunya ialah membantu mengubah perbualan dan penemuan menjadi pengetahuan yang boleh dicari semula. Kini produk menghimpunkan nota, rakaman, terjemahan dan Clip dalam satu ruang kerja. Seterusnya, kami mahu mengukuhkan hubungan antara bahan ini agar minit mesyuarat, idea dan sumbernya tidak kembali terpisah.
Kami mahukan aliran kerja yang berterusan: merakam perbualan dengan kebenaran yang diperlukan, menyemak perkara penting, menjelaskan keputusan dan berkongsi idea bersama bahan sokongan. Jika perbincangan bermula daripada laman web, Clip patut membantu menyimpan URL dan konteks pilihan pengguna. Jika terjemahan membantu pemahaman, sumber asal perlu kekal tersedia untuk perbandingan dan pembetulan.
Ini ialah hala tuju produk, bukan pengumuman bahawa Telli.sh sudah menyepadukan GPT-Live-1 atau Gemini 3.5 Live Translate. Fungsi suara masa hadapan perlu membuktikan manfaat merentas bahasa, menyediakan rekod yang dipercayai dan memberi kawalan jelas terhadap bahan yang disimpan. Kemajuan model patut menjadikan ruang kerja lebih berguna tanpa mengikat pengetahuan peribadi kepada satu model sahaja.
Apabila perbualan merentas bahasa menjadi lebih mudah, kami mahu membantu mengekalkan nilainya lebih lama. Mulakan dengan satu mesyuarat yang perlu diingati, satu idea untuk dikongsi atau satu sumber yang akan diperlukan semula.