Eleven Realtime membawa persaingan AI suara melampaui kualitas suara
ElevenLabs memperkenalkan model realtime Mini dan Max. Perubahan menariknya adalah susunan percakapan yang lebih sederhana, serta perbedaan lebih tegas antara terdengar alami dan menuntaskan pekerjaan.
Pratinjau komponen chat suara resmi ElevenLabs UI untuk dukungan pelanggan. Sumber: elevenlabs/ui; hak cipta 2025 Eleven Labs Inc., Lisensi MIT. Gambar ini menggambarkan antarmuka suara, bukan pengujian model Realtime.

Momen canggung dalam percakapan suara sering muncul sebelum jawabannya. Anda berhenti sejenak untuk mengingat tanggal, dan asisten mulai bicara. Anda mengoreksi nama, tetapi asisten menuntaskan kalimat yang sudah disiapkannya. Suaranya bisa terdengar sangat baik, sementara interaksinya terasa aneh dan kurang kooperatif. Bagi pembuat asisten telepon, tutor, atau karakter interaktif, kegagalan kecil itu dapat sama pentingnya dengan mutu suara yang dihasilkan.
Pada 20 Oktober, ElevenLabs memperkenalkan Eleven Realtime v1 Mini dan v1 Max, memosisikannya sebagai model agen suara lengkap, bukan komponen tambahan yang harus dirakit pengembang. Mini menyasar percakapan sehari-hari dengan biaya lebih rendah; Max menyasar instruksi kompleks dan pekerjaan bertahap. Rilis ini penting karena mengemas lebih banyak aspek percakapan ke dalam satu keputusan produk. Rilis tersebut juga membuat pertanyaan lama semakin sulit dihindari: ketika suara terdengar mampu, bagaimana kita mengetahui bahwa tugasnya benar-benar selesai? Pengumuman resmi.
Pandangan kami: bagian yang menjanjikan adalah berkurangnya waktu untuk menyetel sambungan antar-komponen. Pembuktian janji itu adalah percakapan yang mampu melewati koreksi dan menghasilkan keluaran yang benar. Demonstrasi yang rapi dapat menunjukkan kesan pertama. Permintaan pelanggan yang biasa dan berantakanlah tempat produk membuktikan kelayakannya.
ElevenLabs memperluas kekuatan yang sudah dikenal ke pekerjaan lebih besar
Bagi pembaca yang terutama mengenal ElevenLabs melalui suara sintetis, perusahaan kini menjelaskan tiga platform: ElevenCreative untuk pembuatan konten, ElevenAgents untuk agen percakapan yang diterapkan, dan ElevenAPI untuk pengembang. Realtime berada dalam upaya lebih luas untuk menjadikan audio berguna di dalam aplikasi, bukan hanya sebagai berkas audio jadi. Latar belakang itu menjelaskan mengapa rilis ini menggabungkan kualitas suara dengan mekanisme interaksi. Latar belakang pers ElevenLabs.
Klip audio memiliki batas yang jelas. Teks ditulis, ucapan dihasilkan, dan pendengar mendengarkan hasilnya. Agen langsung beroperasi di dalam situasi yang terus bergerak. Pendengar dapat menyela, mengubah pertanyaan, menambahkan informasi yang kurang, atau menyadari bahwa permintaan semula keliru. Perangkat lunak harus memutuskan apakah jeda berarti “giliran Anda” atau “saya masih berpikir”. Pemahamannya harus tetap selaras dengan orang tersebut sambil menangani sistem di balik percakapan.
Masalah produk ini berbeda dari membuat satu kalimat terdengar meyakinkan. Pertimbangkan asisten pemesanan. Ia mungkin melafalkan nama pelanggan dengan sempurna, tetapi tetap memesan hari yang salah karena melewatkan koreksi. Produk suara yang berhasil memerlukan ritme sosial dan catatan transaksi yang sama-sama masuk akal. Memperbaiki yang satu sambil mengabaikan yang lain menciptakan cara menyenangkan untuk melakukan hal yang salah.
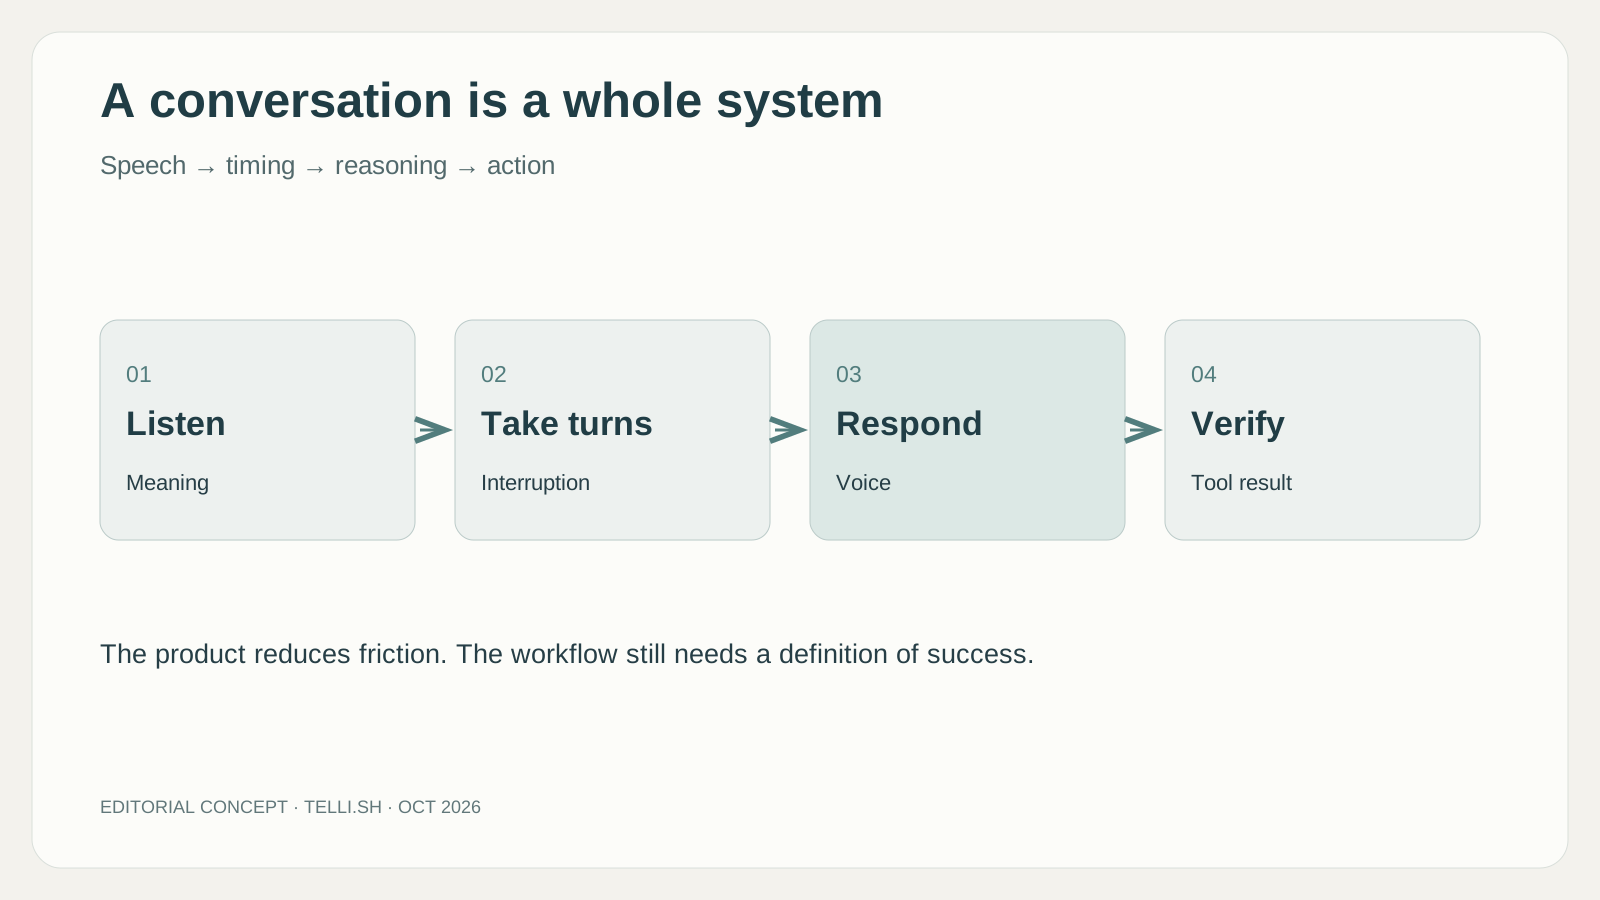
Infografik editorial orisinal. Ini menggambarkan pengalaman pengguna, bukan arsitektur internal model.
Susunan terkelola mengurangi konfigurasi sekaligus mengubah kendali Anda
Perbedaan dalam dokumentasi bersifat praktis. Dalam mode Custom, pembuat memilih model bahasa, model suara, dan pengaturan pengenalan. Mode Realtime menyerahkan pilihan tersebut kepada ElevenLabs sambil mempertahankan instruksi agen, suara, alat, dan pengaturan percakapan lain yang didukung. Akses diluncurkan bertahap, sehingga pengaturan ini mungkin belum terlihat di setiap ruang kerja. Realtime juga memiliki batasan kompatibilitas dan wilayah yang harus dipenuhi agen yang sudah ada. Dokumentasi model Realtime.
Pertukaran itu dapat berguna. Tim kecil mungkin jauh lebih peduli apakah asistennya menangani interupsi daripada memilih setiap komponen dasar. Konfigurasi terkelola memberinya titik awal yang selaras dan lebih sedikit kombinasi untuk ditelusuri saat bermasalah. Waktunya dapat digunakan untuk pertanyaan pelanggan, informasi yang benar-benar dimiliki bisnis, dan titik ketika manusia harus mengambil alih.
Namun, lebih sedikit pengaturan juga berarti lebih sedikit penggantian independen. Jika satu bagian perilaku tidak sesuai, tim perlu mengetahui apakah perilaku itu bisa disesuaikan, model bisa diganti, atau konfigurasi khusus bisa digunakan kembali. Perbandingan yang tepat adalah keseluruhan pekerjaan untuk memelihara agen yang dapat digunakan. Susunan yang bisa dikonfigurasi dapat membebani, sementara susunan terintegrasi dapat membatasi. Biaya mana yang lebih penting bergantung pada pekerjaannya dan siapa yang mengoperasikan sistem setelah demonstrasi.
Hal ini terutama relevan ketika prototipe menjadi layanan bersama. Orang yang merakit prototipe mungkin memahami keunikannya. Tim dukungan, pelanggan, dan pengembang berikutnya akan mengalami perilakunya tanpa latar belakang tersebut. Produk yang secara konsisten mengambil pilihan umum bisa bernilai meskipun menawarkan lebih sedikit pilihan. Konsistensi berguna ketika terlihat, dapat diuji, dan sesuai dengan tanggung jawab layanan.
Susunan suara lain menempatkan kendali di titik berbeda
Pendekatan ElevenLabs lebih jelas jika dibandingkan dengan alternatifnya. Panduan agen suara OpenAI membedakan interaksi ucapan realtime dari alur berantai yang mentranskripsikan ucapan, menjalankan agen teks, lalu menghasilkan ucapan sesudahnya. Pembahasan sistem berantai menekankan pemeriksaan teks perantara dan penggantian komponen satu per satu. Ini perbandingan arsitektur, bukan bukti tentang mekanisme internal Eleven Realtime yang tidak diungkap. Interaksi pelanggan yang sama dapat dirakit di sekitar titik pengamatan dan perubahan yang berbeda.
Tahap teks dapat bernilai ketika organisasi memerlukan titik pemeriksaan tertentu. Layanan pelatihan mungkin meninjau bagaimana agen menafsirkan jawaban pelajar; meja dukungan khusus mungkin menerapkan penanganan istilah sebelum respons diucapkan. Catatan perantara memberi tim sesuatu yang spesifik untuk diperiksa. Namun, tahap itu menambah batas antar-komponen yang harus dipelihara. Untuk karakter yang hidup atau percakapan eksploratif, pembuat mungkin memilih interaksi lebih terintegrasi dan menerima bentuk kendali yang berbeda.
| Pendekatan | Daya tarik bagi pembuat | Keputusan yang masih diperlukan |
|---|---|---|
| Mode realtime terkelola | Lebih sedikit pilihan komponen dan satu konfigurasi percakapan yang didukung | Apakah pengaturan yang didukung sesuai dengan layanan |
| Ucapan dan teks berantai | Teks perantara yang dapat diperiksa dan penggantian komponen independen | Bagaimana tahapan rakitan mempertahankan waktu respons dan koreksi |
| Orkestrasi berbasis framework | Perilaku aplikasi yang eksplisit untuk giliran, alat, dan pengalihan | Siapa yang memelihara perilaku itu saat penyedia berubah |
Faktor penentunya adalah di mana tim memerlukan titik pemeriksaan yang andal: transkrip perantara, peristiwa percakapan, atau tindakan yang selesai. Ini membantu menjelaskan mengapa tim secara masuk akal tetap mempertahankan sistem khusus meskipun rilis terintegrasi terlihat menjanjikan. Peluang komersial ElevenLabs adalah membuat pilihan terkelola cukup baik untuk lebih banyak pekerjaan, sehingga perakitan rinci menjadi pilihan, bukan biaya masuk untuk membangun layanan suara.
Keraguan dan interupsi layak mendapat respons berbeda
Sudut pandang framework menambah dimensi lain. Dokumentasi penanganan giliran LiveKit memperlakukan interupsi palsu sebagai perilaku eksplisit yang perlu ditangani: aktivitas suara dapat menyela agen meskipun tidak menghasilkan transkrip pengguna, dan ucapan dapat dilanjutkan setelah batas waktu yang dikonfigurasi. Ini tidak membuktikan bahwa ElevenLabs memakai mekanisme yang sama. Contoh tersebut menunjukkan mengapa kesantunan yang tampak pada produk suara bergantung pada perilaku aplikasi selain model yang menyuplai kata-katanya.
Bayangkan perbedaan antara seseorang berkata “tunggu, alamat yang satu lagi” dan seseorang batuk saat mendengarkan. Keduanya dapat menghasilkan suara pada giliran asisten. Hanya salah satunya yang pasti mengubah permintaan. Layanan yang mengulang penjelasan setelah setiap suara latar menjadi melelahkan; layanan yang mengabaikan koreksi nyata menjadi sulit dipercaya. Perbandingan yang berguna adalah apakah percakapan pulih dengan konteks yang benar, bukan apakah saluran audio mendeteksi aktivitas dengan cepat.
Perbedaan itu juga memperluas siapa yang perlu dilibatkan dalam uji coba. Orang yang mencari kata asing, memakai bahasa kedua, atau berbicara lebih lambat mungkin memerlukan durasi hening berbeda. Ini usulan kelompok evaluasi, bukan klaim tentang aksesibilitas terukur atau cakupan bahasa. Tim perlu memperhatikan apakah pengguna mendapat ruang untuk menyelesaikan ucapan dan apakah pemulihan mengharuskan mereka mengulangi seluruh permintaan. Nilai rata-rata waktu respons dapat menyembunyikan beban tersebut.
Kemungkinan yang menggembirakan adalah model percakapan terkelola dapat memperbaiki pengalaman ini tanpa setiap pelanggan menerapkan logika waktunya sendiri. Pertanyaan yang tersisa adalah seberapa jauh aplikasi tertentu dapat menyesuaikan diri ketika ritme bawaan tidak cocok. Ini pertanyaan produk yang konkret untuk demonstrasi: biarkan pembicara ragu, mengoreksi detail, dan melanjutkan, lalu periksa apa yang dipahami agen dan apa yang benar-benar diterima alat terhubung. Ini menghubungkan kenyamanan percakapan dengan hasil yang dapat diverifikasi tim.
Mini dan Max membedakan percakapan dari eksekusi yang menuntut
Kedua nama itu seharusnya mendorong keputusan beban kerja, bukan refleks membeli model lebih besar. Karakter latihan bahasa dan agen layanan yang mengikuti proses pengembalian dana menghadapi masalah berbeda. Yang pertama perlu menjaga percakapan mengalir dan merespons kesalahan secara sesuai. Yang kedua mungkin harus mengambil kebijakan, mengidentifikasi pesanan, memeriksa kelayakan, dan melaporkan hasil tindakan eksternal.
Model lebih besar bisa tidak diperlukan untuk interaksi ringan, sementara model lebih murah bisa menjadi mahal jika terus menyerahkan kasus belum selesai kepada staf. Biaya per menit berguna untuk memperkirakan tagihan. Biaya per interaksi yang selesai dengan benar lebih berguna untuk menentukan apakah sistem layak masuk alur kerja. Angka kedua itu mencakup pemulihan, panggilan berulang, dan pekerjaan manusia untuk memperbaiki kesalahan yang terdengar masuk akal.
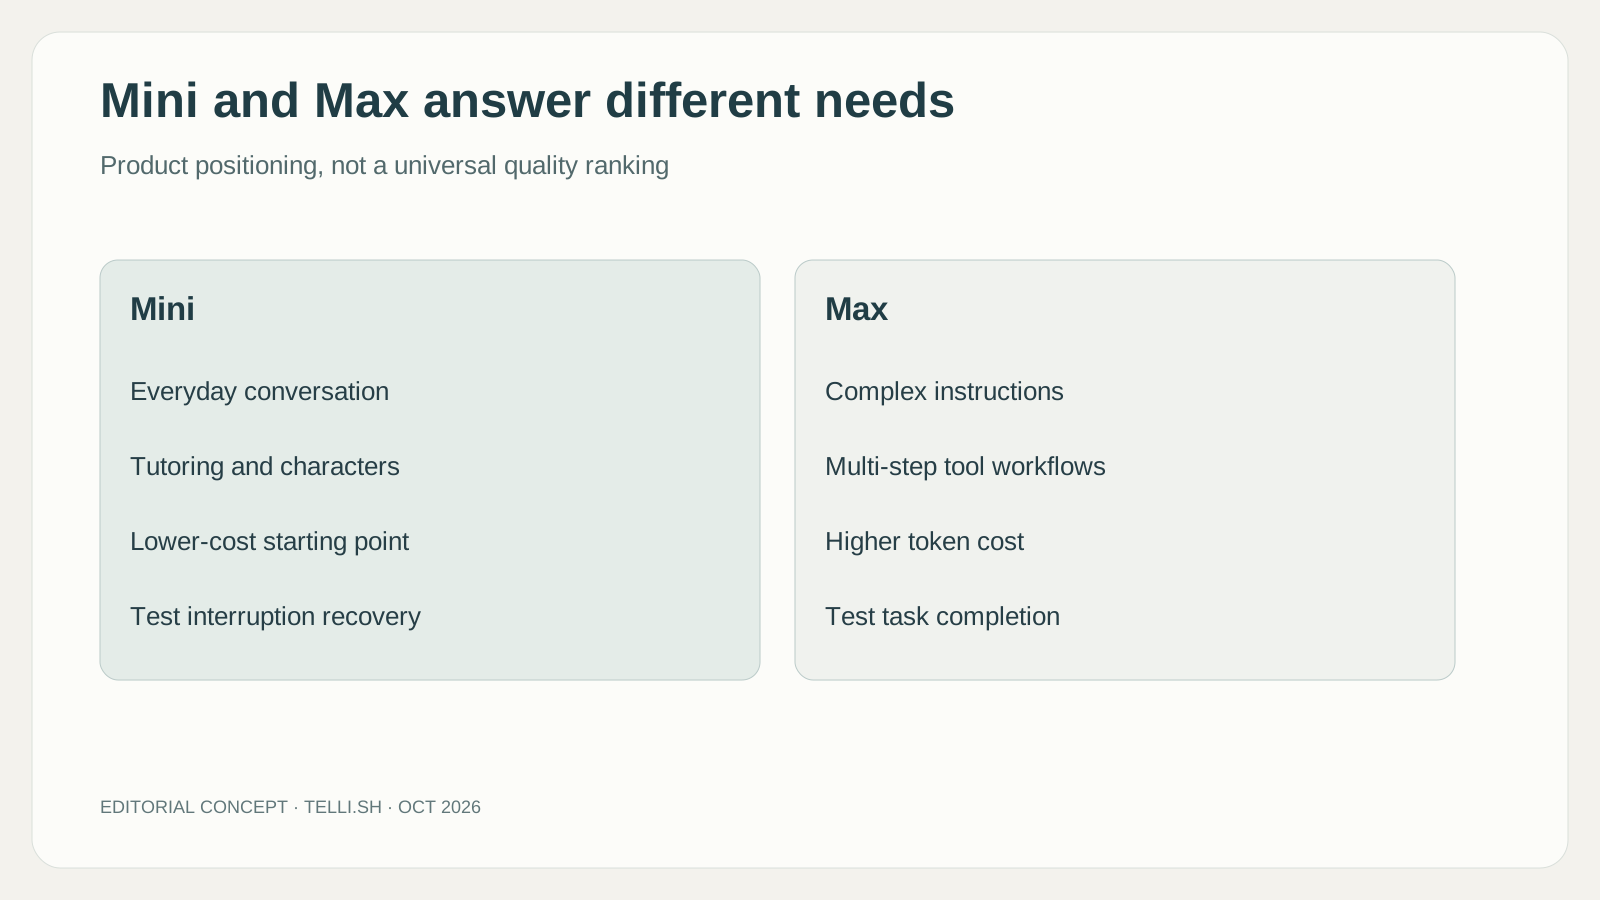
Infografik orisinal berdasarkan pemosisian penyedia. Ini bukan peringkat terukur untuk semua bahasa atau tugas.
Pengumuman menerbitkan hasil benchmark yang diatribusikan kepada Artificial Analysis. Angka penggunaan alatnya adalah penyelesaian 87.1% untuk Max dan 60.3% untuk Mini, sedangkan skor dinamika percakapan yang dilaporkan sedikit mengunggulkan Mini. Ini hasil benchmark yang diterbitkan penyedia, bukan pengukuran penerapan kami. Pesan bergunanya adalah kelancaran percakapan dan penyelesaian penggunaan alat dapat berbeda; angka tersebut tidak menetapkan tingkat keberhasilan panggilan perusahaan tertentu. Pengumuman dan konteks benchmark.
Karena itu, tim sebaiknya tidak memadatkan seluruh mutu menjadi satu posisi papan peringkat. Jika agen terutama menjelaskan pameran museum, pengaturan waktu percakapan mungkin mendominasi. Jika agen memperbarui reservasi, keadaan akhir yang tepat lebih penting. Rilis ini memberi pembuat dua titik awal, tetapi tugas tetap menentukan definisi mutu.
Tiga situasi biasa memperlihatkan kekuatan berbeda
Bayangkan pelajar berlatih percakapan restoran dalam bahasa lain. Pelajar berhenti di tengah pesanan, mencari kata, lalu memulai kembali. Tutor yang berguna memberi ruang untuk keraguan itu dan menawarkan bantuan tanpa mengambil alih. Manfaatnya adalah keyakinan untuk terus berlatih. Kegagalannya berupa asisten yang menganggap setiap jeda sebagai izin untuk memberi ceramah. Contoh ilustratif ini terutama menyangkut kerja sama dalam percakapan, sementara mutu pengajaran tetap memerlukan peninjauan tersendiri.
Sekarang pertimbangkan layanan janji temu. Penelepon awalnya meminta hari Jumat, lalu berkata, “Sebenarnya, Senin depan, setelah makan siang.” Asisten harus membawa koreksi itu ke usulan pemesanan dan mengonfirmasi detail terkait sebelum langkah yang berdampak. Setelah sistem pemesanan merespons, konfirmasi lisan harus mencerminkan respons tersebut. Ucapan ramah “sudah beres” sebelum sistem menerima perubahan merupakan kegagalan, sekalipun setiap kalimat terdengar alami.
Karakter interaktif menciptakan keseimbangan ketiga. Jawaban imajinatif dapat diterima dalam latar fiksinya, tetapi pemain tetap berharap karakter mengingat adegan saat ini dan berhenti saat disela. Di sini hasil bisnisnya mungkin berupa interaksi yang menarik, bukan transaksi selesai. Perilaku yang terasa hidup pada karakter bisa terasa mengelak dalam dukungan pelanggan. Karena itulah pekerjaan berbeda perlu dievaluasi sendiri-sendiri, alih-alih memperlakukan “agen suara” sebagai satu kategori seragam.
Kompatibilitas menurunkan biaya mencoba, dengan batas yang perlu dibaca
ElevenLabs menawarkan akses melalui ElevenAgents dan Realtime API yang kompatibel dengan OpenAI. Contoh API dalam pengumuman mengubah tujuan dan model pada klien yang sudah ada, tetapi juga menetapkan koneksi khusus WebSocket dan memisahkan API tersebut dari platform terkelola. Karena itu, integrasi WebRTC memerlukan lebih dari sekadar mengganti nama model, dan kanal terkelola atau fitur basis pengetahuan tidak boleh dianggap otomatis ikut tersedia melalui API. Akses API dan catatan migrasi.
Nilai kompatibilitasnya adalah perbandingan yang lebih mudah. Pengembang dapat mempertahankan lebih banyak bagian aplikasi yang sudah ada sambil mencoba penyedia berbeda. Ini membuat perbandingan tugas, prompt, dan alat yang sama lebih realistis daripada membandingkan demonstrasi yang tidak saling terkait. Kebutuhan memeriksa perilaku peristiwa, penyambungan ulang, respons alat, dan cara aplikasi menyajikan kegagalan tetap ada.
Detail yang kurang gemerlap itu membentuk pengalaman pelanggan. Jika koneksi putus setelah permintaan pemesanan, aplikasi perlu mengetahui apakah pemesanan terjadi sebelum meminta penelepon mengulanginya. Jika alat melewati batas waktu, mengulangi pemanggilan alat dapat menimbulkan konsekuensi berbeda dari mengulangi pertanyaan lisan. Migrasi model berhasil ketika aplikasi lengkap berperilaku benar dalam situasi tersebut, bukan hanya ketika respons audio pertama terdengar.
Suara alami dapat membuat tindakan belum selesai terdengar sudah tuntas
Pertahankan perbandingan yang stabil saat memilih model. Jika model lebih besar menerima basis pengetahuan lebih bersih, prompt lebih baik, dan alat lebih andal, uji coba tidak dapat menjelaskan perubahan mana yang membantu. Mulailah dengan permintaan representatif yang sama dan periksa kegagalannya sebelum mengubah alur di sekelilingnya. Kegagalan waktu mungkin memerlukan penyesuaian percakapan; jawaban kebijakan yang salah mungkin membutuhkan sumber lebih baik; pemesanan yang tidak selesai mungkin melibatkan integrasi alat. Membeli model yang lebih mampu dapat membantu sebagian masalah, tetapi tidak boleh menyembunyikan sambungan rusak yang akan tetap rusak dengan pilihan mana pun.
Keunggulan terkuat produk juga dapat membuat kesalahan lebih sulit terlihat. Orang memakai nada, tempo, dan kepercayaan diri sebagai sinyal percakapan. Asisten yang lancar dapat terdengar seolah sudah memeriksa sesuatu padahal baru membentuk respons yang masuk akal. Dalam antarmuka teks, pengguna mungkin memiliki lebih banyak kesempatan memeriksa jawaban. Selama panggilan, percakapan bergerak maju dan detail yang dipersoalkan dapat tenggelam di dalam alurnya.
Respons rancangan harus konkret, bukan teatrikal. Bedakan penjelasan, tindakan yang diusulkan, dan hasil yang dikonfirmasi. Biarkan agen mengatakan bahwa ia sedang memeriksa, permintaan masih tertunda, atau manusia perlu membantu. Pastikan keadaan itu sesuai dengan aplikasi, sehingga bukan sekadar bahasa yang menenangkan di dalam prompt. Jeda yang jujur sering memberi pengalaman layanan lebih baik daripada jawaban instan yang menciptakan pekerjaan perbaikan kemudian.
Eskalasi ke manusia juga memerlukan kesinambungan. Penelepon yang mencapai staf setelah beberapa menit tidak seharusnya harus merangkai ulang setiap detail dari ingatan. Pengalihan yang berguna memuat permintaan terkini, koreksi relevan, dan langkah yang belum selesai. Ketidakpastian harus dipertahankan ketika agen memang tidak yakin. Jika tidak, otomatisasi menghemat waktu di awal panggilan sambil memindahkan beban yang sama ke orang yang harus menyelesaikannya.
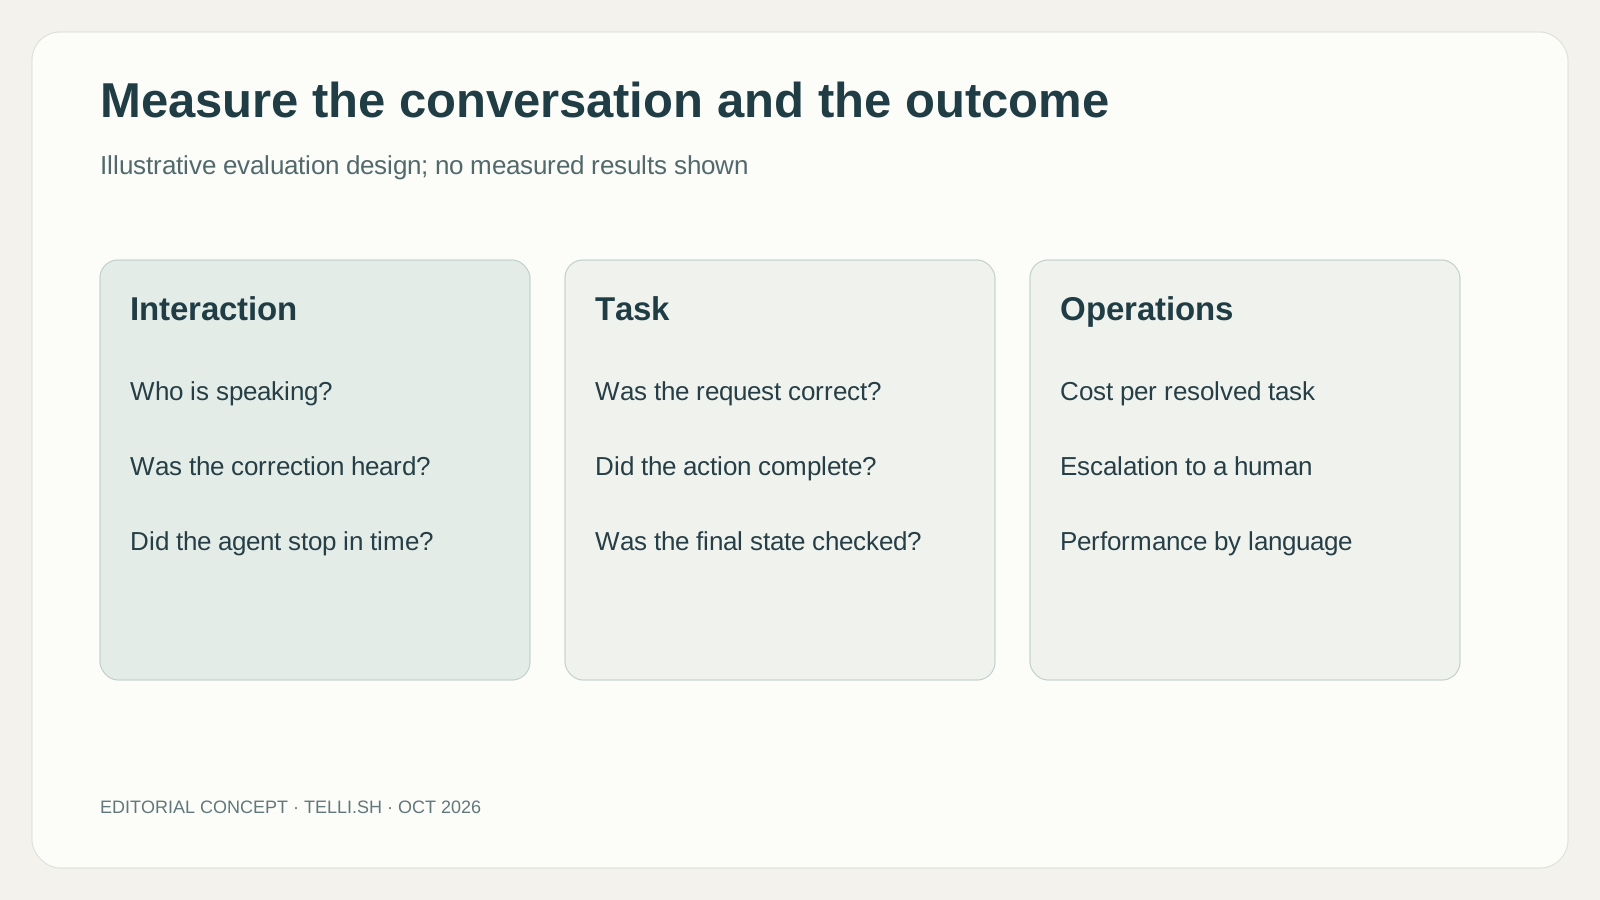
Kerangka evaluasi editorial orisinal. Tidak ada hasil pengujian yang digambarkan.
Benchmark berikutnya adalah percakapan yang terselesaikan
Uji coba yang masuk akal akan memakai percakapan representatif dengan izin: permintaan pendek dan panjang, interupsi, koreksi, bahasa berbeda, serta kasus yang memerlukan eskalasi. Tinjau apakah tindakan yang dimaksud terjadi, seberapa sering manusia harus campur tangan, dan biaya interaksi yang selesai. Pertahankan kecepatan audio pertama sebagai salah satu ukuran, tetapi hitung pula jawaban cepat yang kemudian membutuhkan koreksi. Ukuran ini menjelaskan usulan evaluasi, bukan pengujian Realtime yang telah kami lakukan.
Hasil paling menjanjikan adalah agen yang mengajukan lebih sedikit pertanyaan tidak perlu, sambil tetap bersedia mengajukan pertanyaan yang memang dibutuhkan. Tutor harus membiarkan pelajar menuntaskan pikirannya. Asisten pemesanan harus memverifikasi tanggal yang dikoreksi. Agen dukungan harus membawa konteks ke proses pengalihan. Perbaikan itu sederhana untuk dijelaskan dan besar untuk dirasakan, karena menghilangkan hambatan kecil yang membuat percakapan otomatis melelahkan.
Eleven Realtime memberi arah itu bentuk produk yang konkret. Rilis ini dapat memungkinkan lebih banyak tim membangun interaksi suara berguna tanpa menjadi ahli setiap komponen audio. Arti jangka panjangnya bergantung pada apakah perilaku percakapan terintegrasi juga menghasilkan pekerjaan selesai yang andal. Suara mengajak pengguna masuk ke percakapan. Hasil menentukan apakah mereka ingin menjalani percakapan berikutnya.
Sumber
-
Pengumuman Eleven Realtime dan konteks benchmark, 20 Oktober 2026.
-
Mode model Realtime, peluncuran, dan batasannya, diperiksa 21 Oktober 2026.
-
Latar belakang platform ElevenLabs, diperiksa 21 Oktober 2026.
-
Arsitektur agen suara OpenAI, diperiksa 21 Oktober 2026.
-
Penanganan giliran LiveKit, diperiksa 21 Oktober 2026.
Pertahankan percakapan agar dapat ditinjau
Jika Anda membutuhkan tempat terpisah untuk menyimpan rekaman yang telah diizinkan dan catatan yang ditinjau, Telli.sh adalah salah satu pilihan. Mulai dengan catatan audio.