Dessa ของ Block ถามว่าโมเดลเสียงเรียนรู้อะไรได้ก่อนอ่านหนังสือ
Dessa เป็นงานวิจัยเบื้องต้นของ Block ที่เรียนจากเสียงพูดเท่านั้น เดโมฟูลดูเพล็กซ์ชวนถามถึงจังหวะ ความถูกต้อง และสิ่งที่บทสนทนาธรรมชาติพิสูจน์ได้
ลองพูดว่า “แบบนั้นก็ดี” ด้วยความโล่งใจ แล้วพูดอีกครั้งหลังเว้นนานด้วยเสียงราบเรียบ คำเหมือนเดิม แต่บทสนทนาเปลี่ยนไป
Block เปิดตัว Dessa เมื่อ 23 ตุลาคม 2026 โดยอธิบายว่าเป็นโมเดลที่เรียนจากบทสนทนามนุษย์โดยไม่ใช้ข้อความหรือโมเดลที่ฝึกมาก่อน บริษัทเจ้าของ Square และ Cash App เรียกว่าระบบเสียงแบบฟูลดูเพล็กซ์ คือฟังได้ขณะพูด การเปิดตัวเป็นตัวอย่างงานวิจัย มีเสียงบันทึกสาธารณะและสิทธิ์จำกัดสำหรับนักวิจัยความปลอดภัย ไม่ใช่ API เสียงที่ให้ใช้ทั่วไป
คำถามน่าสนใจคือเมื่อจังหวะและการแสดงออกผ่านเสียงเป็นส่วนของการเรียนตั้งแต่ต้น จะเกิดอะไรขึ้น บทความอธิบายความต่าง เสนอวิธีฟังเดโม และพิจารณางานสามแบบที่พฤติกรรมสนทนามีความหมาย มุมมองของเราคือระบบเสียงที่มีประโยชน์รุ่นต่อไปต้องดูแลช่องว่างระหว่างคำอย่างระมัดระวังเท่าตัวคำ
ภาพหลัก: ภาพบรรณาธิการที่จัดทำเองเกี่ยวกับเสียงและจังหวะสนทนา ไม่ใช่การติดตั้ง Dessa หรือคลื่นเสียงที่วัดจริง
เสียงพูดมีข้อมูลที่ข้อความถอดเสียงเรียบร้อยอาจทำหาย
ข้อความถอดเสียงช่วยให้ค้น อ้าง และตรวจบทสนทนาได้ แต่ปกตินำเสนอข้อมูลแคบกว่าต้นฉบับเสียง การเน้นคำ จังหวะ การพูดทับ และเสียงที่ไม่ใช่คำมีผลต่อการตีความ
สมมติคุยนัดหมาย คนหนึ่งพูด “วันพฤหัสได้” แล้วต่อทันทีว่า “เดี๋ยวนะ หลังอาหารกลางวัน” ผู้ช่วยที่มีประโยชน์ต้องรักษาการแก้และไม่ถือว่าส่วนแรกเป็นคำสั่งเสร็จสมบูรณ์ จังหวะสำคัญเพราะระบบอาจเริ่มเตรียมคำตอบแล้ว
เสียงรับสั้น ๆ เช่น “อืม” อาจหมายถึง “ยังฟังอยู่” ไม่ใช่ “ขอพูดบ้าง” ระบบที่นับทุกเสียงเป็นเทิร์นเต็มใหม่ทำให้เหนื่อย ส่วนระบบที่มองข้ามการแทรกสั้นทุกครั้งอาจพลาดการแก้จริง
นี่คือปัญหา จังหวะของบทสนทนา ว่าเมื่อไรควรพูดต่อ รอ รับคำ หรือยอมให้พูด การเพิ่มความแสดงออกให้เสียงสังเคราะห์อย่างเดียวไม่พอ ระบบต้องตัดสินใจเรื่องการไหลของบทสนทนาด้วย
นักวิจัย Moshi ซึ่งเผยแพร่ในปี 2024 ระบุชัดว่าคำพูดซ้อนและคำแทรกเป็นข้อจำกัดของระบบแบ่งช่วงผลัดกันพูด เป็นบริบทสำคัญเพราะบทสนทนาฟูลดูเพล็กซ์มีมาก่อน Dessa ข้ออ้างที่เด่นของ Block คือการฝึกจากคำพูดอย่างเดียว ซึ่งควรแยกประเมินจากความสามารถฟังและพูดพร้อมกันทั่วไป
สามคำถามช่วยไม่ให้สับสนสามความสามารถ
คำว่า “เกิดมาเพื่อเสียง” อาจหมายถึงข้อมูลฝึก ข้อมูลที่ส่งระหว่างองค์ประกอบขณะทำงาน หรือจังหวะการโต้ตอบ ความก้าวหน้าในด้านหนึ่งไม่ได้แก้อีกด้านเสมอไป
ตารางแยกมิติเหล่านี้เพื่ออ่านประกาศผลิตภัณฑ์ เป็นการเปรียบเทียบแนวคิด ไม่ใช่อันดับ benchmark หรือคำอธิบายระบบภายในโมเดลอย่างครบถ้วน
| คำถาม | สิ่งที่ถาม | สิ่งที่ยังพิสูจน์ไม่ได้ด้วยข้อนี้อย่างเดียว |
|---|---|---|
| ใช้อะไรฝึกโมเดล | ใช้เสียงพูด ข้อความ หรือทั้งคู่ | ความแม่นยำในงานหรือภาษาเฉพาะ |
| ระหว่างทำงานประมวลผลอะไร | เสียงเข้าตรงหรือผ่านตัวแทนอื่น | ความนุ่มนวลในการรับการขัดจังหวะ |
| อินพุตกับเอาต์พุตซ้อนกันได้หรือไม่ | ฟังระหว่างสร้างคำพูดได้หรือไม่ | เข้าใจอารมณ์หรือเจตนาถูกต้องหรือไม่ |
หน้า Dessa ที่ตรวจเมื่อ 27 ตุลาคม 2026 อธิบายทั้งสามด้าน ได้แก่ เรียนจากเสียงอย่างเดียว โต้ตอบเสียงสู่เสียง และจังหวะฟูลดูเพล็กซ์ เป็นคำอธิบายของทีม ไม่ใช่คะแนนคุณภาพที่เผยแพร่ครอบคลุมทุกบทสนทนา
Moshi แสดงว่าทำไมต้องแยก บทความวิจัยอธิบายระบบเสียงและข้อความฟูลดูเพล็กซ์ที่สร้างบนโมเดลภาษาข้อความ เส้นทางเรียนต่างจาก Dessa ตามที่ Block บอก แม้ทั้งคู่จัดการบทพูดซ้อนกัน การเรียกทุกระบบว่าเป็นขั้นตอนถอดเสียงทำให้มองไม่เห็นความต่าง
ทีมผลิตภัณฑ์ควรถามว่ามิติใดสำคัญต่องาน คลังค้นหาได้ต้องมีข้อความเชื่อถือได้ ครูสอนโต้ตอบต้องมีคำแนะนำมีประโยชน์และจังหวะเหมาะ ส่วนเอเจนต์หน้าลูกค้าต้องมีความรู้และสิทธิ์ทำงานธุรกิจให้จบด้วย
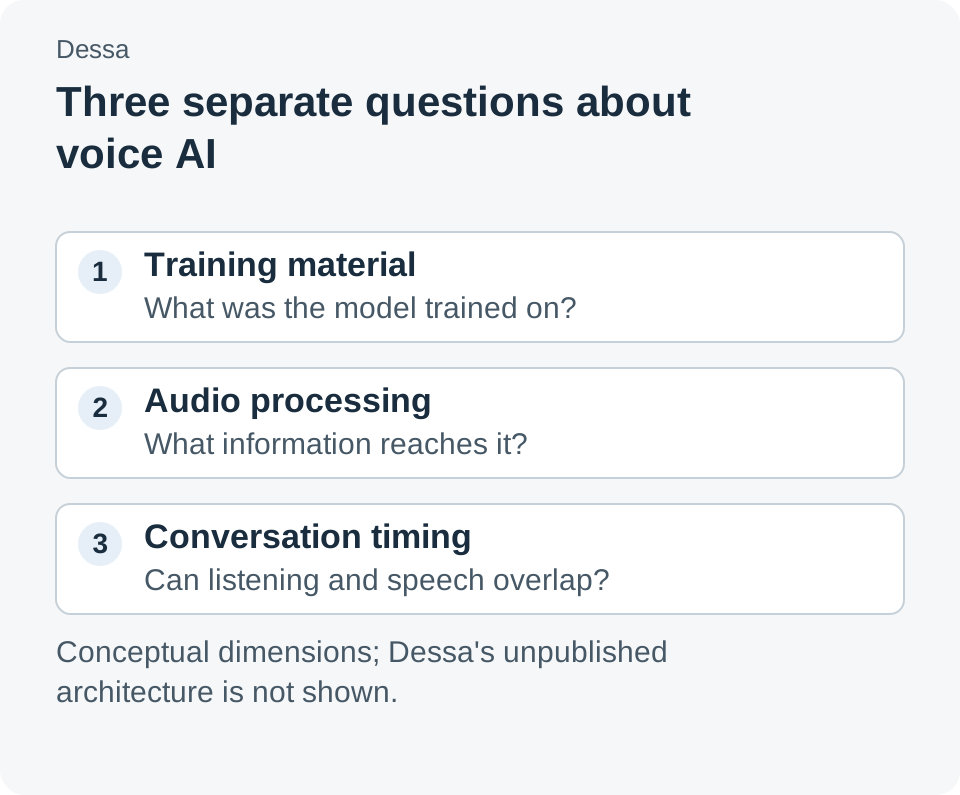
แผนภาพอธิบายที่สร้างเอง ไม่อ้างว่าเปิดเผยสถาปัตยกรรม Dessa ที่ยังไม่เผยแพร่ แหล่งข้อมูล: หน้า Dessa ของ Block และ งาน Moshi ปี 2024
เสียงน่าเชื่อกับคำตอบถูกต้องต้องทดสอบแยกกัน
คำตอบที่แสดงอารมณ์ติดตามง่าย แต่ก็อาจทำให้คำตอบไร้หลักฐานฟังน่าเชื่อขึ้น เมื่อผู้ฟังรู้สึกว่าระบบเข้าใจตน อาจหยุดตรวจรายละเอียดน้อยลง
ความรู้สึกเห็นอกเห็นใจ ความถูกต้องของข้อเท็จจริง และการทำงานสำเร็จจึงต้องมีเกณฑ์แยก การรับคำอย่างเป็นมิตรอาจเหมาะแม้ระบบไม่มีข้อมูลตอบ แต่ในกรณีนั้นคำถามชัดเจนในเวลาที่เหมาะมักดีกว่าการเดาที่ขัดเกลาอารมณ์
สมมติคุยบริการลูกค้าเรื่องพัสดุล่าช้า ผู้โทรหงุดหงิดและแทรกเพื่อแก้หมายเลขคำสั่งซื้อ ระบบที่ดีควรยอมรับการแก้ เก็บรหัสถูก และอธิบายขั้นถัดไป น้ำเสียงอบอุ่นไม่แก้การค้นผิดหรือคำสัญญาเกินอำนาจ
เช่นเดียวกันเมื่อคนฟังดูไม่แน่ใจ การหยุดอาจหมายถึงลังเล หาคำ ถูกรบกวนในห้อง หรือพูดจบแล้ว เสียงให้หลักฐานแต่ความหมายขึ้นกับบริบท การประเมินที่สมเหตุผลควรให้คุณค่ากับการถามย้ำเมื่อสัญญาณกำกวม
Block เชิญนักวิจัยความปลอดภัยกลุ่มจำกัดตรวจ Dessa นี่อธิบายระยะปัจจุบันอย่างมีความหมาย ไม่ได้ยืนยันว่าผ่านข้อกำหนดความน่าเชื่อถือของงานสนับสนุน การศึกษา หรือการใช้งานอื่นแล้ว
เดโมทางการเป็นแบบฝึกฟัง ไม่ใช่ตารางคะแนน
หน้าเปิดเผยมีบันทึกบทสนทนาที่คัดเลือก เช่น คุยเรื่องการเปิดตัวและรำลึกถึงภาพยนตร์ บริษัทบอกว่าโมเดลเลือกคำตอบเองและใส่คำบรรยายภายหลัง เราเห็นตัวอย่างพฤติกรรมได้ แต่ไม่รู้ว่าปรากฏบ่อยเพียงใดในชุดทดสอบกว้าง
ฟังจังหวะก่อนอ่านคำบรรยาย คำตอบเริ่มเมื่อไร การรับคำสนับสนุนหรือแย่งเทิร์นคน ระบบให้พื้นที่คนแก้คำของตนเองไหม
จากนั้นตรวจเนื้อหา หากมีข้อเท็จจริง ให้ประเมินแยกจากคุณภาพการพูด คำตอบที่จังหวะยอดเยี่ยมก็ยังต้องแก้ได้ การแยกสองการตัดสินช่วยไม่ให้เดโมฟังดีแทนหลักฐานเรื่องงาน
สุดท้ายดูการฟื้นจากความเข้าใจผิด เมื่อคนแก้แล้ว บทสนทนาแก้ปัญหาหรือยังเดินตามความหมายเดิม การฟื้นหนึ่งครั้งไม่ให้ค่าอัตรา แต่ช่วยออกแบบการประเมินภายหลัง
ข้อจำกัดก็ชัด บันทึกที่เลือกไว้ไม่ให้ควบคุมคำสั่ง สภาพแวดล้อม หรือจำนวนการลอง ใช้มันสร้างคำถามสำหรับการทดลอง ไม่ใช่ตอบทุกคำถามการนำไปใช้ล่วงหน้า
สามการใช้งานที่เป็นไปได้แสดงความสำคัญของจังหวะ
สถานการณ์ต่อไปเป็นตัวอย่างใช้ความสามารถสนทนา ไม่ใช่ลูกค้า Dessa ที่ประกาศแล้วหรือคำอ้างว่ารองรับการเชื่อมต่อที่จำเป็น แต่ละข้อแยกพฤติกรรมที่น่าสำรวจออกจากงานทำให้เชื่อถือได้
คู่ฝึกภาษา อาจได้ประโยชน์จากการรอระหว่างผู้เรียนลังเลและรับรู้การแก้ที่สำเร็จ การประเมินต้องแยกกำลังใจที่ช่วยกับการแทรกที่ขัดการฝึก และต้องมีหลักฐานภาษาเป้าหมาย คุณภาพการแก้ และการรับมือผิดซ้ำ เดโมอังกฤษธรรมชาติไม่ตอบทั้งหมด
ผู้ช่วยซ้อมพูด อาจช่วยฝึกนำเสนอหรือบทสนทนายาก ควรให้พูดจบความคิด ถามต่อ และรับคำสั่งที่เปลี่ยน ทีมต้องกำหนดว่าเป้าคือซ้อม ให้ความเห็น หรือสอนข้อเท็จจริง เพราะแต่ละอย่างใช้เกณฑ์ต่างกัน
หน้ารับเรื่องเพื่อคัดแยกบริการ อาจฟังคำอธิบาย ถามให้ชัด และเก็บการแก้โดยไม่เริ่มคุยใหม่ ส่วนยากคือเชื่อมบทสนทนากับเรื่องและการกระทำที่ถูก ความรู้ การยืนยันตัวตน การส่งต่อ และสิทธิ์ทำรายการยังเป็นหน้าที่ระบบคนละส่วน
รูปแบบร่วมคือการคุยลื่นช่วยลดอุปสรรคไปสู่การตัดสินใจถัดไป คุณค่าขึ้นกับว่าการตัดสินใจมีประโยชน์และผู้ใช้แก้ได้หรือไม่ การรับการแทรกกับการฟื้นจึงเป็นข้อกำหนดผลิตภัณฑ์จริง ไม่ใช่รายละเอียดเดโมเท่านั้น
การรันในเครื่องเป็นข้ออ้างด้านฮาร์ดแวร์ที่มีเงื่อนไขการเข้าถึง
Block ระบุว่า Dessa รันในเครื่องบน MacBook Pro M4 Max หรือดีกว่า และฝึกด้วย NVIDIA GB200 NVL72 หนึ่งระบบ ทั้งสองมาจาก หน้าโครงการทางการ ที่เข้าถึง 27 ตุลาคม 2026 เป็นข้อมูลผู้พัฒนารายงาน ไม่ใช่การวัดจากการติดตั้งของเรา
ต้องแยกการฝึกกับการใช้งานโมเดล เครื่องฝึกและเครื่องรันโมเดลสำเร็จตอบคนละคำถาม ฮาร์ดแวร์ฝึกไม่ใช่ข้อกำหนดผู้บริโภค และคำบอกว่ารันบนโน้ตบุ๊กไม่ใช่ตารางหน่วยความจำและความหน่วงที่เผยแพร่
การเข้าถึงก็แยกอีกเรื่อง หน้ายังระบุลิงก์เปิดใช้ว่าเร็ว ๆ นี้ และเข้าถึงก่อนเฉพาะนักวิจัยที่เลือก ไม่มีราคา API ทั่วไป น้ำหนักโมเดลให้ดาวน์โหลด หรือตารางภาษาที่ใช้วางแผนผลิตจริงได้
นักพัฒนาใช้ข้อมูลนี้เลือกคำถามที่ควรติดตามได้ แต่ยังไม่พอจัดตารางย้ายจากระบบเสียงเดิม แผนย้ายที่น่าเชื่อถือต้องมีสิ่งใช้งานได้ รายละเอียดเชื่อมต่อ ผลวัดบนเครื่องเป้าหมาย และการสนับสนุนชัดเจน
ออกแบบการประเมินที่มีความเงียบและการแก้คำ
ถ้ามีการทดลองกว้างขึ้น ให้เริ่มงานที่ผลถูกตรวจง่าย ใช้สถานการณ์เดียวกันข้ามระบบ และเก็บเสียงที่จำเป็นต่อการทำความเข้าใจข้อโต้แย้งโดยผู้ร่วมยินยอม ขั้นตอนนี้เป็นข้อเสนอ ไม่ใช่การทดลองที่ทำในบทความ
- กำหนดผลที่ต้องการ นัดหมายต้องมีวันเวลาถูก การซ้อมต้องระบุคำแนะนำที่ขอ อย่าใช้เพียงคะแนน “เหมือนคน”
- เขียนสถานการณ์เป็นคู่ ให้คำขอหลักใกล้กันแล้วเปลี่ยนเหตุการณ์เดียว เช่น หยุด รับคำ แทรก หรือแก้ชัดเจน จะคุยต้นเหตุความผิดพลาดได้ง่าย
- ใส่คำสั่งให้กู้คืน ขอแก้รายละเอียดก่อนหน้า ตรวจว่าคำตอบสุดท้ายสะท้อนและการคุยทำให้การเปลี่ยนชัด
- ประเมินเวลาและเนื้อหาแยก บันทึกการแทรกไม่เหมาะ พลาดคำแก้ หรือข้อเท็จจริงไร้หลักฐาน คะแนนรวมเดียวอาจซ่อนจุดอ่อน
- ทดสอบสภาพแวดล้อมเป้าหมาย เมื่อเข้าถึงได้ ให้ลองงานตัวแทนบนเครื่องและระบบเสียงจริง ผลจากไมค์ในที่เงียบเป็นหลักฐานสำหรับชุดนั้น ไม่ใช่ทุกห้องหรือหูฟัง
- ทบทวนความเห็นต่างด้วยเสียง ฟังช่วงที่เกี่ยวข้องแล้วปรับเกณฑ์ ความต่างอาจเปิดเผยว่างานนิยามไม่ชัด ไม่ใช่เพียงโมเดลผิด
ตัวอย่างชุดแรกอาจมี 12 สถานการณ์: สี่มีช่วงหยุด สี่มีการแก้ สี่มีการรับคำสั้น จำนวนนี้เป็นข้อเสนอเริ่มต้น ไม่ใช่การรับรองความเพียงพอทางวิทยาศาสตร์หรือ benchmark Dessa ที่เผยแพร่ เป้าคือเห็นความต้องการสนทนาหลายแบบก่อนเพิ่มขนาด
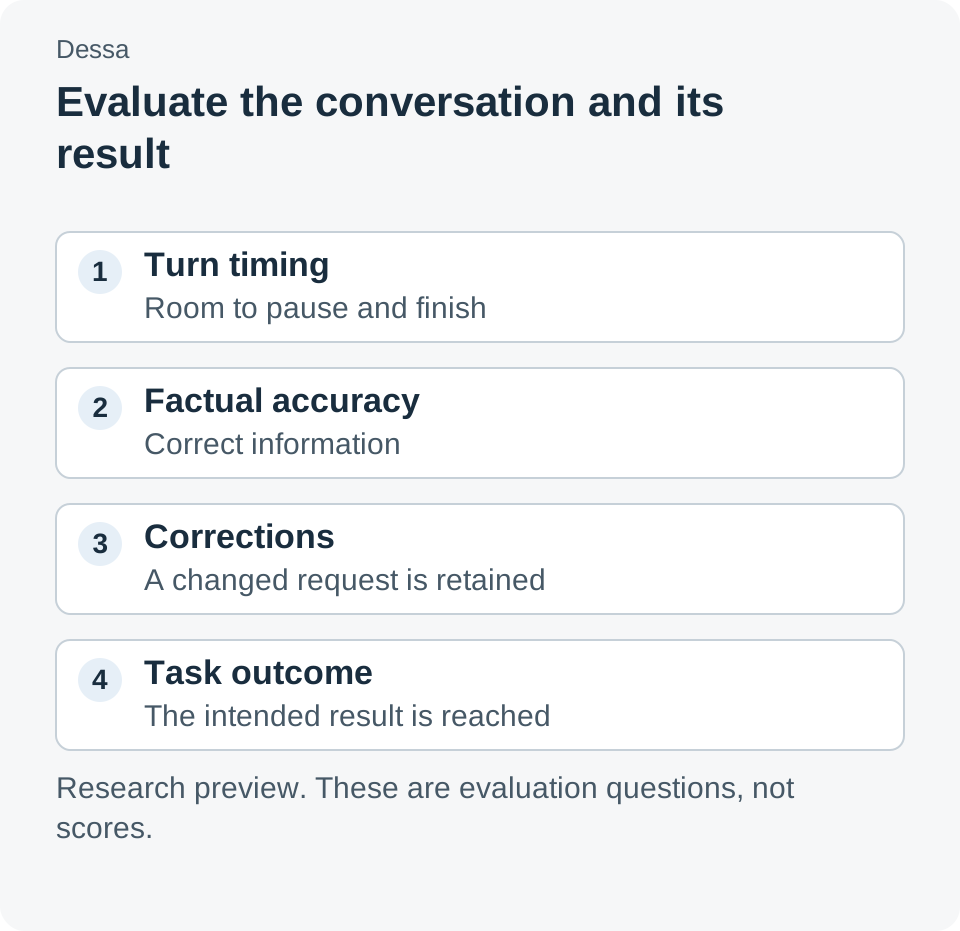
คู่มือจัดทำเอง ไม่สื่อถึงอัตราสำเร็จ ผลความหน่วง หรือคะแนนเปรียบเทียบโมเดลที่วัดแล้ว
อินเทอร์เฟซเสียงควรทำให้การแก้เป็นเรื่องธรรมดา
ความหวังที่มีประโยชน์ที่สุดไม่ใช่ทำผู้ช่วยทุกตัวเหมือนคนจนแยกไม่ออก แต่คือใช้แรงน้อยลงในการปรับวิธีพูดให้เข้ากับหน้าตาใช้งานที่แข็ง การหยุด แทรก และคิดยังไม่จบเป็นเรื่องปกติของการพูด
Dessa ทำให้ความเป็นไปได้นี้มีหัวข้อวิจัยจับต้องได้ คือโมเดลที่ผู้พัฒนาบอกว่าเรียนจากเสียงเท่านั้น คำถามถัดไปคือพฤติกรรมนี้ใช้ได้ในสถานการณ์ที่ผู้ใช้ต้องการจริงหรือไม่ อินเทอร์เฟซที่ดีช่วยให้พูดต่อ อธิบาย และแก้ได้ง่าย โดยยังเข้าใจงานที่ทำอยู่
แหล่งข้อมูล
- Block: Dessa — คำอธิบายวิจัย เดโม ฮาร์ดแวร์ และสถานะเข้าถึงทางการ ตรวจ 27 ตุลาคม 2026
- ข่าว Block — ประกาศวันที่ 23 ตุลาคม 2026
- Défossez และคณะ: Moshi, a speech-text foundation model for real-time dialogue — งานวิจัยต้นทางปี 2024 เรื่องบทสนทนาเสียงและข้อความแบบฟูลดูเพล็กซ์
ตรวจแหล่งเมื่อ 27 ตุลาคม 2026 รายละเอียดผลิตภัณฑ์เป็นข้อมูลผู้เผยแพร่ สถานการณ์และขั้นตอนเป็นตัวอย่าง เราไม่ได้ติดตั้ง Dessa หรือวัดประสิทธิภาพ ฟังบันทึกทางการได้ที่หน้าโครงการ
คำแนะนำจาก Telli.sh
ต้องการที่ค้นบันทึกเสียง เอกสารอ้างอิง และการตัดสินใจหลังคุยได้ไหม รวบรวมเอกสารอ้างอิงไว้ใน Telli.sh เพื่อให้ส่งต่องานได้เข้าใจตรงกัน