Dessa dari Block bertanya apa yang dipelajari model suara sebelum membaca
Dessa adalah pratinjau riset Block yang belajar hanya dari ujaran. Demo dupleks penuh menimbulkan pertanyaan tentang waktu, ketepatan, dan arti percakapan alami.
Ucapkan “Tidak apa-apa” dengan lega, lalu ulangi setelah jeda panjang dengan nada datar. Kata-katanya sama. Percakapannya berubah.
Block memperkenalkan Dessa pada 23 Oktober 2026 sebagai model yang dilatih dari percakapan manusia tanpa teks atau model pralatih. Perusahaan di balik Square dan Cash App menyebutnya sistem dupleks penuh: dapat mendengar sambil berbicara. Ini pratinjau riset dengan rekaman publik dan akses terbatas bagi peneliti keselamatan, bukan API suara yang tersedia umum.
Yang menarik adalah apa yang terjadi ketika waktu dan ekspresi vokal menjadi bahan belajar sejak awal. Artikel ini menjelaskan perbedaannya, menawarkan cara mendengarkan demo, dan membahas tiga pekerjaan yang membutuhkan perilaku percakapan. Menurut kami, sistem suara berguna berikutnya harus menangani ruang di antara kata dengan kehati-hatian yang sama seperti kata itu sendiri.
Gambar utama: ilustrasi editorial orisinal tentang ujaran dan waktu percakapan. Bukan instalasi Dessa atau jejak audio hasil pengukuran.
Ujaran memuat informasi yang bisa hilang dari transkrip rapi
Transkrip membuat percakapan dapat dicari, dikutip, dan diperiksa. Namun biasanya representasinya lebih sempit daripada rekaman. Penekanan, jeda, tumpang tindih, dan bunyi nonverbal memengaruhi penafsiran kalimat.
Bayangkan percakapan penjadwalan. Seseorang berkata “Kamis bisa”, lalu segera menambahkan “Tunggu, setelah makan siang”. Asisten perlu menyimpan koreksi dan tidak menganggap klausa pertama sebagai instruksi selesai. Waktu koreksi penting karena sistem mungkin sudah menyiapkan jawaban.
“Mm-hm” singkat bisa berarti “saya masih mendengar”, bukan “saya ingin mengambil giliran”. Memperlakukan setiap bunyi sebagai giliran penuh membuat interaksi melelahkan. Mengabaikan semua sela singkat bisa melewatkan koreksi sungguhan.
Ini masalah ritme percakapan: kapan melanjutkan, menunggu, mengakui, atau mengalah. Suara sintetis yang lebih ekspresif tidak cukup. Sistem juga harus menentukan aliran pertukaran.
Peneliti Moshi, diterbitkan pada 2024, secara eksplisit membahas ujaran bertumpang tindih dan interjeksi sebagai batas sistem giliran tersegmentasi. Ini konteks penting karena dialog dupleks penuh mendahului Dessa. Klaim khas Block adalah pelatihan hanya dari ujaran, yang harus dinilai terpisah dari kemampuan mendengar dan berbicara sekaligus.
Tiga pertanyaan mencegah tiga kemampuan tercampur
“Natif suara” dapat merujuk data latihan, informasi antar komponen saat berjalan, atau waktu interaksi. Kemajuan pada satu dimensi tidak otomatis menyelesaikan yang lain.
Tabel ini memisahkannya untuk membaca pengumuman produk. Ini perbandingan konsep, bukan peringkat benchmark atau penjelasan lengkap implementasi internal model.
| Pertanyaan | Hal yang ditanyakan | Yang belum dibuktikan sendiri |
|---|---|---|
| Apa bahan latihan model? | Ujaran, teks, atau keduanya | Ketepatan tugas atau bahasa tertentu |
| Apa yang diproses saat berjalan? | Audio langsung atau melalui representasi lain | Keluwesan menangani interupsi |
| Bisakah masukan dan keluaran bertumpang tindih? | Mendengar saat menghasilkan ujaran | Ketepatan membaca emosi atau maksud |
Halaman Dessa, diperiksa 27 Oktober 2026, menyatakan ketiga dimensi: belajar dari ujaran saja, interaksi audio-ke-audio, dan waktu dupleks penuh. Itu deskripsi tim, bukan skor terbit untuk kualitas setiap percakapan yang mungkin dialami pengguna.
Moshi memperjelas manfaat pembedaan. Makalahnya menjelaskan sistem ujaran-teks dupleks penuh yang dibangun dari model bahasa teks. Jalur belajarnya berbeda dari deskripsi Dessa, meski sama-sama menangani dialog bertumpang tindih. Menyebut semua sistem suara sebagai pipeline transkripsi akan menghapus perbedaan itu.
Tim produk sebaiknya bertanya dimensi mana yang penting bagi pekerjaan. Arsip yang dapat dicari memerlukan catatan teks andal. Tutor interaktif membutuhkan umpan balik berguna dan tempo sesuai. Agen pelanggan juga perlu pengetahuan serta wewenang untuk menyelesaikan tugas bisnis.
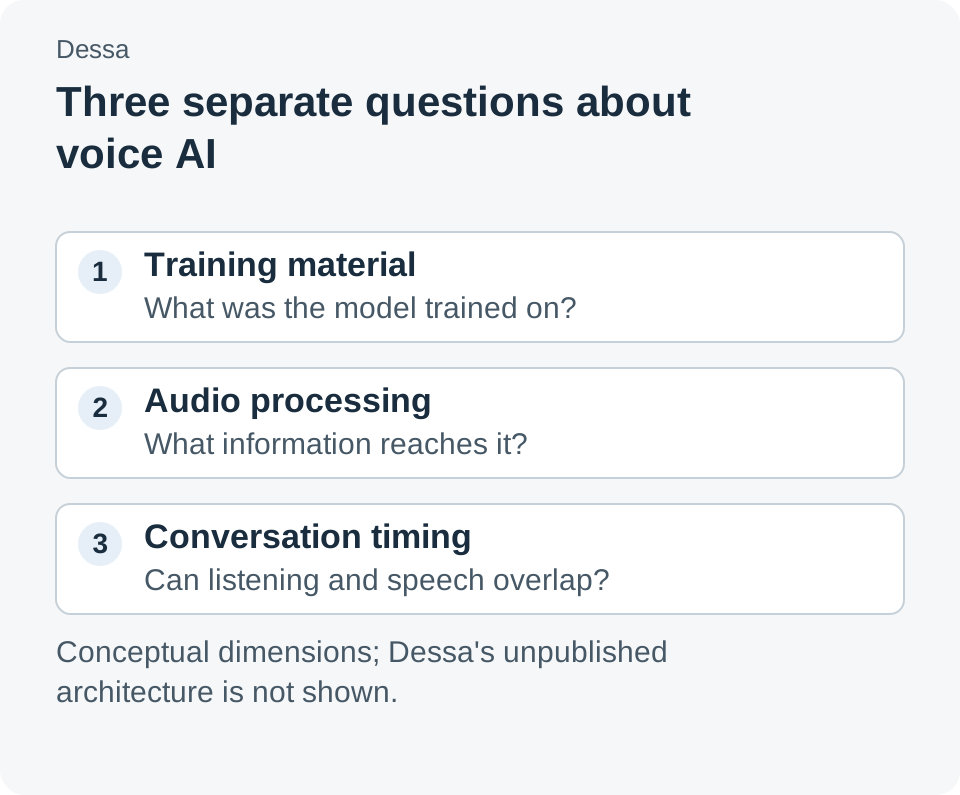
Diagram orisinal yang memisahkan pertanyaan, bukan mengungkap arsitektur Dessa yang belum diterbitkan. Sumber: halaman Dessa Block dan makalah Moshi 2024.
Suara meyakinkan dan jawaban benar membutuhkan tes berbeda
Jawaban ekspresif mudah diikuti, tetapi dapat membuat klaim tanpa dukungan lebih persuasif. Pendengar yang merasa dipahami mungkin lebih jarang berhenti untuk memeriksa rincian.
Karena itu empati yang dirasakan, ketepatan fakta, dan penyelesaian tugas perlu kriteria sendiri. Pengakuan ramah dapat sesuai meski informasi belum cukup. Dalam situasi itu, pertanyaan jelas pada waktu tepat sering lebih baik daripada tebakan dengan emosi yang dipoles.
Bayangkan layanan pelanggan tentang paket terlambat. Penelepon frustrasi dan menyela untuk memperbaiki nomor pesanan. Sistem berguna menerima koreksi, menyimpan pengenal benar, dan menjelaskan langkah tersedia. Nada hangat tidak memperbaiki pencarian salah atau janji tanpa wewenang.
Hal yang sama berlaku saat pembicara terdengar ragu. Jeda bisa berarti keraguan, mencari kata, gangguan ruangan, atau giliran selesai. Audio memberi petunjuk, tetapi makna bergantung pada konteks. Evaluasi masuk akal menghargai klarifikasi ketika sinyal ambigu.
Block mengundang kelompok peneliti keselamatan terbatas untuk memeriksa Dessa. Itu menjelaskan tahap sekarang, bukan membuktikan bahwa sistem memenuhi keandalan layanan pelanggan, pendidikan, atau penerapan lain.
Demo resmi adalah latihan mendengar, bukan papan skor
Halaman publik menyajikan rekaman pilihan, termasuk diskusi rilis dan kenangan film. Perusahaan mengatakan model memilih jawabannya dan subtitel ditambahkan sesudahnya. Rekaman menunjukkan contoh perilaku, tidak frekuensinya pada pengujian luas.
Dengarkan waktunya sebelum membaca subtitel. Kapan jawaban dimulai? Apakah pengakuan mendukung giliran manusia atau bersaing? Apakah pembicara diberi ruang mengoreksi diri?
Lalu periksa isi. Nilai klaim fakta terpisah dari kualitas penyampaian. Tempo sangat baik masih dapat disertai kesalahan. Pemisahan mencegah demo menyenangkan menggantikan bukti tentang tugas.
Terakhir, amati pemulihan. Salah paham menjadi informatif ketika dikoreksi pembicara. Apakah masalah selesai atau sistem bertahan pada tafsiran awal? Satu pemulihan tidak menetapkan tingkat keberhasilan, tetapi membantu merancang evaluasi nanti.
Batas latihan juga jelas. Rekaman pilihan tidak memberi kendali atas prompt, lingkungan, atau pengulangan. Gunakan untuk merumuskan pertanyaan uji, bukan menjawab semua pertanyaan penerapan sebelumnya.
Tiga kemungkinan penggunaan menunjukkan pentingnya waktu
Skenario berikut adalah ilustrasi penerapan kemampuan percakapan, bukan pelanggan Dessa yang diumumkan atau klaim dukungan integrasi dalam pratinjau. Masing-masing memisahkan perilaku menarik dari pekerjaan agar dapat diandalkan.
Teman latihan bahasa bisa menunggu saat pelajar ragu dan mengakui koreksi yang berhasil. Evaluasi perlu membedakan dorongan berguna dari interupsi yang menghambat latihan. Bukti bahasa sasaran, kualitas koreksi, dan penanganan kesalahan berulang tetap diperlukan; demo Inggris alami tidak menjawabnya.
Asisten latihan berbicara bisa membantu presentasi atau percakapan sulit. Ia perlu membiarkan pikiran selesai, bertanya lanjut, dan mengikuti instruksi yang berubah. Tim harus memilih apakah sasaran latihan, umpan balik, atau bimbingan fakta karena rubriknya berbeda.
Antarmuka triase layanan bisa mendengar penjelasan, mengklarifikasi, dan menyimpan koreksi tanpa memulai ulang. Tantangannya menghubungkan percakapan ke kasus serta tindakan tepat. Pengetahuan, autentikasi, eskalasi, dan izin transaksi tetap tanggung jawab sistem yang terpisah.
Polanya sama: percakapan lancar mengurangi hambatan menuju keputusan. Nilai bergantung pada kegunaan keputusan dan apakah pengguna bisa mengoreksi. Penanganan interupsi serta pemulihan adalah kebutuhan produk praktis, bukan detail demo saja.
Eksekusi lokal merupakan klaim perangkat keras dengan syarat akses
Block mengatakan Dessa berjalan lokal pada MacBook Pro M4 Max atau lebih baik dan pelatihannya memakai satu NVIDIA GB200 NVL72. Keduanya berasal dari halaman proyek resmi, diakses 27 Oktober 2026. Ini laporan pengembang, bukan pengukuran instalasi kami.
Pelatihan dan inferensi harus dibedakan. Mesin untuk melatih dan mesin untuk menjalankan model jadi menjawab pertanyaan berbeda. Perangkat latihan bukan kebutuhan konsumen, dan pernyataan laptop bukan matriks memori serta latensi yang diterbitkan.
Akses adalah hal lain. Halaman masih menandai tautan peluncuran sebagai segera hadir dan menjelaskan akses awal bagi peneliti terpilih. Tidak ada harga API umum, bobot unduhan, atau tabel bahasa untuk dasar peluncuran produksi.
Pengembang dapat menentukan pertanyaan yang perlu dipantau, tetapi belum bisa menjadwalkan migrasi dari sistem lama. Rencana andal memerlukan artefak yang dapat digunakan, rincian integrasi, pengukuran di perangkat sasaran, dan dukungan jelas.
Susun evaluasi yang mencakup diam dan koreksi
Jika uji lebih luas tersedia, mulai dengan tugas yang hasil benarnya mudah diperiksa. Pakai skenario sama antar sistem dan simpan audio yang diperlukan untuk memahami perselisihan dengan persetujuan peserta. Prosedur ini usulan, bukan eksperimen artikel.
- Definisikan hasil yang diinginkan. Untuk jadwal, tulis tanggal dan waktu; untuk latihan, tentukan umpan balik. Jangan hanya memakai skor “terdengar manusia”.
- Buat pasangan skenario. Pertahankan permintaan serupa dan ubah satu kejadian: jeda, pengakuan, interupsi, atau koreksi eksplisit. Sumber kegagalan lebih mudah dibahas.
- Masukkan instruksi pemulihan. Minta koreksi detail sebelumnya. Periksa jawaban akhir dan kejelasan perubahan dalam percakapan.
- Nilai waktu dan isi terpisah. Catat interupsi tidak tepat, koreksi terlewat, dan fakta tanpa dukungan. Skor gabungan bisa menyembunyikan kelemahan.
- Uji lingkungan sasaran. Ketika akses memungkinkan, ulangi tugas representatif pada perangkat dan audio sebenarnya. Tes mikrofon sunyi hanya membuktikan konfigurasi itu, bukan semua ruangan atau headset.
- Tinjau perbedaan lewat audio. Putar ulang momen dan perbaiki rubrik. Perbedaan bisa menunjukkan definisi tugas tidak jelas, bukan sekadar model salah.
Contoh awal dapat berisi 12 skenario: empat dengan jeda, empat koreksi, empat pengakuan singkat. Itu saran awal, bukan klaim kecukupan ilmiah atau benchmark Dessa yang diterbitkan. Tujuannya membuka tuntutan percakapan berbeda sebelum memperbesar skala.
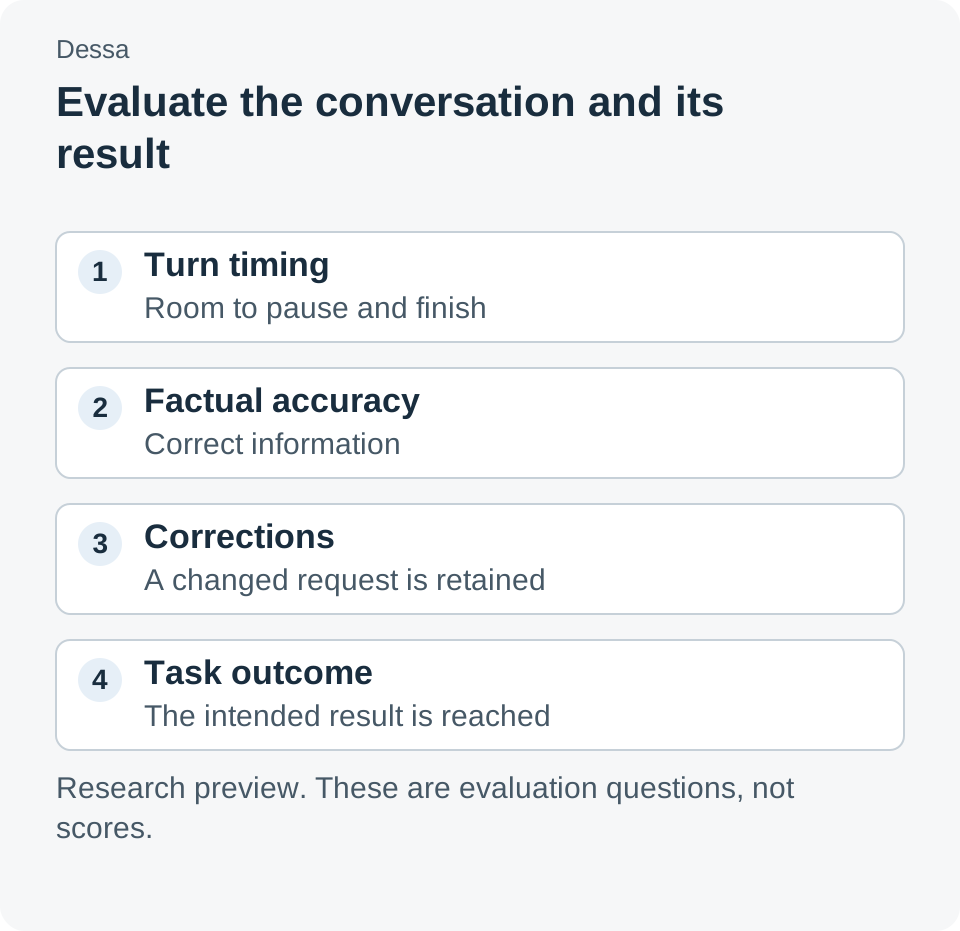
Panduan orisinal. Tidak menyiratkan tingkat sukses, latensi, atau skor perbandingan model terukur.
Antarmuka suara seharusnya membuat koreksi terasa biasa
Janji paling berguna bukan membuat setiap asisten tak terbedakan dari manusia. Janjinya mengurangi usaha menyesuaikan ujaran dengan antarmuka kaku. Jeda, sela, dan pikiran belum selesai adalah bagian biasa berbicara.
Dessa memberi objek riset konkret: model yang menurut pembuatnya belajar hanya melalui ujaran. Pertanyaan berikutnya ialah apakah perilakunya bertahan pada situasi yang dibutuhkan. Antarmuka baik memudahkan melanjutkan, mengklarifikasi, dan mengoreksi sambil menjaga tugas tetap dipahami.
Sumber
- Block: Dessa — riset, demo, perangkat keras, akses resmi; diperiksa 27 Oktober 2026.
- Berita Block — pengumuman 23 Oktober 2026.
- Défossez dan rekan: Moshi, a speech-text foundation model for real-time dialogue — riset primer 2024 tentang dialog ujaran-teks dupleks penuh.
Sumber diperiksa 27 Oktober 2026. Detail produk diatribusikan kepada penerbit. Skenario dan langkah bersifat ilustratif; kami tidak memasang Dessa atau mengukur performanya. Rekaman resmi tersedia di halaman proyek.
Rekomendasi dari Telli.sh
Ingin tempat yang dapat dicari untuk rekaman, catatan referensi, dan keputusan sesudah percakapan? Kumpulkan referensi di Telli.sh agar serah terima tetap mudah dipahami.