DDR4 เก่าจะช่วยให้เซิร์ฟเวอร์ AI มีหน่วยความจำเหลือมากขึ้นได้ไหม?
Netlist และ Marvell เตรียมนำอุปกรณ์ CXL ที่ใช้ DDR4 ไปงาน SC26 มาดูว่าหน่วยความจำฝั่งโฮสต์ที่เพิ่มขึ้นช่วยตรงไหน และควรวัดอะไรก่อนซื้อ
ระบบค้นหาภายในตอบสนองเร็วดีจนถึงช่วงงานแน่นตอนเช้า ระบบต้องดึงข้อความจากเอกสารหลายพันฉบับก่อนส่งคำขอให้ GPU สร้างคำตอบ ข้อความที่ใช้บ่อยเก็บในหน่วยความจำได้ แต่เมื่อมีคนค้นส่วนอื่นของคลังเอกสารซ้ำ ระบบต้องกลับไปอ่านจากสตอเรจ ผู้ใช้จึงรอนานขึ้นทั้งที่ตัวเร่งยังมีกำลังเหลือ สำหรับทีมที่ดูแลบริการ แคชบนเซิร์ฟเวอร์ที่ใหญ่ขึ้นอาจช่วยได้มากกว่าซื้อ GPU เพิ่ม
ประกาศสองฉบับก่อนงาน SC26 ชี้ให้เห็นอีกวิธีในการเพิ่มแคช เมื่อวันที่ 10 พฤศจิกายน CXL Consortium ระบุว่า Netlist บริษัทด้านหน่วยความจำ เตรียมสาธิตต้นแบบพิสูจน์แนวคิดชื่อ NVvault-D4 ซึ่งนำ DDR4 ที่มีอยู่มาใช้เพิ่มหน่วยความจำฝั่งโฮสต์ผ่าน Compute Express Link หรือ CXL วันที่ 13 พฤศจิกายน Marvell ผู้ผลิตชิป ประกาศว่าพาร์ตเนอร์จะนำระบบที่ใช้ตัวควบคุมขยายหน่วยความจำในตระกูล Structera X พร้อม DDR4 และ DDR5 มาแสดง ทั้งสองประกาศกล่าวถึงฮาร์ดแวร์ที่เตรียมจัดแสดง ส่วนราคา กำหนดส่งมอบ และผลการสาธิตยังรอการยืนยัน งาน SC26 จัดที่ชิคาโกระหว่างวันที่ 15–20 พฤศจิกายน โดยช่วงจัดแสดงตามปกติคือวันที่ 17–19 พฤศจิกายนตามเวลาท้องถิ่น ตัวอย่างงานของ Netlist จาก CXL Consortium · ประกาศ SC26 ของ Marvell · กำหนดการ SC26 อย่างเป็นทางการ
คำถามสำหรับผู้ซื้อคือ ความจุที่เพิ่มขึ้นจะเก็บข้อมูลที่งานต้องใช้ไว้ในหน่วยความจำได้มากพอ โดยยังรักษาเวลาตอบสนองของคำขอที่ช้าที่สุดได้หรือไม่ ทีมที่มี DDR4 เหลืออาจลดต้นทุนได้ หากโมดูลผ่านการรับรองและระบบจัดข้อมูลที่เหมาะสมไปเก็บในหน่วยความจำนั้น ความคุ้มค่าขึ้นอยู่กับว่าตอนนี้งานส่วนไหนกำลังรอ และรออยู่ที่ขั้นตอนใด
หน่วยความจำที่เพิ่มขึ้นอยู่ตรงไหน
CPU เข้าถึง DRAM ที่ต่อโดยตรงผ่านตัวควบคุมหน่วยความจำของตัวเองได้ เมื่อเซิร์ฟเวอร์กับอุปกรณ์ขยายหน่วยความจำ CXL ใช้งานร่วมกันได้ CPU ยังเข้าถึงหน่วยความจำหลังอุปกรณ์นั้นผ่านลิงก์ CXL ได้ด้วย ส่วนขยายจึงเพิ่มพื้นที่เก็บข้อมูลฝั่งโฮสต์ เส้นทาง แบนด์วิดท์ และความหน่วงต่างจากช่องทางของ DRAM ที่ต่อโดยตรง เฟิร์มแวร์กับระบบปฏิบัติการต้องแสดงพื้นที่ส่วนนี้ให้ระบบใช้ได้ และแอปพลิเคชันหรือระบบปฏิบัติการต้องมีนโยบายจัดวางหน้าหน่วยความจำให้เหมาะกับงาน
เรื่องนี้สำคัญเมื่อมีข้อเสนอให้นำ DDR4 ที่เก็บไว้มาใช้กับเซิร์ฟเวอร์รุ่นใหม่ เซิร์ฟเวอร์ยังใช้ DDR5 ที่ต่อโดยตรงได้ พร้อมเข้าถึง DDR4 ผ่านอุปกรณ์ขยายที่รองรับ ตัวควบคุมของอุปกรณ์ รายชื่อโมดูลที่ผ่านการรับรอง และความเข้ากันได้ของโฮสต์ยังต้องตรวจสอบ ต้นแบบที่ใช้ DDR4 ที่มีอยู่ทำให้แนวทางนำกลับมาใช้น่าศึกษา ส่วนรุ่นโมดูลที่ระบบรองรับและเครื่องที่จะใช้งานได้อย่างเสถียรยังต้องยืนยัน
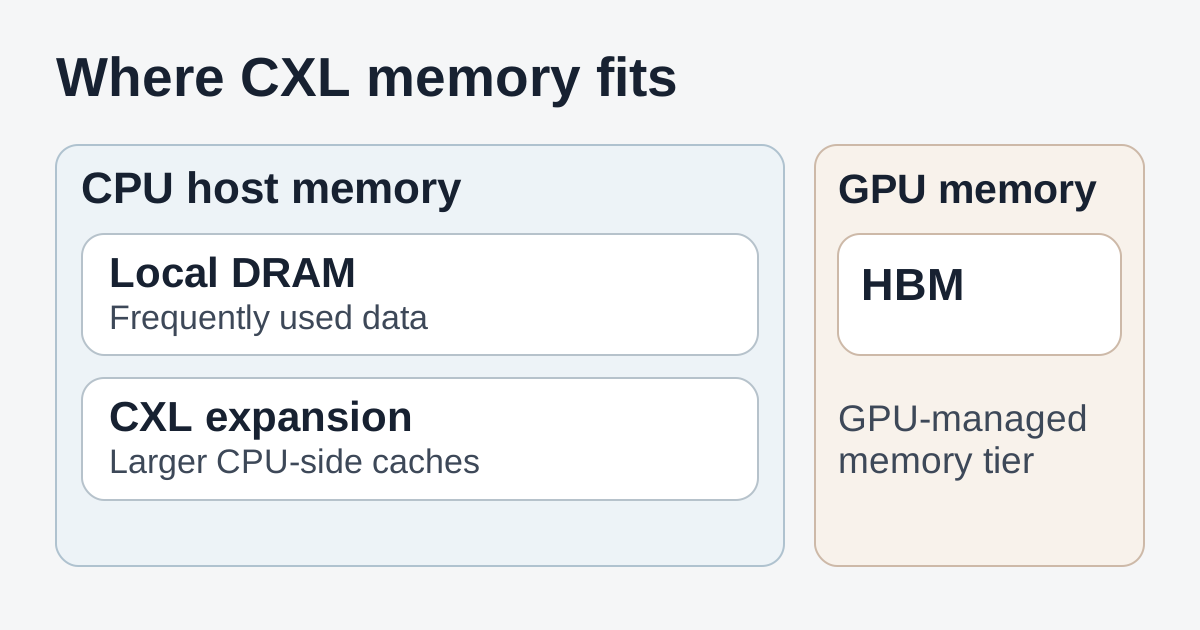
DRAM ที่ต่อโดยตรงเก็บหน้าหน่วยความจำที่เรียกใช้บ่อยได้ ส่วนชั้นขยายรองรับแคชฝั่ง CPU ที่มีขนาดใหญ่ขึ้น หน่วยความจำแบนด์วิดท์สูงของตัวเร่งมีข้อจำกัดด้านความจุและแบนด์วิดท์ของตัวเอง
ในตัวอย่างระบบค้นหา ทีมอาจเก็บข้อมูลดัชนีที่อ่านบ่อยไว้ใน DDR5 ที่ต่อโดยตรง แล้ววางแคชขนาดใหญ่ที่เก็บข้อความหรือผลค้นหาที่เรียกใช้น้อยกว่าไว้ในชั้น CXL เมื่อระบบพบข้อความที่ตรงกับคำค้น ส่วนประมวลผลโมเดลจะส่งข้อความนั้นให้โมเดลบน GPU น้ำหนักของโมเดลและข้อมูลที่เคอร์เนลของตัวเร่งต้องใช้ยังต้องอยู่ในพื้นที่ที่เอนจินเรียกใช้โมเดลอ่านได้ตามที่ออกแบบไว้ ชั้นขยาย CXL ในประกาศเหล่านี้เพิ่มความจุฝั่งโฮสต์ ส่วนหน่วยความจำแบนด์วิดท์สูงของ GPU หรือ HBM เป็นทรัพยากรแยกกัน
เริ่มจากบันทึกเวลาในแต่ละขั้นตอนของคำขอ ถ้า CPU ต้องรอข้อมูลที่ถูกขับออกจากแคชซ้ำ ๆ การเพิ่มหน่วยความจำฝั่งโฮสต์อาจลดการอ่านจากสตอเรจ แต่ถ้าโมเดลใช้เวลาส่วนใหญ่อ่านค่าน้ำหนักจากหน่วยความจำ GPU และฝั่งโฮสต์แทบไม่ติดขัด การซื้อแบบเดียวกันอาจช่วยลดเวลารอคำตอบได้น้อย ขั้นตอนดึงข้อมูลที่เร็วขึ้นมีผลต่อเวลารอได้แม้โมเดลจะยังทำงานด้วยความเร็วเท่าเดิม วัดทั้งสองส่วนก่อนระบุว่าส่วนใดทำให้เวลาตอบสนองของบริการเปลี่ยนไป
ต้นแบบสามแบบของ Netlist เหมาะกับงานคนละประเภท
NVvault-D4 เป็นรุ่นที่ควรติดตามหากสนใจนำ DDR4 กลับมาใช้ CXL Consortium ระบุว่างานเป้าหมายได้แก่ เครื่องเสมือน ฐานข้อมูลในหน่วยความจำ การประมวลผลสมรรถนะสูง และงานระดับองค์กร ลองนึกถึงโฮสต์เครื่องเสมือน ทีมอาจเก็บเครื่องเสมือนที่ทำงานหนักที่สุดไว้ในหน่วยความจำที่ต่อโดยตรง แล้วทดสอบว่าหน้าหน่วยความจำของเครื่องที่ทำงานน้อยกว่าย้ายไปอยู่ในชั้นขยายได้หรือไม่ ทีมฐานข้อมูลอาจทดลองแนวทางเดียวกันกับบางส่วนของแคชสำหรับการอ่าน ฐานข้อมูลต้องมีนโยบายจัดสรรที่ให้หน้าที่คำค้นไวต่อความหน่วงเรียกใช้ยังอยู่ใกล้ CPU ทั้งคู่เป็นแนวทางทดลองสำหรับต้นแบบที่เน้นความจุ ประกาศยังไม่มีผลทดสอบระดับภาระงาน ตัวอย่างงานของ Netlist จาก CXL Consortium
ต้นแบบอีกสองแบบของ Netlist แสดงให้เห็นว่าชื่อรุ่นมีความสำคัญ NVvault-HM ใช้ DRAM เป็นแคชหน้าพื้นที่ความจุที่ใช้ NAND ประกาศกล่าวถึงการย้ายข้อมูลและข้อมูลเฝ้าระวัง พร้อมตัวอย่างงานอย่างแคชคีย์–ค่าของ AI และการวิเคราะห์ข้อมูล ส่วน NVvault-PM เป็นอีกแบบหนึ่งที่ใช้ CXL Type 3 โดยประกาศระบุว่ามี DRAM, NAND สำหรับสำรองข้อมูล และแหล่งพลังงานในตัวเพื่อรับมือไฟดับ ตัวอย่างงานสำหรับ PM ได้แก่ การเก็บแคชคีย์–ค่า การบันทึกจุดตรวจสอบ และการกู้คืน ทีมที่ประเมินระบบสำรองข้อมูลหรือการเก็บข้อมูลข้ามเหตุขัดข้องต้องขอรายละเอียดว่ารุ่นนั้นทำงานอย่างไรในสถานการณ์ที่ทีมต้องรับมือ ส่วน D4 ต้องประเมินจากคุณสมบัติที่ประกาศสำหรับรุ่นนั้นโดยเฉพาะ ตัวอย่างงานของ Netlist จาก CXL Consortium
แคชคีย์–ค่าของโมเดลภาษาเป็นตัวอย่างการทดลอง AI อีกกรณีหนึ่ง แคชนี้เก็บข้อมูล attention จากโทเคนก่อนหน้าไว้ให้โมเดลใช้ซ้ำ เอนจินที่รองรับการย้ายข้อมูลออกไปไว้ฝั่งโฮสต์อาจย้ายหน้าของเซสชันที่พักอยู่จากหน่วยความจำ GPU แล้วโหลดกลับเมื่อผู้ใช้กลับมา ทีมจึงทดลองได้ว่าความจุฝั่งโฮสต์ที่เพิ่มขึ้นช่วยเก็บเซสชันได้มากขึ้นหรือไม่ และการโอนข้อมูลเพิ่มเวลาตอบคำขอเมื่อกลับมาใช้เซสชันเท่าไร วิธีจัดวางและคัดลอกขึ้นกับเอนจินและเซิร์ฟเวอร์ นี่เป็นการทดลองที่อาจทำได้กับโฮสต์ที่แบ่งหน่วยความจำเป็นชั้น ตัวอย่างแคชคีย์–ค่าที่ Netlist ระบุโดยตรงในประกาศเป็นของ HM และ PM
ประกาศจาก Marvell เปิดอีกแนวทางให้ผู้ซื้อติดตาม พาร์ตเนอร์เตรียมนำระบบที่ใช้ตัวควบคุมในตระกูล Structera X พร้อม DDR4 และ DDR5 มาจัดแสดง กำหนดการและชุดข้อมูลสำหรับสื่อช่วยให้เห็นภาพงานกับตระกูลผลิตภัณฑ์ ผู้ซื้อยังต้องตรวจว่าผู้ขายรับรองเซิร์ฟเวอร์แบบใด รองรับหน่วยความจำแบบไหน และดูแลทั้งระบบอย่างไร ภาพชิปในชุดข้อมูลเป็นภาพอ้างอิงของตระกูลผลิตภัณฑ์ กำหนดการบูท SC26 จาก CXL Consortium · ประกาศ SC26 ของ Marvell · ชุดข้อมูลสื่อ Marvell Structera
เริ่มวัดจากคำขอที่ช้า
ค่าเฉลี่ยอาจกลบคำขอที่ทำให้ผู้ใช้รู้สึกว่าแอปช้า ในบริการค้นหา เอกสารยอดนิยมอาจให้ผลเร็วทั้งวัน ขณะที่เอกสารที่มีคนเปิดน้อยทำให้โพรเซสชุดเดียวกันกลับไปอ่านข้อมูลจากชั้นขยายซ้ำ ๆ งานจัดทำดัชนีรอบกลางคืนอาจรับคำขอที่ช้ามากเพิ่มขึ้นได้ แต่ลูกค้าที่รอผลค้นหาอาจสังเกตได้ทันที การออกแบบหน่วยความจำจึงต้องพิสูจน์ตัวเองกับเป้าหมายบริการจริงเมื่อโหลดสูงสุด
ทีมวิจัยอิสระที่ทำงานศึกษา MELODY ในปี 2025 แสดงให้เห็นเรื่องนี้จากการทดสอบภาระงาน 265 แบบ อุปกรณ์หน่วยความจำ CXL จริงสี่ตัว แพลตฟอร์ม CPU ห้าแบบ และความหน่วงเจ็ดระดับ ทีมทดสอบความไวต่อความหน่วงต่ำกว่าหนึ่งไมโครวินาทีในช่วง 140–410 นาโนวินาที และพบว่าชนิดงาน ความหน่วงของการอ่านที่ช้าที่สุด ตลอดจนพฤติกรรมของ CPU มีผลต่อการใช้งานหน่วยความจำ CXL งานวิจัยเรียกอุปกรณ์ขยายที่ทดสอบว่า CXL-A ถึง CXL-D ผลดังกล่าวใช้ประมาณสมรรถนะของระบบที่ประกาศสำหรับงาน SC26 ไม่ได้ งานวิจัยมีประโยชน์กับผู้ซื้อเพราะแสดงว่าความหน่วงเฉลี่ยค่าเดียวหรือผลทดสอบที่ดีเพียงครั้งเดียวยังตอบไม่ได้ว่าเซิร์ฟเวอร์เครื่องหนึ่งจะทำงานอย่างไร งานศึกษา MELODY จาก ASPLOS 2025 · บทความวิจัยฉบับเต็ม
ถ้าแพลตฟอร์มรองรับ ให้เตรียมการทดสอบเปรียบเทียบสามแบบ เริ่มจากรันบริการเดิมบน DRAM ที่ต่อโดยตรงชุดเดิม แล้วเพิ่มความจุด้วยหน่วยความจำแบบแบ่งชั้น สุดท้ายให้ทดสอบแบบที่ความจุรวมเท่ากันและใช้หน่วยความจำต่อโดยตรงทั้งหมด เพื่อให้มีค่าอ้างอิงที่เทียบกันได้ ตัวอย่างเชิงสมมุติคือเทียบ DRAM ที่ต่อโดยตรง 256 GiB บวกกับพื้นที่ขยายที่ใช้ได้ 256 GiB กับ DRAM ที่ต่อโดยตรง 512 GiB ใช้แอปพลิเคชัน ชุดข้อมูล การตั้งค่าซอฟต์แวร์ และปริมาณงานที่ส่งเข้ามาให้ใกล้เคียงกัน พร้อมบันทึกความต่างด้านแพลตฟอร์มหรือช่องทางหน่วยความจำที่เกิดจากการจัดเครื่อง หากทางเลือกในการเดินระบบคือย้ายข้อมูลส่วนเกินลงสตอเรจหรือแบ่งงานไปอีกเครื่อง ให้จับเวลาและคำนวณต้นทุนแบบนั้นด้วย
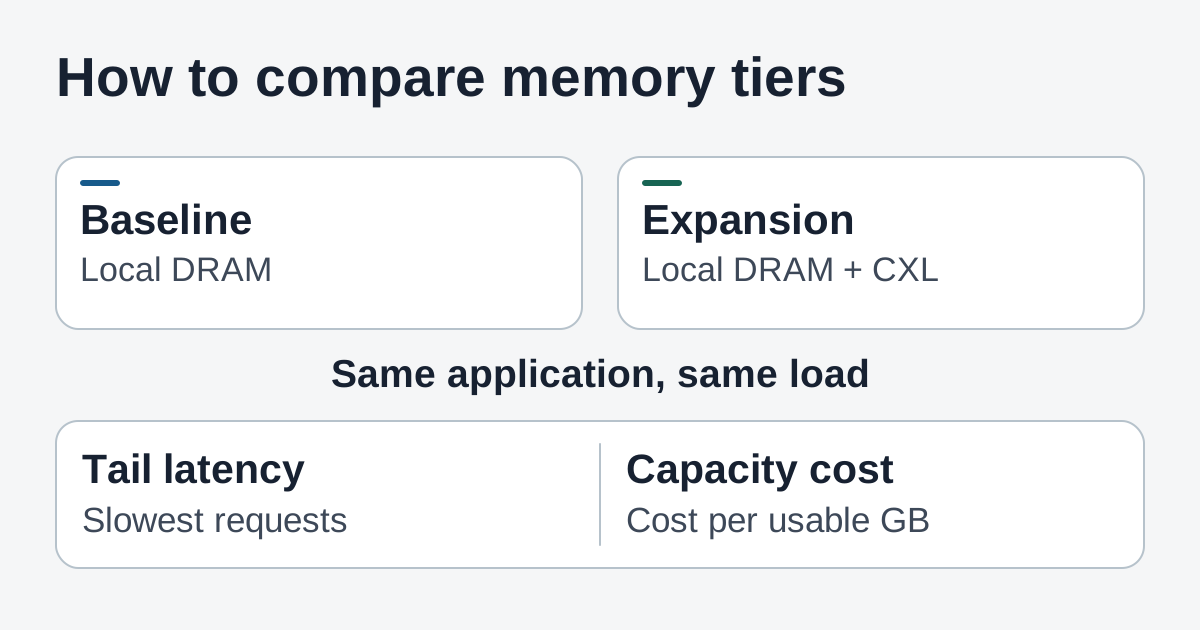
เปรียบเทียบด้วยงานและปริมาณคำขอเดียวกัน ตรวจคำขอที่ช้าที่สุดและคำนวณต้นทุนต่อหน่วยความจุที่ใช้ได้
- เล่นคำขอย้อนหลังให้แคชเต็ม. ใช้ชุดคำขอที่ใกล้การใช้งานจริง ทั้งเอกสารที่เปิดซ้ำและเอกสารที่นาน ๆ เปิดที ทดสอบตั้งแต่เปิดระบบใหม่ และทดสอบอีกครั้งหลังแคชมีข้อมูลแล้ว ดูค่ากลาง ค่า p95 และ p99 ของความหน่วง อัตราผิดพลาด และปริมาณงานที่ทำได้ เมื่อมีคำขอพร้อมกันเท่ากัน สำหรับระบบค้นหาด้วย AI ควรวัดเวลาดึงข้อมูลกับเวลาประมวลผลโมเดลแยกกัน เพื่อเห็นว่าส่วนใดดีขึ้นหรือช้าลง
- ตรวจว่าข้อมูลส่วนใดย้ายจริง. ดูการจัดสรรหน่วยความจำตามชั้นและโหนด NUMA ของ CPU การย้ายและการคืนพื้นที่ของหน้าหน่วยความจำถ้าตรวจได้ รวมถึงตัวนับของลิงก์หรืออุปกรณ์ที่แพลตฟอร์มมีให้ ผลที่ดูดีอาจเกิดจากเกือบทุกคำขอใช้แต่ DRAM ที่ต่อโดยตรง ส่วนผลที่ดูแย่อาจมาจากระบบนำหน้าดัชนีที่อ่านบ่อยไปไว้ในชั้นที่ไกลกว่าโดยปริยาย บันทึกนโยบายการจัดวางไว้กับผลวัดทุกชุด
- ทดสอบช่วงโหลดหนัก. รันงานที่สองระหว่างที่ระบบกำลังรับคำขอแบบโต้ตอบจำนวนมาก อุ่นแคชใหม่หลังรีสตาร์ต และสังเกตเมื่อบริการใกล้ถึงขีดจำกัดหน่วยความจำ ตรวจว่าระบบปฏิบัติการรายงานความผิดปกติของหน่วยความจำหรืออุปกรณ์อย่างไร ทีมปฏิบัติการระบุโฮสต์ที่มีปัญหาได้อย่างไร และบริการจะกลับไปใช้นโยบายจัดสรรเดิมอย่างไร ควรทดสอบการกู้คืนของทุกแบบที่ทีมจะต้องดูแล
- กำหนดเกณฑ์ผ่านก่อนดูกราฟ. เริ่มจากเป้าหมาย p99 และอัตราผิดพลาดที่ทีมใช้อยู่ ระบุความจุที่ต้องเพิ่มและใช้ได้จริงภายใต้เป้าหมายดังกล่าว รวมทั้งกรณีที่ยอมให้ฟื้นตัวช้าลงได้ หากระบบผ่านเฉพาะตอนที่แคชตอบคำขอได้ในสัดส่วนสูง ให้ลองใช้บันทึกจากวันที่งานหนักเป็นพิเศษเพื่อดูว่าสัดส่วนดังกล่าวจะยังทำได้ในระบบจริงหรือไม่
คิดต้นทุนทั้งหมดของการนำหน่วยความจำกลับมาใช้
แรม DIMM ที่มีอยู่ช่วยให้ค่าใช้จ่ายด้านหน่วยความจำในข้อเสนอดูดีขึ้น การจัดซื้อยังต้องมีอุปกรณ์ขยาย โฮสต์หรือชุดอัปเกรดที่รองรับ โมดูลที่ผ่านการรับรอง และเวลาเจ้าหน้าที่สำหรับติดตั้งและดูแล อุปกรณ์ยังต้องใช้สล็อตหรือจุดเชื่อมต่อกับแพลตฟอร์มที่เหมาะสม ตรวจสอบการจัดสรรเลน PCIe ร่วมกับสตอเรจ เครือข่าย และตัวเร่ง การอัปเกรดมีความคุ้มค่าน้อยลงถ้าต้องเสียทรัพยากรที่งานเดียวกันต้องใช้ย้ายข้อมูล
คำนวณต้นทุนต่อ GiB ที่ใช้ได้ตามระดับบริการที่กำหนด รวมความจุที่แพลตฟอร์มกันไว้หรือพื้นที่ที่ต้องเผื่อให้หน้าหน่วยความจำอยู่ในชั้นที่ต่อโดยตรง ค่าไฟและระบายความร้อน การทดสอบรับรองทั้งฝูงเครื่อง อะไหล่ และการดูแลตลอดอายุใช้งานที่วางไว้ ตรวจว่าใครเป็นผู้ส่งอัปเดตเฟิร์มแวร์ และระบบแสดงสถานะอุปกรณ์กับข้อผิดพลาดของหน่วยความจำอย่างไร หากชั้นขยายช่วยให้เครื่องเดียวทำงานปริมาณเท่าเดิมได้โดยลดการย้ายข้อมูลลงสตอเรจหรือความจำเป็นต้องเพิ่มเครื่อง ให้ประเมินงานที่ประหยัดได้และต้นทุนประกอบทั้งสองทาง การทดลองง่าย ๆ คือรันบริการที่อัตราคำขอสูงสุดบนทั้งสองสถาปัตยกรรม แล้วเทียบต้นทุนในการรักษาเวลาตอบสนองให้อยู่ในเป้า
หลังงาน SC26 ควรติดตามชุดที่ผ่านการรับรอง เอกสารรายชื่อโมดูลที่รองรับ ความเข้ากันได้กับซอฟต์แวร์ และบันทึกจากภาระงานจริง ระบบที่วางจำหน่ายอาจเพิ่มทางเลือกให้ทีมที่ต้องเก็บชุดข้อมูลใช้งานรองขนาดใหญ่และอยากขยายเซิร์ฟเวอร์เดิม กรณีที่น่าสนใจที่สุดคือบริการที่เก็บข้อมูลเอกสารได้มากขึ้นฝั่งโฮสต์ ลดการอ่านจากสตอเรจซ้ำ และยังคุม p99 ได้ภายในขีดเดิมด้วยต้นทุนต่ำลง ทีมที่วัดผลแบบนี้ได้จะมีหลักฐานประกอบการซื้อเครื่องถัดไป
แหล่งข้อมูล
- ตัวอย่างงาน SC26 ของ Netlist จาก CXL Consortium วันที่ 10 พฤศจิกายน 2026
- ประกาศเกี่ยวกับพาร์ตเนอร์และการเชื่อมต่อที่ SC26 ของ Marvell วันที่ 13 พฤศจิกายน 2026
- กำหนดการบูทและกราฟิกงาน SC26 จาก CXL Consortium
- ชุดข้อมูลสื่อของตระกูลผลิตภัณฑ์ Marvell Structera
- กำหนดการและวันจัดแสดงของ SC26 อย่างเป็นทางการ
- งานศึกษา MELODY และข้อมูลตีพิมพ์ ASPLOS 2025 · บทความวิจัยฉบับเต็ม
หากต้องการเก็บบันทึกการทดลอง บันทึกภาระงาน และข้อมูลการตัดสินใจซื้อไว้ด้วยกัน สร้างบัญชี Telli.sh