Bisakah DDR4 lama memberi server AI ruang lebih lega?
Netlist dan Marvell membawa rancangan CXL berbasis DDR4 ke SC26. Simak kapan tambahan memori host berguna dan apa yang sebaiknya diukur sebelum membelinya.
Layanan pencarian internal terasa cepat sampai permintaan menumpuk di pagi hari. Sistem harus mengambil kutipan dari ribuan dokumen sebelum meneruskan permintaan jawaban ke GPU. Kutipan yang sering dipakai muat di memori, tetapi pencarian berulang pada bagian lain koleksi masih harus membaca penyimpanan. Orang menunggu lebih lama meski akselerator masih punya kapasitas. Bagi tim pengelola layanan itu, cache server yang lebih besar bisa lebih berguna daripada GPU tambahan.
Dua pengumuman menjelang SC26 menunjukkan cara lain untuk menambah cache tersebut. Pada 10 November, CXL Consortium mengatakan bahwa spesialis memori Netlist berencana menunjukkan bukti konsep bernama NVvault-D4, yang memanfaatkan DDR4 yang sudah ada sebagai tambahan memori host melalui Compute Express Link, atau CXL. Pada 13 November, pembuat cip Marvell mengumumkan pameran mitra menggunakan pengendali ekspansi memori Structera X bersama DDR4 dan DDR5. Pengumuman tersebut menjelaskan perangkat keras yang disiapkan untuk pameran, sementara harga, tanggal pengiriman, dan hasil demonstrasi masih belum diketahui. SC26 berlangsung pada 15–20 November di Chicago, dan pameran reguler digelar pada 17–19 November waktu setempat. Pratinjau Netlist dari CXL Consortium · Pengumuman SC26 dari Marvell · Jadwal resmi SC26
Bagi pembeli, pertanyaannya adalah apakah kapasitas tambahan menampung cukup banyak data yang berguna tanpa memperlambat permintaan terlama melebihi batas yang bisa diterima. Jika tim memiliki cadangan DDR4, penggunaan kembali bisa menguntungkan jika modul memenuhi syarat dan sistem mampu menempatkan data yang tepat di sana. Nilainya bergantung pada proses mana yang saat ini harus menunggu dan di mana waktu itu habis.
Di mana memori tambahan berada
CPU dapat mengakses DRAM yang terpasang lokal melalui pengendali memorinya. Pada server dan perangkat ekspansi memori CXL yang kompatibel, CPU juga dapat mengakses memori di belakang perangkat tersebut melalui tautan CXL. Ekspansi menambah tempat menyimpan data di sisi host. Jalur, bandwidth, dan latensinya berbeda dari kanal DRAM lokal. Firmware dan sistem operasi harus menyediakan kapasitas tersebut untuk digunakan, sedangkan aplikasi atau sistem operasi perlu menerapkan kebijakan penempatan halaman yang sesuai dengan beban kerja.
Hal ini penting saat seseorang mengusulkan pemasangan stok DDR4 pada server yang lebih baru. Server dapat mempertahankan DDR5 lokal dan menjangkau DDR4 melalui perangkat ekspansi yang didukung. Pengendali perangkat, kualifikasi modul, dan kompatibilitas host tetap berpengaruh. Bukti konsep yang memanfaatkan DDR4 yang sudah ada memberi alasan untuk menyelidiki penggunaan kembali. Modul apa yang bisa diterima dalam konfigurasi yang didukung dan sistem mana yang dapat menjalankannya secara andal masih harus dipastikan.
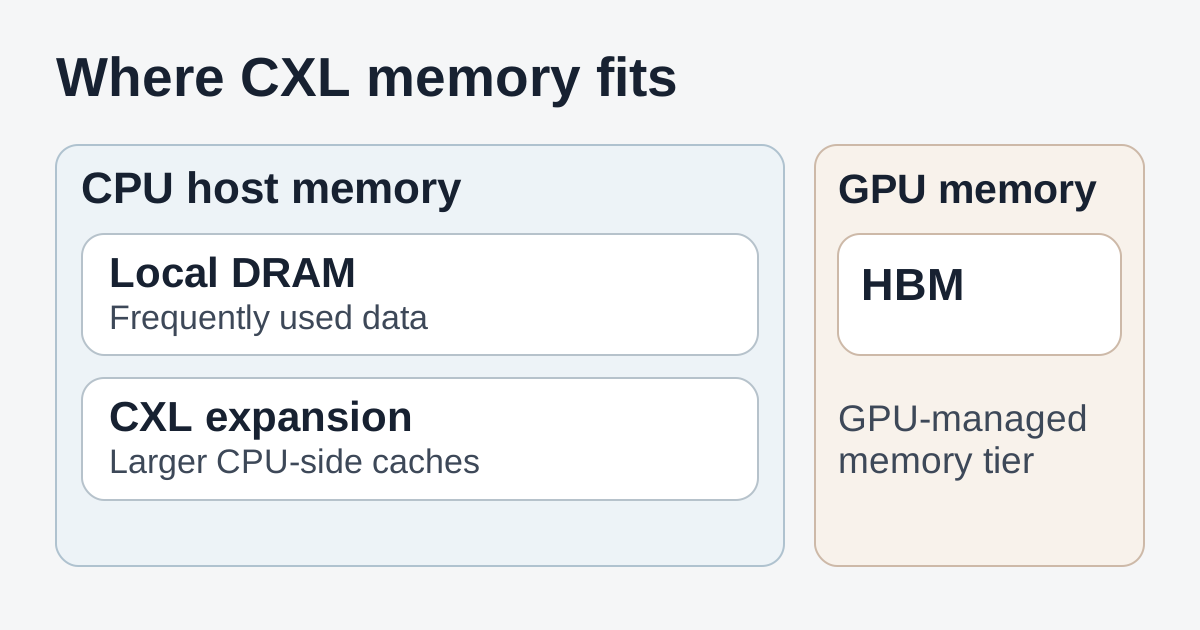
DRAM lokal dapat menyimpan halaman yang sering diakses, sementara lapisan ekspansi menampung cache sisi CPU yang lebih besar. Memori berbandwidth tinggi milik akselerator memiliki batas kapasitas dan bandwidth tersendiri.
Pada contoh pencarian tadi, tim bisa menempatkan indeks yang sering dibaca di DDR5 lokal dan memindahkan cache kutipan atau hasil pencarian yang lebih besar serta jarang dibaca ke lapisan CXL. Ketika layanan menemukan kutipan yang tepat, sistem inferensi meneruskannya ke model yang berjalan di GPU. Bobot model dan data yang dibutuhkan kernel akselerator tetap harus muat di tempat mesin inferensi mengaksesnya. Ekspansi CXL pada pengumuman ini menambah kapasitas memori host. Memori berbandwidth tinggi GPU, atau HBM, tetap merupakan sumber daya tersendiri.
Mulailah dengan menelusuri waktu yang dihabiskan tiap permintaan. Apabila CPU berulang kali menunggu data yang sudah dikeluarkan dari cache, tambahan memori host bisa mengurangi akses penyimpanan. Apabila model menghabiskan sebagian besar waktunya membaca bobot dari memori GPU dan host jarang tersendat, pembelian yang sama mungkin tidak banyak mempercepat jawaban. Pengambilan data yang lebih cepat tetap bisa berarti meski kecepatan model tidak berubah. Ukur keduanya sebelum mengaitkan perubahan kinerja layanan dengan salah satunya.
Tiga prototipe Netlist menargetkan pekerjaan berbeda
Untuk penggunaan kembali DDR4, perhatikan NVvault-D4 dari Netlist. Konsorsium menyebut mesin virtual, basis data dalam memori, komputasi berkinerja tinggi, dan beban kerja perusahaan sebagai sasaran. Host virtualisasi memberi contoh konkret. Mesin virtual yang paling sibuk bisa tetap memakai memori lokal sambil tim menguji apakah halaman yang lebih jarang diakses dapat ditempatkan di lapisan ekspansi. Tim basis data bisa mencoba prinsip yang sama pada bagian tertentu dari cache pembacaan. Basis data akan memerlukan kebijakan alokasi yang mempertahankan halaman untuk kueri peka latensi di dekat CPU. Ini adalah kemungkinan uji coba untuk rancangan penambahan kapasitas. Pratinjau tidak memberi hasil pengujian pada beban kerja tertentu. Pratinjau Netlist dari CXL Consortium
Dua rancangan Netlist lainnya menunjukkan mengapa nama produk perlu dibedakan. NVvault-HM memakai cache DRAM di depan kapasitas berbasis NAND, dan pengumuman membahas perpindahan data dan telemetri serta penggunaan seperti cache key-value AI dan analitik. NVvault-PM adalah rancangan CXL Type 3 tersendiri dengan DRAM, cadangan NAND, dan sumber energi internal untuk menangani putusnya daya. Pratinjau menempatkan PM pada penggunaan seperti mempertahankan cache key-value, menyimpan checkpoint, dan pemulihan. Tim yang menilai pencadangan atau persistensi membutuhkan rincian tentang perilaku rancangan yang tepat pada kondisi gangguan mereka. Pratinjau D4 tidak memberi dasar untuk mengatribusikan cara penyimpanan atau pemulihan kedua perangkat tersebut kepada D4. Pratinjau Netlist dari CXL Consortium
Cache key-value model bahasa memberi contoh uji AI yang terpisah. Cache ini menyimpan data atensi dari token sebelumnya agar model bisa menggunakannya kembali. Mesin inferensi yang mendukung pemindahan data ke host dapat menyingkirkan halaman cache sesi yang tidak aktif dari memori GPU dan memuatnya kembali ketika sesi dilanjutkan. Tim dapat menguji apakah tambahan kapasitas host memungkinkan lebih banyak sesi bertahan serta berapa lama penyalinan memperlambat permintaan yang dilanjutkan. Penempatan dan proses salin bergantung pada mesin serta servernya. Ini merupakan contoh eksperimen untuk konfigurasi memori host bertingkat. Dalam pratinjau ini, Netlist secara eksplisit menempatkan penggunaan cache KV pada HM dan PM.
Pengumuman Marvell memberi pembeli pendekatan implementasi lain untuk diikuti. Para mitranya berencana menunjukkan sistem dengan keluarga pengendali Structera X yang menggunakan DDR4 dan DDR5. Program pameran dan kit media memberi konteks tentang acara dan keluarga produk tersebut. Pembeli masih perlu memeriksa konfigurasi server mana yang dikualifikasi pemasok, modul yang diterima, dan bentuk dukungan untuk keseluruhan sistem. Gambar cip dalam kit merupakan materi rujukan untuk keluarga produk. Program paviliun SC26 CXL Consortium · Pengumuman SC26 dari Marvell · Kit media Marvell Structera
Ukur dulu permintaan yang paling lambat
Rata-rata bisa menyembunyikan permintaan yang membuat aplikasi terasa lamban. Pada layanan pencarian, dokumen populer bisa ditemukan dengan cepat sepanjang hari, sementara dokumen yang jarang diakses berulang kali mengirim proses pencarian ke lapisan ekspansi. Nilai latensi naik pada permintaan terlama mungkin masih bisa diterima untuk pengindeksan malam. Pelanggan yang sedang menunggu hasil pencarian bisa langsung merasakannya. Rancangan memori harus memenuhi sasaran layanan yang sebenarnya ketika beban memuncak.
Peneliti independen di balik studi MELODY memperjelas persoalan ini pada 2025. Mereka meneliti 265 beban kerja dengan empat perangkat memori CXL nyata, lima platform CPU, dan tujuh tingkat latensi. Mereka mengamati sensitivitas di rentang di bawah satu mikrodetik, yaitu 140–410 nanodetik, dan menemukan bahwa beban kerja, latensi pada permintaan terlambat, dan perilaku CPU memengaruhi cara sistem menangani memori CXL. Makalah memberi label perangkat ekspansi yang diuji sebagai CXL-A sampai CXL-D. Hasilnya tidak memperkirakan kinerja sistem yang diumumkan untuk SC26. Nilainya bagi pembeli ialah menunjukkan mengapa satu rata-rata latensi atau satu tolok ukur yang menguntungkan tidak cukup menjelaskan kinerja server tertentu. Studi MELODY dari ASPLOS 2025 · Makalah lengkap
Jika platform memungkinkan, rencanakan tiga perbandingan. Pertama, ulangi layanan yang ada pada DRAM lokal saat ini. Setelah itu, uji kapasitas yang lebih besar dengan memori host bertingkat. Terakhir, gunakan konfigurasi seluruhnya lokal dengan kapasitas total yang sama agar hasilnya memiliki pembanding yang bermakna. Sebagai contoh penetapan kapasitas, bandingkan 256 GiB DRAM lokal plus 256 GiB ekspansi yang dapat digunakan dengan 512 GiB DRAM lokal. Pertahankan aplikasi, kumpulan data, pengaturan perangkat lunak, dan beban permintaan yang sebanding, lalu catat perbedaan platform atau kanal lokal yang tidak bisa dihindari. Jika alternatif operasionalnya mengalihkan data ke penyimpanan atau membagi beban ke host lain, ukur waktu dan biaya pilihan itu juga.
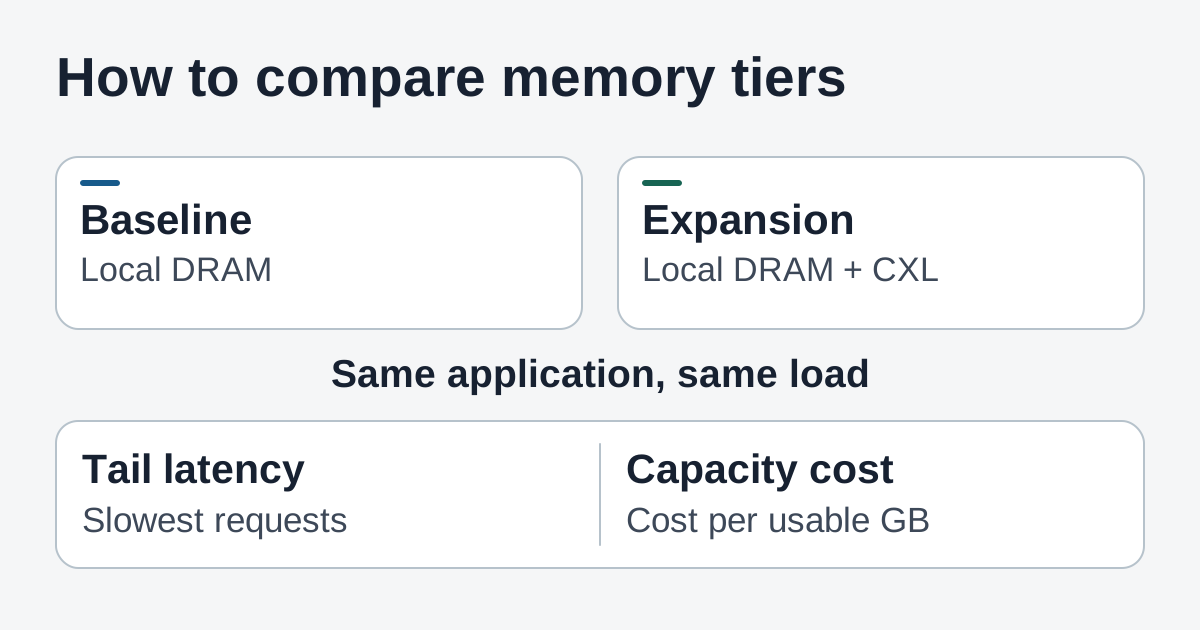
Bandingkan kedua konfigurasi dengan beban kerja dan lalu lintas yang sama. Periksa permintaan terlama dan hitung biaya tiap satuan kapasitas yang bisa dipakai.
- Putar ulang lalu lintas yang membuat cache penuh. Gunakan komposisi permintaan yang realistis, termasuk dokumen yang sering dan jarang dibaca. Jalankan saat cache masih kosong, kemudian ulangi setelah cache terisi. Pantau median, p95 dan p99 latensi permintaan, tingkat kesalahan, serta throughput pada tingkat konkurensi yang sama. Untuk aplikasi pencarian AI, ukur waktu pengambilan data dan waktu inferensi secara terpisah agar cache yang lebih cepat tidak menyamarkan inferensi yang lebih lambat, atau sebaliknya.
- Periksa data apa yang benar-benar pindah. Amati alokasi berdasarkan lapisan dan simpul NUMA CPU, migrasi dan reklamasi halaman jika tersedia, serta penghitung tautan atau perangkat yang disediakan platform. Pengujian yang tampak baik bisa saja hampir selalu memakai DRAM lokal. Hasil buruk mungkin muncul karena halaman indeks yang sering dibaca ditempatkan secara bawaan di lapisan jarak jauh. Catat kebijakan penempatan dalam setiap rangkaian hasil pengukuran.
- Uji kondisi sore yang sibuk. Jalankan pekerjaan kedua saat beban interaktif sedang tinggi, isi ulang cache setelah perangkat dimulai ulang, dan amati kondisi saat layanan mendekati batas memori. Pastikan bagaimana sistem operasi melaporkan kesalahan perangkat atau memori, bagaimana operator menemukan host yang terdampak, serta bagaimana layanan kembali ke kebijakan alokasi sebelumnya. Uji pemulihan untuk setiap konfigurasi yang nantinya harus didukung tim.
- Tentukan kriteria kelulusan sebelum membaca grafik. Mulai dari p99 dan sasaran tingkat kesalahan tim saat ini. Catat berapa kapasitas tambahan yang harus bisa digunakan sambil memenuhi sasaran tersebut, dan kondisi apa yang dapat menerima pemulihan lebih lambat. Jika sasaran hanya tercapai dengan tingkat cache hit yang tinggi, gunakan catatan hari-hari tersibuk untuk memeriksa apakah tingkat tersebut bertahan dalam lalu lintas produksi.
Hitung seluruh biaya penggunaan kembali
DIMM yang sudah dimiliki bisa membuat pos memori pada proposal tampak menarik. Pembelian tetap memerlukan perangkat ekspansi, host atau peningkatan yang didukung, modul yang memenuhi kualifikasi, dan waktu staf untuk pemasangan serta dukungan. Perangkat juga membutuhkan slot atau sambungan platform yang cocok. Bandingkan alokasi jalur PCIe dengan kebutuhan penyimpanan, jaringan, dan akselerator. Peningkatan memori kurang masuk akal jika mengorbankan sumber daya yang dipakai beban kerja yang sama untuk memindahkan data.
Hitung biaya per GiB yang dapat digunakan pada tingkat layanan yang diwajibkan. Sertakan kapasitas cadangan milik platform dan kapasitas yang dikorbankan agar cukup banyak halaman tetap lokal, serta biaya daya, pendinginan, kualifikasi perangkat di seluruh armada, suku cadang, dan dukungan selama masa pakai. Pastikan siapa yang menyediakan pembaruan firmware dan bagaimana sistem menampilkan kondisi perangkat serta kesalahan memori. Jika lapisan tersebut membuat satu host mampu menangani pekerjaan yang sebelumnya harus dialihkan ke penyimpanan atau memerlukan mesin tambahan, ukur pekerjaan yang berhasil ditangani dan perhitungkan biaya tambahan kedua pilihan. Eksperimen sederhana dapat memperjelas perbandingan. Jalankan layanan pada laju permintaan puncak di kedua arsitektur, lalu bandingkan biaya untuk menjaga waktu respons dalam batas yang ditargetkan.
Setelah SC26, perhatikan konfigurasi yang sudah dikualifikasi, dukungan modul yang terdokumentasi, kompatibilitas perangkat lunak, dan catatan beban kerja nyata. Produk yang sudah dirilis dapat memberi tim dengan kumpulan data sekunder yang besar opsi untuk memperluas server yang ada. Contoh yang paling meyakinkan adalah layanan yang menampung lebih banyak dokumen di memori host, menghindari pembacaan penyimpanan berulang, dan tetap memenuhi batas p99 lama dengan biaya lebih rendah. Hasil semacam itu memberi tim dasar pembelian yang bisa dipakai kembali untuk server berikutnya.
Sumber
- Pratinjau Netlist untuk SC26 dari CXL Consortium, 10 November 2026
- Pengumuman konektivitas dan pameran mitra Marvell di SC26, 13 November 2026
- Program paviliun SC26 dan gambar acara CXL Consortium
- Kit pers keluarga produk Marvell Structera
- Program resmi SC26 dan tanggal pameran
- Makalah MELODY dan rincian publikasi, ASPLOS 2025 · Makalah lengkap
Untuk menyimpan catatan uji coba, rekaman beban kerja, dan keputusan pembelian di satu tempat, buat akun Telli.sh.