[สมุดไอเดีย AI 03] ColGrep-Agent: ให้ผู้ช่วยสำรวจบนเครื่องหาโค้ดก่อนโมเดลใหญ่อ่าน
รู้จักเอเจนต์ค้นหาโค้ดบนเครื่องของ LightOn ผลลัพธ์ที่ได้ การทำงานร่วมกับผู้ช่วยเขียนโค้ด และวิธีทดสอบการประหยัดโทเคนโดยไม่สับสนระหว่างการค้นหากับการแก้ไขที่เสร็จแล้ว
สมุดไอเดีย AI ชวนสำรวจแนวคิดและความเป็นไปได้ในการใช้งานจริงของโมเดลและเครื่องมือ AI ที่เพิ่งเริ่มปรากฏขึ้น
รายงานบั๊กบอกว่าการอัปโหลดจบเร็วเกินไป รีโพซิทอรีมีไฟล์หลายร้อยไฟล์ ตัวจัดการความคืบหน้าหลายตัว และฟิลด์สถานะชื่อคล้ายกันอีกสองสามฟิลด์ ก่อนผู้ช่วย AI จะแนะนำวิธีแก้ มันอาจใช้เวลาส่วนใหญ่ของรอบงานไปกับการหาโค้ดที่รับผิดชอบการเสร็จสิ้น
ColGrep-Agent ซึ่ง LightOn ประกาศเมื่อ วันที่ 12 ตุลาคม 2026 รับช่วงการค้นหานี้บนเครื่อง มันสำรวจรีโพซิทอรีและส่งพาธไฟล์ ช่วงบรรทัด และโค้ดที่เกี่ยวข้องกลับให้ผู้ช่วยเขียนโค้ดหลัก แนวคิดคือผู้ช่วยสำรวจในเครื่อง: ให้ผู้เชี่ยวชาญตัวเล็กหาเส้นทางก่อนขอให้โมเดลใหญ่คิดเรื่องการแก้ไข ประกาศจาก LightOn
บทความนี้อธิบายส่วนประกอบ เส้นทางเริ่มต้นที่ใช้ได้จริง และสิ่งที่ควรวัดในการเปรียบเทียบครั้งแรก จุดน่าสนใจคือลดภาระการค้นหา คำถามคือการลดนั้นยังเกิดกับรีโพซิทอรี คำถาม และฮาร์ดแวร์ที่คุณใช้จริงหรือไม่
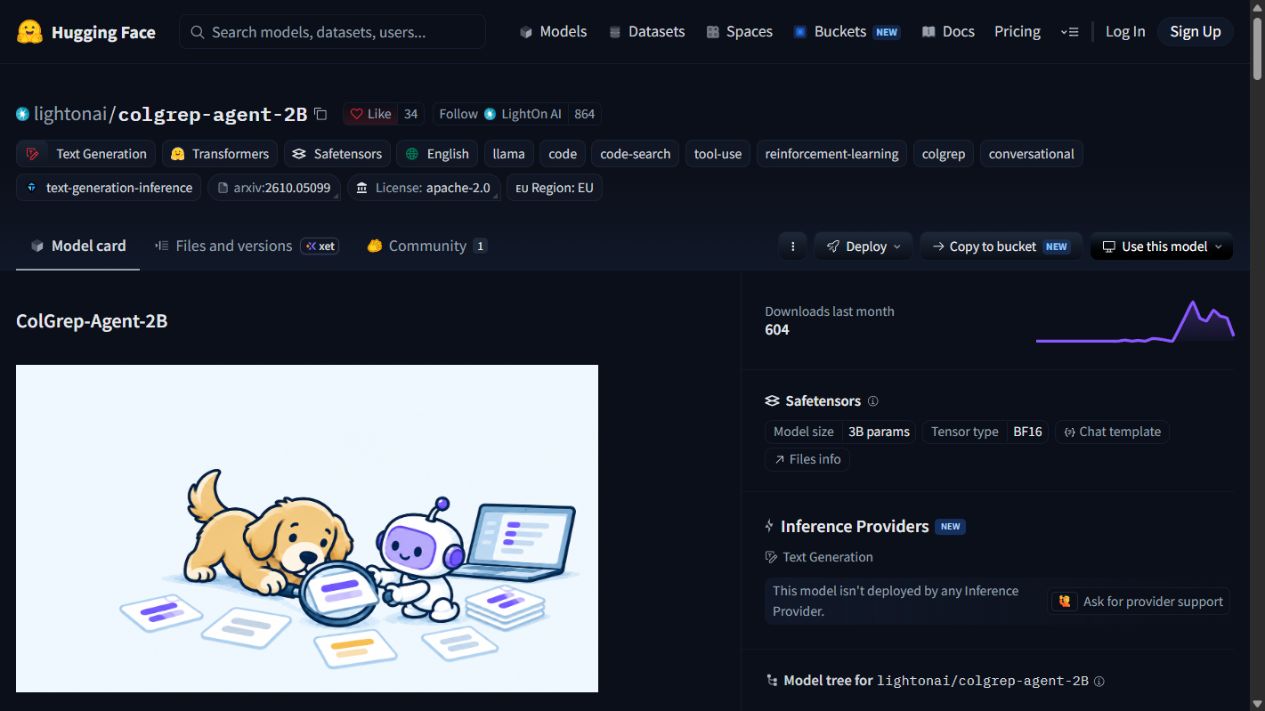 หน้าโมเดลสาธารณะ ถ่ายเมื่อวันที่ 20 ตุลาคม 2026 นี่คือหน้าจอโมเดลการ์ดที่เผยแพร่ ไม่ใช่หลักฐานว่าโมเดลทำงานบนเครื่องของเราแล้ว
สามชื่ออธิบายส่วนประกอบสามส่วนของกระบวนการ
ColGrep คือเครื่องมือค้นหาเชิงความหมาย ColGrep-Agent-2B คือชื่อโมเดลที่เผยแพร่ ส่วนคำสั่ง colgrep --agent รันโมเดลพร้อมกรอบการค้นหาที่จำกัดขอบเขต จึงเป็นชุดส่วนประกอบที่ทำงานร่วมกัน ไม่ใช่ตระกูลโมเดลอีกตระกูล คำอธิบายทางการ
การแยกนี้ช่วยเมื่อตัดสินใจว่าจะเพิ่มโครงสร้างพื้นฐานมากเพียงใด นักพัฒนาคนหนึ่งอาจต้องการค้นหาเชิงความหมายในเทอร์มินัลโดยไม่มีวงจรเอเจนต์ อีกทีมอาจอยากให้ผู้ช่วยเขียนโค้ดส่งคำถามให้เอเจนต์บนเครื่อง แล้วรับชุดบริบทที่เล็กและตรงประเด็นขึ้น
ระบบค้นหารวมคำถามเชิงความหมายกับข้อจำกัดตรงตัว เช่น พาธหรือรูปแบบข้อความ ทั้งสองวิธีแก้ปัญหาต่างกัน คำถามภาษาธรรมชาติช่วยหาพฤติกรรมที่ยังไม่รู้ชื่อตัวระบุ ขณะที่การค้นตรงตัวยังมีค่าสำหรับชื่อฟังก์ชันที่คัดมาจาก stack trace
สำหรับผู้เริ่มต้น ผลลัพธ์สำคัญนั้นเรียบง่าย: รายการสั้นของจุดที่ควรตรวจ คุณยังต้องเข้าใจโค้ด ตรวจข้อตกลงรอบข้าง และรันทดสอบที่เกี่ยวข้องหลังเปลี่ยนพฤติกรรม ตำแหน่งที่มีประโยชน์เป็นข้อมูลนำเข้าสู่การแก้ไข ไม่ใช่การแก้ไขนั้นเอง
ทำไมวงจรค้นหาจึงมีต้นทุนสูงขึ้นได้
ผู้ช่วยเขียนโค้ดมักทำตามลำดับ: ค้นคำ เปิดไฟล์ พบตัวระบุอีกชื่อ ตามจุดอ้างอิง แล้วค้นใหม่ แต่ละขั้นอาจเพิ่มบริบทให้การเรียกโมเดลครั้งถัดไป รีโพซิทอรีที่ผู้ดูแลเดินทางได้ง่าย อาจยังมีต้นทุนสูงสำหรับผู้ช่วยที่เพิ่งพบเป็นครั้งแรก
ColGrep-Agent ย้ายขั้นสำรวจเหล่านั้นเข้าสู่วงจรบนเครื่อง ผู้ช่วยหลักถามคำถาม ผู้ช่วยสำรวจค้นและอ่านไฟล์ที่เป็นไปได้ แล้วบริบทที่ส่งกลับระบุตำแหน่งที่เห็นว่าเกี่ยวข้อง การแบ่งงานนี้ว่าด้วยผู้รับผิดชอบการสำรวจ แทนที่จะขอให้โมเดลในเครื่องแก้งานเขียนโปรแกรมทุกชนิด
ลองนึกว่ากำลังตรวจว่าทำไมเซสชันบันทึกไม่ฟื้นตัวหลังเชื่อมต่อใหม่ การค้น “reconnect” แบบกว้างอาจได้ตัวช่วยขนส่งข้อมูล การแจ้งเตือน UI และการทดสอบเก่า ผลลัพธ์ที่มีประโยชน์ต้องย่อรายการเหลือเจ้าของเซสชันปัจจุบันและฟังก์ชันที่สร้างการเชื่อมต่อกลับขึ้นมา
นี่เป็นเหตุผลด้วยว่าคำตอบสั้นกว่าไม่ได้แปลว่าค้นหาดีกว่าเสมอ หากผู้ช่วยสำรวจตัดไฟล์เดียวที่อธิบายการบันทึกข้อมูลขั้นสุดท้ายออก ผู้ช่วยหลักอาจแก้อย่างมั่นใจแต่ไม่ครบ เป้าหมายคือลดบริบทที่ไม่เกี่ยวข้องโดยยังเก็บหลักฐานที่งานต้องใช้
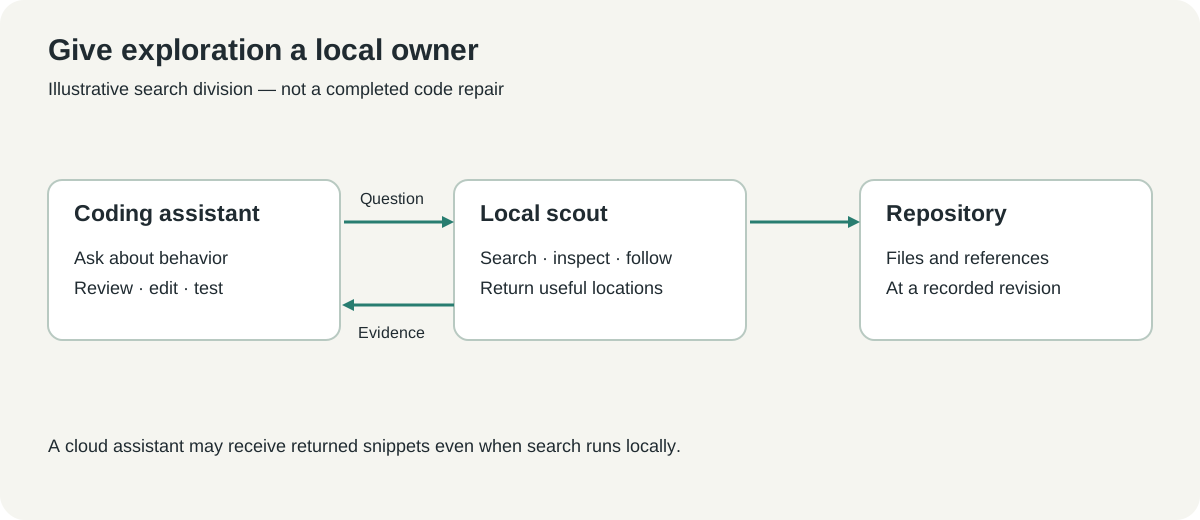 แผนภาพที่จัดทำขึ้นใหม่เพื่ออธิบายการแบ่งงานตามเอกสาร คำถามและตำแหน่งตัวอย่างมีไว้ประกอบความเข้าใจ
ผลลัพธ์เด่นกล่าวถึงการค้นหาโค้ดโดยเฉพาะ
LightOn รายงานว่าใช้ โทเคน API ลดลง 34% และ ต้นทุน API ที่คำนึงถึงแคชลดลง 40% เมื่อเทียบกับ grep ในการศึกษา คำถามค้นหาโค้ด 52 ข้อจาก 13 รีโพซิทอรี นี่คือการวัดที่ผู้เผยแพร่ทำสำหรับการเปรียบเทียบนั้น ไม่ได้พิสูจน์ว่าต้นทุนสร้างหรือดูแลแอปพลิเคชันลดลง 40% รายละเอียดการศึกษา
ขอบเขตสำคัญเพราะงานซอฟต์แวร์มีต้นทุนหลายส่วน การค้นหาอาจลดลงขณะที่การคิดวิธีลงมือยังเท่าเดิม เวลารันทดสอบอาจเป็นส่วนใหญ่ โมเดลที่ประหยัดโทเคนคลาวด์อาจใช้ CPU, GPU, หน่วยความจำ และเวลาสร้างดัชนีบนเครื่องเพิ่มด้วย
แยกคิดสามคำถาม: การค้นหาพบโค้ดถูกจุดหรือไม่ งานเขียนโค้ดเสร็จถูกต้องหรือไม่ และทั้งงานใช้ทรัพยากรเท่าไร การวัดเฉพาะข้อที่ง่ายที่สุดทำให้อีกสองข้อยังไม่มีคำตอบ ทีมควรเลือกสิ่งที่แลกให้ตรงกับงาน แทนถือว่าร้อยละเดียวคือพยากรณ์ที่ใช้ได้ทุกกรณี
พรอมป์ต์ซ้ำยังทำให้เทียบราคาซับซ้อนขึ้น ผู้ให้บริการอาจคิดราคาข้อมูลนำเข้าที่แคชแล้ว ข้อมูลนำเข้าที่ไม่แคช และข้อความที่สร้างต่างกัน หากเครื่องมือแสดงข้อมูลนี้ให้บันทึกแยก และค่อยใช้อัตราราคาที่ระบุวันที่เมื่อมีจำนวนการใช้งานแล้ว
เริ่มจากรีโพซิทอรีที่คุณตรวจสอบได้อย่างมั่นใจ
คำแนะนำเริ่มต้นทางการมีวิธีติดตั้งสำหรับ macOS, Windows และการสร้างจากซอร์ส เริ่มจากสำเนาสะอาดหรือรีโพซิทอรีที่คุณเข้าใจสถานะ และอ่านคำแนะนำรุ่นก่อนรันตัวติดตั้ง อย่าเริ่มด้วยการให้เครื่องมือที่ยังไม่คุ้นเข้าถึงพื้นที่งาน production ที่ยังไม่ตรวจ เอกสาร ColGrep
สำหรับผู้อ่าน macOS ที่ใช้ Homebrew ประกาศ LightOn แสดงคำสั่งดังนี้:
brew install lightonai/tap/colgrep
colgrep --install-agent
คำสั่งที่สองเตรียมโมเดลในเครื่อง แทนการสมัคร endpoint อนุมานแบบโฮสต์ ประกาศระบุว่าโมเดลควอนไทซ์เริ่มต้นดาวน์โหลดประมาณ 2.5 GB นี่คือขนาดดาวน์โหลดที่เอกสารระบุ ไม่ใช่งบหน่วยความจำหรือพื้นที่ดิสก์ครบถ้วนสำหรับทุกการตั้งค่า การตั้งค่าโมเดล
ผู้อ่าน Windows ควรทำตามวิธี PowerShell ปัจจุบันในรีโพซิทอรีทางการ และตรวจตัวติดตั้งก่อนรัน รันไทม์และเส้นทางเร่งความเร็วที่ใช้ได้ขึ้นกับเครื่อง อย่าคิดว่าคำสั่งที่สำเร็จบน Mac พิสูจน์การตั้งค่า ความเร็ว หรือทรัพยากรที่เท่ากันบน Windows
ใช้ลำดับการรันครั้งแรกนี้เพื่อให้เข้าใจการทดลองได้:
- บันทึกคอมมิตรีโพซิทอรีและสถานะ working tree เลือกคำถามที่รู้โค้ดที่เกี่ยวข้องอยู่แล้ว
- ติดตั้งผ่านวิธีในเอกสาร แล้วอ่าน
colgrep --helpและคำแนะนำสร้างดัชนีของเวอร์ชันที่ติดตั้ง - รันการค้นหาเชิงความหมายปกติก่อนเปิดการเชื่อมต่อเอเจนต์ ตรวจว่าไฟล์ที่ละเว้นและไดเรกทอรีที่ไม่รวมเป็นไปตามที่คาด
- ลอง
colgrep --agentด้วยรูปแบบเรียกที่ help ของเวอร์ชันนั้นแสดง ตรวจทุกตำแหน่งที่ส่งกลับในรีโพซิทอรี - เชื่อมกับผู้ช่วยเขียนโค้ดที่รองรับเมื่อการค้นหาเดี่ยวมีประโยชน์แล้วเท่านั้น เก็บการตั้งค่าค้นหาเดิมไว้เปรียบเทียบ
นี่คือขั้นตั้งค่าและประเมิน ไม่ใช่รายงานการติดตั้งเพื่อบทความนี้ บทความแนะนำควรช่วยเลือกแบบฝึกแรก โดยไม่แต่งผลลัพธ์ที่คุณจะพบ
ถามถึงพฤติกรรมแทนระบุไฟล์ล่วงหน้า
คำถามค้นหาที่ดีอธิบายเหตุการณ์และพฤติกรรมที่ต้องการหา “การอัปโหลดที่รับเข้ามาแล้วเปลี่ยนเป็นเสร็จสิ้นตรงไหน หลังงานเบื้องหลังประมวลผลจบ?” ให้ข้อมูลมากกว่า “หาโค้ดอัปโหลด” เพราะให้ข้อตกลงที่ผู้ช่วยสำรวจต้องตามหา โดยเปิดโอกาสให้ค้นพบผู้รับผิดชอบจริง
อย่าใส่วิธีแก้ที่คุณคิดไว้ลงในคำถาม หากถามหาเฉพาะฟังก์ชันที่ควรตั้งแฟล็กหนึ่ง การค้นหาอาจตามสมมติฐานนั้นจนพลาดส่วนที่ควรเป็นเจ้าของสถานะ เริ่มจากสิ่งที่ผู้ใช้เห็น แล้วตรวจ implementation ที่อธิบายมัน
คำถามฝึกสามแบบครอบคลุมรูปแบบเดินโค้ดต่างกัน ลองถามว่าคำขอผ่านการตรวจตัวตนที่ไหน งานเบื้องหลังบันทึกผลสุดท้ายที่ไหน และ frontend สมัครรับการอัปเดตสถานะที่ไหน นี่คือตัวอย่างงานที่ชวนให้ตามความรับผิดชอบข้ามไฟล์ แทนจับคู่ตัวระบุเดียว
สตริงตรงตัวยังมีที่ของมัน stack trace พาธเส้นทาง หรือรหัสข้อผิดพลาดทำให้คำถามแม่นขึ้นมาก รวมหลักฐานนั้นกับคำอธิบายพฤติกรรมที่เห็น เพื่อไม่ให้การค้นหาแยกขาดจากกระบวนการที่ล้มเหลว
ตัดสินตำแหน่งที่ได้ก่อนตัดสินสำนวน
เปิดบรรทัดที่แนะนำและอ่านโค้ดรอบข้างพอเข้าใจความรับผิดชอบของฟังก์ชัน หมายเลขบรรทัดอาจถูก แต่ snippet ชวนเข้าใจผิดเพราะละเงื่อนไขป้องกัน ผู้เรียก หรือขั้นบันทึกข้อมูลสุดท้าย บริบทควรพอให้ตรวจคำกล่าวได้ ไม่ใช่แค่ดูน่าเชื่อ
คอมมิตรีโพซิทอรีสำคัญตรงนี้ พาธและช่วงบรรทัดที่เคยมีประโยชน์อาจเก่าหลัง refactor ผูกผลค้นหาเข้ากับ revision เดียวที่ใช้ประเมิน และรีเฟรชดัชนีตามกระบวนการในเอกสารเมื่อไฟล์ต้นทางเปลี่ยน
| ผลการค้นหา | สิ่งที่ผู้ตรวจควรเช็ก | เหตุผลที่สำคัญ |
|---|---|---|
| พบเจ้าของที่ถูกพร้อมโค้ดรอบข้างที่ใช้ได้ | โค้ดทำพฤติกรรมในคำถามหรือไม่ | ยืนยันว่าผลลัพธ์นำไปทำงานต่อได้ |
| มีเพียง helper ที่เกี่ยวข้อง | ขาดผู้เรียกหรือเจ้าของสถานะหรือไม่ | ป้องกันการแก้เฉพาะจุดที่ยังทิ้งข้อตกลงจริงให้เสีย |
| มีไฟล์ทดสอบแต่ไม่มี implementation | การทดสอบอธิบายพฤติกรรมปัจจุบันหรือความคาดหวังเก่า | เชื่อมหลักฐานกับการทำงานจริงไว้ด้วยกัน |
| มีไฟล์ที่ดูเป็นไปได้จำนวนมาก | จัดลำดับให้เหลือชุดเล็กลงได้โดยไม่ทำบริบทสำคัญหายหรือไม่ | แสดงว่าการค้นหาช่วยลดงานตรวจหรือไม่ |
ในการนำร่องค้นหาโค้ด ให้ผู้ดูแลระบุไฟล์ที่คาดหวังก่อนเห็นคำตอบของเครื่องมือ ไม่เช่นนั้นจะยอมรับตำแหน่งที่ดูสมเหตุสมผลแล้วนิยามความสำเร็จใหม่โดยไม่รู้ตัวได้ง่าย แยกคำถามกำกวมไว้ต่างหาก แทนทำเหมือนทุกปัญหามีไฟล์ถูกเพียงไฟล์เดียว
เปรียบเทียบโดยรวมต้นทุนบนเครื่องด้วย
ใช้คำถามเดียวกันกับวิธีค้นหาเดิมและวิธีใหม่ บน revision รีโพซิทอรีเดียวกัน ชุดเริ่มต้นเล็ก ๆ อาจมีคำถามทั่วไปสิบกว่าข้อและคำถามความรับผิดชอบที่ยากขึ้นอีกเล็กน้อย นี่คือข้อเสนอออกแบบโครงการนำร่อง ไม่ใช่เบนช์มาร์กทางการหรือการรับรองความเชื่อมั่นทางสถิติ
บันทึกว่าผลแต่ละครั้งมีไฟล์ที่รู้ว่าเกี่ยวข้องหรือไม่ ได้โค้ดไม่เกี่ยวข้องมากเท่าไร ใช้โทเคนคลาวด์และเวลาเท่าไร บันทึกการสร้างดัชนีแยกจากการค้นซ้ำด้วย ต้นทุนเริ่มต้นอาจเหมาะกับรีโพซิทอรีที่ใช้บ่อย แต่ไม่น่าสนใจหากแค่นำทางครั้งเดียว
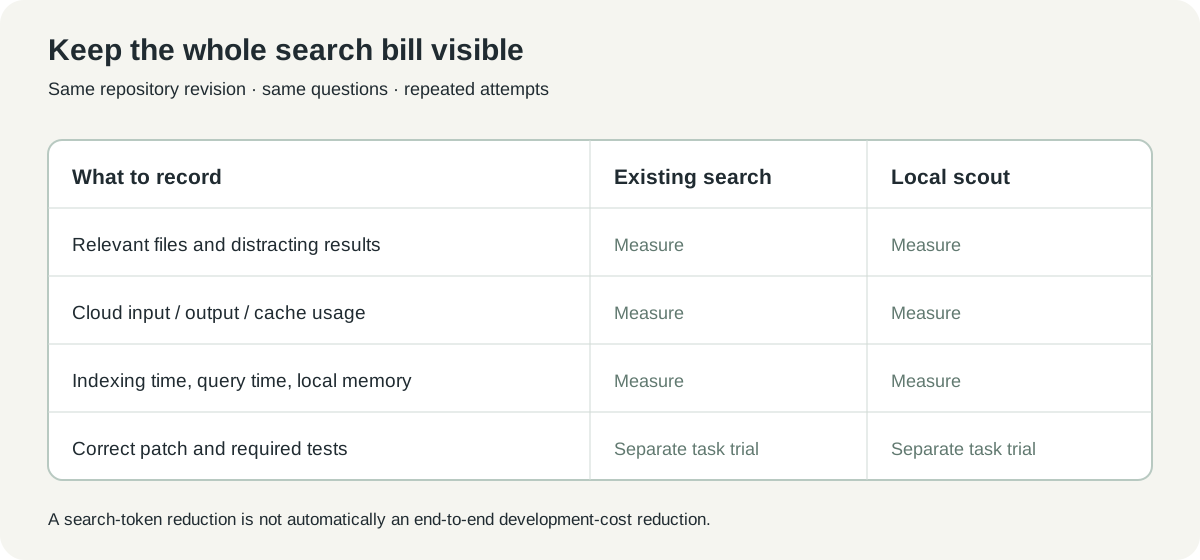 ตารางประเมินที่จัดทำขึ้นใหม่ ช่องวัดว่างไว้โดยตั้งใจ ให้เก็บค่าของคุณก่อนตัดสินว่าสิ่งที่แลกคุ้มหรือไม่
หากเปรียบเทียบการแก้บั๊กครบวงจรด้วย ให้แยกเป็นอีกการทดลอง ใช้ปัญหา snapshot รีโพซิทอรี เกณฑ์ทดสอบ และการตั้งค่าโมเดลเดียวกัน แล้วตรวจแพตช์ที่ได้ เครื่องมือที่ชนะคำถามค้นหาอาจทำงานต่างออกไป เมื่องานต้องสำรวจ แก้ไข ตีความผลทดสอบ และแก้หลายรอบ
ทำบางคำถามซ้ำ แทนเชื่อการรันที่โชคดีครั้งเดียว การนำทางแบบเอเจนต์อาจเลือกทางต่างกันในแต่ละครั้ง ข้อสรุปที่ใช้ได้อาจเป็นว่าโทเคนทั่วไปลดลงแต่คำถามยากช้าลง ซึ่งเป็นสิ่งที่ต้องแลกจริงและตัวเลขรวมเดียวอธิบายไม่ได้
การค้นคืนในเครื่องไม่ได้ทำให้ผู้ช่วยคลาวด์ออฟไลน์
LightOn อธิบายว่าการสร้างดัชนีและอนุมานเอเจนต์ทำในเครื่อง จึงเก็บขั้นค้นหาไว้บนเครื่องได้ แต่ผู้ช่วยเขียนโค้ดบนคลาวด์ที่เชื่อมอยู่ยังอาจได้รับโค้ดที่ผู้ช่วยสำรวจคัดส่งกลับ ประเมินเส้นทางทั้งหมดตั้งแต่คำถามถึงการเรียกโมเดลสุดท้าย แทนถือว่า “ค้นหาในเครื่อง” เท่ากับ “ไม่มีโค้ดออกจากคอมพิวเตอร์” คำอธิบายสถาปัตยกรรม
ควรตรวจรายการยกเว้นของรีโพซิทอรีอย่างตั้งใจ โฟลเดอร์ที่สร้างอัตโนมัติอาจเพิ่มสัญญาณรบกวน ขณะที่ข้อมูลรับรองและไฟล์ส่งออกส่วนตัวไม่ควรกลายเป็นเนื้อหาค้นหาเพียงเพราะอยู่ใต้ไดเรกทอรีโครงการ ใช้พฤติกรรม ignore ตามเอกสารและแนวปฏิบัติรีโพซิทอรีตามปกติขององค์กร
การค้นหาแบบอ่านอย่างเดียวเป็นขอบเขตที่มีประโยชน์สำหรับผู้ช่วยสำรวจ แต่ไม่ได้อนุมัติการแก้ไขภายหลัง ผู้ช่วยหลักยังต้องเคารพคำแนะนำรีโพซิทอรี รักษางานปัจจุบัน และตรวจการแก้ที่เกิดขึ้น การนำทางกับการอนุญาตยังเป็นคนละความรับผิดชอบ
สำหรับทีม ให้แสดงขอบเขตเหล่านี้ในเอกสารการเชื่อมต่อ ผู้คนควรรู้ว่าดัชนีอยู่ไหน โมเดลใดรันในเครื่อง snippet ใดส่งถึงบริการอื่น และปิดการเชื่อมต่ออย่างไร ความรับผิดชอบที่ชัดช่วยให้การทดลองที่มีประโยชน์ยังเข้าใจได้หลังผู้เริ่มต้นย้ายไปทำอย่างอื่น
สิ่งที่ประหยัดได้ดีที่สุดคือการสำรวจที่ไม่เกี่ยวข้องน้อยลง
เรามองว่า ColGrep-Agent แสดงเหตุผลเชิงปฏิบัติของการใช้ผู้เชี่ยวชาญเฉพาะทาง ผู้ช่วยเขียนโค้ดไม่จำเป็นต้องใช้ขั้นคิดที่แพงที่สุดกับการค้นทุกไดเรกทอรี หากผู้ช่วยสำรวจในเครื่องส่งหลักฐานที่เกี่ยวข้องกลับมาได้สม่ำเสมอ คำว่า สม่ำเสมอ คือส่วนที่โครงการนำร่องต้องพิสูจน์
เริ่มด้วยรีโพซิทอรีเดียวและคำถามเดียวที่ผู้ดูแลตัดสินได้ หากตำแหน่งที่ได้ลดการอ่านโดยไม่ซ่อนเจ้าของพฤติกรรม ก็ค่อยขยายการทดลอง เป้าหมายคือเส้นทางสู่การแก้ที่ถูกต้องซึ่งสั้นลง พร้อมวัดต้นทุนค้นหาระหว่างทาง
แหล่งข้อมูลและสื่อ
ตรวจสอบเมื่อวันที่ 20 ตุลาคม 2026 ตัวเลขประสิทธิภาพที่เผยแพร่คือผลค้นหาโค้ดที่ LightOn รายงาน ไม่ได้อ้างว่าติดตั้งในเครื่อง วัด latency หรือทำเบนช์มาร์กเขียนโค้ดครบวงจรแล้ว ผู้เขียนถ่ายภาพหน้าจอสาธารณะ ส่วนแผนภาพจัดทำขึ้นใหม่ ข้อมูลที่มาและประกาศสิทธิ์อยู่ใน บันทึกสื่อ
- ประกาศและการศึกษาจาก LightOn วันที่ 12 ตุลาคม 2026
- เอกสารและซอร์ส ColGrep
- โมเดลการ์ด ColGrep-Agent
- ใบอนุญาตรีโพซิทอรี Apache 2.0
เชื่อมปัญหาและหลักฐานไว้ด้วยกัน
เก็บรายงานต้นฉบับ คำถามค้นหา ลิงก์โค้ดที่เกี่ยวข้อง และบันทึกตรวจสอบไว้ด้วยกัน Telli.sh ช่วยจัดระเบียบบันทึกการตรวจปัญหานี้ได้ สร้างบัญชี Telli.sh