Bolehkah komputer riba yang dikongsi membacakan pelajaran bahasa Twi di luar talian?
Africa TTS 0.5.0 menyediakan suara lalai bagi 92 bahasa Afrika dan bahasa Inggeris. Ini perkara yang perlu diuji dalam rintis sintesis suara luar talian.
Bayangkan pusat pembelajaran komuniti dengan komputer riba yang dikongsi dan sambungan internet yang kerap terputus. Seorang guru menyediakan latihan bacaan pendek dalam bahasa Twi dan mahu murid mendengarnya dua kali, sebelum menjawab dan semasa menyemak jawapan. Rakaman ialah penyelesaian yang jelas. Alat teks kepada pertuturan berguna apabila skrip kerap berubah, guru mahu menghasilkan beberapa variasi latihan atau rakaman yang diluluskan belum dibuat.
AfriSpeech menerbitkan Africa TTS 0.5.0 pada 8 November 2026. Menurut penerangan keluaran, pakej itu boleh mensintesis pertuturan daripada teks dalam 92 bahasa Afrika dan bahasa Inggeris, dengan satu suara lalai bagi setiap bahasa. Ia berjalan pada CPU dan boleh mensintesis di luar talian selepas model dimuat turun dan disimpan dalam cache. Penyelenggaranya menerbitkan demonstrasi dalam talian serta sampel audio. Sampel itu memberikan cara pantas untuk mendengar bahasa yang sedang dipertimbangkan sebelum meluangkan masa memasang pakej. Keluaran berversi di PyPI · Sampel audio rasmi
Soalan berguna untuk pusat pembelajaran itu lebih khusus daripada bilangan bahasa. Bolehkah pendengar mengenal pasti perkataan yang dimaksudkan dan mengikuti bahan pada komputer riba yang dikongsi, dalam ragam bahasa mereka sendiri? Ini memerlukan semakan pendengaran dan peranti. Kedua-duanya lebih berguna apabila bermula dengan ayat yang benar-benar digunakan oleh pusat itu.
Foto konteks dari sebuah studio radio di Ghana, diambil pada 2017. Foto oleh Joy Agyepong, diubah saiz di bawah CC BY-SA 4.0. Foto asal

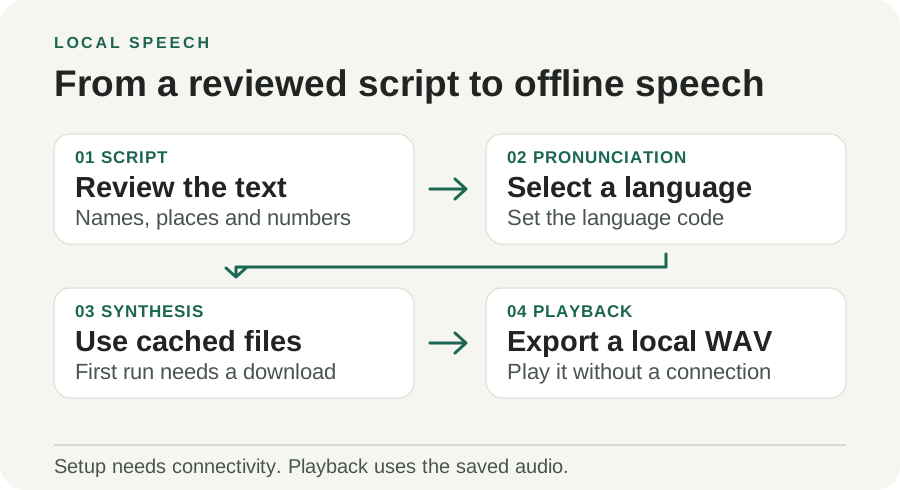
Ilustrasi asli oleh Telli.sh. Model dimuat turun semasa persediaan. Selepas fail yang diperlukan dicache, aliran mendengar boleh kekal pada peranti.
Suara lalai mengurangkan kerja persediaan untuk pelajaran pertama
Keluaran ini memberikan langkah terus kepada pengguna baharu. Berikan satu ayat bertulis dan kod bahasa ISO tiga huruf, seperti twi bagi Twi, swh bagi Swahili atau yor bagi Yoruba. Pakej memberikan suara lalai dan menyimpan pertuturan sebagai fail audio. Guru boleh memasukkan fail itu dalam pelajaran luar talian atau memainkannya terus, dengan versi bertulis tersedia untuk perbandingan.
Input teks sepatutnya sudah dalam bahasa yang dijangka oleh pendengar. Pengumuman Swahili memerlukan skrip Swahili. Jika bermula dalam bahasa lain, penterjemahan dan semakan penutur asli ialah langkah berasingan. Berikan nama tempat, unit dan format tarikh yang digunakan oleh khalayak kepada penterjemah. Letakkan skrip yang sudah disemak di sebelah audio janaan supaya punca salah faham boleh dikenal pasti.
Mulakan dengan bahan yang masih boleh dibetulkan sedikit demi sedikit. Guru boleh menghasilkan beberapa petikan bacaan dengan tahap kesukaran yang serupa dan meminta dua orang penutur mendengar tanpa melihat teks. Pusat latihan boleh menyediakan versi suara bagi arahan bertulis dan memeriksa sama ada peserta memahami turutan langkah. Dalam kedua-dua keadaan, kakitangan boleh merakam pembetulan pendek apabila hasil sintetik sukar menyebut nama atau frasa luar biasa.
Notis awam pendek juga sesuai. Bayangkan pusat pembelajaran mengubah waktu bengkel lalu menyediakan teks bercetak dan versi pertuturan di kios setempat. Minta seorang penutur menyemak waktu yang diubah sebelum menggantikan fail semalam. Jika suara sintetik menyampaikan isi pengumuman tetapi waktu kedengaran kabur, rakam semula ayat itu dan kekalkan versi bertulis supaya boleh dilihat. Ketepatan maklumat lebih penting daripada kemudahan menjana seluruh fail sekali gus.
Tentukan kaedah mengemas kini audio sebelum meletakkannya pada peranti yang dikongsi. Satu cara ialah menyimpan skrip induk dalam teks biasa bersama tarikh dan bahasa di sebelah WAV yang diluluskan. Apabila kakitangan mengubah pelajaran, fail sebelumnya kekal sehingga pendengar meluluskan penggantinya. Pada peranti tanpa sambungan, dua salinan lapuk boleh kedengaran sama meyakinkan. Label semakan ringkas dalam antara muka pelajaran membolehkan guru mengetahui versi yang akan dimainkan tanpa membuka folder pengeluaran.
Sebutan bermula sebelum model pertuturan
Dokumentasi AfriSpeech menerangkan model pelajar enam lapisan dengan 110 juta parameter, termasuk kodek audionya. Model itu disuling daripada model asas 24 lapisan. Proses latihan mengajar model lebih kecil menghampiri hasil penjanaan berpandu daripada model yang lebih besar. Itu antara sebab pakej boleh menyasarkan penggunaan CPU. Ukuran yang relevan pada komputer yang dikongsi ialah masa yang diperlukan untuk menghasilkan fail yang boleh digunakan semasa komputer turut menjalankan pelajaran. Butiran model
Model menerima IPA, iaitu Abjad Fonetik Antarabangsa, melalui komponen hadapan teks khusus bahasa. Komponen itu memetakan teks bertulis kepada unit bunyi yang diperlukan oleh model pertuturan. Projek menggunakan penukar Africa G2P untuk bahasa Afrika yang disokong dan mendokumenkan eSpeak NG untuk bahasa Inggeris. Seni bina ini menerangkan mengapa ejaan yang kurang dikenali, kata pinjaman atau nama boleh gagal walaupun hasil kedengaran lancar. Kesilapan sebelum peringkat akustik boleh membuatkan model menyebut perkara yang salah dengan sangat lancar. Model dan komponen sebutan
Penyelenggara mengesyorkan supaya nombor dieja dengan perkataan. Gunakan kebiasaan yang diikuti oleh pendengar sasaran. Uji bentuk yang digunakan dalam bahan sebenar, termasuk tarikh, masa, julat, singkatan dan kuantiti. Jika berbeza, simpan petikan yang ditaip dan versi yang disesuaikan untuk sebutan secara berasingan. Teks asal boleh terus digunakan pada skrin, manakala skrip penjanaan audio mempunyai rekod perubahan yang jelas.
Skrip yang bertukar bahasa dalam satu ayat memerlukan ujian tersendiri. Dokumentasi membolehkan pemanggil memilih bahasa, maka semak nama dan frasa petikan dalam bahan yang selebihnya menggunakan satu bahasa. Jika penjanaan sekali gus memberikan hasil yang mengejutkan, cuba sediakan segmen berasingan yang telah disemak. Ini berguna bagi bahan pendidikan yang perlu mengekalkan istilah asing dan membacakannya secara konsisten merentas pelajaran.
Liputan latihan memberikan titik mula yang berguna
Kad model melaporkan 897 jam pertuturan dalam data latihan. Jadual mengikut bahasa menyenaraikan kira-kira 322.6 jam bagi bahasa Inggeris, 27.0 jam bagi Swahili, 24.0 jam bagi Twi dan 15.3 jam bagi Yoruba. Jumlah jam latihan menerangkan set data. Angka itu tidak memberitahu ragam bahasa setempat yang digunakan kelas, kekerapan frasa tertentu dalam latihan atau sama ada pendengar mengenali nama sintetik tertentu. Kad model dan jadual bahasa
Keluaran juga menerangkan senarai eksperimen 657 bahasa yang tidak dilatih, yang boleh dibaca melalui bahasa terlatih yang dipilih sebagai padanan paling hampir. Anggap ini laluan penyelidikan berasingan. Bahasa dalam set utama yang didokumenkan dan bahasa yang disalurkan melalui padanan mempunyai bukti berbeza. Bagi rintis untuk orang yang bergantung pada audio, mulakan dengan senarai bahasa terlatih, kemudian tentukan sama ada laluan eksperimen mempunyai semakan penutur asli yang mencukupi untuk tujuannya. Nota bahasa eksperimen
Penyelenggara memberikan dua hasil yang wajar dibaca bersama konteksnya. Pertama, mereka melaporkan penjanaan 2.4 kali masa nyata pada mesin awan dengan empat vCPU. Kedua, mereka menerangkan perbandingan pada data ujian yang diasingkan, menggunakan Omnilingual ASR untuk mentranskripsikan hasil sintesis. Dalam penilaian itu, Africa TTS mengatasi MMS-TTS bagi 21 daripada 27 bahasa yang dibandingkan. Kedua-dua angka datang daripada projek. Bilik yang dipenuhi pelajar mempunyai loghat, peranti, hingar latar dan pembesar suara yang berbeza. Skor transkripsi ialah ukuran pengganti yang berguna bagi kebolehfahaman. Tafsiran pendengar terhadap ayat ialah semakan yang penting untuk pelajaran. Penanda aras keluaran · Kaedah penilaian
| Ujian | Ukur pada peranti rintis sebenar | Sebabnya penting |
|---|---|---|
| Pelancaran pertama | Masa persediaan, saiz muat turun, ruang simpanan selepas cache diisi | Komputer riba yang dikongsi mungkin mempunyai ruang terhad atau tiada sambungan pantas |
| Penjanaan dengan cache | Masa daripada permintaan hingga WAV siap ketika pelajaran terbuka | Aplikasi latar boleh mempengaruhi kelajuan yang dirasai pada CPU biasa |
| Fakta penting | Sama ada pendengar mengulang nama, masa, nombor dan arahan dengan betul | Petikan boleh kedengaran semula jadi walaupun satu perkataan penting tersilap |
| Ragam setempat | Penilaian penutur asli terhadap frasa dan loghat sasaran | Satu kod bahasa yang disokong boleh merangkumi pelbagai cara bertutur |
| Pemulihan apabila gagal | Sama ada pelajaran masih berjalan dengan teks bertulis atau rakaman kakitangan | Model atau peranti audio boleh gagal pada hari ia diperlukan |
Sediakan laluan luar talian sekali, kemudian uji tanpa sambungan
- Pilih petikan pendek yang telah disemak. Tulis sapaan, satu latihan yang mewakili bahan sebenar dan satu petikan yang mengandungi nama atau nombor. Minta seorang penutur mengesahkan ejaan dan pilihan perkataan sebelum sintesis.
- Wujudkan persekitaran Python berasingan. Keluaran 0.5.0 menetapkan Python 3.10 hingga 3.14. Aktifkan persekitaran maya yang sesuai untuk sistem pengendalian anda dan pasang versi yang ditetapkan.
python -m pip install "africa-tts==0.5.0"
africa-tts --list-languages
- Rancang muat turun model pertama. Dokumentasi versi ini menyatakan muat turun awal sekitar 440 MB bagi model lalai. Jalankan semasa persediaan pada rangkaian yang diluluskan, atau mulakan permintaan sintesis dan terima muat turun apabila diminta. Pasang kebergantungan eSpeak NG yang didokumenkan jika rintis merangkumi bahasa Inggeris. Semak arahan pakej sebelum menukar platform atau komponen belakang.
africa-tts --download
africa-tts "Akwaaba!" --lang twi -o twi-greeting.wav
- Ulang selepas persediaan dengan rangkaian dimatikan. Gunakan akaun dan lokasi cache yang akan digunakan oleh pelajaran. Hasilkan WAV baharu, bukanya pada peranti sasaran dan rekod masa penjanaan secara berasingan daripada tempoh main balik.
- Minta orang mendengar sebelum membaca. Mainkan klip akhir pada kelantangan yang akan digunakan dan minta dua penutur atau pendengar mengulang fakta utama. Simpan versi skrip, versi model dan komen. Jika fakta disalah dengar, betulkan teks atau gantikan klip dan ulang semakan.
Urutan ini berguna juga bagi pasukan yang berminat dengan Android. AfriSpeech mendokumenkan himpunan sherpa-onnx dengan komponen hadapan C dan pembalut Android. Uji binaan telefon sebenar secara berasingan kerana pakej mudah alih dan persekitaran masa jalan desktop lalai menggunakan komponen belakang yang berlainan. Bandingkan masa mula sejuk, simpanan, mutu audio dan penggunaan bateri dengan peranti yang mewakili pengguna serta petikan lengkap. Arahan desktop yang berfungsi menunjukkan bahawa projek sesuai dengan satu persekitaran. Telefon masih memerlukan ujian sendiri. Nota pelaksanaan pada peranti
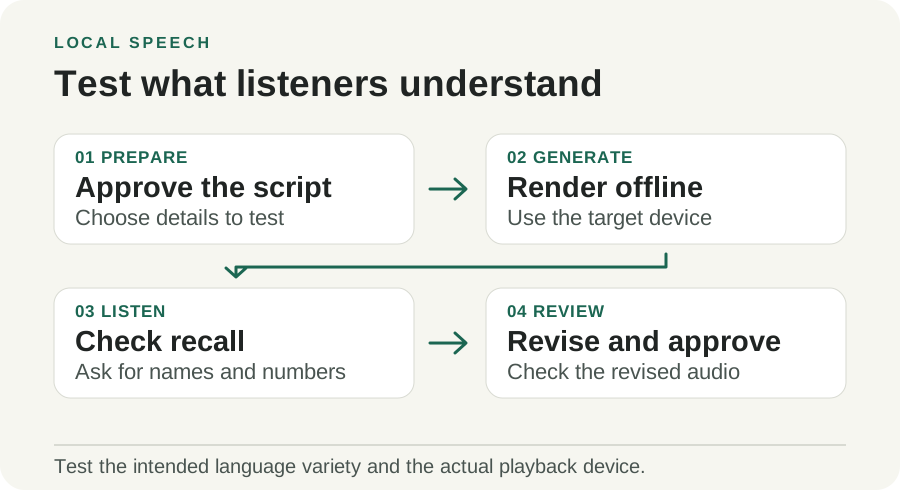
Ilustrasi asli oleh Telli.sh. Minta pendengar mengulang fakta utama sebelum membaca skrip supaya mereka dapat mengesan masalah sebutan yang mungkin terlepas daripada semakan teks.
Semak lesen suara bersama lesen kod
Kod pakej Python menggunakan lesen MIT. Keluaran 0.5.0 menyatakan model dan suara lalai menggunakan CC BY-NC 4.0. Kebergantungan bahasa Inggeris eSpeak NG mempunyai syarat GPL tersendiri. Semak bahagian itu secara berasingan apabila merancang pengedaran alat, fail suara atau perkhidmatan yang bergantung padanya. Muat turun awam mudah dicuba, sementara sesetengah kegunaan komersial memerlukan model lain atau kebenaran berasingan. Pelesenan keluaran · Syarat CC BY-NC 4.0
Pakej itu juga boleh menggunakan sampel suara yang diberikan. Suara lalai memudahkan rintis sekolah kerana tiada keperluan mengumpulkan rakaman rujukan seseorang. Jika aplikasi memerlukan suara khusus, dapatkan kebenaran penutur untuk penggunaan yang dicadangkan dan persetujui lokasi simpanan audio rujukan serta fail janaan. Pusat pembelajaran boleh mengelakkan keputusan itu dengan merakam pembetulan menggunakan suara kakitangannya sendiri dengan kebenaran, dan menggunakan model lalai bagi variasi latihan.
Sintesis luar talian boleh membantu pasukan menyimpan skrip dan bahan suara pada peranti sendiri. Demonstrasi berhos menggunakan laluan yang berbeza. Jika seseorang menghantar skrip atau klip rujukan melalui perkhidmatan web, anggap itu keputusan perkongsian data yang berasingan. Mulakan dengan ayat ujian awam ketika mencuba demonstrasi berhos dan gunakan aliran setempat untuk bahan yang tertakluk pada dasar sekolah atau organisasi.
Pendengar menentukan sama ada hasil itu lulus
Africa TTS membolehkan draf audio pertama disampaikan kepada orang yang mungkin jarang melihat bahasa mereka dalam alat pertuturan. Ujian keluaran yang berguna cukup kecil untuk disemak dengan telinga. Ambil petikan yang akan didengar oleh pengguna, jalankannya tanpa rangkaian dan minta mereka mengulangi maklumat yang penting. Jawapan yang tepat memberitahu lebih banyak tentang rintis daripada bilangan pilihan dalam menu bahasa.
Sumber
- Keluaran Africa TTS 0.5.0, 8 November 2026
- Kad model AfriSpeech dan liputan latihan
- Kaedah penilaian AfriSpeech
- Contoh audio awam AfriSpeech
- Lesen CC BY-NC 4.0
- Foto konteks studio radio Ghana oleh Joy Agyepong, CC BY-SA 4.0
Untuk menyimpan perbualan dan keputusan di sebalik kerja anda dalam rekod yang boleh dicari, cipta akaun Telli.sh.