Bisakah laptop bersama membacakan pelajaran bahasa Twi secara luring?
Africa TTS 0.5.0 menyediakan suara bawaan untuk 92 bahasa Afrika dan bahasa Inggris. Inilah yang perlu diuji dalam percobaan sintesis suara luring.
Bayangkan pusat belajar masyarakat dengan laptop bersama dan koneksi internet yang putus-nyambung. Seorang guru punya latihan membaca singkat dalam bahasa Twi dan ingin siswa mendengarnya dua kali, sebelum menjawab dan saat memeriksa jawaban. Rekaman adalah solusi yang wajar. Alat sintesis suara berguna ketika naskah sering berubah, guru ingin membuat beberapa variasi latihan, atau rekaman yang disetujui belum tersedia.
AfriSpeech menerbitkan Africa TTS 0.5.0 pada 8 November 2026. Menurut keterangan rilis, paket ini dapat menyintesis suara dari teks dalam 92 bahasa Afrika dan bahasa Inggris, dengan satu suara bawaan untuk setiap bahasa. Paket ini berjalan pada CPU dan dapat bekerja luring setelah model diunduh dan disimpan dalam cache. Pengelolanya menyediakan demo daring dan sampel suara. Sampel itu memudahkan Anda mendengarkan bahasa yang akan digunakan sebelum meluangkan waktu untuk pemasangan. Rilis berversi di PyPI · Sampel suara resmi
Pertanyaan yang berguna bagi pusat belajar lebih sempit daripada jumlah bahasa. Bisakah pendengar mengenali kata-kata yang dimaksud dan mengikuti materi pada laptop bersama, dalam ragam bahasa mereka sendiri? Jawabannya perlu uji pendengaran dan uji perangkat. Keduanya lebih berguna bila dimulai dari kalimat yang benar-benar dipakai pusat belajar.
Foto kontekstual studio radio di Ghana, diambil pada 2017. Foto oleh Joy Agyepong, diubah ukurannya berdasarkan CC BY-SA 4.0. Foto asli

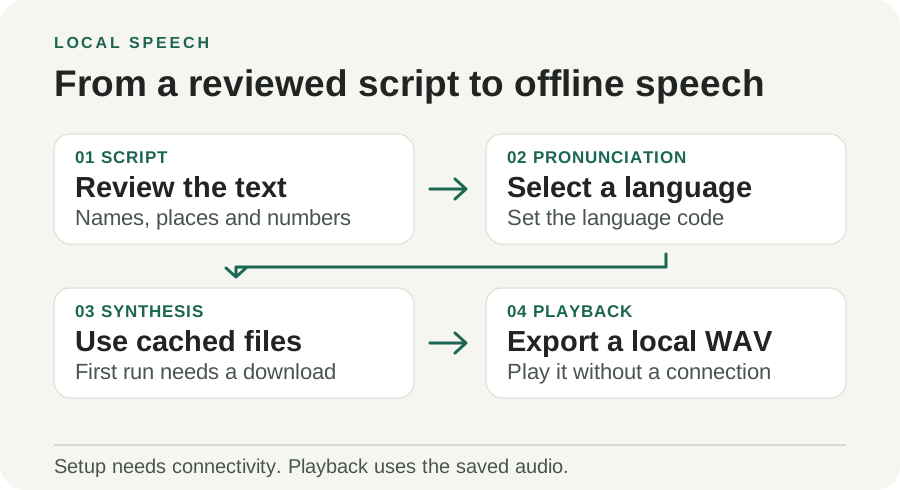
Ilustrasi orisinal oleh Telli.sh. Model diambil saat penyiapan. Alur mendengarkan dapat berlangsung di perangkat setelah berkas yang dibutuhkan tersimpan dalam cache.
Suara bawaan memudahkan penyiapan pelajaran pertama
Rilis ini memberi pengguna baru jalur langsung. Berikan kalimat tertulis dan kode bahasa ISO tiga huruf, seperti twi untuk Twi, swh untuk Swahili, atau yor untuk Yoruba. Paket menyediakan suara bawaan dan menyimpan hasilnya ke berkas audio. Guru bisa memasukkan berkas itu ke dalam pelajaran luring atau memutarnya secara langsung dengan versi tertulis sebagai pembanding.
Teks masukan seharusnya sudah dalam bahasa yang ingin didengar. Pengumuman Swahili memerlukan naskah Swahili. Jika berasal dari bahasa lain, penerjemahan dan tinjauan penutur asli adalah langkah terpisah. Beri penerjemah nama tempat, satuan, dan format tanggal yang digunakan pendengar. Letakkan naskah yang ditinjau di samping audio yang dihasilkan agar penyebab kesalahpahaman dapat dilacak.
Mulailah dengan materi yang masih bisa diperbaiki sedikit demi sedikit. Guru bisa membuat beberapa bacaan dengan tingkat kesulitan serupa dan meminta dua penutur mendengarkannya tanpa melihat teks. Pusat pelatihan bisa menyiapkan versi audio dari petunjuk tertulis dan memeriksa apakah peserta memahami urutan langkah. Dalam kedua kasus, staf bisa merekam koreksi singkat saat hasil sintetis kesulitan melafalkan nama atau frasa yang tidak umum.
Pengumuman publik singkat juga masuk akal. Bayangkan pusat belajar mengubah jadwal lokakarya lalu menyediakan teks cetak dan versi audio di kios lokal. Minta seorang penutur memastikan waktu baru terdengar dengan jelas sebelum mengganti berkas kemarin. Jika suara sintetis membacakan isi pengumuman dengan baik tetapi waktunya terdengar samar, rekam ulang kalimat itu dan biarkan versi tertulis tetap terlihat. Ketepatan detail lebih penting daripada kemudahan menghasilkan seluruh berkas dalam satu proses.
Tentukan cara memperbarui audio sebelum menyimpannya di perangkat bersama. Salah satu caranya adalah menyimpan naskah utama sebagai teks polos dengan tanggal dan bahasa di dekat berkas WAV yang disetujui. Saat staf mengubah pelajaran, pertahankan berkas lama sampai penggantinya disetujui pendengar. Pada perangkat yang tidak terhubung, dua salinan usang bisa terdengar sama meyakinkannya. Label revisi singkat pada antarmuka pelajaran memberi guru cara mengetahui versi yang akan diputar tanpa membuka folder produksi.
Pelafalan dimulai sebelum model suara
Dokumentasi model AfriSpeech menjelaskan model siswa enam lapis dengan 110 juta parameter, termasuk codec audio. Model itu didistilasi dari model dasar 24 lapis. Proses pelatihan mengajari model kecil mendekati keluaran generasi terpandu model yang lebih besar. Itu salah satu alasan paket ini bisa ditujukan untuk penggunaan CPU. Hasil yang relevan pada komputer bersama adalah waktu yang dibutuhkan untuk menghasilkan berkas yang layak saat komputer juga menjalankan pelajaran. Detail model
Model menerima IPA, Alfabet Fonetis Internasional, melalui komponen teks khusus bahasa. Komponen itu memetakan teks tertulis ke satuan bunyi yang diharapkan model suara. Proyek menggunakan konverter Africa G2P untuk bahasa Afrika yang didukung dan mendokumentasikan eSpeak NG untuk bahasa Inggris. Arsitektur ini menjelaskan mengapa ejaan yang tidak dikenal, kata pinjaman, atau nama bisa gagal meski keluaran terdengar lancar. Kesalahan sebelum tahap akustik bisa membuat model melafalkan hal yang salah dengan sangat fasih. Model dan komponen pelafalan
Pengelola menyarankan menulis angka dengan huruf. Ikuti kebiasaan yang digunakan pendengar sasaran. Uji bentuk yang muncul dalam materi nyata, termasuk tanggal, waktu, rentang, singkatan, dan jumlah. Simpan teks yang diketik dan versi yang disesuaikan untuk pelafalan secara terpisah jika keduanya berbeda. Teks asli tetap berguna di layar, sementara naskah sintesis menyimpan catatan perubahan yang jelas.
Naskah yang berganti bahasa di tengah kalimat memerlukan uji tersendiri. Dokumentasi memungkinkan pemanggil memilih bahasa, sehingga nama dan frasa kutipan dalam konten yang selebihnya satu bahasa perlu diperiksa. Jika satu kali sintesis memberi hasil mengejutkan, cobalah menyiapkan segmen terpisah yang sudah ditinjau. Ini berguna untuk materi pendidikan yang perlu mempertahankan istilah asing dan membacakannya secara konsisten di beberapa pelajaran.
Cakupan pelatihan memberi titik awal
Kartu model melaporkan 897 jam data wicara untuk pelatihan. Tabel per bahasa mencatat sekitar 322,6 jam untuk bahasa Inggris, 27,0 jam untuk Swahili, 24,0 jam untuk Twi, dan 15,3 jam untuk Yoruba. Jam pelatihan menggambarkan himpunan data. Angka itu tidak menunjukkan ragam bahasa lokal yang dipakai kelas, frekuensi sebuah frasa dalam pelatihan, atau apakah pendengar mengenali nama tertentu yang disintesis. Kartu model dan tabel bahasa
Rilis juga menjelaskan daftar eksperimental 657 bahasa yang tidak dilatih, yang dapat dibacakan melalui bahasa terlatih yang dipilih sebagai padanan terdekat. Perlakukan ini sebagai jalur riset terpisah. Bahasa pada daftar utama yang terdokumentasi dan bahasa yang dirutekan melalui padanan memiliki dasar bukti berbeda. Untuk uji coba bagi orang yang mengandalkan audio, mulailah dengan daftar bahasa terlatih, lalu pertimbangkan apakah jalur eksperimental sudah cukup ditinjau penutur asli untuk tujuan tersebut. Catatan bahasa eksperimental
Pengelola menyebut dua hasil yang perlu dibaca dalam konteks. Pertama, mereka melaporkan kecepatan generasi 2,4 kali waktu nyata pada mesin awan dengan empat vCPU. Kedua, mereka menjelaskan perbandingan pada data uji yang disisihkan, dengan Omnilingual ASR mentranskripsikan hasil sintesis. Dalam evaluasi tersebut, Africa TTS mengungguli MMS-TTS pada 21 dari 27 bahasa yang dilaporkan. Kedua angka berasal dari proyek. Ruang belajar menghadirkan aksen, perangkat, kebisingan, serta pengeras suara yang berbeda. Skor transkripsi adalah ukuran pengganti yang berguna untuk keterpahaman. Yang penting bagi pelajaran adalah bagaimana pendengar menafsirkan kalimat itu. Tolok ukur rilis · Metode evaluasi
| Pengujian | Ukur pada perangkat uji yang sebenarnya | Mengapa penting |
|---|---|---|
| Penggunaan pertama | Waktu penyiapan, ukuran unduhan, ruang penyimpanan setelah cache terisi | Laptop bersama mungkin memiliki ruang terbatas atau koneksi lambat |
| Sintesis dari cache | Waktu dari permintaan sampai WAV selesai dengan pelajaran terbuka | Aplikasi latar belakang bisa memengaruhi kecepatan CPU biasa |
| Fakta penting | Apakah pendengar mengulangi nama, waktu, angka, dan petunjuk dengan benar | Bacaan bisa terdengar alami dengan satu kata penting yang salah |
| Ragam lokal | Penilaian penutur asli pada frasa dan aksen sasaran | Satu kode bahasa yang didukung bisa mencakup beberapa ragam tutur |
| Pemulihan dari kegagalan | Apakah pelajaran tetap berjalan dengan teks tertulis atau rekaman staf | Model atau perangkat audio bisa gagal saat diperlukan |
Siapkan jalur luring sekali, lalu uji tanpa koneksi
- Pilih bacaan pendek yang sudah diperiksa. Siapkan sapaan, satu latihan representatif, dan satu bacaan dengan nama atau angka. Minta penutur memeriksa ejaan dan susunan kata sebelum sintesis.
- Buat lingkungan Python terpisah. Rilis 0.5.0 menetapkan Python 3.10 hingga 3.14. Aktifkan lingkungan virtual sesuai sistem operasi, lalu pasang versi yang ditentukan.
python -m pip install "africa-tts==0.5.0"
africa-tts --list-languages
- Rencanakan unduhan model pertama. Dokumentasi versi ini menyebut unduhan awal sekitar 440 MB untuk model bawaan. Jalankan saat penyiapan di jaringan yang disetujui, atau mulai permintaan sintesis lalu setujui unduhan saat diminta. Pasang dependensi eSpeak NG yang didokumentasikan jika uji coba mencakup bahasa Inggris. Periksa petunjuk paket sebelum mengganti platform atau backend.
africa-tts --download
africa-tts "Akwaaba!" --lang twi -o twi-greeting.wav
- Ulangi dengan jaringan dimatikan setelah penyiapan. Gunakan akun dan lokasi cache yang akan dipakai pelajaran. Buat WAV baru, buka pada perangkat sasaran, lalu catat waktu sintesis secara terpisah dari durasi pemutaran.
- Minta orang mendengarkan sebelum membaca. Putar klip akhir pada volume yang akan digunakan dan minta dua penutur atau pendengar mengulang fakta penting. Simpan versi naskah, versi model, dan komentar. Jika ada fakta yang salah didengar, perbaiki teks atau ganti klip dan ulangi pemeriksaan.
Urutan ini juga berguna bagi tim yang tertarik pada Android. AfriSpeech mendokumentasikan paket sherpa-onnx dengan komponen C dan pembungkus Android. Uji build ponsel secara terpisah karena paket seluler dan runtime desktop bawaan memakai backend yang berbeda. Bandingkan waktu mulai, penyimpanan, mutu audio, dan pemakaian baterai dengan perangkat representatif serta bacaan utuh. Perintah desktop yang berjalan menunjukkan proyek sesuai untuk satu lingkungan. Ponsel tetap perlu diuji sendiri. Catatan penggunaan pada perangkat
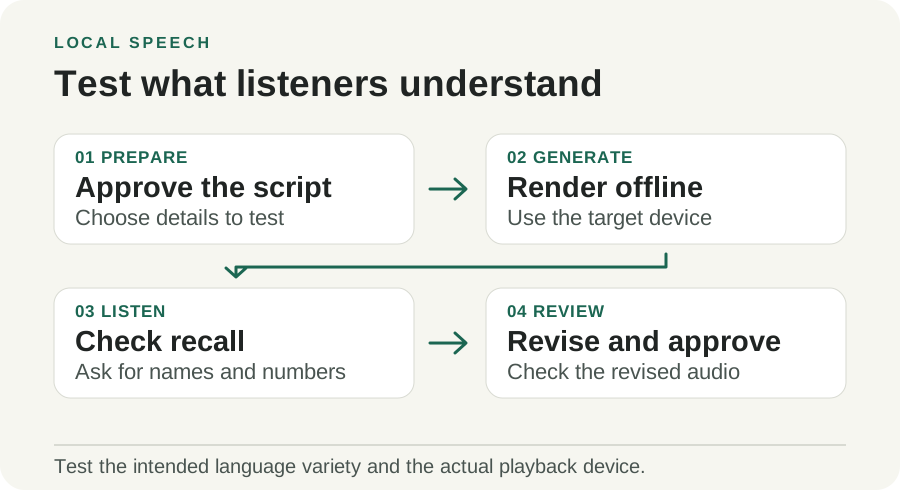
Ilustrasi orisinal oleh Telli.sh. Minta pendengar mengulang fakta utama sebelum membaca naskah agar mereka dapat menemukan masalah pelafalan yang mungkin luput dari penyunting.
Periksa lisensi suara dan kode
Kode paket Python menggunakan lisensi MIT. Rilis 0.5.0 menyebut model dan suara bawaan menggunakan CC BY-NC 4.0. Dependensi bahasa Inggris eSpeak NG memiliki ketentuan GPL sendiri. Periksa bagian itu secara terpisah saat merencanakan distribusi alat, berkas suara, atau layanan yang bergantung padanya. Unduhan publik mudah dicoba, sementara penggunaan komersial tertentu memerlukan model lain atau izin terpisah. Lisensi pada rilis · Ketentuan CC BY-NC 4.0
Paket juga dapat menggunakan sampel suara yang diberikan. Suara bawaan menyederhanakan uji coba sekolah karena tidak perlu mengumpulkan rekaman referensi seseorang. Jika aplikasi membutuhkan suara tertentu, peroleh izin penutur untuk penggunaan yang diusulkan dan sepakati lokasi penyimpanan referensi serta berkas hasilnya. Pusat belajar bisa menghindari keputusan itu dengan merekam koreksi menggunakan suara staf sendiri atas izin mereka, dan menggunakan model bawaan untuk variasi latihan.
Sintesis luring bisa membantu tim mempertahankan naskah dan materi suara pada perangkat sendiri. Demo yang di-host merupakan jalur berbeda. Jika seseorang mengirim naskah atau klip referensi melalui layanan web, perlakukan itu sebagai keputusan berbagi data tersendiri. Mulai dari kalimat uji publik untuk mencoba demo yang di-host dan gunakan alur lokal untuk materi yang tunduk pada kebijakan sekolah atau organisasi.
Pendengar menentukan apakah hasilnya lulus
Africa TTS memungkinkan draf audio pertama sampai kepada orang yang mungkin jarang menemukan bahasa mereka dalam alat sintesis suara. Uji rilis yang berguna cukup kecil untuk diperiksa dengan mendengarkan. Pilih bacaan yang benar-benar akan didengar, jalankan dengan jaringan mati, lalu minta pendengar mengulang detail yang penting. Jawaban yang tepat mengungkapkan lebih banyak tentang uji coba daripada jumlah pilihan pada menu bahasa.
Sumber
- Rilis Africa TTS 0.5.0, 8 November 2026
- Kartu model AfriSpeech dan cakupan pelatihan
- Metode evaluasi AfriSpeech
- Contoh suara publik AfriSpeech
- Lisensi CC BY-NC 4.0
- Foto kontekstual studio radio Ghana oleh Joy Agyepong, CC BY-SA 4.0
Untuk menyimpan percakapan dan keputusan di balik pekerjaan dalam catatan yang dapat dicari, buat akun Telli.sh.